黄仁勋走了,英伟达仍赚翻了:首份财报超预期,接班人稳住了?
1
“后黄仁勋时代”的首次大考
随着 AI 不断发展,过去这些年,这家公司似乎一直势不可挡。
但这次财报之前,黄仁勋辞职了。
11 月 11 日,黄仁勋辞去英伟达总裁、CEO 和董事会成员职务,即刻生效。CFO Colette Kress 暂代 CEO,董事会开始物色正式接班人。他执掌这家公司 33 年,把它从一家做图形处理器的厂商带成 AI 计算平台的核心供应商,这些年一连串大额交易和生态布局,大多是他推的。公司说日常运营和产品路线图不会中断。
在管理层变动引发的震荡中,英伟达股价周一再度下跌 4.12%,收于 156.14 美元。相比 10 月 6 日创下的 239.24 美元收盘高点,累计跌幅已接近 35%。在此背景下,这份财报既要回答 AI 需求是否依然强劲,也承担着稳定投资者信心的任务。
英伟达交出的第一个答案,是单季营收突破千亿美元。北京时间 11 月 18 日凌晨公布的 2027 财年第三季度财报显示,截至 10 月 25 日,公司季度营收达到 1158.44 亿美元,同比增长 103%,环比增长 20%。这一结果超过公司此前给出的 1080 亿美元指引中值,也高于 FactSet 调查的约 1089 亿美元市场预期。
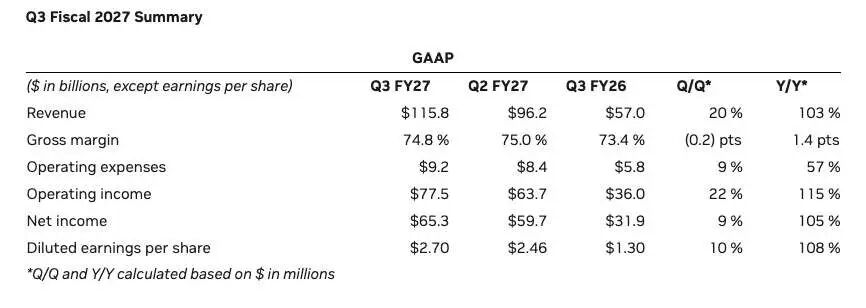
利润同样继续增长。按 GAAP 口径,季度营业利润为 775.20 亿美元,同比增长 115%;净利润为 652.87 亿美元,同比增长 105%;摊薄每股收益为 2.70 美元。调整后每股收益为 2.68 美元,高于市场此前约 2.48 美元的预期。从收入到盈利,这份成绩单仍然延续着英伟达过去几个季度的强势。
其中,数据中心业务贡献了绝大部分增长。该业务季度收入达到 1076 亿美元,同比增长 110%,环比增长 21%,占总收入约 93%。边缘计算业务收入为 82 亿美元,同比增长 42%,环比增长 14%。英伟达的收入结构,已经高度集中于围绕 AI 数据中心展开的基础设施建设。
这轮增长的重要支撑,是新一代平台 Vera Rubin 开始交付。英伟达在财报中将 Vera Rubin NVL72 称为公司历史上爬坡速度最快的产品,相关机架已经在 CoreWeave、Google Cloud、Microsoft Azure、Oracle Cloud Infrastructure 和 Nebius 等合作伙伴处运行。Oracle 和 Google Cloud 也已推出基于 Vera Rubin 的云服务。
Kress 在财报中强调,公司的增长动力真实存在,Vera Rubin 开局强劲,产品路线图仍按计划推进。对于刚刚失去创始人 CEO 的英伟达,这段表态直接回应了市场最关心的问题:已经形成的产品、工程与客户合作体系,能否继续维持原有节奏。
科技巨头的历史也表明,创始人离开,并不会让多年积累的业务体系随之瓦解。Bill Gates 于 2000 年交出微软 CEO 职位,2008 年退出日常管理,微软此后仍完成了向云计算的转型;Jeff Bezos 在 2021 年将 Amazon CEO 职位交给 Andy Jassy,电商、物流和 AWS 也继续运转。对英伟达而言,CUDA 生态、已经进入交付阶段的产品,以及客户正在建设的 AI 集群,同样拥有跨越个人任期的延续性。黄仁勋离任带来了预期震荡,但现有业务仍有自身的运行惯性。
英伟达给出的下一季度指引,也延续了增长预期。公司预计,2027 财年第四季度收入将达到 1300 亿美元,上下浮动 3%,高于 LSEG 汇总的约 1252.5 亿美元分析师预期。该季度比通常多一周,指引仍未计入来自中国的数据中心计算收入。
不过,收入继续扩大,伴随的是更明显的利润率压力。第三季度,英伟达 GAAP 毛利率为 74.8%,调整后毛利率为 74.9%,较上一季度仅小幅下降;到了第四季度,公司预计,两种口径的毛利率都将降至 71%—72%。
这意味着,下一季度即使实现更高收入,每一美元销售额留下的毛利润比例也会下降。以 1300 亿美元收入计算,毛利率每变化一个百分点,就对应约 13 亿美元毛利润。对英伟达这样规模的公司,几个百分点的变化,已经足以显著影响利润增长。
这份财报首先证明,英伟达的订单与产品交付体系仍在高速运转。 数据中心收入翻倍、新平台进入客户基础设施、下一季度指引高于预期,都为管理层交接提供了支撑。但本季度截至 10 月 25 日,早于黄仁勋离任,真正属于新管理层的执行考验,还在后面。
Kress 接手的,是一家需求依旧强劲、规模空前庞大,也需要承担更多供应链投入和系统交付责任的公司。
2
财报继续狂飙,英伟达还能通吃多久?
英伟达的统治地位经历了数十年的积累。从图形处理器起家,到围绕 CUDA 建立软件生态,再到持续投入高带宽内存和芯片间互连,它逐渐把竞争从单颗芯片的性能,扩展到整个计算系统的效率。训练大模型需要的计算、数据交换和软件工具,被整合进同一套平台。客户采用这套平台越深入,迁移时需要重新适配和验证的工作就越多。
不过,AI 基础设施远比 GPU 更复杂。CPU 负责运行应用、调度任务和执行工具,内存决定数据能否及时送到计算单元,网络决定大量芯片能否高效协作。英伟达的优势建立在这些环节的协同之上,压力也正在从不同方向进入:最大的客户希望掌握更多采购主动权,AMD 正在扩大数据中心业务,制造、内存与封装等供应链环节,则持续影响整套系统的交付和成本。
第一股压力,来自云厂商降低供应商依赖的动力。对于大规模建设 AI 集群的企业,GPU 是重要支出,供货节奏、产品路线和软件生态又与同一家供应商深度关联。采购规模越大,建立第二条技术路线的价值也就越高。客户既希望获得更多算力,也希望在价格、交付和产品选择上拥有更多主动权。
Google 与 Broadcom 的合作已经延伸到长期供货安排。Broadcom 在 2026 年 4 月披露,将为 Google 开发和供应未来几代 TPU,并为其下一代 AI 机架提供网络及其他组件,相关协议最长延续至 2031 年。Meta 也在同月宣布扩大与 Broadcom 的合作,围绕自研训练与推理加速器 MTIA 推进多代芯片及配套网络技术。Amazon 则拥有自己的芯片设计团队。AWS 在 2015 年收购 Annapurna Labs,随后逐步构建 Graviton 和 Trainium 等产品系列。云厂商采用了不同的研发与合作模式,都在尝试把庞大的计算需求转化为自研硬件的规模优势。
这些芯片无需替代所有 GPU,就能改变采购预算的流向。云厂商掌握自己的模型、软件和业务数据,可以优先迁移运行量大、流程稳定的任务。只要长期节省的成本足以覆盖研发和适配投入,部分工作负载就有动力离开英伟达平台。最大的客户,也因此成为最有能力培育替代方案的企业。
第二股:AMD 的实质性追赶。AMD 长期同时做 CPU 和 GPU,这个布局在 AI 时代开始兑现。2026 年第三季度,AMD 数据中心收入达到约 85 亿美元,同比增长 97%,增长动力包括 EPYC 服务器处理器需求,以及 Instinct GPU 业务。说明它不只是“理论上的替代选项”,而是开始实际抢份额。
第三股压力,来自制造环节的集中与供应链成本。英伟达、AMD 以及云厂商的多条芯片路线,都依赖台积电等关键制造伙伴。芯片设计上的竞争越来越激烈,上游制造、先进封装和 HBM 供应却无法同步快速扩张。客户增加了芯片供应商,仍然可能面对相同的交付瓶颈。
为了保障后续供应,英伟达正在作出更大规模的长期承诺。截至 2026 年 7 月 26 日,其供应与产能承诺从上一季度的 1190 亿美元增至 2790 亿美元,增加部分主要与内存采购有关。提前锁定资源支撑了交付,也将更大规模的需求预测风险留在公司自身。
需求分化:推理换了一种活法
英伟达面对的竞争,正在随着 AI 的使用方式发生变化。过去,训练更大的模型,需要更多 GPU、更大的高带宽内存和更快的芯片间网络;如今,AI 开始从回答问题走向执行任务,新增需求对硬件的要求也随之分化。处理一份数百页的合同、实时生成语音,以及让 Coding Agent 连续工作几个小时,都属于推理,却未必适合相同的硬件配置。
McKinsey 在 10 月发布的分析中预计,到 2030 年,推理将占 AI 需求的约 60%,训练约占 40%。这一预测意味着,芯片厂商未来争夺的市场,会越来越多地由模型部署后的日常运行构成。
这给英伟达带来了一个更复杂的问题:推理需求增长,能够扩大它的市场,但不同推理任务之间的差异,也在为其他架构创造机会。
以一款合规工具为例,它读取一份 300 页的合同,最终只返回少量需要关注的条款。大量工作发生在处理输入的 prefill 阶段,更考验计算能力。语音助手则需要持续、快速地生成回复,逐 token 输出的 decode 阶段更加重要,对内存带宽和延迟更敏感。同一颗芯片可以处理两种任务,但客户可能因此为一部分没有充分使用的能力付费。
英伟达的 GPU 能够兼顾这些需求。强大的计算能力支持 prefill,HBM 容纳模型权重和 KV cache,高速互连则让多颗 GPU 协同工作。这种通用性也是其优势:一套系统可以在训练和推理之间调整用途,客户无需为每一种任务重新建设基础设施。但当某类任务的运行量足够大时,为它选择专用硬件,节省下来的成本就可能覆盖软件适配与部署投入。
Cerebras 瞄准的正是这种机会。它把整片晶圆做成一颗芯片,通过跨越不同曝光区域的边界进行布线,减少传统芯片间连接的开销。其 WSE-3 配备 44GB 片上 SRAM,带宽达到每秒 21PB;作为对比,H100 配备 80GB HBM,带宽为每秒 3.35TB。两者的内存容量与带宽取舍截然不同:Cerebras 用较小的片上容量换取极高的访问速度,希望让模型更快地生成 token。推理需要大量 token,显然是 Cerebras 最擅长的领域。
行业也开始尝试把同一次推理请求拆开,交给不同硬件处理。McKinsey 列举的方案包括 AWS 将 Trainium 用于 prefill、将 Cerebras 用于 decode,以及 Intel 与 SambaNova 将 prefill 分配给 GPU、将 decode 分配给可重构数据流单元。AMD 也与 Cerebras 建立了合作。竞争已经深入到一次请求的执行过程:输入如何处理、输出如何生成、缓存放在哪里,都可能成为重新分配硬件资源的依据。
不过,专用芯片始终面临一个时间差。模型架构几个月就可能变化,芯片开发却通常以年计算。一颗为特定工作负载优化的芯片交付时,原先的需求可能已经改变。McKinsey 提到,Google 已将基于强化学习的布局规划用于多代 TPU,Jeff Dean 也提出过借助 AI 将芯片设计周期从 18 至 30 个月压缩到 3 至 6 个月的设想。能否缩短这一周期,将直接影响专用芯片追随模型变化的能力。
真正的转折点在 Agent 推理。
回答型推理与 Agent 推理,最终可能走向不同的硬件架构。回答型推理围绕人类等待答案展开,Agent 推理是“完成任务”,由计算机根据其他计算机的指令持续工作,逐步摆脱人类实时参与的限制。
这种区别会改变延迟的价值。一个开发者正在使用的编程助手,每次等待都会影响工作节奏;一个被安排在夜间执行代码迁移、检查和修复的 Agent,则拥有更长的执行窗口。对于后者,客户首先关心的是能否按时完成任务,以及完成任务的总成本,未必需要为每一步都追求最快响应。
于是优先级变了。Agent 推理最重要的不再是 token 生成速度,而是内存与存储。Agent 需要上下文、状态和历史:一部分作为活跃 KV cache 存在,一部分放在主机内存或 SSD,大量内容沉在数据库、日志、向量嵌入和对象存储里。Agent 推理将越来越围绕模型周边的分层存储体系展开,GPU 回答单个问题只是其中一环。在这个体系里,速度和容量必须取舍;既然延迟可以接受,为极致算力付溢价的人就会变少。速度较慢、价格较低的传统 DRAM 变得更有意义;如果系统大部分时间在等内存,芯片也不必是最快的那一款。
这里就出现了一个反直觉的判断:Agent 消耗的算力可以越来越多,客户对最昂贵算力的依赖却可能下降。 英伟达通过高速计算、HBM 和互连建立的优势,需要在新的任务结构下重新证明其溢价。当“够用就好”能够完成工作,客户就有动力把预算分配给更便宜的计算与存储组合。
英伟达并非没有察觉。它推出 Dynamo 推理框架,拆分推理过程的不同部分,同时交付独立的内存机架和 CPU 机架,支持更大的 KV cache 和更快的工具调用——核心目标都是让昂贵的 GPU 保持忙碌。但对于远未受 GPU 性能限制的 Agent 推理,成本和简洁性对云厂商的吸引力会越来越大。
这不意味着英伟达明天就会失去主导地位。训练仍然重要,它的架构在训练领域将继续占主导;回答型推理也仍是一个有意义的市场,只是规模相对较小。但在 Agent 推理这个有望成为最大增量的市场上——因为它不受人类数量或时间的限制——英伟达方案的溢价将承受越来越大的压力。
黄仁勋的离任,让这场压力多了一层不确定性。他任内推动的大额交易和生态承诺,是新管理层要接手的资产,也是要回答的问题:按原节奏走,还是重新看一遍。这将是财报数字之外,市场真正在等的答案。
参考链接:
https://nvidianews.nvidia.com/news/nvidia-announces-financial-results-for-third-quarter-fiscal-2027
本文来自微信公众号“InfoQ”(ID:infoqchina),作者:Tina,36氪经授权发布。