Jensen Huang ist weg, aber Nvidia fährt trotzdem enorme Gewinne ein: Der erste veröffentlichte Finanzbericht übertrifft die Erwartungen, hat der Nachfolger die Lage bereits stabilisiert?
1
Die erste große Bewährungsprobe im Zeitalter nach Jensen Huang
Mit der kontinuierlichen Entwicklung der KI schien dieses Unternehmen in den vergangenen Jahren unaufhaltsam zu sein.
Doch vor der Veröffentlichung dieses Finanzberichts trat Jensen Huang zurück.
Am 11. November legte Jensen Huang seine Ämter als Präsident, CEO und Mitglied des Aufsichtsrats von Nvidia mit sofortiger Wirkung nieder. CFO Colette Kress übernimmt vorübergehend das Amt des CEO, und der Aufsichtsrat sucht nach einem dauerhaften Nachfolger. Er leitete das Unternehmen 33 Jahre lang und machte es aus einem Hersteller von Grafikprozessoren zu einem Kernlieferanten für KI-Computing-Plattformen. Die meisten der großen Transaktionen und ökologischen Layouts in diesen Jahren wurden von ihm vorangetrieben. Das Unternehmen teilte mit, dass der tägliche Betrieb und die Produkt-Roadmap nicht unterbrochen werden.
Inmitten der durch den Führungswechsel ausgelösten Turbulenzen fiel der Aktienkurs von Nvidia am Montag erneut um 4,12 % und schloss bei 156,14 US-Dollar. Im Vergleich zum Schlusskurs-Hoch von 239,24 US-Dollar, der am 6. Oktober erreicht wurde, beträgt der kumulative Rückgang fast 35 %. Vor diesem Hintergrund muss dieser Finanzbericht nicht nur beantworten, ob die KI-Nachfrage weiterhin stark ist, sondern auch die Aufgabe übernehmen, das Vertrauen der Anleger zu stabilisieren.
Die erste Antwort, die Nvidia vorgelegt hat, ist ein Quartalsumsatz von über 100 Milliarden US-Dollar. Der Finanzbericht für das dritte Quartal des Geschäftsjahres 2027, der in der frühen Morgenstunde des 18. November in Pekingzeit veröffentlicht wurde, zeigt, dass der Quartalsumsatz des Unternehmens bis zum 25. Oktober 115,844 Milliarden US-Dollar erreichte, was einem Anstieg von 103 % gegenüber dem Vorjahr und 20 % gegenüber dem Vorquartal entspricht. Dieses Ergebnis übertrifft den zuvor von dem Unternehmen angegebenen Mittelwert der Prognose von 108 Milliarden US-Dollar und liegt auch über den Markterwartungen von etwa 108,9 Milliarden US-Dollar, die aus einer Umfrage von FactSet hervorgehen.
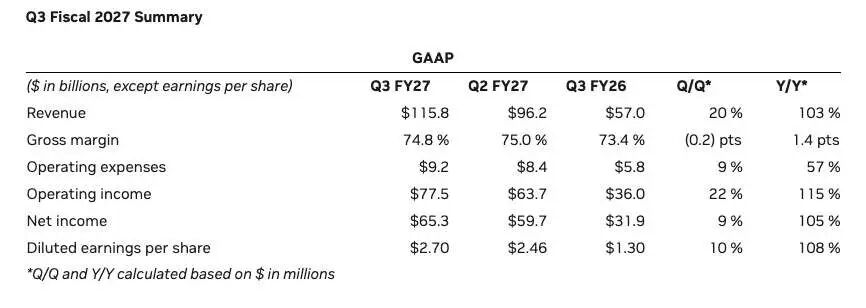
Die Gewinne steigen ebenfalls weiter an. Nach GAAP betrug das Betriebsergebnis im Quartal 77,52 Milliarden US-Dollar, was einem Anstieg von 115 % gegenüber dem Vorjahr entspricht; der Nettogewinn betrug 65,287 Milliarden US-Dollar, ein Anstieg von 105 % gegenüber dem Vorjahr; das verwässerte Ergebnis pro Aktie betrug 2,70 US-Dollar. Das bereinigte Ergebnis pro Aktie lag bei 2,68 US-Dollar und übertraf damit die früheren Markterwartungen von etwa 2,48 US-Dollar. Von den Einnahmen bis zu den Gewinnen setzt dieser Leistungsnachweis die Stärke von Nvidia in den vergangenen Quartalen fort.
Dabei trug das Rechenzentrumsgeschäft den Großteil des Wachstums bei. Der Umsatz dieses Geschäftsfelds erreichte 107,6 Milliarden US-Dollar, ein Anstieg von 110 % gegenüber dem Vorjahr und 21 % gegenüber dem Vorquartal, was etwa 93 % des Gesamtumsatzes ausmacht. Der Umsatz des Edge-Computing-Geschäfts betrug 8,2 Milliarden US-Dollar, ein Anstieg von 42 % gegenüber dem Vorjahr und 14 % gegenüber dem Vorquartal. Die Umsatzstruktur von Nvidia konzentriert sich bereits stark auf den Infrastrukturaufbau rund um KI-Rechenzentren.
Eine wichtige Stütze dieses Wachstums ist die Auslieferung der neuen Generation der Plattform Vera Rubin. Nvidia bezeichnet im Finanzbericht Vera Rubin NVL72 als das Produkt mit der schnellsten Hochlaufgeschwindigkeit in der Unternehmensgeschichte. Die entsprechenden Racks laufen bereits bei Partnern wie CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure und Nebius. Oracle und Google Cloud haben ebenfalls Cloud-Dienste auf Basis von Vera Rubin eingeführt.
Kress betonte im Finanzbericht, dass die Wachstumskräfte des Unternehmens real vorhanden sind, Vera Rubin einen starken Start hingelegt hat und die Produkt-Roadmap weiterhin planmäßig voranschreitet. Für Nvidia, das gerade seinen Gründer-CEO verloren hat, beantwortet diese Aussage direkt die wichtigste Frage des Marktes: Ob das bereits etablierte System aus Produkt-, Ingenieur- und Kundenkooperationen seinen ursprünglichen Rhythmus beibehalten kann.
Die Geschichte der Technologiegiganten zeigt auch, dass der Abgang des Gründers nicht dazu führt, dass das über Jahre aufgebaute Geschäftssystem zusammenbricht. Bill Gates übergab 2000 das Amt des CEO von Microsoft und zog sich 2008 aus dem täglichen Management zurück. Microsoft vollzog danach noch den Wandel zum Cloud Computing; Jeff Bezos übergab 2021 das Amt des CEO von Amazon an Andy Jassy, und E-Commerce, Logistik und AWS funktionierten weiterhin. Für Nvidia haben das CUDA-Ökosystem, die bereits in der Auslieferungsphase befindlichen Produkte und die KI-Cluster, die Kunden gerade aufbauen, ebenfalls eine Kontinuität, die über die Amtszeit einer einzelnen Person hinausgeht. Der Abgang von Jensen Huang hat Erwartungsturbulenzen ausgelöst, aber das bestehende Geschäft behält seine eigene Betriebsträgheit.
Die von Nvidia vorgelegte Prognose für das nächste Quartal setzt ebenfalls die Wachstumserwartungen fort. Das Unternehmen erwartet, dass der Umsatz im vierten Quartal des Geschäftsjahres 2027 130 Milliarden US-Dollar erreichen wird, mit einer Schwankungsbreite von ±3 %, was über den von LSEG zusammengefassten Analystenerwartungen von etwa 125,25 Milliarden US-Dollar liegt. Dieses Quartal hat eine Woche mehr als üblich, und die Prognose berücksichtigt noch keine Einnahmen aus Rechenzentrumscomputern aus China.
Die fortgesetzte Umsatzausweitung geht jedoch mit einem deutlicheren Druck auf die Margen einher. Im dritten Quartal betrug die GAAP-Bruttomarge von Nvidia 74,8 % und die bereinigte Bruttomarge 74,9 %, was gegenüber dem Vorquartal nur leicht zurückging. Für das vierte Quartal erwartet das Unternehmen, dass die Bruttomarge nach beiden Berechnungsmethoden auf 71 % bis 72 % sinken wird.
Das bedeutet, dass selbst bei höheren Einnahmen im nächsten Quartal der Anteil des Bruttogewinns pro US-Dollar Umsatz sinken wird. Bei einem Umsatz von 130 Milliarden US-Dollar entspricht ein Prozentpunkt Änderung der Bruttomarge einem Bruttogewinn von etwa 1,3 Milliarden US-Dollar. Für ein Unternehmen von der Größe Nvidias reichen Änderungen von wenigen Prozentpunkten aus, um das Gewinnwachstum erheblich zu beeinflussen.
Dieser Finanzbericht beweist zunächst, dass das Auftrags- und Produktauslieferungssystem von Nvidia weiterhin mit hoher Geschwindigkeit funktioniert. Die Verdoppelung der Rechenzentrums-Einnahmen, die Integration der neuen Plattform in die Kundeninfrastruktur und die über den Erwartungen liegende Prognose für das nächste Quartal stützen den Führungswechsel. Allerdings endete dieses Quartal am 25. Oktober, also vor dem Abgang von Jensen Huang. Die eigentliche Bewährungsprobe für die neue Führung steht noch bevor.
Kress übernimmt ein Unternehmen mit nach wie vor starker Nachfrage, einer beispiellos großen Größe, das mehr Verantwortung für Lieferketteninvestitionen und Systemauslieferung übernehmen muss.
2
Der Finanzbericht wächst weiterhin rasant – wie lange kann Nvidia den Markt vollständig dominieren?
Die dominante Stellung von Nvidia hat sich über Jahrzehnte aufgebaut. Ausgehend von Grafikprozessoren, über den Aufbau eines Software-Ökosystems rund um CUDA bis hin zu kontinuierlichen Investitionen in Hochgeschwindigkeitsspeicher und Inter-Chip-Verbindungen hat es den Wettbewerb schrittweise von der Leistung einzelner Chips auf die Effizienz des gesamten Rechensystems ausgeweitet. Die Berechnungen, der Datenaustausch und die Softwaretools, die für das Training großer Modelle benötigt werden, sind in ein und derselben Plattform integriert. Je tiefer Kunden diese Plattform nutzen, desto mehr Anpassungs- und Validierungsarbeiten müssen sie bei einem Wechsel durchführen.
Allerdings ist die KI-Infrastruktur weit komplexer als eine GPU. CPUs sind für das Ausführen von Anwendungen, das Planen von Aufgaben und das Ausführen von Tools zuständig, der Speicher bestimmt, ob Daten rechtzeitig zu den Recheneinheiten gelangen, und das Netzwerk bestimmt, ob eine große Anzahl von Chips effizient zusammenarbeiten kann. Die Vorteile von Nvidia bauen auf der Zusammenarbeit dieser Glieder auf, und der Druck kommt aus verschiedenen Richtungen: Die größten Kunden wollen mehr Initiative bei der Beschaffung erlangen, AMD weitet sein Rechenzentrumsgeschäft aus, und die Lieferkettenglieder wie Fertigung, Speicher und Gehäusetechnik beeinflussen kontinuierlich die Auslieferung und die Kosten des gesamten Systems.
Der erste Druck kommt von dem Bestreben der Cloud-Anbieter, die Abhängigkeit von Lieferanten zu verringern. Für Unternehmen, die in großem Maßstab KI-Cluster aufbauen, sind GPUs eine wichtige Ausgabe, und Lieferrhythmus, Produkt-Roadmap und Software-Ökosystem sind eng mit ein und demselben Lieferanten verbunden. Je größer das Beschaffungsvolumen ist, desto höher ist der Wert des Aufbaus einer zweiten technologischen Route. Kunden wollen nicht nur mehr Rechenleistung erhalten, sondern auch mehr Initiative bei Preis, Auslieferung und Produktauswahl haben.
Die Zusammenarbeit zwischen Google und Broadcom hat sich bereits auf langfristige Liefervereinbarungen erstreckt. Broadcom gab im April 2026 bekannt, dass es für Google zukünftige Generationen von TPUs entwickeln und liefern sowie Netzwerk- und andere Komponenten für dessen nächste Generation von KI-Racks bereitstellen wird. Die entsprechenden Vereinbarungen laufen längstens bis 2031. Meta kündigte im selben Monat ebenfalls an, die Zusammenarbeit mit Broadcom auszuweiten, um mehrere Generationen von Chips und zugehörige Netzwerktechnologien rund um den selbst entwickelten Trainings- und Inferenzbeschleuniger MTIA voranzutreiben. Amazon verfügt über ein eigenes Chip-Design-Team. AWS erwarb 2015 Annapurna Labs und baute danach schrittweise Produktreihen wie Graviton und Trainium auf. Die Cloud-Anbieter haben verschiedene Forschungs- und Entwicklungs- sowie Kooperationsmodelle gewählt, um alle zu versuchen, die riesige Rechennachfrage in Größenvorteile für selbst entwickelte Hardware umzuwandeln.
Diese Chips müssen nicht alle GPUs ersetzen, um den Fluss des Beschaffungsbudgets zu verändern. Cloud-Anbieter beherrschen ihre eigenen Modelle, Software und Geschäftsdaten und können Aufgaben mit hohem Ausführungsvolumen und stabilen Abläufen vorrangig migrieren. Solange die langfristig eingesparten Kosten ausreichen, um die Forschungs- und Entwicklungs- sowie Anpassungsinvestitionen zu decken, haben einige Workloads einen Anreiz, die Nvidia-Plattform zu verlassen. Die größten Kunden sind damit auch die Unternehmen, die am besten in der Lage sind, Alternativlösungen zu entwickeln.
Der zweite Druck: Die substanzielle Aufholjagd von AMD. AMD stellt seit langem gleichzeitig CPUs und GPUs her, und diese Strategie zahlt sich im KI-Zeitalter aus. Im dritten Quartal 2026 erreichte der Umsatz von AMD im Rechenzentrumsgeschäft etwa 8,5 Milliarden US-Dollar, ein Anstieg von 97 % gegenüber dem Vorjahr. Die Wachstumsmotivation umfasst die Nachfrage nach EPYC-Serverprozessoren sowie das Instinct-GPU-Geschäft. Das zeigt, dass es nicht nur eine „theoretische Alternative“ ist, sondern beginnt, tatsächlich Marktanteile zu gewinnen.
Der dritte Druck kommt von der Konzentration im Fertigungsbereich und den Lieferkettenkosten. Die verschiedenen Chip-Routen von Nvidia, AMD und den Cloud-Anbietern hängen alle von wichtigen Fertigungspartnern wie TSMC ab. Der Wettbewerb im Chip-Design wird immer intensiver, aber die vorgelagerte Fertigung, fortschrittliche Gehäusetechnik und die HBM-Versorgung können nicht gleichzeitig schnell expandieren. Selbst wenn Kunden die Anzahl ihrer Chiphersteller erhöhen, können sie immer noch mit denselben Auslieferungsengpässen konfrontiert sein.
Um die zukünftige Versorgung zu sichern, geht Nvidia größere langfristige Verpflichtungen ein. Bis zum 26. Juli 2026 stiegen seine Versorgungs- und Kapazitätsverpflichtungen von 119 Milliarden US-Dollar im Vorquartal auf 279 Milliarden US-Dollar. Der zusätzliche Teil hängt hauptsächlich mit dem Einkauf von Speichern zusammen. Die vorzeitige Bindung von Ressourcen stützt die Auslieferung, belässt aber auch das Risiko größerer Nachfrageprognosen im Unternehmen selbst.
Nachfragedifferenzierung: Inferenz findet einen neuen Weg
Der Wettbewerb, dem Nvidia ausgesetzt ist, verändert sich mit der Art und Weise der Nutzung von KI. Früher erforderte das Training größerer Modelle mehr GPUs, größeren Hochgeschwindigkeitsspeicher und schnellere Netzwerke zwischen Chips. Heute bewegt sich KI von der Beantwortung von Fragen zur Ausführung von Aufgaben, und die Anforderungen der neuen Nachfrage an Hardware differenzieren sich entsprechend. Die Verarbeitung eines hundertseitigen Vertrags, die Echtzeit-Generierung von Sprache und das stundenlange kontinuierliche Arbeiten eines Coding-Agent gehören alle zur Inferenz, eignen sich aber nicht unbedingt für dieselbe Hardwarekonfiguration.
In einer im Oktober veröffentlichten Analyse prognostiziert McKinsey, dass bis 2030 Inferenz etwa 60 % der KI-Nachfrage ausmachen wird und Training etwa 40 %. Diese Prognose bedeutet, dass der Markt, um den Chiphersteller in Zukunft kämpfen werden, zunehmend aus dem täglichen Betrieb nach der Bereitstellung von Modellen besteht.
Das stellt Nvidia vor ein komplexeres Problem: Das Wachstum der Inferenznachfrage kann seinen Markt vergrößern, aber die Unterschiede zwischen verschiedenen Inferenzaufgaben schaffen auch Chancen für andere Architekturen.
Nehmen wir als Beispiel ein Compliance-Tool: Es liest einen 300-seitigen Vertrag und gibt am Ende nur wenige zu beachtende Klauseln zurück. Ein großer Teil der Arbeit findet in der Prefill-Phase statt, in der Eingaben verarbeitet werden, was die Rechenleistung stärker fordert. Ein Sprachassistent hingegen muss kontinuierlich und schnell Antworten generieren, die Decode-Phase der Ausgabe von Token für Token ist wichtiger und empfindlicher gegenüber Speicherbandbreite und Latenz. Ein und derselbe Chip kann beide Aufgaben verarbeiten, aber Kunden zahlen möglicherweise für einen Teil der nicht vollständig genutzten Kapazität.
Die GPUs von Nvidia können diese Anforderungen erfüllen. Die starke Rechenleistung unterstützt das Prefill, HBM nimmt Modellgewichte und KV-Cache auf, und die Hochgeschwindigkeitsverbindung lässt mehrere GPUs zusammenarbeiten. Diese Allgemeinverwendbarkeit ist auch ihr Vorteil: Ein System kann zwischen Training und Inferenz umgenutzt werden, und Kunden müssen keine Infrastruktur für jede Aufgabe neu aufbauen. Wenn jedoch das Ausführungsvolumen einer bestimmten Aufgabe groß genug ist, können die durch die Wahl spezialisierter Hardware eingesparten Kosten die Investitionen in Softwareanpassung und Bereitstellung decken.
Cerebras zielt genau auf diese Chance ab. Es macht einen ganzen Wafer zu einem einzigen Chip, führt Verbindungen über die Grenzen verschiedener Belichtungsbereiche hinweg und reduziert den Overhead herkömmlicher Verbindungen zwischen Chips. Sein WSE-3 ist mit 44 GB On-Chip-SRAM ausgestattet, dessen Bandbreite 21 PB pro Sekunde erreicht; zum Vergleich: Die H100 ist mit 80 GB HBM ausgestattet, deren Bandbreite 3,35 TB pro Sekunde beträgt. Die beiden unterscheiden sich stark in der Abwägung zwischen Speicherkapazität und Bandbreite: Cerebras t