世界模型,机器人的AGI元年
【导读】阿里CEO吴泳铭在云栖大会放话:未来机器的思考总量将超过人类1000倍以上,机器将承担99.9%的思考工作,但“机器智能时代的代表性产品,还没有出现”——他把AI Coding比作“1882年的电灯”。围绕AI模型、AI芯片、AI云三大基石,阿里公布Qwen下一代模型参数冲到5-10T、平头哥发布真武V900(算力为M890的3倍、单集群可扩展50万卡)、阿里云2032年数据中心超20GW。耐人寻味的是,就在大佬们畅想ASI的同时,学术界正用一批论文把“超智能”从口号拆成三张可执行的工程图纸——网络安全超智能、世界模型定义之争、具身AGI分级。当ASI长出身体,物理AI的奇点到底长什么样?
AGI的最后一块拼图,不在更大的对话模型里,而在“让AI长出手脚和身体”的世界模型与物理AI里。
01 世界模型:AGI为什么需要“身体”
上海AI实验室物理智能团队给了一个克制却锋利的定义:世界模型,是在有限计算资源的约束下,对物理世界状态转移过程的压缩建模。
关键词是“压缩”,不是“生成”。世界模型的核心任务是信息论意义上的压缩,把高维、冗余、充满噪声的物理观测,蒸馏成一个紧凑、可用的物理表征;生成视频只是压缩到位之后顺带涌现的能力,不是目标本身。
这个定义派生出了三大属性:全模态(同时建模视觉、听觉、触觉等所有感知)、多维异步性(不同维度的数据采样频率天然不同)、局域性(智能体只能看到局部,外部影响只能是干预,天然是一个POMDP)。
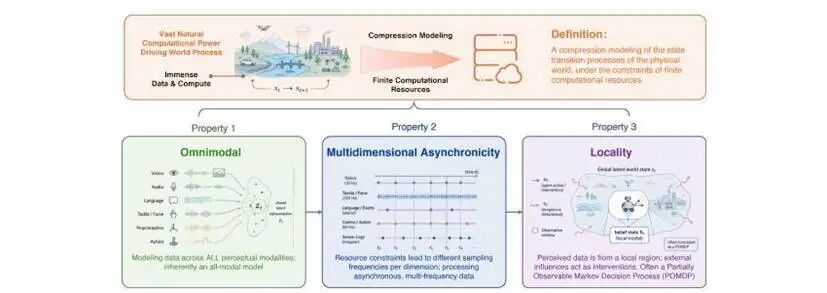
上海AI实验室对世界模型的定义与三大属性
最值得咀嚼的,是它那句“数据决定上限”的论断:任何智能系统在物理世界的泛化能力上限,由训练数据的物理多样性决定,而不是模型结构。而目前唯一能规模化提供这种多样性的,是开放互联网——每一段普通视频里,都藏着物体恒存、刚性与柔性、遮挡与因果这些物理先验。
02 从“看到就做”到“先想象再行动”
如果世界模型是“物理世界的大脑”,那机器人还需要一个把想象变成动作的接口。近三个月,这个接口有了自己的名字:世界-动作模型(World Action Model,WAM)。
传统VLA模型是“看到什么就做什么”;WAM多走一步——先预测“这样做下去世界会变成什么样”,再决定动作。这一步之遥,把机器人从“条件反射”推向“谋定后动”。
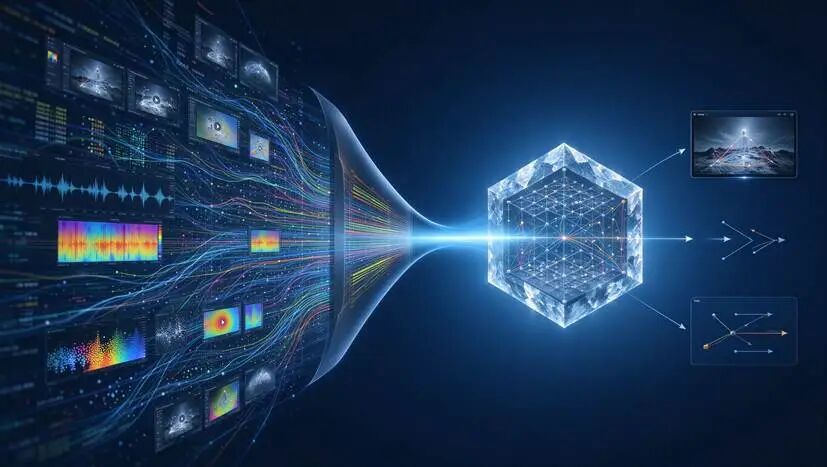
世界模型把高维物理数据压缩为统一表征,再解码出渲染、模拟与规划
过去几个月,这条赛道几乎是在集体冲刺。
NVIDIA的Cosmos 3用一个统一的混合专家Transformer架构,把语言、图像、视频、音频、动作五种模态塞进同一模型,宣称一个框架同时“吃掉”视觉语言模型、视频生成器、世界模拟器和世界-动作模型。
智元机器人发布的GE-Act 2.0,是首个“原生”世界-动作模型——从随机初始化开始、在具身数据上从头训练,不针对评测任务做任何微调。它用自研的CoAE编码器把一帧256×384画面压成24个token,只有DINOv3的十六分之一,在RTX 5090上生成一个动作块只要104毫秒。
最震撼的是它验证了“机器人Scaling定律”:把训练数据从300小时拉到3万小时(100倍),机器人在陌生场景的零样本测试中,能完成的精细任务从39项涨到76项——折叠毛巾、嵌套纸杯、插花这些此前完全无法理解的动作,在数据够大时“突然开窍”。
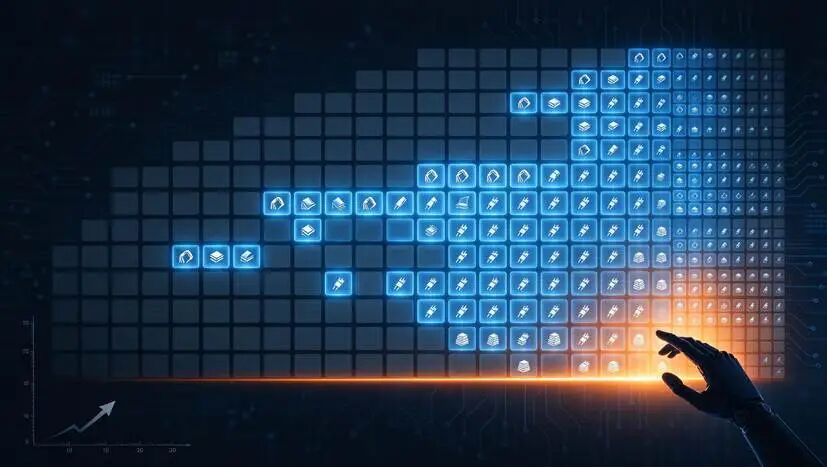
数据规模扩大后机器人能力逐格点亮
03 世界模型正被“喂大”
Scaling的前提是数据。这里,“倒置金字塔工作流”给出了方法论:先用数十亿量级的互联网视频解锁隐含的物理先验,再逐层过滤、合成、提纯,最后变成任务对齐、紧凑的真实世界数据。逻辑很直白——专有机器人数据在多样性上注定无法和互联网竞争,不如先“借用”互联网里现成的物理常识。
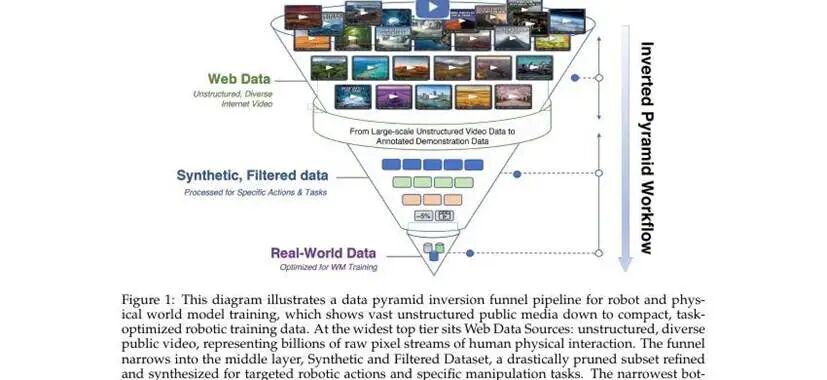
从互联网视频到任务数据的世界模型“倒置金字塔”数据工作流
智元与上海创智学院联合发布的τ0-WM,就是这条路的大规模实践:在约27,300小时的异构语料上预训练(含17,800小时真机遥操作、6,500小时UMI、3,000小时第一人称人类视频),模型只有5B参数,却把“动作生成”“视频预测”“任务评估”统一进一个共享预测表示。推理时,它采样多个候选动作,用动作条件视频模拟器“预演”未来,再挑出最有前景的一条——一个“提议—评估—修正”的闭环。
而海外,Riemann-1.0用200K+小时交互数据,把“可执行的机器人策略”和“多本体视觉世界模拟器”融进同一个自回归模型,在RoboTwin2.0上拿到94.3%、LIBERO上99.0%的成功率。
我的一个判断:机器人在走LLM走过的路——Scaling与数据多样性决定能力上限。但物理数据有个LLM没有的麻烦:动作标签稀缺、采集昂贵。谁能在“低成本拿到足够物理多样性的数据”上胜出,谁就掌握了物理AI的入场券。
04 具身AGI:从L1到L5,走到哪了
有了世界模型和动作接口,距离AGI还有多远?南洋理工大学的综述给出了一个清醒的分级——L1到L5,参考的是自动驾驶的成熟度分级。
L1是单任务完成,L2是组合任务完成,L3是有条件的通用任务,L4是高度通用,L5是全天候自主的全能机器人。论文的结论很冷静:当前所有具身智能系统,都处在L1到L2之间。
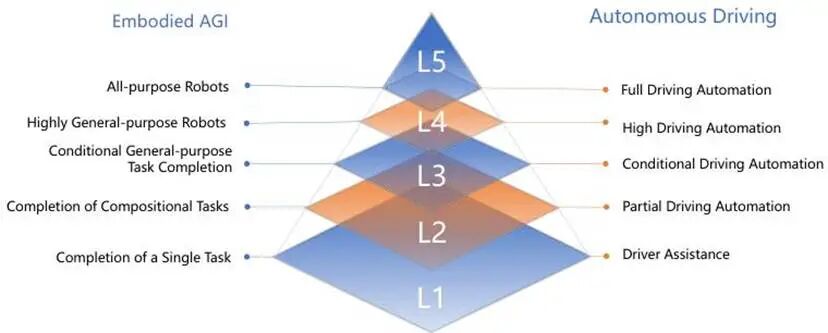
具身AGI五级路线图
一共四个衡量维度:全模态能力、类人认知、实时响应、开放任务泛化。其中最难的,是“类人认知”——自我意识、社交连接理解、程序性记忆、记忆重构。这些都不是靠现成的监督学习或强化学习能学出来的,它们需要终身学习:模型在部署后仍要持续更新内部状态,而不是训练完就“冻结”。
这正是“具身AGI”与“聊天AGI”的本质区别:语言模型可以靠参数冻结稳定运行,而一个真正通用的机器人,必须像一个有记忆的生命那样,在每一天的交互里持续进化。这既是技术问题,某种程度上也是哲学问题。
05 ASI的另一条路:垂直超级智能先行
如果说AGI是“广度”,那超级智能(ASI)也可以是“深度”。Alias Robotics的论文,讲了一个垂直领域超级智能的真实样本——网络安全。
它把进化分成三步:第一步,PentestGPT让AI“辅助”人类做渗透测试(AI引导人类);第二步,Cybersecurity AI(CAI)让AI Agent达到专家级水平,以3,600倍于人类的速度、156分之一的成本完成安全任务;第三步,G-CTR把博弈论(纳什均衡)装进LLM Agent,让它在“攻防对抗”里具备超越人类的战略推理——成功率翻倍、行为方差降低5.2倍。
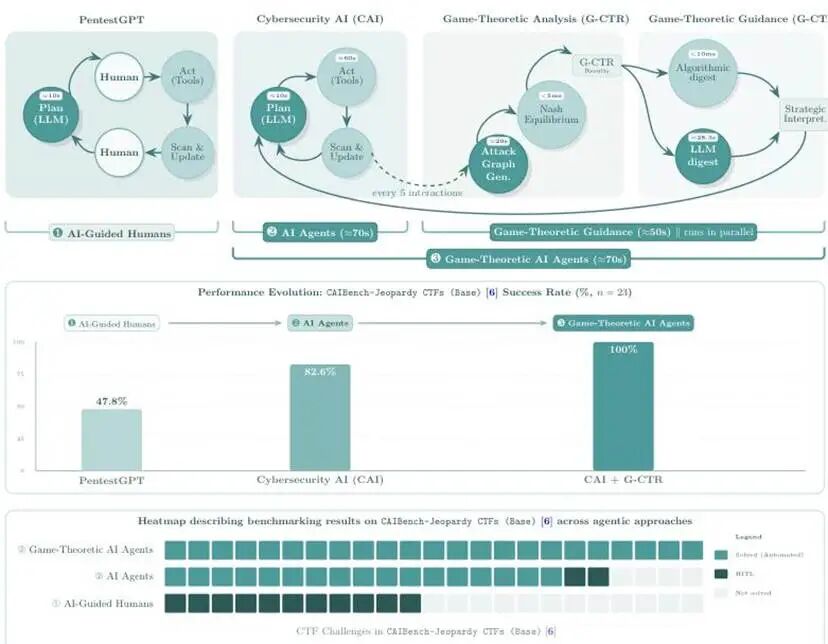
迈向网络安全超级智能的三阶段演进
人类从“执行者”变成“操作者”,再变成“监督者”;AI则从“顾问”变成“执行者”,再变成“战略行动者”。当攻防双方都用上博弈论AI,网络安全就从“人机协作”变成“算法军备竞赛”。
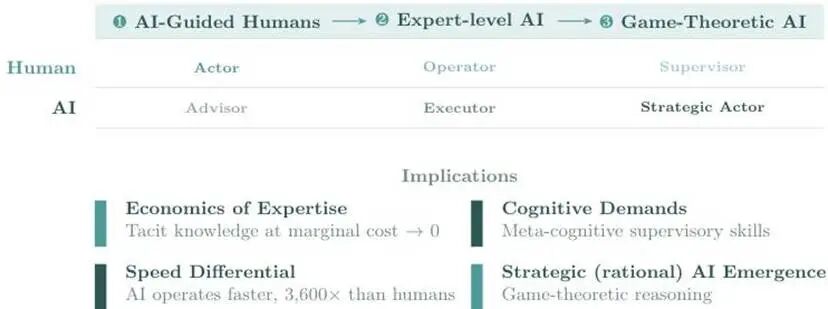
人机角色反转——从AI引导人类到人类引导AI
这给“超级智能”提供了另一种想象:ASI不必是一个全知全能的通用大脑,它可以是“在某个窄领域达到超人水平的智能系统”——尤其是当它被装进一个能行动的实体时。AI Agent、人工生命与机器人的合流,可能通向一种硅基的超智能形态。
06 通往物理AGI的路线图
先做统一多模态世界模型,再做“统一物理表征”(一个状态,多个解码器——渲染、模拟、规划都从同一个压缩状态解码),最终做成“基础规模交互式模拟器”——一个闭环、可复用、能安全试错的虚拟物理世界。
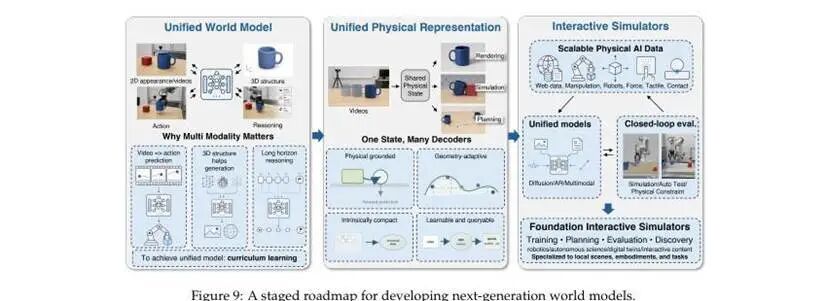
下一代世界模型的分阶段路线图
这其实回答了“机器人的大脑该长什么样”:它不该是三个各管一摊的模块(一个负责看、一个负责想、一个负责动),而应该是一个统一的压缩表征,配上一个能把世界“预演”出来的模拟器。未来真正难的不是让机器人“会做”,而是让它“能想”——在真实世界里动手之前,先在心里把方案推演无数遍,并且推演得足够准。
当然,这条路没那么浪漫。能量消耗、真实性与精度的权衡、长时间预测的误差累积、从仿真到现实的鸿沟,每一个都是硬骨头。更本质的担忧是:当世界模型足够强、机器人足够通用,人机关系会不会重演网络安全里的“角色反转”——人类从执行者退居监督者,而智能体在物理世界里越跑越快。
世界模型是那座桥,机器人是AGI在物理世界的落脚点。当足够多、足够多样的物理数据喂进一个足够大的世界模型,机器人或许真的会在某一天“想明白了”再动手。
而我们要做的,是看清方向,同时想清楚:把世界交给机器人的大脑时,我们该把什么握在自己手里。
资料来源(核验日期:2026-09-23):上海人工智能实验室《世界模型定义与路线图》;新加坡南洋理工大学《走向具身AGI:具身AI综述与前方道路》;Alias Robotics《迈向网络安全超级智能:从AI引导人类到人类引导AI》;NVIDIA《Cosmos 3:面向物理AI的全模态世界模型》;智元机器人《GE-Act 2.0发布说明》;上海创智学院《τ0-WM:最大规模预训练具身世界模型》;Riemann-1.0《面向物理AI的具身世界-动作模型》;Kairos《面向物理AI的原生世界模型栈》;Embodied-R1.5《通过具身基础模型进化物理智能》;北京智源《2026十大AI技术趋势》。
本文来自微信公众号“山自”,作者:Rayking629,36氪经授权发布。