Weltmodell, das erste Jahr der AGI für Roboter
【Einführung】 Wu Yongming, CEO von Alibaba, erklärte auf der Yunqi-Konferenz: Die gesamte Denkleistung von Maschinen wird in Zukunft mehr als das 1000-fache der des Menschen übersteigen, und Maschinen werden 99,9 % der Denkarbeit übernehmen, aber „das repräsentative Produkt des Zeitalters der maschinellen Intelligenz ist noch nicht erschienen“ – er verglich AI Coding mit „der elektrischen Lampe von 1882“. Ausgehend von den drei Grundpfeilern KI-Modell, KI-Chip und KI-Cloud gab Alibaba bekannt, dass die Parameter des nächsten Modells von Qwen auf 5-10 T ansteigen, dass der Chip Hsuan-Tsang V900 von T-Head veröffentlicht wurde (seine Rechenleistung ist dreimal so hoch wie die des M890, und ein einzelner Cluster kann auf 500.000 Karten skaliert werden) und dass die Rechenzentren von Alibaba Cloud im Jahr 2032 eine Leistung von über 20 GW erreichen werden. Auffällig ist, dass während die Branchengrößen über ASI nachdenken, die akademische Forschung mit einer Reihe von Arbeiten das Konzept der „Superintelligenz“ von einem Slogan in drei umsetzbare technische Pläne zerlegt: die Superintelligenz für Cybersicherheit, der Streit um die Definition des Weltmodells und die Einstufung der verkörperten AGI. Wenn ASI einen physischen Körper erhält, wie sieht die Singularität der physischen KI tatsächlich aus?
Das letzte Puzzleteil der AGI liegt nicht in größeren Dialogmodellen, sondern in Weltmodellen und physischer KI, die „der KI Hände, Füße und einen Körper geben“.
01 Weltmodell: Warum braucht AGI einen „Körper“
Das Team für physische Intelligenz des Shanghai AI Laboratory gab eine zurückhaltende aber scharfe Definition: Ein Weltmodell ist die komprimierte Modellierung des Prozesses der Zustandsübertragung der physischen Welt unter den Einschränkungen begrenzter Rechenressourcen.
Das Schlüsselwort ist „Komprimierung“, nicht „Generierung“. Die Kernaufgabe des Weltmodells ist die Komprimierung im Sinne der Informationstheorie, bei der hochdimensionale, redundante und rauschbehaftete physische Beobachtungen zu einer kompakten, nutzbaren physischen Repräsentation destilliert werden; die Generierung von Videos ist nur eine Fähigkeit, die nach einer erfolgreichen Komprimierung emergent entsteht, nicht das Ziel selbst.
Aus dieser Definition ergeben sich drei Eigenschaften: Totalmodalität (gleichzeitige Modellierung aller Wahrnehmungen wie Sehen, Hören und Tasten), mehrdimensionale Asynchronität (die Abtastfrequenzen von Daten verschiedener Dimensionen sind natürlich unterschiedlich) und Lokalität (der Agent kann nur einen Teilbereich sehen, externe Einflüsse können nur durch Interventionen erfolgen, es handelt sich natürlich um ein POMDP).
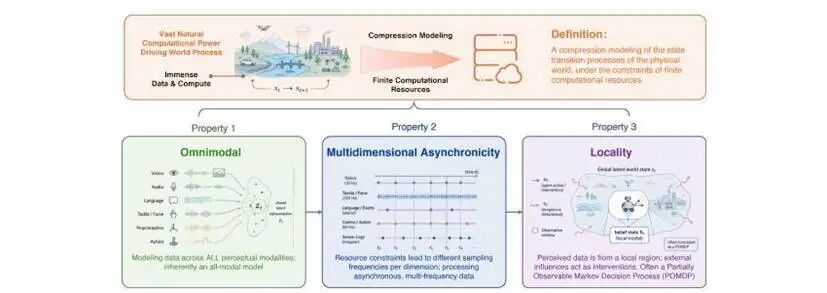
Definition des Weltmodells und seine drei Eigenschaften nach dem Shanghai AI Laboratory
Am nachdenklich stimmendsten ist seine These, dass „Daten die Obergrenze bestimmen“: Die Obergrenze der Generalisierungsfähigkeit eines jeden intelligenten Systems in der physischen Welt wird durch die physische Vielfalt der Trainingsdaten bestimmt, nicht durch die Struktur des Modells. Derzeit ist das offene Internet der einzige Ort, der diese Vielfalt in großem Maßstab bereitstellen kann – in jedem gewöhnlichen Video sind physische A-Priori-Regeln wie Objektpermanenz, Starrheit und Flexibilität, Verdeckung und Kausalität verborgen.
02 Von „Sehen und Handeln“ zu „Zuerst Vorstellen, dann Handeln“
Wenn das Weltmodell das „Gehirn der physischen Welt“ ist, dann brauchen Roboter noch eine Schnittstelle, die Vorstellungen in Handlungen umwandelt. In den letzten drei Monaten erhielt diese Schnittstelle ihren eigenen Namen: Welt-Aktions-Modell (World Action Model, WAM).
Herkömmliche VLA-Modelle folgen dem Prinzip „Was man sieht, das macht man“; WAM geht einen Schritt weiter – es prognostiziert zuerst, „wie sich die Welt entwickeln wird, wenn man so handelt“, bevor es die Handlung festlegt. Dieser kleine Schritt bringt Roboter von „reflexartigen Reaktionen“ zu „überlegtem Handeln“.
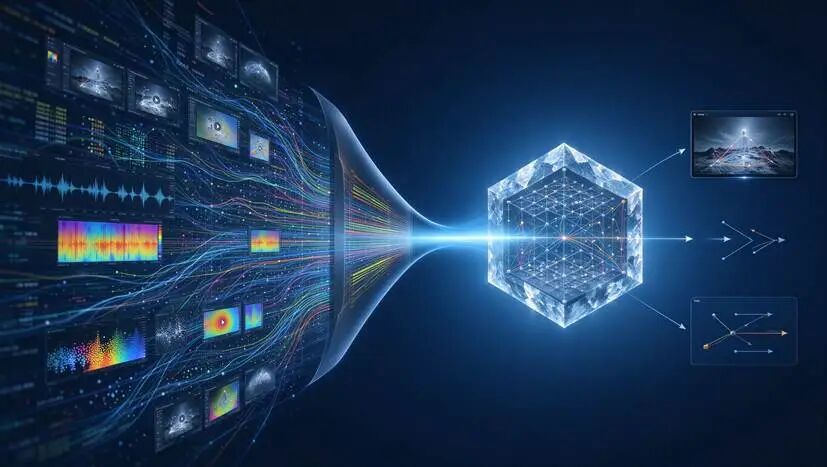
Das Weltmodell komprimiert hochdimensionale physische Daten zu einer einheitlichen Repräsentation und dekodiert dann Rendering, Simulation und Planung
In den letzten Monaten hat sich dieses Feld fast im kollektiven Sprint weiterentwickelt.
NVIDIAs Cosmos 3 verwendet eine einheitliche gemischte Experten-Transformer-Architektur, um die fünf Modalitäten Sprache, Bild, Video, Audio und Handlung in dasselbe Modell zu integrieren. Es wird behauptet, dass ein einziges Framework gleichzeitig Vision-Sprach-Modelle, Videogeneratoren, Weltsimulatoren und Welt-Aktions-Modelle abdeckt.
Das von Unitree Robotics veröffentlichte GE-Act 2.0 ist das erste „native“ Welt-Aktions-Modell – es wird von zufälliger Initialisierung an auf verkörperten Daten von Grund auf trainiert, ohne jegliche Feinabstimmung für Bewertungsaufgaben. Es verwendet einen selbst entwickelten CoAE-Encoder, um ein Bild von 256×384 Pixeln auf 24 Token zu komprimieren, was nur ein Sechzehntel der Größe von DINOv3 ist. Auf einer RTX 5090 dauert die Generierung eines Aktionsblocks nur 104 Millisekunden.
Am beeindruckendsten ist die Bestätigung des „Roboter-Scaling-Gesetzes“: Wenn die Trainingsdaten von 300 Stunden auf 30.000 Stunden (das 100-fache) erweitert werden, kann der Roboter im Zero-Shot-Test in unbekannten Szenarien 76 feine Aufgaben statt vorher 39 erledigen – Aktionen wie das Falten von Handtüchern, das Stapeln von Pappbechern und das Arrangieren von Blumen, die zuvor völlig unverständlich waren, funktionieren plötzlich, wenn die Datenmenge groß genug ist.
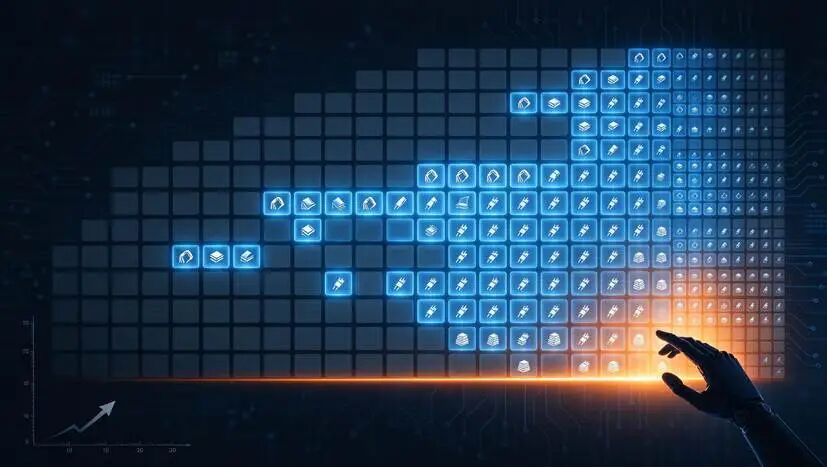
Die Fähigkeiten des Roboters werden schrittweise aktiviert, wenn der Datenumfang wächst
03 Weltmodelle werden gerade „großgezogen“
Die Voraussetzung für Scaling sind Daten. Hier bietet der „invertierte Pyramiden-Arbeitsablauf“ eine Methodik: Zuerst werden Milliarden von Internetvideos verwendet, um die impliziten physischen A-Priori-Regeln zu erschließen, dann werden sie schichtweise gefiltert, synthetisiert und aufgereinigt, bis sie schließlich zu aufgabenausgerichteten, kompakten Echtzeitdaten der physischen Welt werden. Die Logik ist einfach: Spezielle Roboterdaten können in Bezug auf Vielfalt niemals mit dem Internet konkurrieren, es ist sinnvoller, zuerst die im Internet vorhandenen fertigen physischen Allgemeinwissen zu „nutzen“.
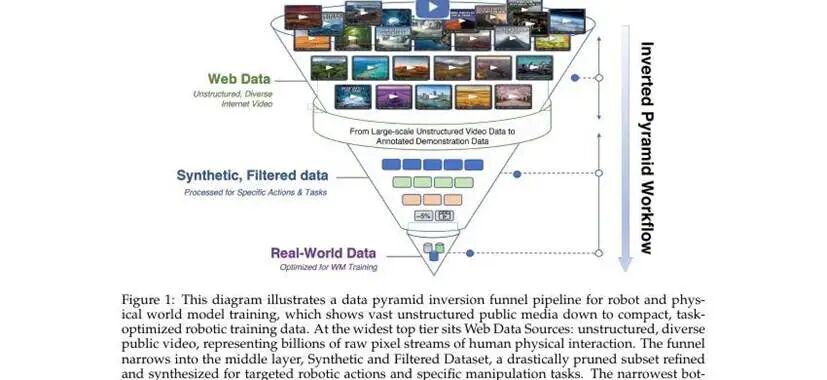
Der „invertierte Pyramiden“-Datenarbeitsablauf für Weltmodelle von Internetvideos zu Aufgabendaten
Das gemeinsam von Unitree und dem Shanghai Institute for Intelligent Innovation veröffentlichte τ0-WM ist eine groß angelegte Umsetzung dieses Ansatzes: Es wird auf etwa 27.300 Stunden heterogener Korpora vortrainiert (darunter 17.800 Stunden Fernsteuerung durch echte Roboter, 6.500 Stunden UMI und 3.000 Stunden Videos aus der Ich-Perspektive von Menschen). Das Modell hat nur 5B Parameter, aber es vereinheitlicht „Aktionsgenerierung“, „Videoprognose“ und „Aufgabenbewertung“ in einer gemeinsamen prognostizierenden Repräsentation. Bei der Inferenz werden mehrere Kandidatenaktionen abgetastet, um die Zukunft mit einem aktionsgesteuerten Videosimulator „vorauszuspielen“, bevor die vielversprechendste Aktion ausgewählt wird – ein geschlossener Regelkreis aus „Vorschlag – Bewertung – Korrektur“.
Ausländischerseits verwendet Riemann-1.0 mehr als 200.000 Stunden Interaktionsdaten, um „ausführbare Roboterstrategien“ und „multiontische visuelle Weltsimulatoren“ in dasselbe autoregressive Modell zu integrieren, und erreicht eine Erfolgsrate von 94,3 % auf RoboTwin2.0 und 99,0 % auf LIBERO.
Meine Schlussfolgerung: Roboter gehen den gleichen Weg, den LLM gegangen sind – Scaling und Datenvielfalt bestimmen die Obergrenze der Fähigkeiten. Aber physische Daten haben ein Problem, das LLM nicht haben: Aktionslabels sind knapp und ihre Erhebung ist teuer. Wer es schafft, „mit geringen Kosten Daten mit ausreichender physischer Vielfalt zu erhalten“, der erhält die Eintrittskarte für die physische KI.
04 Verkörperte AGI: Von L1 bis L5, wo stehen wir?
Wie weit ist es noch von Weltmodellen und Aktionsschnittstellen zur AGI? Eine Übersichtsarbeit der Nanyang Technological University gibt eine nüchterne Einstufung – von L1 bis L5, angelehnt an die Reifegradstufen des autonomen Fahrens.
L1 steht für die Erledigung einzelner Aufgaben, L2 für die Erledigung kombinierter Aufgaben, L3 für bedingte allgemeine Aufgaben, L4 für hochgradige Allgemeinheit und L5 für allseits autonome, allmächtige Roboter. Die Schlussfolgerung der Arbeit ist sachlich: Alle derzeitigen Systeme für verkörperte Intelligenz befinden sich zwischen L1 und L2.
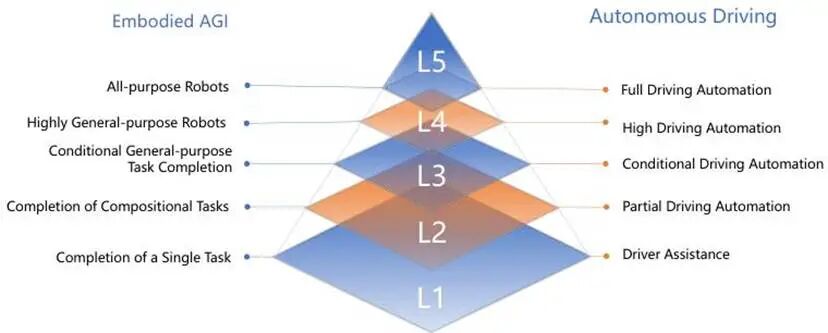
Fünfstufen-Roadmap für verkörperte AGI
Es gibt vier Messdimensionen: Totalmodalitätsfähigkeit, menschenähnliche Kognition, Echtzeitantwort und Generalisierung für offene Aufgaben. Am schwierigsten ist die „menschenähnliche Kognition“ – Selbstbewusstsein, Verständnis von sozialen Verbindungen, prozedurales Gedächtnis und Gedächtnisrekonstruktion. Diese Fähigkeiten lassen sich nicht mit herkömmlicher überwachter Lernverstärkung erlernen, sie erfordern lebenslanges Lernen: Das Modell muss nach der Bereitstellung seinen internen Zustand ständig aktualisieren, anstatt nach Abschluss des Trainings „eingefroren“ zu werden.
Das ist genau der grundlegende Unterschied zwischen „verkörperter AGI“ und „Chat-AGI“: Sprachmodelle können mit eingefrorenen Parametern stabil laufen, aber ein wirklich universeller Roboter muss wie ein lebendiges Wesen mit Gedächtnis in jeder täglichen Interaktion ständig weiterentwickelt werden. Das ist sowohl ein technisches als auch in gewissem Maße ein philosophisches Problem.
05 Ein anderer Weg zu ASI: Vorrang der vertikalen Superintelligenz
Wenn AGI für „Breite“ steht, dann kann Superintelligenz (ASI) auch für „Tiefe“ stehen. Die Arbeit von Alias Robotics beschreibt ein echtes Beispiel für Superintelligenz in einem vertikalen Bereich – der Cybersicherheit.
Sie unterteilt die Entwicklung in drei Schritte: Im ersten Schritt unterstützt PentestGPT den Menschen bei Penetrationstests (die KI leitet den Menschen an); im zweiten Schritt erreicht Cybersecurity AI (CAI) das Niveau von Experten und erledigt Sicherheitsaufgaben mit einer Geschwindigkeit, die 3600-mal höher ist als die des Menschen, und zu einem Preis, der nur 1/156 des menschlichen Aufwands beträgt; im dritten Schritt integriert G-CTR die Spieltheorie (Nash-Gleichgewicht) in den LLM-Agenten, sodass er im „Angriffs- und Verteidigungswettbewerb“ strategisches Denken über das menschliche Niveau hinaus besitzt – die Erfolgsrate verdoppelt sich und die Varianz des Verhaltens sinkt um das 5,2-fache.
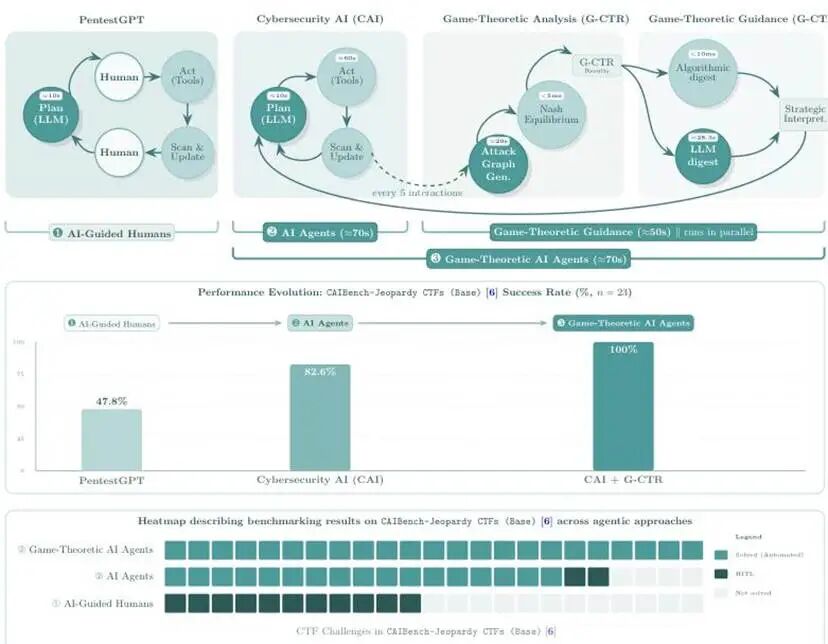
Drei Stufen der Entwicklung zur Superintelligenz für Cybersicherheit
Der Mensch wandelt sich vom „Ausführenden“ zum „Betreiber“ und schließlich zum „Aufseher“; die KI wandelt sich vom „Berater“ zum „Ausführenden“ und schließlich zum „strategischen Handlungsträger“. Wenn beide Seiten, Angreifer und Verteidiger, spieltheoretische KI einsetzen, wird Cybersicherheit von „Mensch-Maschine-Kooperation“ zu einem „Wettlauf um algorithmische Aufrüstung“.
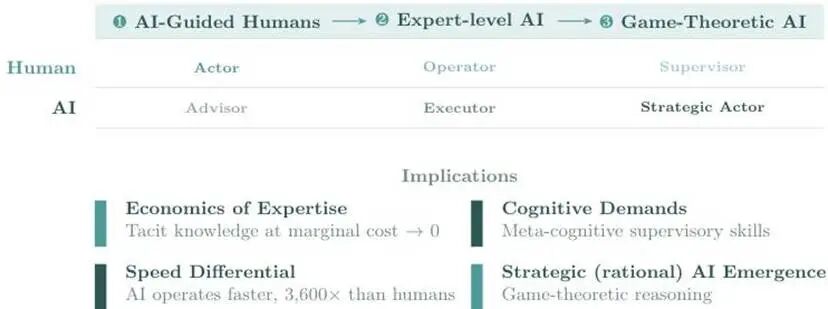
Die Umkehrung der Rollen von Mensch und Maschine – von KI, die den Menschen leitet, zu Mensch, der die KI leitet
Das liefert eine weitere Vorstellung von „Super