叫板英伟达霸权,谷歌“光网”凭什么?
海豚君上一篇中比对了两家专门给别人卖GPU厂商,也就是3P GPU——英伟达和AMD的数据中心组网竞争:
硬超英伟达GB300,AMD好不容易用博通的交换机把 Scale-up从8 卡堆到了 72 卡,做出来了Helios,但出货时的对手已变成了Vera Rubin,结果追平了GPU互联带宽,但成本经济性太差,而工程设计已经落后。
AMD 是迈过了及格线,但颇有种“拿前朝剑斩本朝官”的无力感。海豚君认为核心原因是其自研全栈的缺失。那么,把自研做到另一种极致是怎样的呢?
本篇将转向自研自用1P ASIC上的组网龙头——CSP巨头谷歌,粗看它的组网会发现:
一. Scale-Up域极庞大,接近万卡,作为对比,Vera Rubin, Helios仅72卡;
二.拓扑极特别,采用直连而非办公区(计算托盘)+调度室(交换托盘)=办公楼(机架)的交换式,是全网独一份的OCS交换机方案;
三是组网成本相对便宜,这当然归功于以上两点。
接下来,海豚君沿着这三个特点往下挖,研究下谷歌:
一、近万卡的Scale-Up域是如何实现的?
二、直连拓扑从v7到v8是如何演进的?
三、转向TPU-aaS商业模式后,谷歌方案有竞争力吗?
四、产业链上有哪些核心标的?
以下是详细分析
一、近万卡的Scale-Up域是如何实现的?
我们将以目前大规模部署的Ironwood v7作为基准。
1、互连协议:ICI撑起半片天
1)Pod内Scale-Up:走光、走电都是ICI
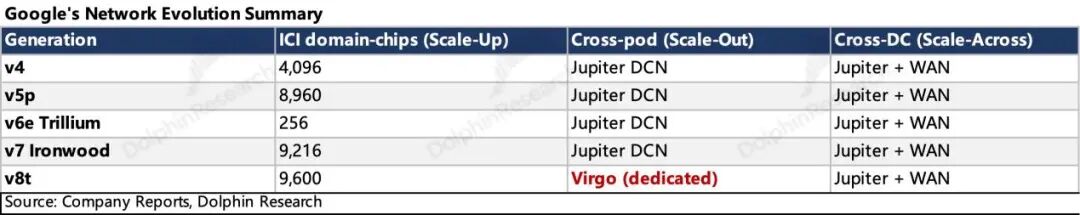
谷歌自研了专有的TPU间互连协议ICI(Inter-chip Interconnection,对标NVLink与UALink)。v8代际单TPU间聚合双向带宽2,400GB/s,相较v7代际1,200GB/s翻番(vs 英伟达3.6TB/s)。
Vera Rubin、Helios的方案中恰好是"一种协议、搭一种传输介质、搭柜内(外)",容易让人误以为三者是互相绑定的,但首篇已经说过,Scale-Up与Scale-Out的划分是基于通信语义而非物理形态。
而谷歌恰恰如此,在一定量TPU的Pod内,TPU间连接无论是否出柜、用光或电,都走ICI协议;只有超出这一规模,才切换到基于以太网的传统DCN协议。
2)跨Pod Scale-Out:“打酱油”的Jupiter DCN
v8之前,谷歌没为 Scale-Out 单独建网。原因在于 ICI 域足够大,带宽最敏感的张量并行和专家并行都留在 ICI 内部,压低了跨Pod的通信需求,带宽要求相对宽松,单卡带宽仅100Gbps。
因此跨Pod流量直接借用自研的通用 Jupiter DCN,也就是 Google 数据中心里所有服务器共用的那张通用以太网,搜索、广告、存储的流量都在上面跑。这意味着Jupiter DCN同时承载了前、后端流量(前端连接存储、CPU与外网,流量稀疏、可容忍抖动;后端连接加速器之间,需同步并行)。
2、组网方案:3D“搭积木”+还有OCS
组网其实就是拓扑——一张网络中东西之间互相如何连起来。海豚君前面两篇做解释的组网其实是多数数据中心都在用的组网2D胖树网络。
谷歌的拓扑是3D拼积木。谷歌组网从小到大为:芯片→托盘→立方体(Cube, 也就是Rack)→Pod/Superpod。与英伟达的方案比,芯片和托盘层,名字类似,但托盘组合起来,样子差别迥异。
1)Intra-Tray Scale-Up:物理排布1×4,拓扑逻辑2×2
托盘内由4颗TPU组成(见下图)。TPU间走ICI协议,每颗 TPU有6个ICI端口,聚合双向带宽1,200GB/s。TPU-CPU间通过PCIe(DAC)实现通信。
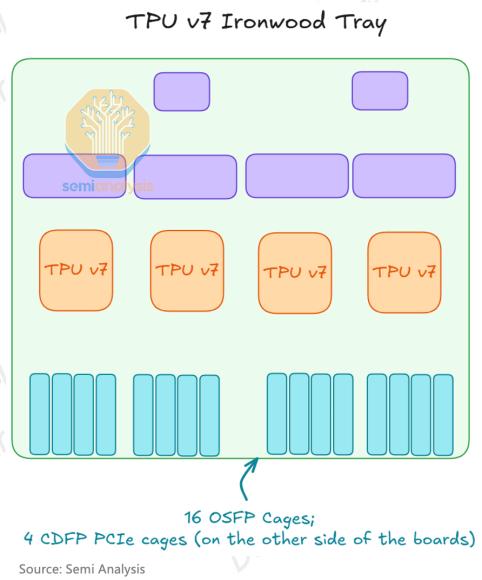
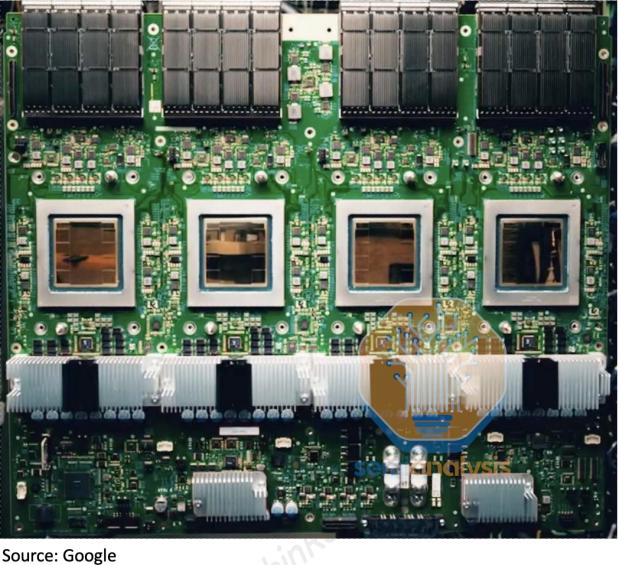
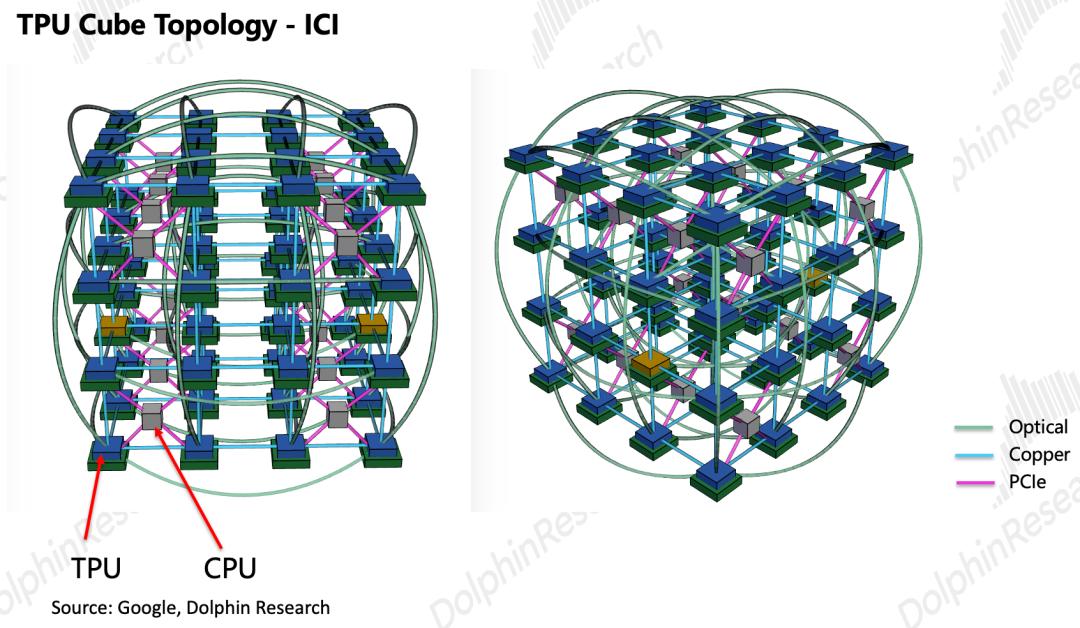
6 个端口的含义要先放到整体里看,Google把TPU排成一个三维网格,6 个端口分别连上、下、左、右、前、后(即 ±x、±y、±z)6 个邻居,这就是 3D torus(下图)。
回到托盘,可以看到托盘内4颗TPU排成一排,但他们并非两两互连的。6 个端口中4个要留给其他托盘上的邻居,板内只剩2个,每颗只能连2颗同板芯片。出板的4个端口接到哪里,就是下一节的跨托盘拓扑。
2)Tray-Tray Scale-Up:直连拓扑提供连通能力
与英伟达、AMD方案最大差别,同样在托盘间的Scale-up:谷歌不设交换芯片,TPU之间3D拓扑方式直连。
16个托盘,组成共计64颗TPU的立方连接体Cube(即机柜),芯片连接成4×4×4的3D拓扑结构,把每颗芯片当成一个6面的连接长方体,六个方向分别拉线,与相邻芯片直连。
观察下图的拓扑,可以看到部分TPU除了铜缆连接,还拉出了光缆,这是怎么回事呢?
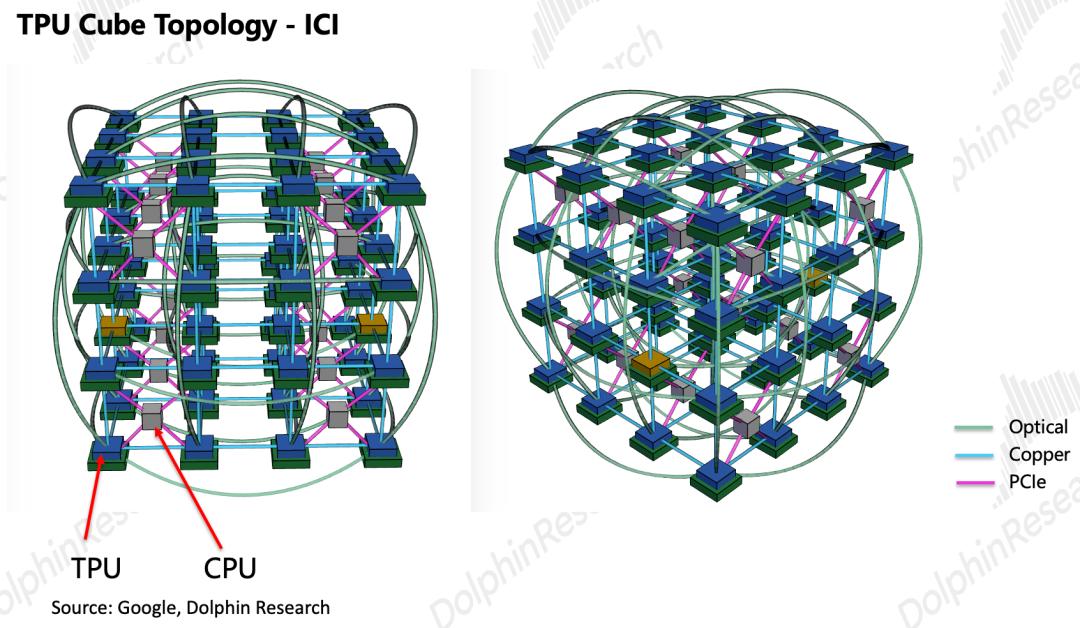
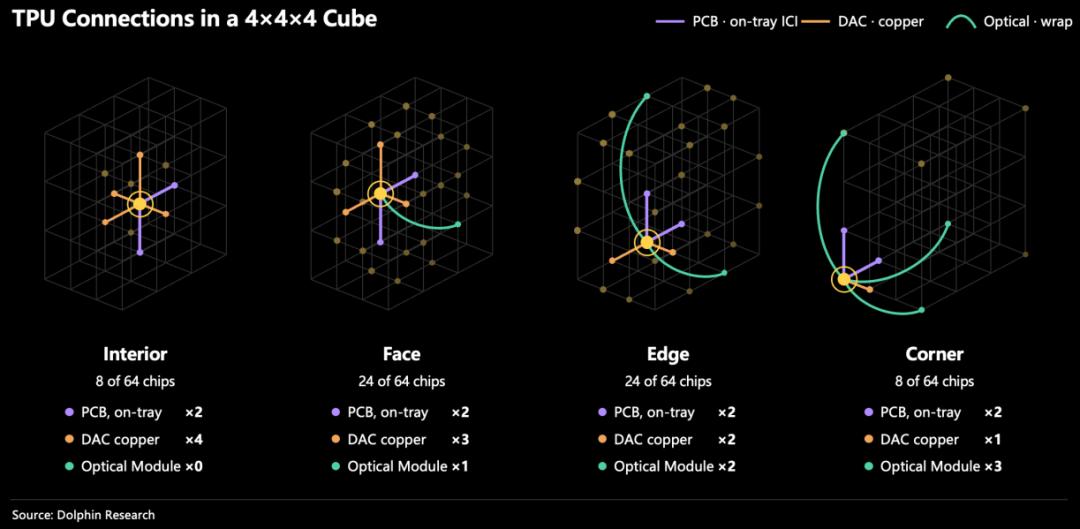
走铜还是走光取决于TPU在域内的位置。单一64芯组成的Cube内部,最里面的8 颗TPU 都能用Copper(DAC+PCB)与全部 6 个相邻 TPU 完全连接。
把这64芯组成的立方体作为单一Cube个体,边线上的TPU由于部分面无相邻 TPU,它就以光连接到这个立方体对侧的 TPU(见绿线),每条外边上的TPU首尾相接,该连接经光模块转为光信号、汇入OCS交换机。我们整理了位于Cube不同位置(内部、表面、棱、角)上对应的连接器件与参数,如下所示。
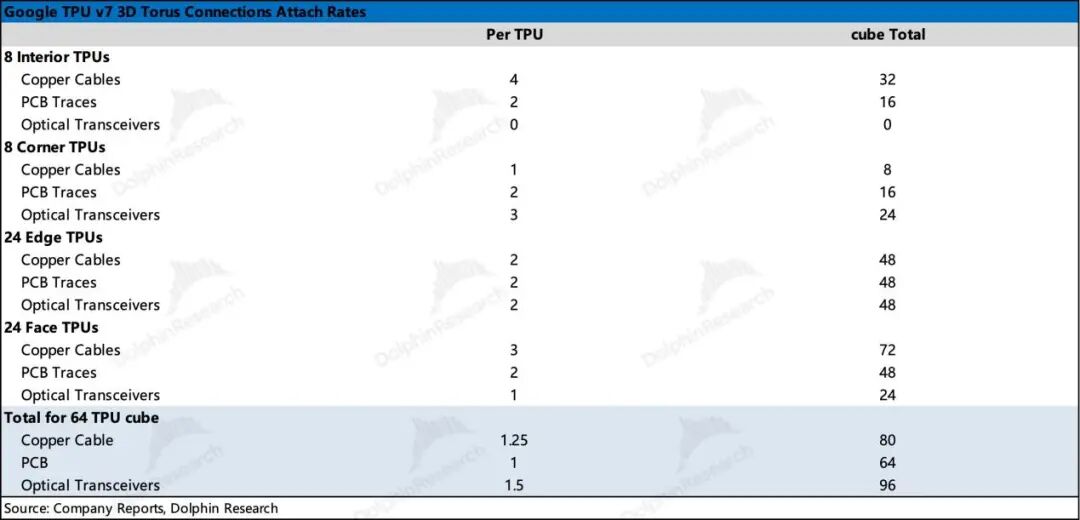
Scale-Up层直接上光,是谷歌独有的设计。Vera Rubin NVL72与Helios的Scale-Up全程是铜:GPU 经背板铜缆接 NVSwitch/Tomahawk,光模块只在Scale-Out的网卡和交换机上出现,GPU本身不接光。
而谷歌的光模块直接插在TPU 托盘前面板的 OSFP 笼子里,光路是 TPU → 光模块 → 光纤 → OCS → 光纤 → 光模块 → TPU,中间没有任何电交换设备。
3) Cube-Cube Scale-Up:OCS是什么?
上文说到Cube外表面的光缆连接会汇入到OCS交换机。事实上,在谷歌更大的网络规模中,它也会负责把多个Cube拼成更大的域:Pod (如4个Cube、256颗TPU) 直至Superpod (上限144个Cube、9,216颗TPU)。这是谷歌最与众不同的网络硬件:
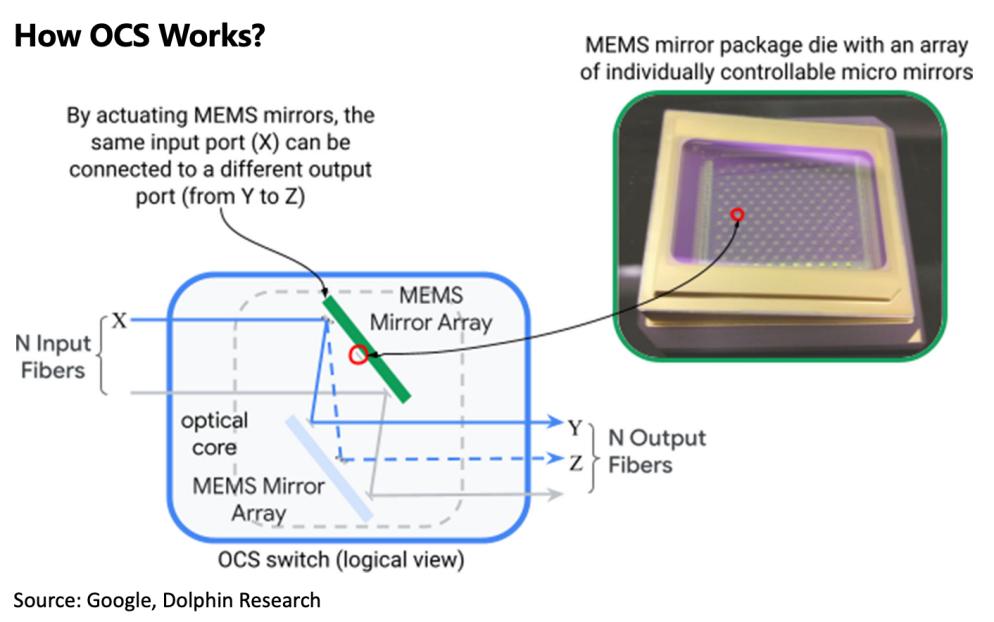
a. OCS交换机只负责重定向光信号。Cube外表面的信号链路经过光模块接入OCS,由 OCS决定每条链路的另一端是自环成 64 芯片 torus还是拼成更大的 torus。OCS 只负责把光从一个端口导向另一个端口。
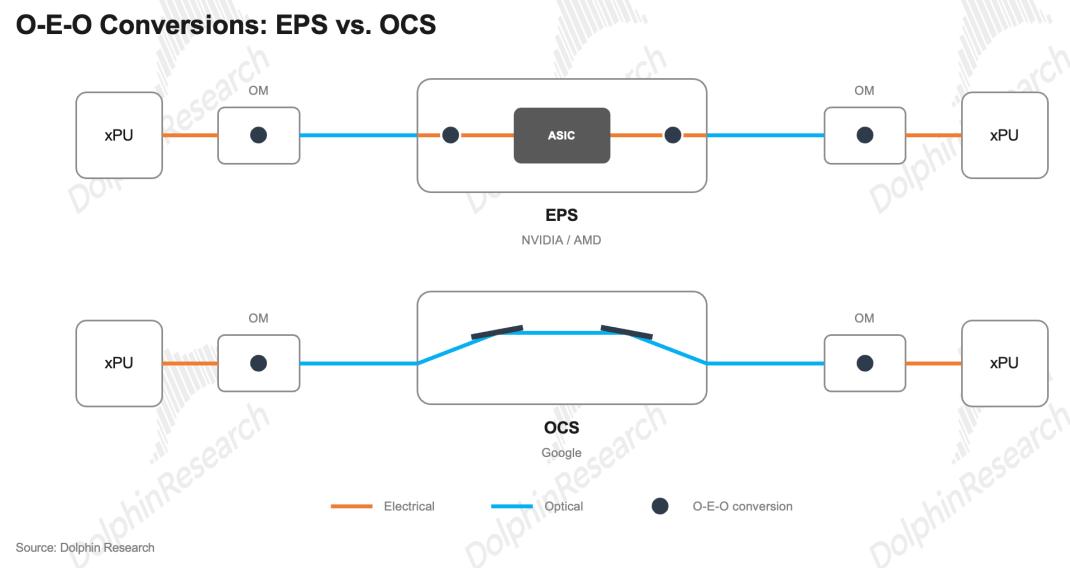
b. 光信号如何交换?OCS内含两组二维MEMS微反射镜阵列,通过每面镜双轴倾转,把任意输入端口的光束"导向"任意输出端口(见下图)。与EPS(电子分组交换机,AMD&英伟达方案)本质区别是:EPS对每个数据包实时做转发决策,OCS 建立的是端口间的静态光路。
举例来说,如果原本是1号端口与2号端口对接,现在要让1号与4号通信,OCS 必须重新配置反射镜,因为OCS没有转发功能;而传统 EPS 端口本就全互连,无需重配置。
一个形象的例子是,好比铁路道岔,轨道可以多条,但同一时刻只走一条,改道必须扳道岔(即调整镜面角度)。
因此,也可以说谷歌的路由路径是由软件提前配置好的,因为在同步并行的低延迟工作负载中花上几秒进行重配置几乎是不可能的。
c. OCS交换机中没有O(光)-E(电)-O(光)的转换过程。我们知道在常规的EPS中,信号出柜通信的路径是:芯片发出的是电信号,先在本柜光模块转成光(E→O),经光纤到交换机。
交换机只认电,入口再转回电(O→E),交换芯片决定转发到哪个端口,出口再转成光(E→O);经光纤到对侧机柜,光模块转回电(O→E),送进芯片。
OCS省掉的就是交换机里的两次光电转换,也是这张网里唯一的"交换"设备,却不用承担交换ASIC的功耗与成本。示意图如下:
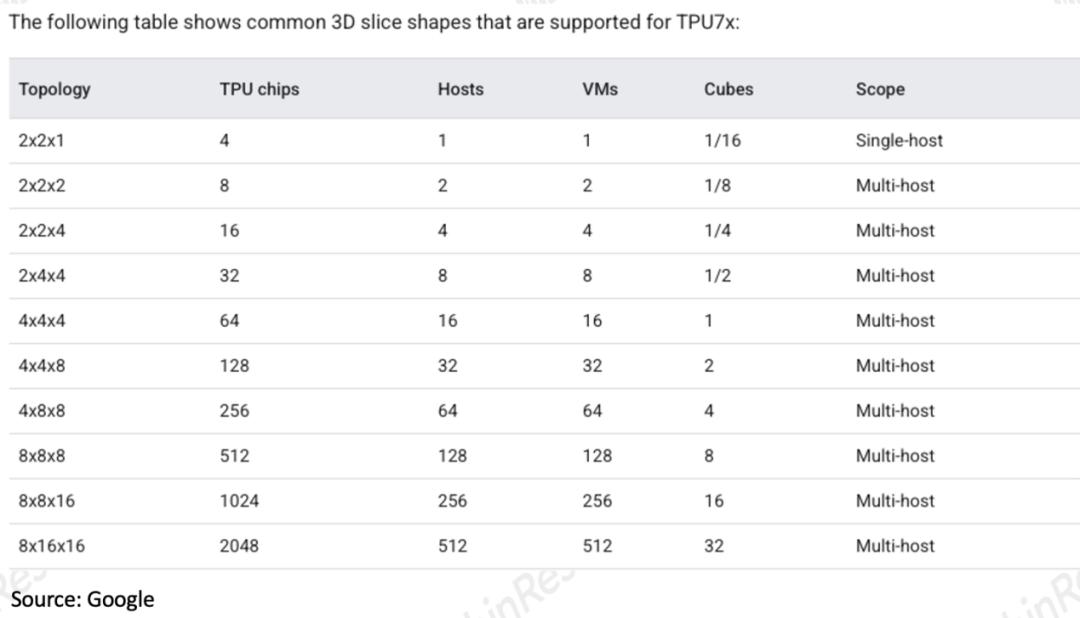
d. 灵活的拓扑规模。在实际落地中谷歌未必以标准的Cube(64颗TPU)进行拓展,谷歌能够把 TPU配置成从 4 颗一路到 2,048 颗之间的常见切片规模,这也是OCS交换机预先配置给予的灵活度。
4)Superpod-Superpod Scale-Out:OCS替代Spine层的野心
出了 ICI 域,就进入 Scale-Out。这张网的核心器件,仍然是 OCS。
对照上篇:英伟达、AMD 的胖树(Leaf-Spine)架构以 EPS 为核心,有两个痛点。一是耗电;二是网络速率 2-3 年翻番,Spine 层跟着整体换代,资本开支巨大。
谷歌的思路是在ToR层仍然使用以太网交换机(自研白牌交换机,Switch ASIC预期为博通),尽可能替代Spine层(如下图所示,常见方案下ToR上连接Spine,而谷歌方案下连接OCS)。这带来了两点优势:
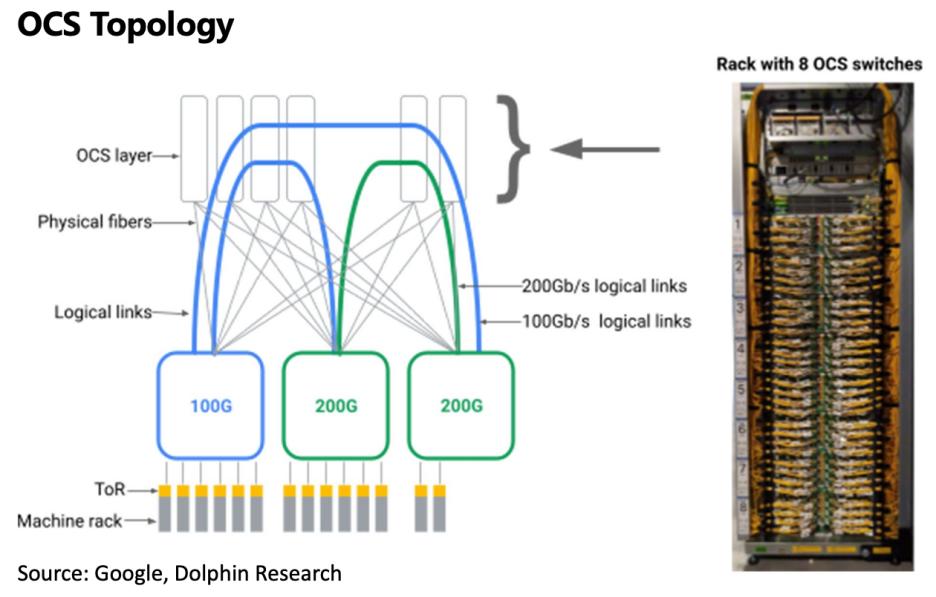
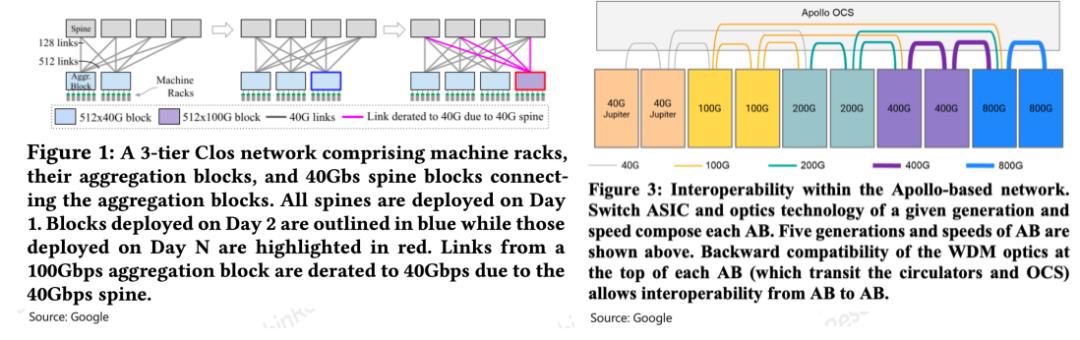
强兼容性带来的成本节约。OCS 只反射光、不认速率,能把不同代际的交换机接在同一张网里(下图右),而整体网络速率不会被最慢代际拖累(下图左,传统网络架构)。意味着一旦OCS部署完成,就可以将交换机和光模块升级到速率快得多的新一代产品,而无需更换网络的Spine层,换机周期更长,更省钱。
低时延低功耗。光电转换的步骤是有时延的,OCS只是把入射光从源端口反射到目的端口。当然这也降低了整体的功耗。
当然OCS也不是完美方案,除了上文说的在工作负载时网络重配置难以实现,还有一个关键点是放弃了和其他EPS通用方案混用的灵活性,毕竟网络是需要基于OCS进行设计的。此外在可靠性、插入损耗等方面,都是略落后于EPS的。
3、小结
我们认为,谷歌的组网方案,本质上建立在其软件栈优势之上。直连 torus 省掉了交换芯片,也就意味着网络里没有设备在运行时做转发决策。前提是拓扑和路径都在任务开始前由软件定好:Cube自环还是拼接、切片的规模大小等都是OCS的配置,不涉及物理布线。Scale-Out以OCS取代电Spine也是同一逻辑。换言之,谷歌把"智能"从交换芯片搬到了配置期,硬件只需提供固定、便宜的直连链路。
对客户而言,这是一笔确定性换灵活性的交易。路径提前固定,不存在运行时的拥塞绕行,性能在任务跑起来之前就是可算的。
代价是跑起来之后没有临场补救的余地。进一步的,只有谷歌自己的编译器知道这些芯片是怎么连的,客户因此必须留在 XLA/JAX 体系内,CUDA侧的迁移也是个问题。
二、直连拓扑从v7到v8是如何演进的?
谷歌为v8代际训推分家的TPU制定了网络优化,组网方案的演进概括来说就两点:
- 训练侧的v8t沿用 v7拓扑,把带宽和规模做大,新建后端专用网络;
- 推理侧的 v8i 改拓扑,把跳数压低。
1、v8t(训练):带宽翻倍、ICI域扩至9,600颗、新建Virgo后端
带宽翻倍,拓扑延续。单TPU双向带宽翻倍至2,400GB/s,托盘与Cube延续v7的3D torus;ICI域上限从9,216颗扩大至9,600颗。
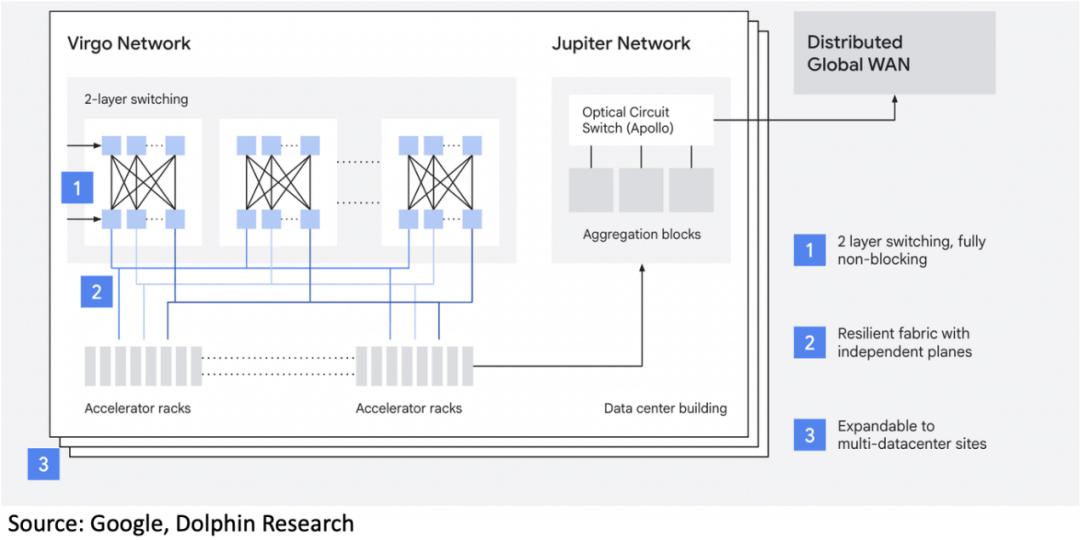
Scale-Out不再借用Jupiter。前后端共网的安排到 v8 难以为继,主要是因为:训练集群逐渐超出单个ICI域,跨Pod流量不再只是数据并行的梯度同步,单芯片带宽需求激增,训练的毫秒级同步突发与推理的延迟一致性要求,与通用网络相悖。
因此,谷歌为v8t新建专用后端网络 Virgo,承接跨Pod的Scale-Out流量,单芯片 Scale-Out带宽提升至v7的4倍(即400Gbps)。当训练突破单DC的电力与空间上限后,需跨 DC 组成统一域,Jupiter继续负责前端网络并作为Scale-Across的出口,可在单一训练集群内扩展到超过100万颗TPU。
2、v8i(推理):托盘全互连、改用Boardfly压低跳数
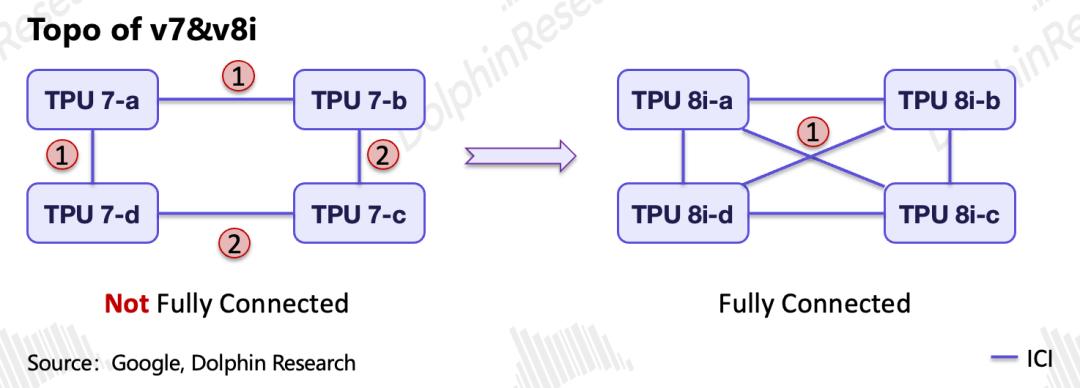
托盘内全互连。单托盘4颗芯片经内部ICI实现了全互连,节省了对角线位置(如a与c)的TPU通信的跳数,即从2跳变为1跳(见下图)。
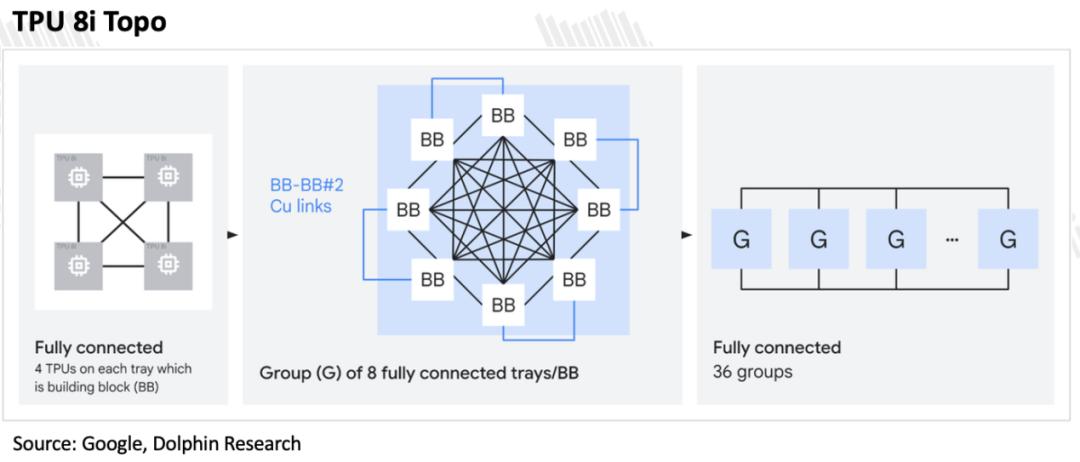
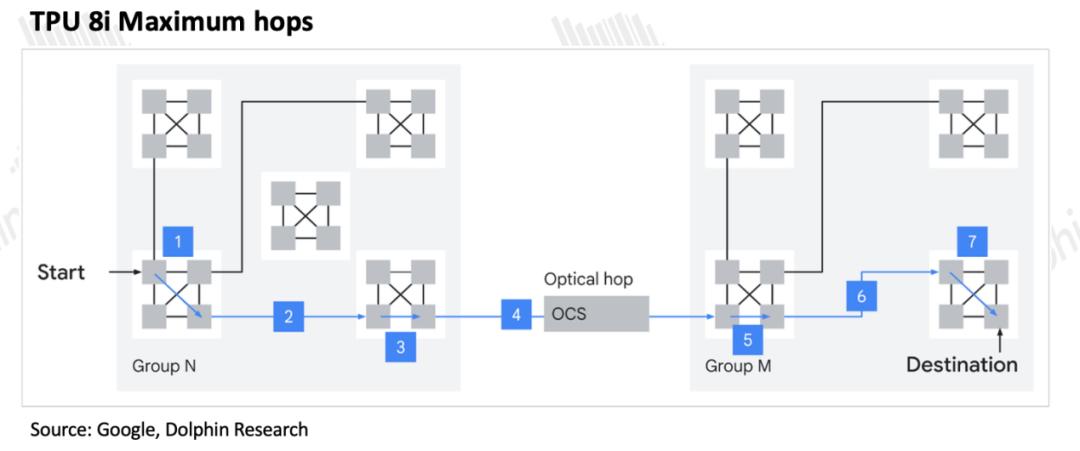
Cube层改用分层拓扑Boardfly。每托盘对外提供16条链路,8块托盘用其中11条经铜缆全互连为一个 Group,余5条经光模块接入 OCS;36 个Group经OCS直连成pod,合计1,152颗,其中1,024颗活跃(见下图)。
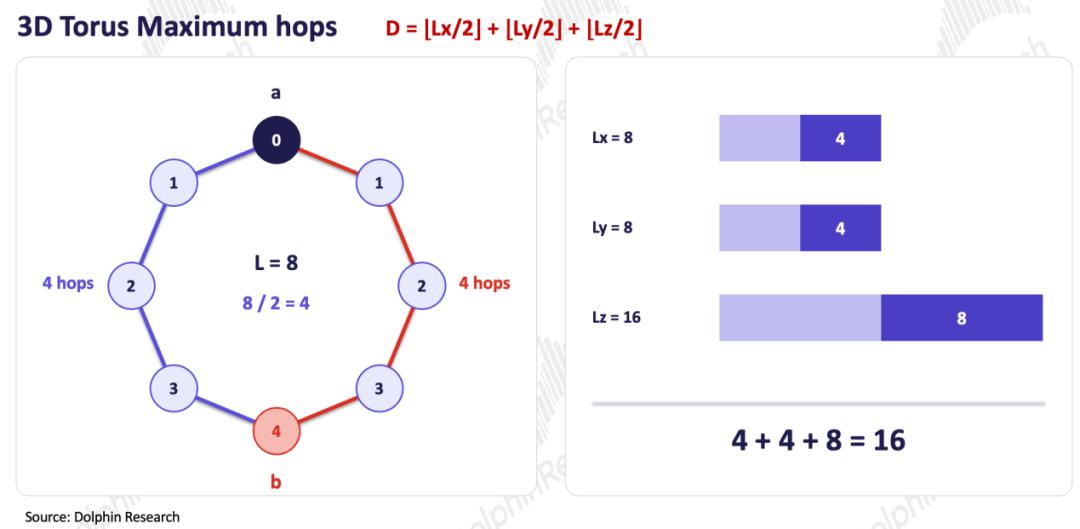
推理侧拓扑改动的直接收益体现在网络直径上。在同为1,024颗(8×8×16)芯片的域,3D torus拓扑最多需16跳:torus 的每一轴都是首尾相接的环,环上最远距离是半圈,三轴互相独立、路程相加,即 4+4+8=16 跳;Boardfly最多仅需7跳(两者路径见下图)。网络直径减少超50%可直接转化为更低的尾部延迟,降低用户侧感知的延迟,对推理为主的Agent工作负载十分重要。
3、至此,我们结束了谷歌组网方案、演进关系、优劣势等话题。在进入竞争力的讨论之前,先对其组网方案做一个小结:
- Scale-Up层:自研ICI协议,3Dtorus直连而非交换式,域内没有交换芯片;芯片间走铜缆还是光由其在Cube中的位置决定;OCS只配置Cube间光路,使torus可切片、可容错、可拼至近万卡。v8i为推理场景改用Boardfly拓扑,降低了最大跳数。
- Scale-Out层:v8之前借用通用 Jupiter DCN(以OCS取代电Spine,前后端流量共网);v8t新建专用后端网络Virgo,单芯片Scale-Out带宽提升至4倍,Jupiter退回前端并承担Scale-Across。
- 关键硬件OCS出现在两层网络之中,在牺牲了一定灵活性与性能的同时,提升了兼容性,达到了降本的效果。
三、转向TPU-aaS商业模式后,谷歌方案有竞争力吗?
1、路径方案的取舍
谷歌与AMD、英伟达其实并非完全可比,我们将可比项加了底色(绿色为领先,红色为落后),其余维度是只能说路径方案之间的取舍,具体来看:
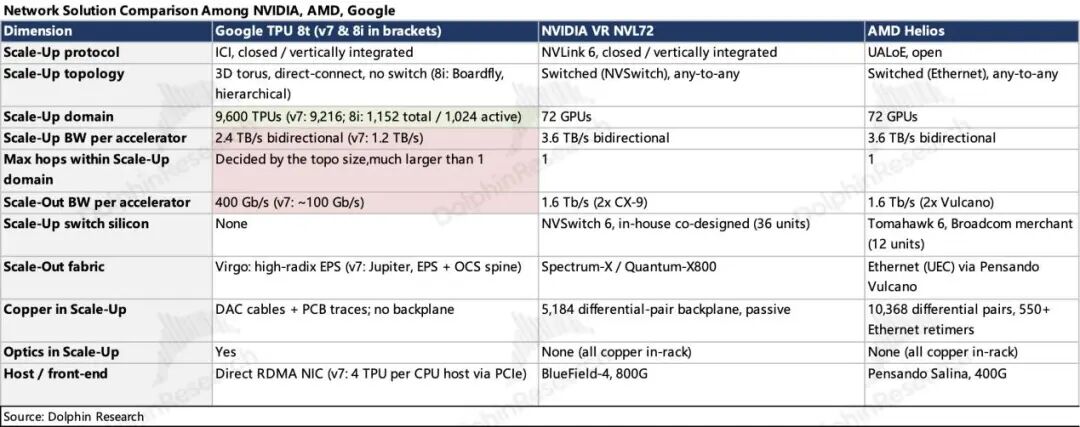
牺牲单卡带宽扩大域规模。单看协议带宽,ICI的2,400 GB/s落后于NVLink 6与 UALoE 的 3,600 GB/s,但 Scale-Up 域差距悬殊(9,600 颗 vs 72 颗)。集群一旦超出单机柜(如千卡),NVIDIA、AMD 方案必须走Scale-Out,存在带宽落差(单卡Scale-Out带宽放缓至200GB/s)和协议转换开销;谷歌在此规模下仍在Scale-Up域内,未必处于劣势。其Scale-Out较低的带宽也是ICI域足够大的结果。
牺牲跳数节约交换芯片。交换式拓扑下任意两颗 GPU 均为单跳;torus 中通信须沿轴逐跳转发,网络直径随规模上升。省掉交换芯片后,扩展不再受交换端口数与铜缆长度约束。
2、以上取舍如何反映到组网成本上?
我们进一步测算了谷歌单机架网络物理层的成本(外采口径),如下所示:
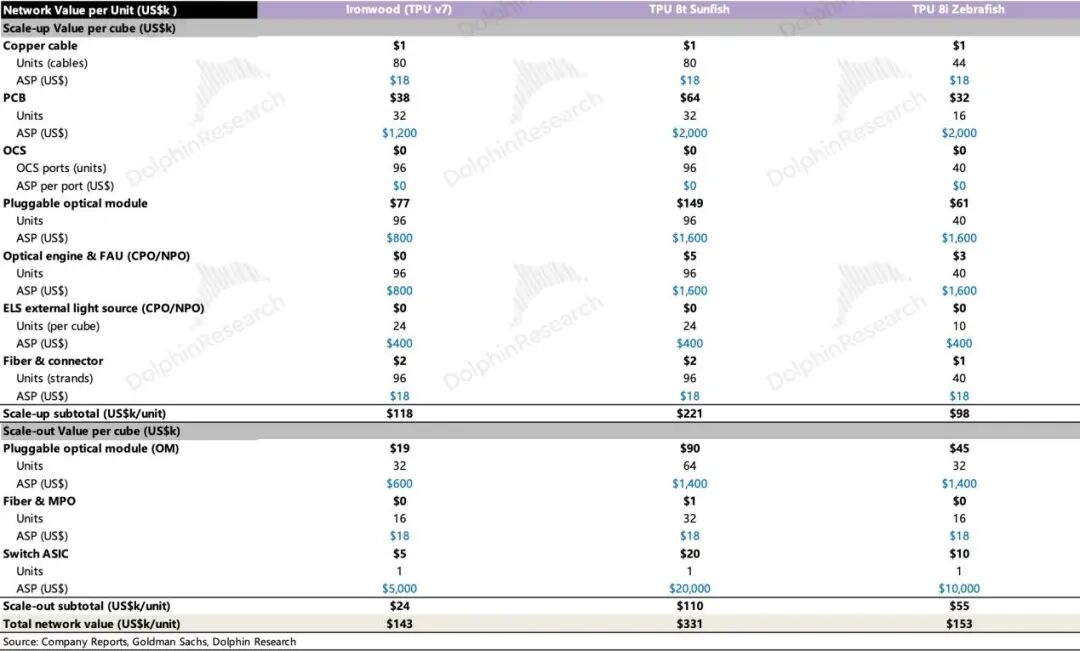
根据海豚君测算同等算力下的单芯组网成本,v7 极具性价比,算力与 GB300 相当,网络成本只有三分之一。到了v8,两颗芯片的分化本身说明了Google的组网思路:训练芯片为万卡域付网络溢价,推理芯片用小域把网络成本摊薄。
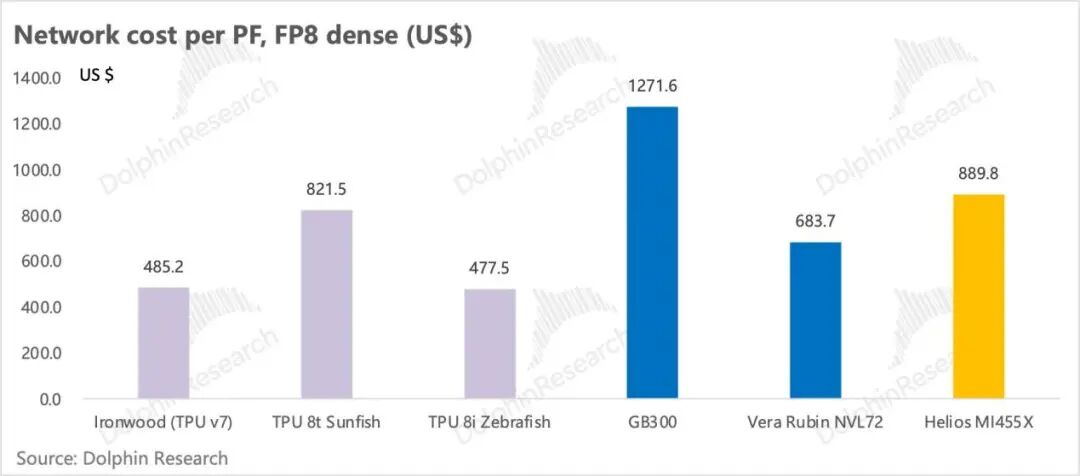
那么在实际工作负载中又怎么样呢?我们就不能局限于单芯片成本了,我们也在上文强调了OCS交换机替代Spine层将节省开支。
谷歌的v8t的拓扑下,每 9,600 颗一个 ICI 域,每个域 48 台 OCS。域内规模扩大增加的是每台的端口占用,交换机数不变(见下表);跨域后按域数线性增加。

例如10万颗TPU的训练集群,谷歌只需约1000台OCS,同算力下,Vera Rubin 胖树架构下需要近2600台交换机(144端口)。事实上只要在因此在大集群项目中,或许确实能节省开支。
3、小结
回到竞争力的问题,显然这不是简单回答谁强谁弱的问题。如果说AMD是靠抄答案迈过及格线,那么谷歌是完全换了解题思路。它没有在英伟达的互连框架里正面硬刚,在这个框架中,跟随者无论在产业链整合能力、方案迭代速度还是软硬件协同能力上,都很难追赶上英伟达的步伐。
谷歌做的是充分发挥自己软件栈的能力优势,靠组网上的取舍换竞争力。单卡带宽落后三分之一,多跳拓扑的延迟不及单跳,这两项是谷歌自己选择的代价;换来的是近万卡的 Scale-Up域,以及每芯片约一半的组网成本。根据第三方InferenceX实测,Ironwood在原始性能曲线大部分区间里跑不赢GB,却在每芯片小时成本中胜出。
这一取舍的吸引力正在显现:Anthropic 2025年7月就与谷歌签订了近100万颗的TPU订单,而在近期2,000 亿美元的融资计划中超75%与TPU挂钩。TPU也将从谷歌的内部自用方案,转向TPU-aaS的商业化,作为可被外部前沿实验室规模采用的算力选项,极有可能成为英伟达的竞争对手。
四、产业链上有哪些核心标的?
1、一些类似逻辑的产业链
我们已经在上篇中对英伟达、AMD组网方案的产业链逻辑进行了梳理,事实上大部分核心标的也是与谷歌的供应链重复的,谷歌最为特殊的OCS 及其器件链将在后文展开。
a. 从谷歌自身的组网演进迭代来看对产业链的影响:
- 计算托盘:最为核心的下一代TPU ASIC的供应商将引入联发科,我们已经对此进行了跟踪点评,请参见。
- v8t:由于延续v7的拓扑架构,我们预期产业链不会产生较大的变动。
- v8i:面向推理场景优化了组网拓扑。硬件升级同样带来单位价值量的提升,但Boardfly拓扑相比 3D torus,互连器件用量普遍更少。
综合来看,上文测算中的 v8t 并非性价比之选:折算到单位算力,它的网络成本高于 Vera Rubin,只是在大规模集群里靠省掉 Spine 层的交换设备扳回一部分。而按谷歌在 Cloud Next 2026 的口径,推理已占AI加速器周期的70%以上,TPU 从训推一体走向训推分化后,若8t出货不及预期,事实上是对谷歌链的利空。
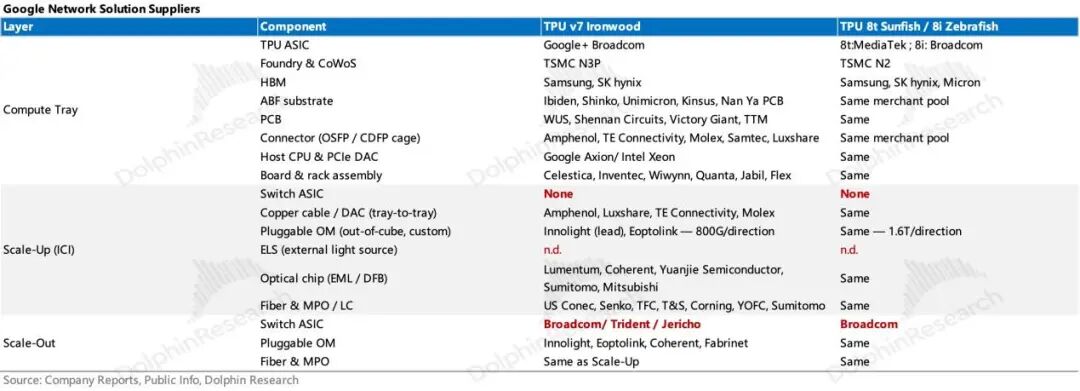
b. 从价值量角度考虑,谷歌的组网方案中价值量最高的环节毫无疑问是光连接,接着是PCB>交换>铜。
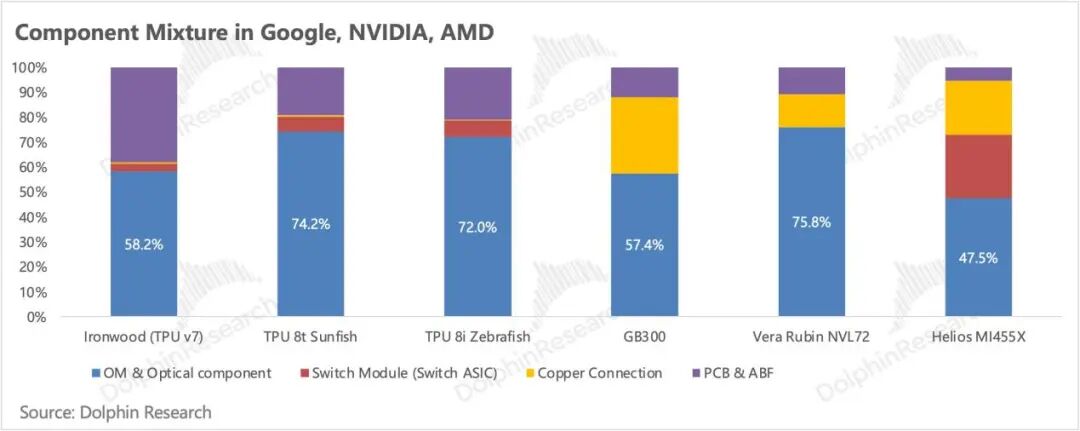
- 光模块是增量最大的部分。不同于OCS交换机在组网方案中保持恒定48台,我们测算的光模块/TPU配比高达1.5,这意味着组网中每增加一颗TPU,就需要增加1.5颗光模块。且速率提升(800G向1.6T)连同技术演进(可插拔向NPO/CPO)将带来ASP提升,英伟达、博通等巨头的入场,基本确立了其量价齐升的逻辑。具体内容请参见技术演进、产业链梳理。
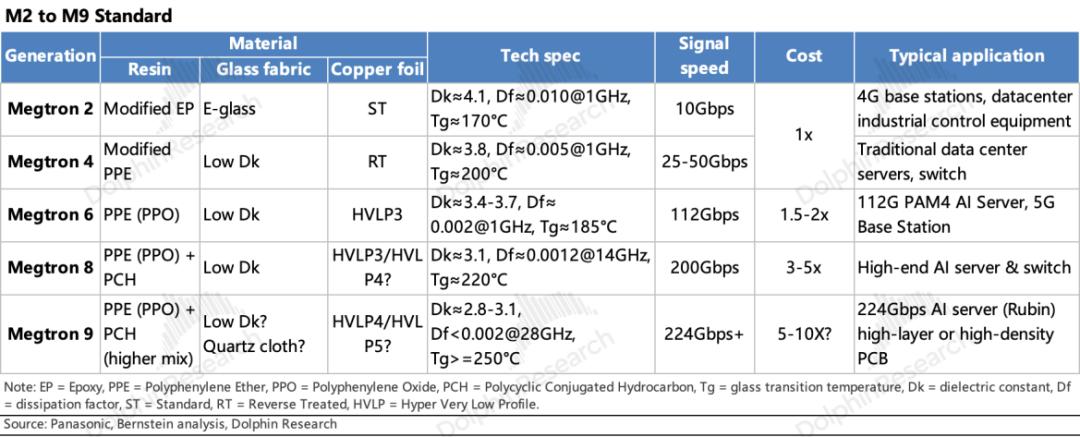
- 次高价值环节是PCB板,逻辑与英伟达方案类似,量价演进对PCB的面积、材料、层数提出更高要求;尽管直连拓扑设计使Ironwood对PCB走线传递信号的能力要求较为宽松,但普遍预期8t将采用M9(松下制定的行业标准,即低Dk&Df,M2-M9的强度依次增强)的PCB板,提升该环节的ASP。量上由大规模组网推动。也是确定性较强的环节。
- 此处的交换ASIC指Scale-Out交换机内的芯片,主要由博通供应。当然我们也不能排除谷歌后续和Marvell、ALAB合作,正如它对待TPU供应三心二意一样。但这一增量只会存在于超出ICI域的场景。
- 铜缆在谷歌方案中基本是边角料,且下一代方案拓扑架构的延续意味着也不会对DAC进行升级(如AEC),我们在下篇AWS中讨论这一环节。
以上环节的产业链梳理请参考上篇。
2、核心差异是OCS产业链
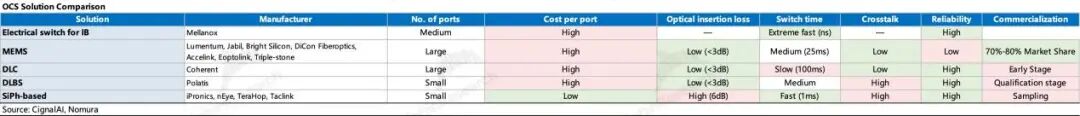
OCS交换机涉及到了谷歌两层的组网。市面上目前有四种常见的 OCS 技术路线(见下表),其中 MEMS 方案应用最广、最成熟,光路相对简单,代表厂商为谷歌与 Lumentum。行业的演进方向是从"谷歌独有方案"向"产业通用方案",MEMS-OCS 的渗透率有望进一步提升。
我们在前文说过,通过调整MEMS倾角就可以调整光路实现“交换”的功能,但是倾多少度才算对准?光束要从1号口精确落进4号口那根比头发丝细得多的光纤芯里,对各部件精度要求很高。按照光路顺序:
- 光纤准直器阵列:光的进出口。光从光纤里出来是散的,准直器把它梳成一束平行光;出口处反过来,把光收回光纤。
- 透镜阵列:聚焦。保证光束落在镜面和光纤芯的正中。
- MEMS 微镜阵列(两组):每面镜子可双轴倾转,改倾角就改光路,相当于一排可转动的道岔。
- 分色分束器:可理解为按波长分流的"单向玻璃",透过一定区间波长的光,反射另一区间波长的光。用它把两种光合到一起,或者分开。
- 注入模块:发出探针光。
- 相机模块:盯着探针光的落点。
谷歌的办法是给信号光配一束"引路光":OCS 内有两路光同路而行,1310nm 信号光承载业务数据,850nm 探针光专用于监测MEMS阵列的对准,探针光必须与信号光走完全相同的路径,以反映信号光的偏差。但在输出端口,我们只需要1310nm信号光,两种波长光分离由分色分束器完成。
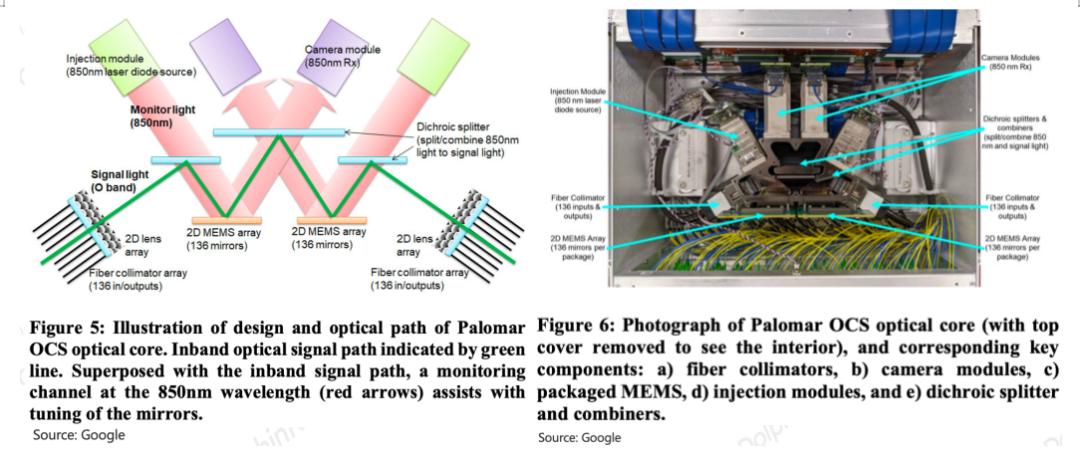
谷歌自研了整套系统的架构、注入模块&相机模块等控制部分。而上游的无源光学器件,包括MEMS微镜阵列、分色镜、光纤准直器阵列、透镜阵列都是外采,占到单机成本的60%-70%。因此,我们建议关注谷歌MEMS链条中的上游供应商,如下:
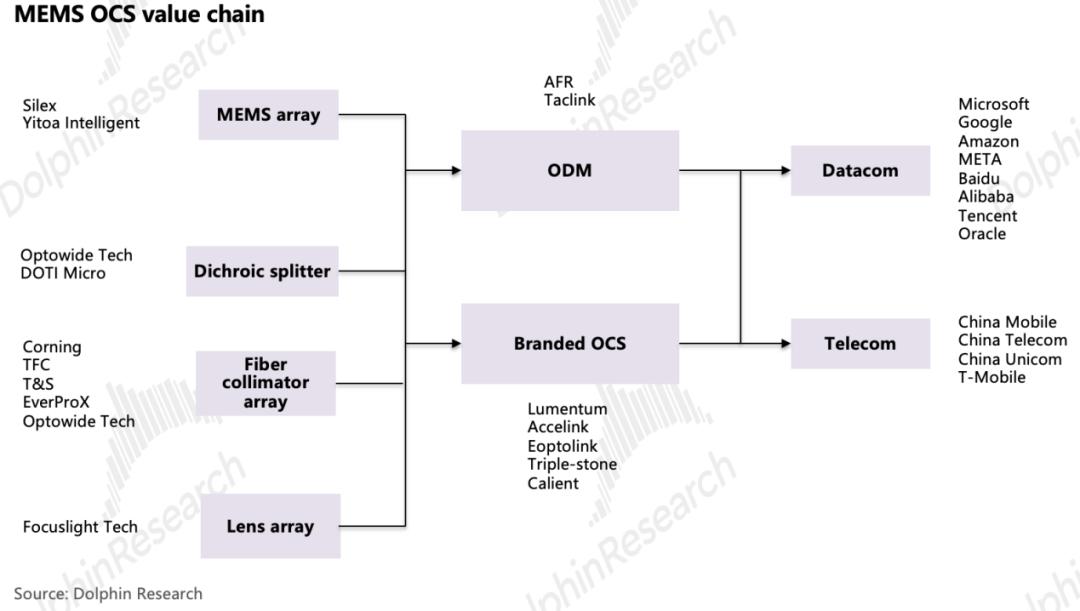
上游器件供应:
1)MEMS微镜阵列:按价值量看最值得关注的是MEMS微镜阵列中的芯片,占单台OCS物料成本约30%-40%。赛微电子通过瑞典Silex为谷歌独家代工 MEMS-OCS芯片,该芯片是谷歌TPU集群光交换系统的核心组件。国内英唐智控下属6寸MEMS晶圆厂(对标赛微 8寸产线),具备 MEMS 芯片阵列的生产能力。
2)分色分束器:腾景科技供应棱镜、滤光片等 OCS 交换机核心光学器件,产品通过谷歌白名单,同时绑定谷歌光模块供应商。客户覆盖Lumentum、Coherent、光迅科技等。
国内东田微、海泰新光、水晶光电、福晶科技等在同一镀膜平台上从滤光片、二向色镜、分光镜切入,目前多处于送样或试制阶段。
3)光纤准直器阵列:康宁全球主供;太辰光、天孚通信为二级供应商。腾景科技是Coherent在准直阵列上的第三方采购来源。
4)透镜阵列:炬光科技是 Lumentum 在透镜阵列上的核心供应商;同时正向Coherent送样液晶方案2D准直器产品。
中游整机与代工:
谷歌2026年OCS规划自产 12,000–14,000 台、对外采购 6,000 台,外采计划由Lumentum与另一家平分(大概率是Coherent),但因实际出货未达预期,谷歌已向采用压电陶瓷技术(DLBS)的Polatis下达订单。国内进展较快的整机自供厂商有光迅科技,其MEMS微镜阵列芯片、光纤阵列单元、精密耦合封装工艺均为全栈自研。
谷歌的代工厂主要是国内的光库科技,市场普遍认为其是谷歌MEMS-OCS第一大供应商,占谷歌采购份额七成以上。
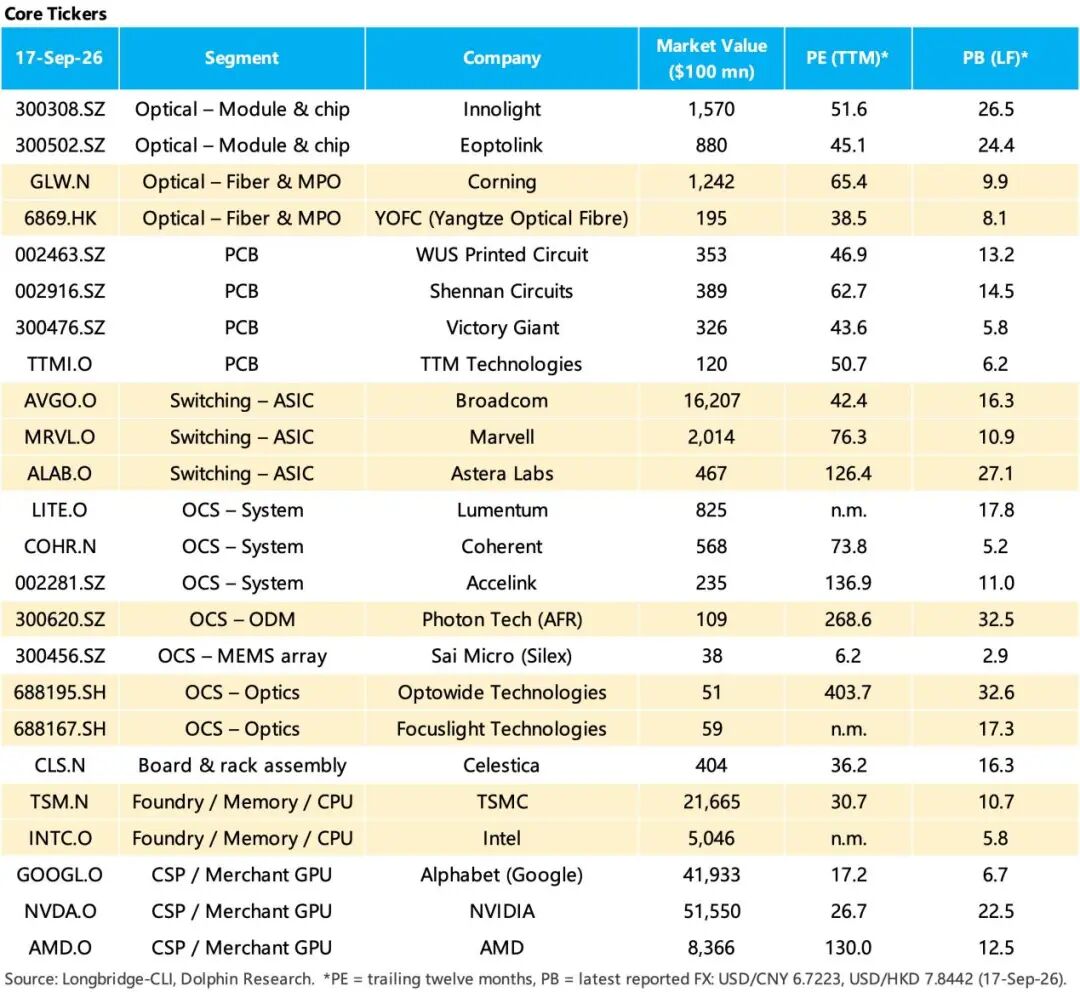
谷歌链条上的核心资产,海豚君整理如下:
下一篇将梳理AWS与华为的组网方案,敬请关注!
本文来自微信公众号“海豚投研”(ID:haituntouyan),作者:海豚君,36氪经授权发布。