Womit kann Googles „LightNet“ die Vorherrschaft von Nvidia herausfordern?
In dem vorherigen Artikel von Dolphin Jun wurden die Datenzentrum-Netzwerkwettbewerbe zwischen zwei Herstellern verglichen, die speziell GPUs für andere anbieten, also 3P-GPU – Nvidia und AMD:
AMD hat sich bei der Übertreffung von Nvidias GB300 schwergetan, mit Switches von Broadcom gelang es ihm endlich, das Scale-Up von 8 Karten auf 72 Karten zu stapeln und Helios zu entwickeln. Aber als die Auslieferung begann, war der Konkurrent bereits Vera Rubin. Das Ergebnis war, dass die GPU-Interkonnektivitätsbandbreite gleichgezogen wurde, aber die Kosteneffizienz viel zu schlecht war, und das technische Design bereits zurückgefallen war.
AMD hat die bestandene Prüfungsgrenze überschritten, aber es fühlt sich an wie das Ohnmachtsgefühl, "das Schwert der vorherigen Dynastie zu nehmen, um die Beamten der aktuellen Dynastie zu bestrafen". Dolphin Jun glaubt, dass der Kerngrund das Fehlen seines selbst entwickelten Full-Stacks ist. Also, wie ist es, die Eigenentwicklung auf ein anderes Extrem zu bringen?
In diesem Artikel wenden wir uns dem Netzwerkführer im selbst entwickelten und selbst genutzten 1P-ASIC zu – dem CSP-Giganten Google. Wenn man sich sein Netzwerk grob ansieht, stellt man fest:
Erstens ist die Scale-Up-Domäne extrem groß, fast 10.000 Karten. Zum Vergleich: Vera Rubin und Helios haben nur 72 Karten;
Zweitens ist die Topologie extrem speziell: Sie verwendet Direktverbindung anstelle des Vermittlungsstils "Bürobereich (Rechenablage) + Vermittlungsraum (Vermittlungsablage) = Bürogebäude (Rack)", und es ist das weltweit einzigartige OCS-Switch-Lösung;
Drittens sind die Netzwerkkosten relativ niedrig, was natürlich auf die beiden oben genannten Punkte zurückzuführen ist.
Im Folgenden wird Dolphin Jun entlang dieser drei Eigenschaften weiter graben und Google untersuchen:
1. Wie wird die Scale-Up-Domäne mit fast 10.000 Karten realisiert?
2. Wie hat sich die Direktverbindungstopologie von v7 zu v8 entwickelt?
3. Ist Googles Lösung nach dem Übergang zum TPU-aaS-Geschäftsmodell wettbewerbsfähig?
4. Welche Kernziele gibt es in der Industriekette?
Hier ist die detaillierte Analyse
1. Wie wird die Scale-Up-Domäne mit fast 10.000 Karten realisiert?
Wir nehmen das derzeit in großem Maßstab eingesetzte Ironwood v7 als Referenz.
1. Interkonnektivitätsprotokoll: ICI trägt die Hälfte des Himmels
1) Scale-Up innerhalb des Pods: Sowohl optisch als auch elektrisch läuft es über ICI
Google hat das proprietäre Inter-TPU-Interkonnektivitätsprotokoll ICI (Inter-chip Interkonnektion, vergleichbar mit NVLink und UALink) selbst entwickelt. In der v8-Generation beträgt die aggregierte bidirektionale Bandbreite zwischen einzelnen TPUs 2.400 GB/s, was sich gegenüber 1.200 GB/s in der v7-Generation verdoppelt hat (im Vergleich zu 3,6 TB/s bei Nvidia).
In den Lösungen von Vera Rubin und Helios gilt genau "ein Protokoll, ein Übertragungsmedium, innerhalb/außerhalb des Schranks", was leicht zu der Irrtum führt, dass die drei miteinander verbunden sind. Wie aber im ersten Artikel erwähnt wurde, basiert die Trennung von Scale-Up und Scale-Out auf der Kommunikationssemantik, nicht auf der physischen Form.
Aber genau das ist bei Google der Fall: In einem Pod mit einer bestimmten Anzahl von TPUs läuft die Verbindung zwischen TPUs über das ICI-Protokoll, unabhängig davon, ob sie den Schrank verlässt oder Licht oder Strom verwendet; erst wenn diese Größe überschritten wird, wechselt es zum herkömmlichen DCN-Protokoll auf Ethernet-Basis.
2) Pod-übergreifendes Scale-Out: Das "nebensächliche" Jupiter DCN
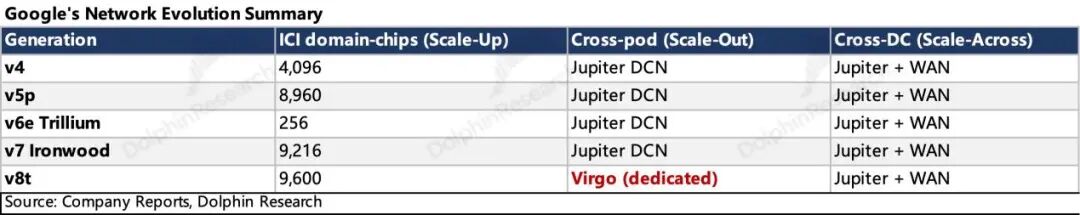
Vor v8 hat Google kein separates Netzwerk für Scale-Out aufgebaut. Der Grund liegt darin, dass die ICI-Domäne groß genug ist, und die tensorparallele und expertenparallele Verarbeitung, die am empfindlichsten auf Bandbreite reagieren, bleiben innerhalb der ICI-Domäne, was die Anforderungen an die Pod-übergreifende Kommunikation senkt. Die Bandbreitenanforderungen sind relativ locker, und die Bandbreite pro Karte beträgt nur 100 Gbps.
Daher nutzen der Pod-übergreifende Datenverkehr direkt das selbst entwickelte allgemeine Jupiter DCN, also das allgemeine Ethernet, das alle Server im Google-Datenzentrum gemeinsam nutzen, auf dem der Datenverkehr von Suche, Werbung und Speicher läuft. Das bedeutet, dass Jupiter DCN gleichzeitig den Vorder- und Hintergrunddatenverkehr trägt (der Vordergrund verbindet Speicher, CPUs und das externe Netzwerk, der Datenverkehr ist spärlich und toleriert Jitter; der Hintergrund verbindet Beschleuniger untereinander und erfordert synchrone Parallelität).
2. Netzwerklösung: 3D "Baustein stapeln" + OCS
Das Netzwerk ist im Wesentlichen die Topologie – wie die Geräte in einem Netzwerk miteinander verbunden sind. Das Netzwerk, das Dolphin Jun in den vorherigen zwei Artikeln erklärt hat, ist das 2D-Fettbaum-Netzwerk, das in den meisten Datenzentren verwendet wird.
Googles Topologie ist 3D-Baustein stapeln. Googles Netzwerk wächst von klein nach groß: Chip → Ablage → Würfel (Cube, also Rack) → Pod/Superpod. Im Vergleich zu Nvidias Lösung sind die Namen der Chip- und Ablageebene ähnlich, aber wenn die Ablagen kombiniert werden, sehen sie völlig anders aus.
1) Intra-Ablage-Scale-Up: Physische Anordnung 1×4, Topologielogik 2×2
Die Ablage besteht aus 4 TPUs (siehe folgende Abbildung). Die TPUs kommunizieren über das ICI-Protokoll. Jede TPU hat 6 ICI-Ports mit einer aggregierten bidirektionalen Bandbreite von 1.200 GB/s. Die Kommunikation zwischen TPU und CPU erfolgt über PCIe (DAC).
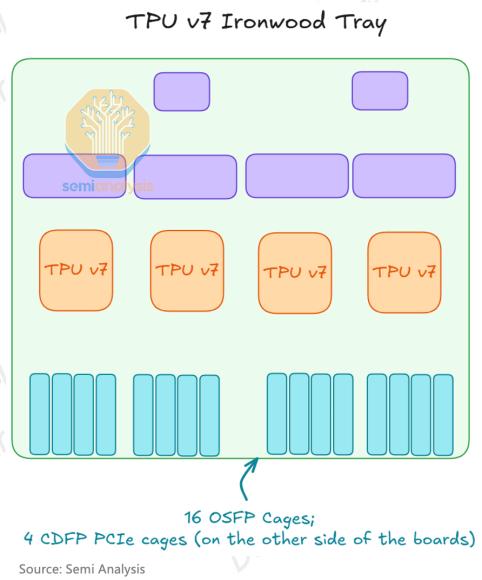
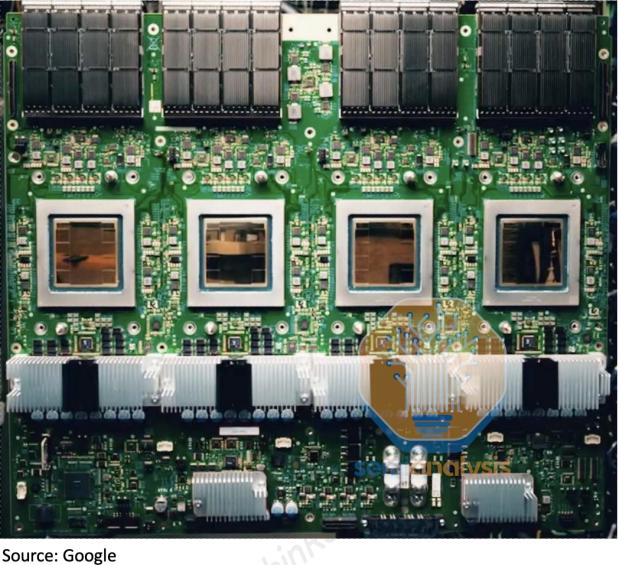
Die Bedeutung der 6 Ports muss zuerst im Gesamtzusammenhang betrachtet werden. Google ordnet die TPUs in einem dreidimensionalen Gitter an, und die 6 Ports verbinden jeweils 6 Nachbarn: oben, unten, links, rechts, vorne und hinten (also ±x, ±y, ±z), das ist der 3D-Torus (siehe folgende Abbildung).
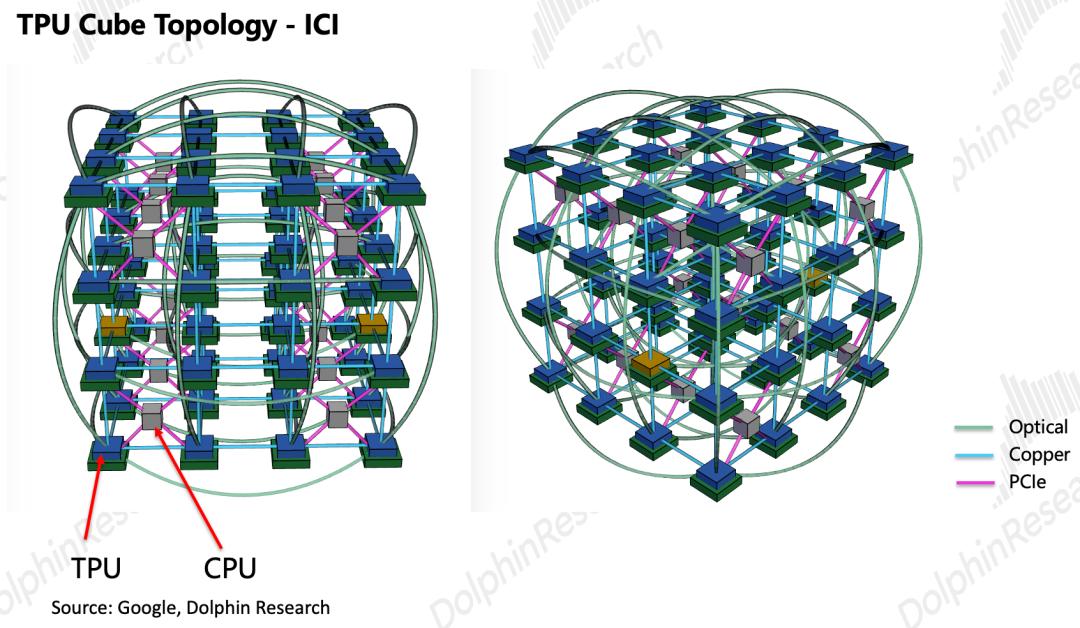
Zurück zur Ablage: Man sieht, dass die 4 TPUs in der Ablage in einer Reihe angeordnet sind, aber sie sind nicht paarweise miteinander verbunden. 4 der 6 Ports sind für Nachbarn auf anderen Ablagen reserviert, auf der Platine bleiben nur 2 übrig, und jede TPU kann nur 2 Chips auf derselben Platine verbinden. Wo die 4 Ports, die die Platine verlassen, angeschlossen werden, ist die Pod-übergreifende Topologie im nächsten Abschnitt.
2) Ablage-Ablage-Scale-Up: Direktverbindungstopologie bietet Konnektivität
Der größte Unterschied zu den Lösungen von Nvidia und AMD liegt ebenfalls im Scale-Up zwischen den Ablagen: Google verwendet keine Vermittlungschips, und die TPUs sind in 3D-Topologie direkt miteinander verbunden.
16 Ablagen bilden einen kubischen Verbund von insgesamt 64 TPUs (also ein Rack). Die Chips sind zu einer 4×4×4 3D-Topologie verbunden, jeder Chip wird als ein sechseckiger verbundener Quader betrachtet, und in sechs Richtungen werden Kabel gezogen, um mit den benachbarten Chips direkt verbunden zu werden.
Wenn man die Topologie in der folgenden Abbildung betrachtet, sieht man, dass einige TPUs neben Kupferkabeln auch Glasfaserkabel herausziehen. Wie kommt das?
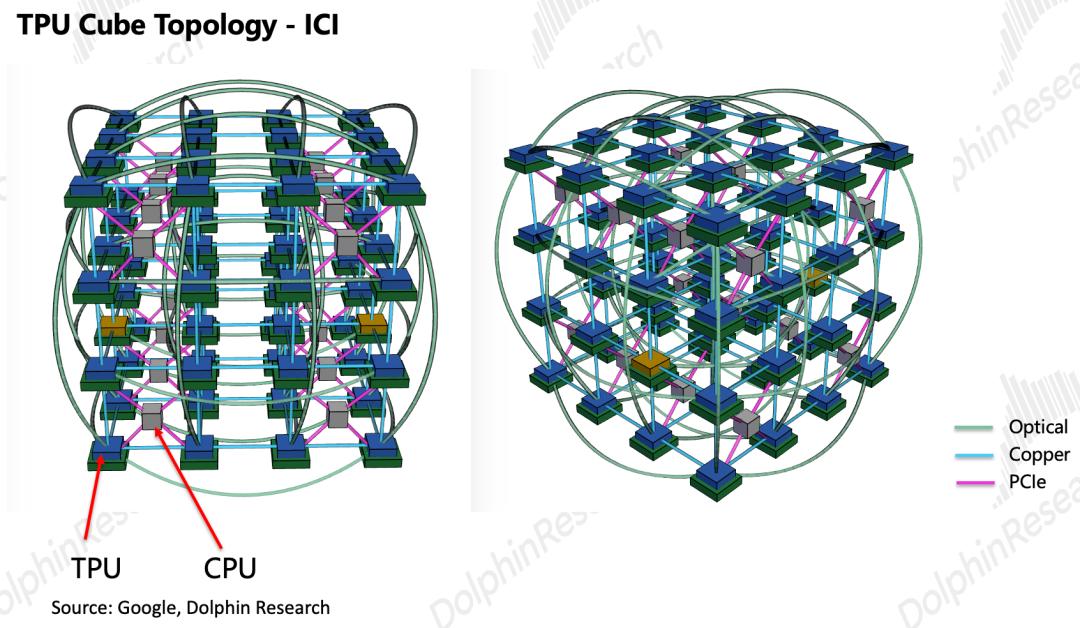
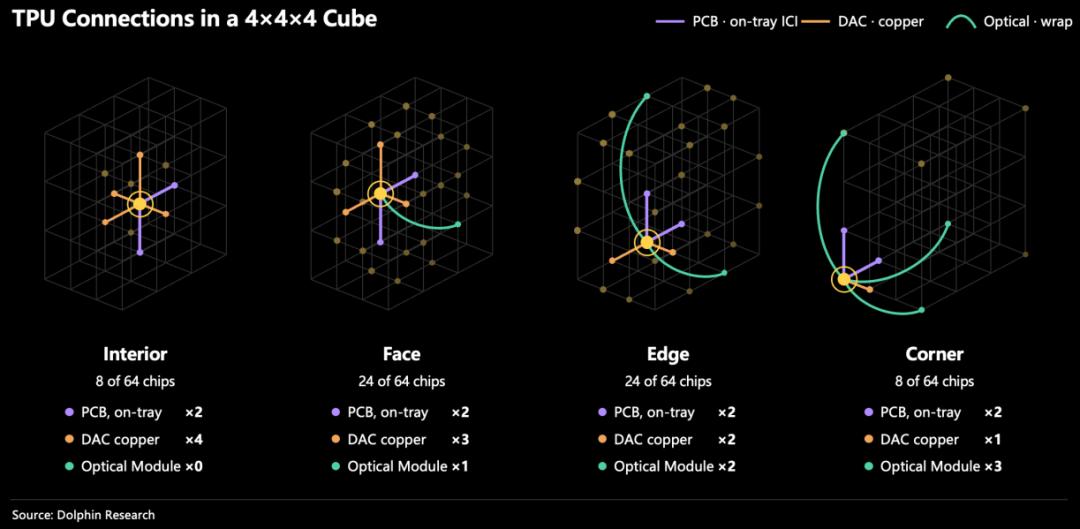
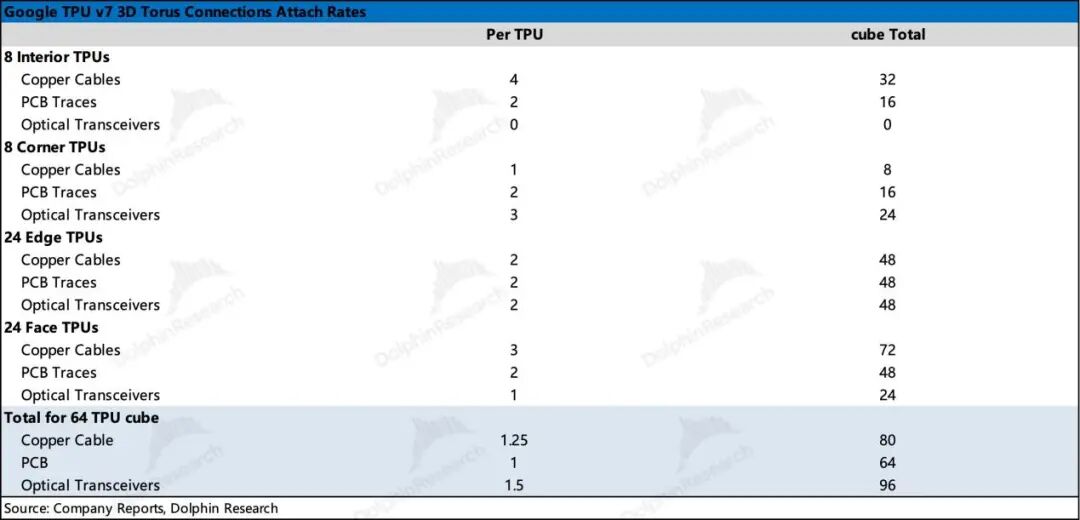
Ob Kupfer oder Licht verwendet wird, hängt von der Position der TPU in der Domäne ab. Innerhalb eines einzelnen Würfels mit 64 Kernen können die innersten 8 TPUs alle 6 benachbarten TPUs vollständig über Kupfer (DAC+PCB) verbinden.
Wenn dieser Würfel mit 64 Kernen als ein einzelnes Cube-Objekt betrachtet wird, haben die TPUs an den Kanten keine benachbarten TPUs auf einigen Seiten, also verbinden sie sich optisch mit den TPUs auf der gegenüberliegenden Seite dieses Würfels (siehe grüne Linie). Die TPUs an jeder Außenkante sind Kopf an Schwanz verbunden, diese Verbindung wird über ein optisches Modul in ein optisches Signal umgewandelt und in den OCS-Switch eingespeist. Wir haben die entsprechenden Verbindungselemente und Parameter für TPUs an verschiedenen Positionen im Cube (innen, Oberfläche, Kante, Ecke) zusammengestellt, wie unten gezeigt.
Die Verwendung von Licht direkt in der Scale-Up-Schicht ist ein einzigartiges Design von Google. Bei Vera Rubin NVL72 und Helios läuft das gesamte Scale-Up über Kupfer: GPUs werden über Rückplatten-Kupferkabel mit NVSwitch/Tomahawk verbunden, optische Module erscheinen nur in den Netzwerkkarten und Switches von Scale-Out, und die GPUs selbst sind nicht mit Licht verbunden.
Das optische Modul von Google hingegen wird direkt in das OSFP-Gehäuse auf der Vorderseite des TPU-Ablage gesteckt. Der optische Pfad lautet TPU → optisches Modul → Glasfaser → OCS → Glasfaser → optisches Modul → TPU, ohne dass dazwischen elektrische Vermittlungsgeräte vorhanden sind.
3) Cube-Cube-Scale-Up: Was ist OCS?
Wie oben erwähnt, fließen die Glasfaserverbindungen auf der Außenfläche des Cubes in den OCS-Switch ein. Tatsächlich ist er in Googles größeren Netzwerkskalen auch dafür verantwortlich, mehrere Cubes zu größeren Domänen zusammenzufügen: Pod (z. B. 4 Cubes, 256 TPUs) bis hin zu Superpod (maximal 144 Cubes, 9.216 TPUs). Das ist das unverwechselbarste Netzwerk-Hardware von Google:
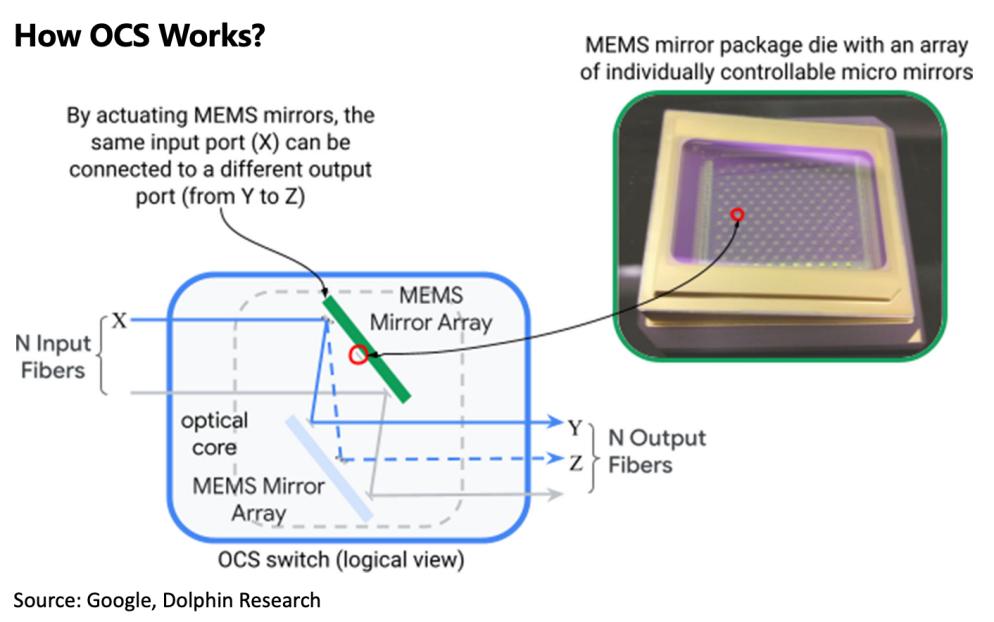
a. OCS-Switches sind nur für die Umleitung optischer Signale verantwortlich. Die Signalketten auf der Außenfläche des Cubes werden über optische Module in den OCS eingespeist, und der OCS entscheidet, ob das andere Ende jeder Kette sich zu einem 64-Chip-Torus selbst schließt oder zu einem größeren Torus zusammengefügt wird. OCS ist nur dafür verantwortlich, das Licht von einem Port zu einem anderen zu leiten.
b. Wie werden optische Signale vermittelt? OCS enthält zwei Gruppen von zweidimensionalen MEMS-Mikrospiegel-Arrays. Durch die zweiachsige Kippung jedes Spiegels wird der Lichtstrahl von jedem Eingangsport zu jedem Ausgangsport "geleitet" (siehe folgende Abbildung). Der wesentliche Unterschied zu EPS (elektronischer Paketvermittler, Lösung von AMD & Nvidia) besteht darin, dass EPS Echtzeit-Weiterleitungsentscheidungen für jedes Paket trifft, während OCS statische Lichtpfade zwischen Ports aufbaut.
Zum Beispiel, wenn ursprünglich Port 1 mit Port 2 verbunden war und jetzt Port 1 mit Port 4 kommunizieren soll, muss OCS die Spiegel neu konfigurieren, da OCS keine Weiterleitungsfunktion hat; bei herkömmlichen EPS sind die Ports jedoch vollständig miteinander verbunden, sodass keine Neukonfiguration erforderlich ist.
Ein anschauliches Beispiel ist das Weichen in der Eisenbahn: Es gibt viele Gleise, aber zu jedem Zeitpunkt fährt nur eines, und zum Wechseln muss die Weiche umgestellt werden (also der Winkel des Spiegels angepasst werden).
Da