Figure的56%新标尺,掀起具身们的泛化验证大考
旧金山湾区的三十户人家,在今年八月把房子交给了同一台机器人,这些房子Figure在训练时一间都没进去过,屋里的沙发、床、折叠台面都是主人自己的。
机器人一次只做一件事,可能是把客厅里散落在地的十几件玩具一件不落地收进篮子,也可能是把毛巾全部折好放进篮子,或者是把两个枕头和被角都摆到床的上三分之一处,做哪件由评测方抽定。
没有部分得分,任务没做完算失败,中途有人介入保护也算失败。
举办这场考试的正是Figure AI。
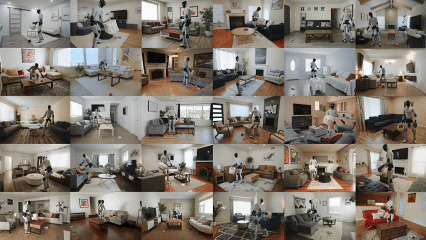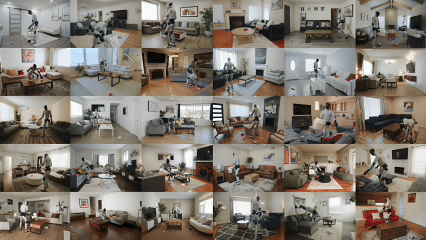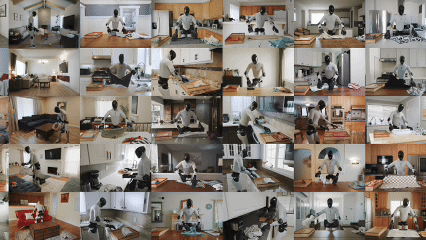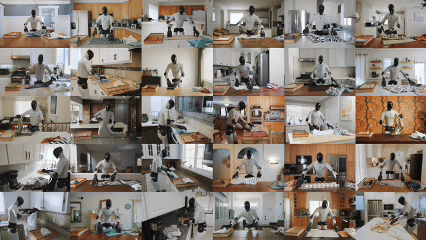
9月17日,Figure发布Helix 2.5,搭载在Figure 03上。
420次尝试,完成237次。人形机器人的泛化能力,从某种意义上来看,任务成功率从9%提升到了56%。
“泛化”早已是具身智能公关话术里的万能形容词,这一次,Figure以可验证的技能展示重新定义了讨论基准,而国内具身玩家又能拿什么接这一记实招?
01 从9%到56%
56%这个数字,且需要拆开来看。
铺床94/140,67%;折毛巾87/140,62%;收玩具56/140,40%。三十户房子共用同一个模型checkpoint,没有针对任何一户做适配,评测方式是盲测。
Figure划的零样本边界是,房子和被操作的物体都没见过,三种行为本身还是在别处数据上教会的。
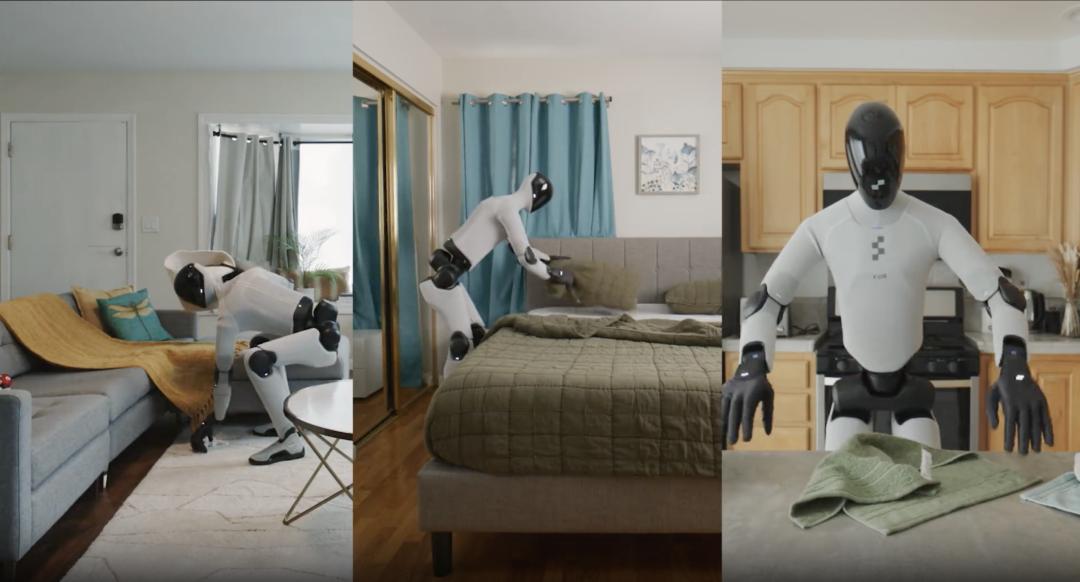
Figure AI测试
这组数字背后有这样一场对照实验:Figure用同一批任务数据训练两个策略,一个从随机权重起步,一个从Index预训练的Helix 2.5起步,架构、优化器、超参数、下游数据和评测方式全部锁死,唯一差别是有没有Index预训练。
用了Index的策略零样本成功率约56%,从零训练的策略只有9%,差六倍多。Index数据集里,没有任何一个评测任务占到1.90%以上。
Figure给这件事的定性是,据其所知,这是人形机器人上首次在这个规模上实现零样本全身泛化。
它同时说明Helix 2.5从随机初始化开始、完全在Index上预训练,上一代Helix 02的起点则是一个预训练好的视觉语言模型。
数据量的账也被摊开在台面上。
相比前代Helix 02,Helix 2.5只用了一半的任务专用数据,就把同一套行为铺到了三十倍数量的环境里。
更关键的是Figure给出了一条scaling曲线。
四个模型跑在Index的嵌套子集上,预训练数据量跨度八倍,模型规模和下游训练保持不变。只用小规模那几次的结果,就能在训练开始前预测最大规模那次实验的测试损失到小数点后四位,预测误差只有整个八倍数据区间波动的0.54%。
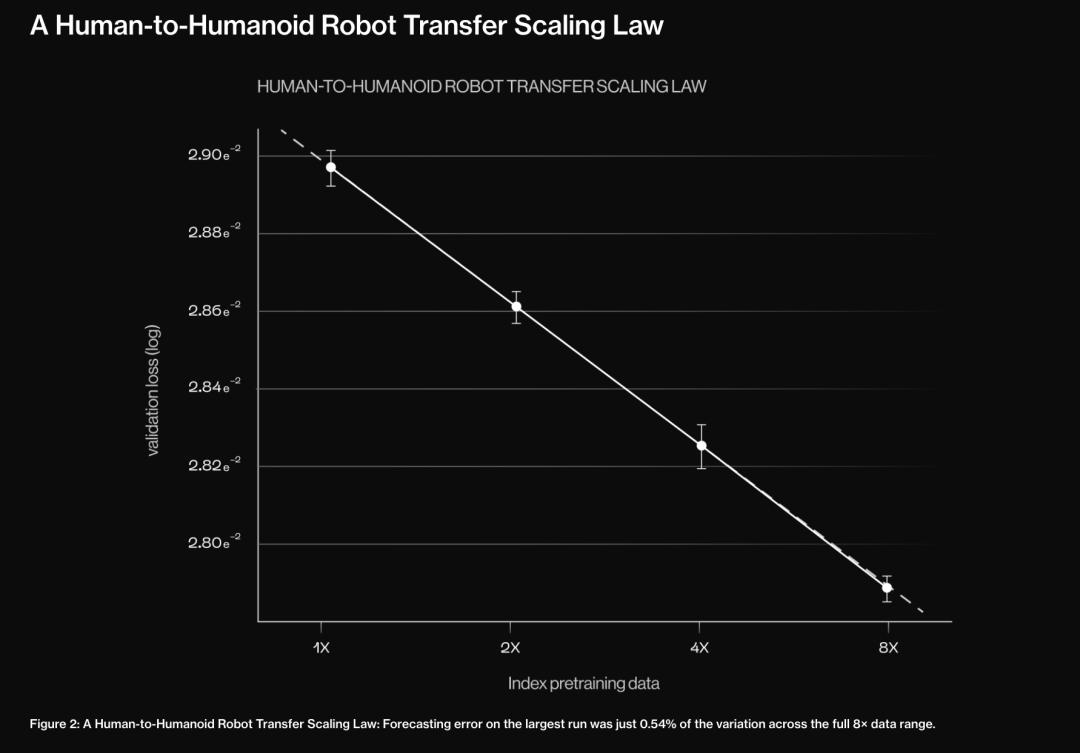
Figure称这是第一个在人形机器人上测出来的人到机器人迁移scaling law。
这套逻辑的地基是8月25日推出的Index,公司称每秒产生约35分钟新的人类行为数据,累计收集超过1600万段视频,向贡献者支付了1500万美元。
Figure在9月3日与Nscale签下多年协议,初期承诺35亿美元算力、锁定最高10万块英伟达Vera Rubin平台的GPU,合同规模最高可到60亿美元,首批GPU计划2027年下半年在得州部署。
它的技术底子是Helix的双系统架构。S2是慢脑,负责理解任务和规划;S1是快脑,在初代Helix里以每秒200次的频率实时控制上半身关节;2026年1月发布的Helix 02把S1的控制扩展到全身,又加了一层S0小脑,专门管平衡和全身协调。
这次“全身泛化”的全身,指机器人在陌生房间里要蹲下、绕开床走、换站姿重新发力,不只是手在动。
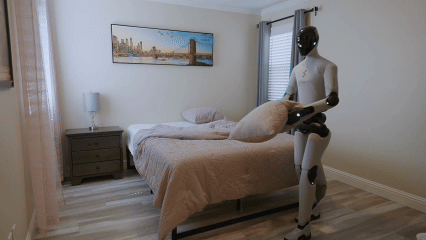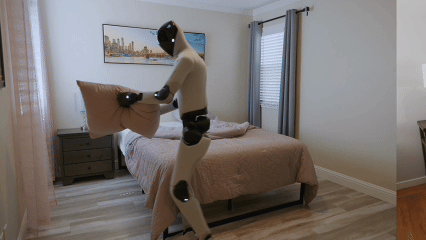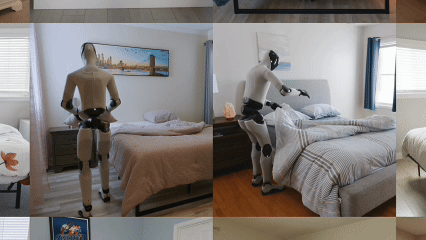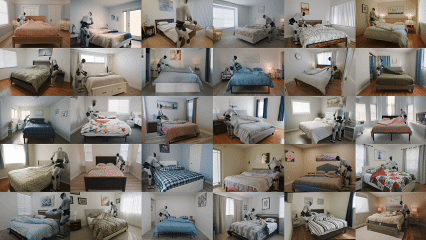
Figure AI测试
但这份结果仍需要辩证看待,评测是Figure自己跑的,没有第三方独立验证,56%也意味着还有44%的尝试没做完。
创始人Brett Adcock在发布视频里说这是Figure做过最重要的项目,他另外放出近四小时拍摄素材,但那也不是420次评测的完整记录。就好比5月那场分拣直播,有观众指出约半秒动作延迟和疑似遥操作的摸头动作,公司否认远程操控,但没有放出后台数据。
02 王兴兴给的尺子是80%
宇树科技创始人王兴兴8月20日在世界机器人大会的主旨演讲里,把行业最大的瓶颈直接点成了泛化能力不够。
他说固定场景下经过充分采集和训练的模型,任务成功率接近100%,但一旦更换操作物品或环境,成功率就大幅下降,每次出现新任务都要重新训练,适配成本很高。
王兴兴给了大众一把尺子,把一台机器人带进80%的陌生场景,仅靠语音或文字指令就能完成约80%的任务,产业才算走到爆发的临界点。
他的判断是快则两到三年,慢则五到十年。
2026年世界机器人大会 王兴兴
至于卡在哪里,他的说法是偏差累积,语言模型的输入输出都限制在向量空间内几乎没有损耗,机器人每一次感知、决策、执行都会引入偏差,任务大方向对,最后几毫米却修不回来。
用这把尺子量,Figure这次交出的是56%,而国内具身公司交出的数字则要分散得多。
银河通用创始人王鹤给过一个相近的定义。他说的具身智能ChatGPT时刻,是机器人在普通人不用专门学的任务上达到70%到80%成功率,他预计的时间点是2028年。
智元机器人9月9日发布GE-Act 2.0,用300小时、1200小时、5000小时、3万小时四档数据训练,训练后不针对测试任务做微调或示范,直接让机器人面对陌生物体。机器人取得非零成功率的任务数从39项增到76项,整体成功率从17.1%升到44.1%,数据加到3万小时仍未饱和。带数据的泛化scaling曲线公开得不多,这是其中一条。
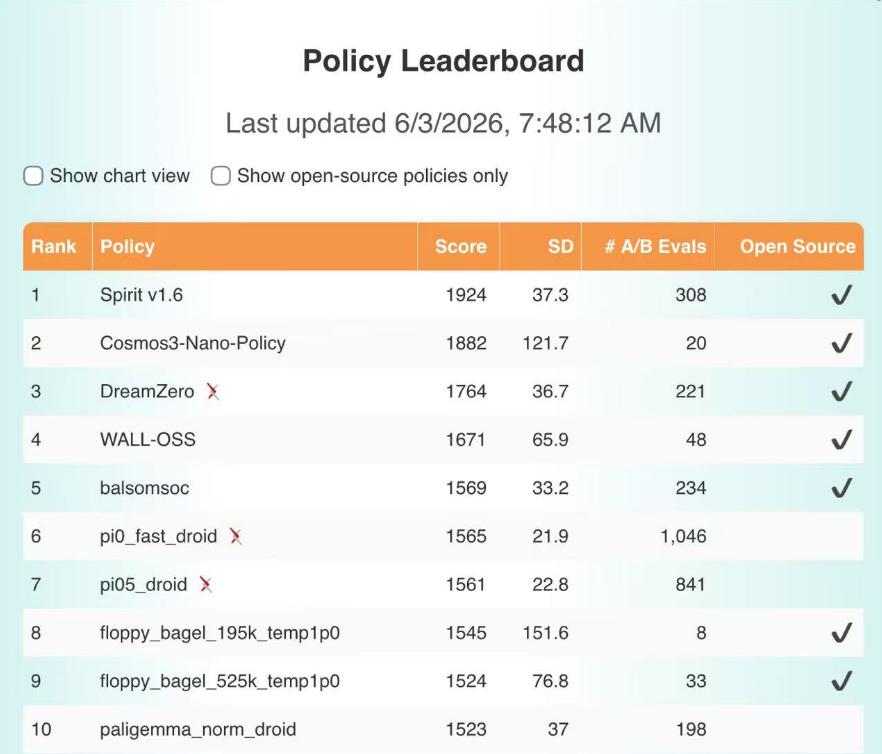
千寻智能走的则是第三方榜单。1月它的Spirit v1.5在RoboChallenge三十项真机任务里拿到66.09分、成功率50.33%,超过霸榜数月的π0.5,是唯一成功率过半的模型;6月Spirit v1.6在RoboArena登顶,超过英伟达Cosmos3和Physical Intelligence的π0.5。不过这个榜首后来起了争议,有观察者指出评测记录里七成以上的分数来自两个账号,RoboArena回滚了存疑数据并更新排名,Spirit v1.6随之被移出榜单,千寻方面至今没有公开回应。宁德时代产线上,它的机器人做高压测试插头插接,成功率稳定在99%以上。
银河通用的AstraBrain-WBC 0.5用2万小时人类动作数据、8040万参数,称在真机上实现了大量未见动作的零样本执行。但需要分开看,它8月在世界机器人大会现场展示的全身运动控制泛化,官方标注是遥操作演示。
松延动力9月15日发布的HERON-CRA做了跨本体泛化,同一套模型分别驱动机械臂和轮式人形,叠袜子首测成功率38.5%,开强化学习后97.8%,两个数都是公司自测。
星海图的G0.5在DROID基准上零样本十个桌面任务平均成功率82.5%,逐任务优于π0.5;8月世界机器人大会上的前置仓,观众在线下单后机器人自主识别、规划、抓取、撑袋打包,展会期间累计完成900单。
加速进化在第二届世界人形机器人运动会上让80台机器人自主变换队形,创始人程昊把它和群控切开,说每台机器人靠自己的激光雷达算下一步怎么走。清华大学赵明国团队用它家的Booster T1做的足球研究登上8月《Science Robotics》,在草地、石板、土壤、沥青上零样本部署,前场射门成功率约90%……
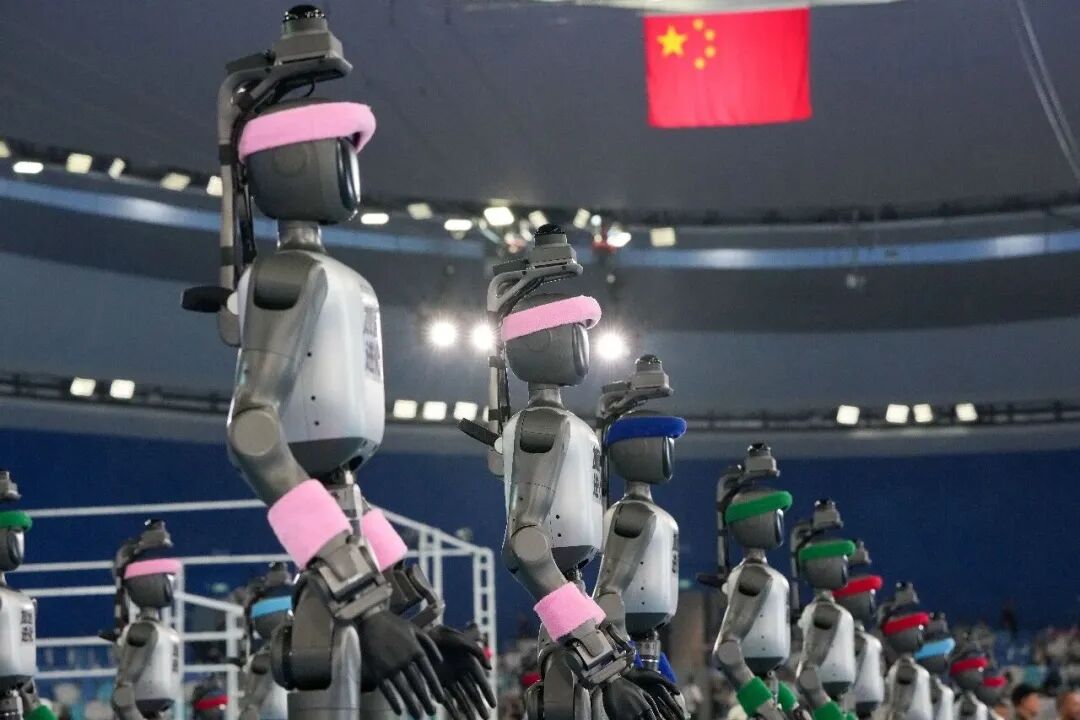
速进化Booster T2人形机器人
喧嚣的数字背后,一场关于“泛化”的诚实度测试正在展开。
当Figure用56%划定及格线,国内玩家们或攀数据scaling曲线,或登顶第三方榜单,或深耕场景纵深——答案或许不在某个惊艳的百分比,而在谁能率先跨越从“演示”到“日常”的鸿沟。
03 账面上还没有的部分
与此同时,关于数据规模的账,国内各家口径不一。
智元的AgiBot World累计超过100万条轨迹、217个任务;星海图的GOD是500小时真机数据、10万条轨迹;千寻智能累计超20万小时,2026年目标100万小时;它石智航称WIYH数据集规模超百万小时、覆盖数万场景……没有一家公开过可核验的真机数据小时账目,也没有一家公布人类行为视频的采集规模。
接管比例更是一道严峻的考验。
星海图在生产环境里保留了人工接管机制,接管产生的数据回流训练;自变量创始人王潜说家庭服务“并不意味着所有任务都能百分之百由AI自主完成,必要时仍需远程人员兜底”;银河通用创始人王鹤说,机器人还很难直接适配千行百业,不同任务仍需相应后训练……
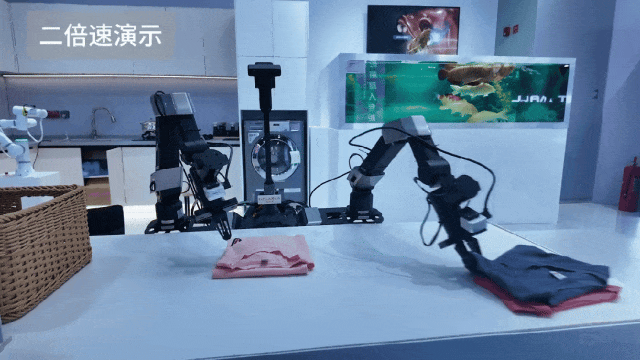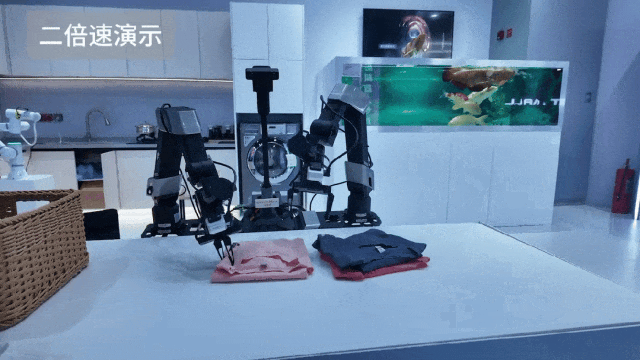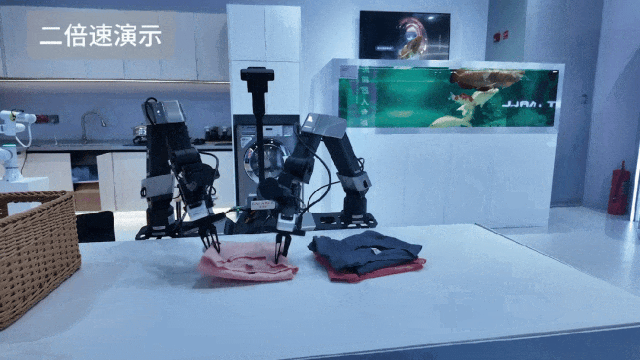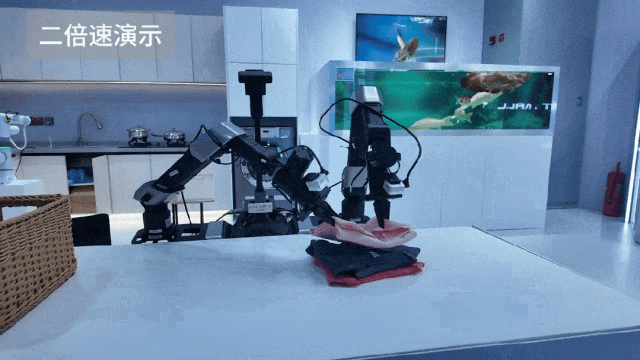
星海图机器人
值得警惕的是,当“保留接管”被重新讲述为“人机协同”的温情故事,当实验室里的平均值被包装成商业世界的通行证,话术与现实的裂缝正在成功率的分母处悄然显现。
破壳机器人创始人许华哲在外滩大会上说,机器人50%的成功率意味着一半概率打碎杯子,要提升到99.99%才能规模化商用;a16z的投资人Oliver Hsu也写过,实验室里95%成功率的策略进了仓库可能迅速跌到60%,研究看的是平均表现,部署要面对所有情况。
出货量的结构同样能说明问题。
2026上半年全球人形机器人出货约1.91万台、同比增长272%,中国厂商占比超97%,但娱乐表演、数据生产、科研教育三类合计占六成以上,智能制造占13%,仓储物流只占5%。宇树2025年前三季度的收入里,科研教育客户占73.6%,工业客户占9.01%。
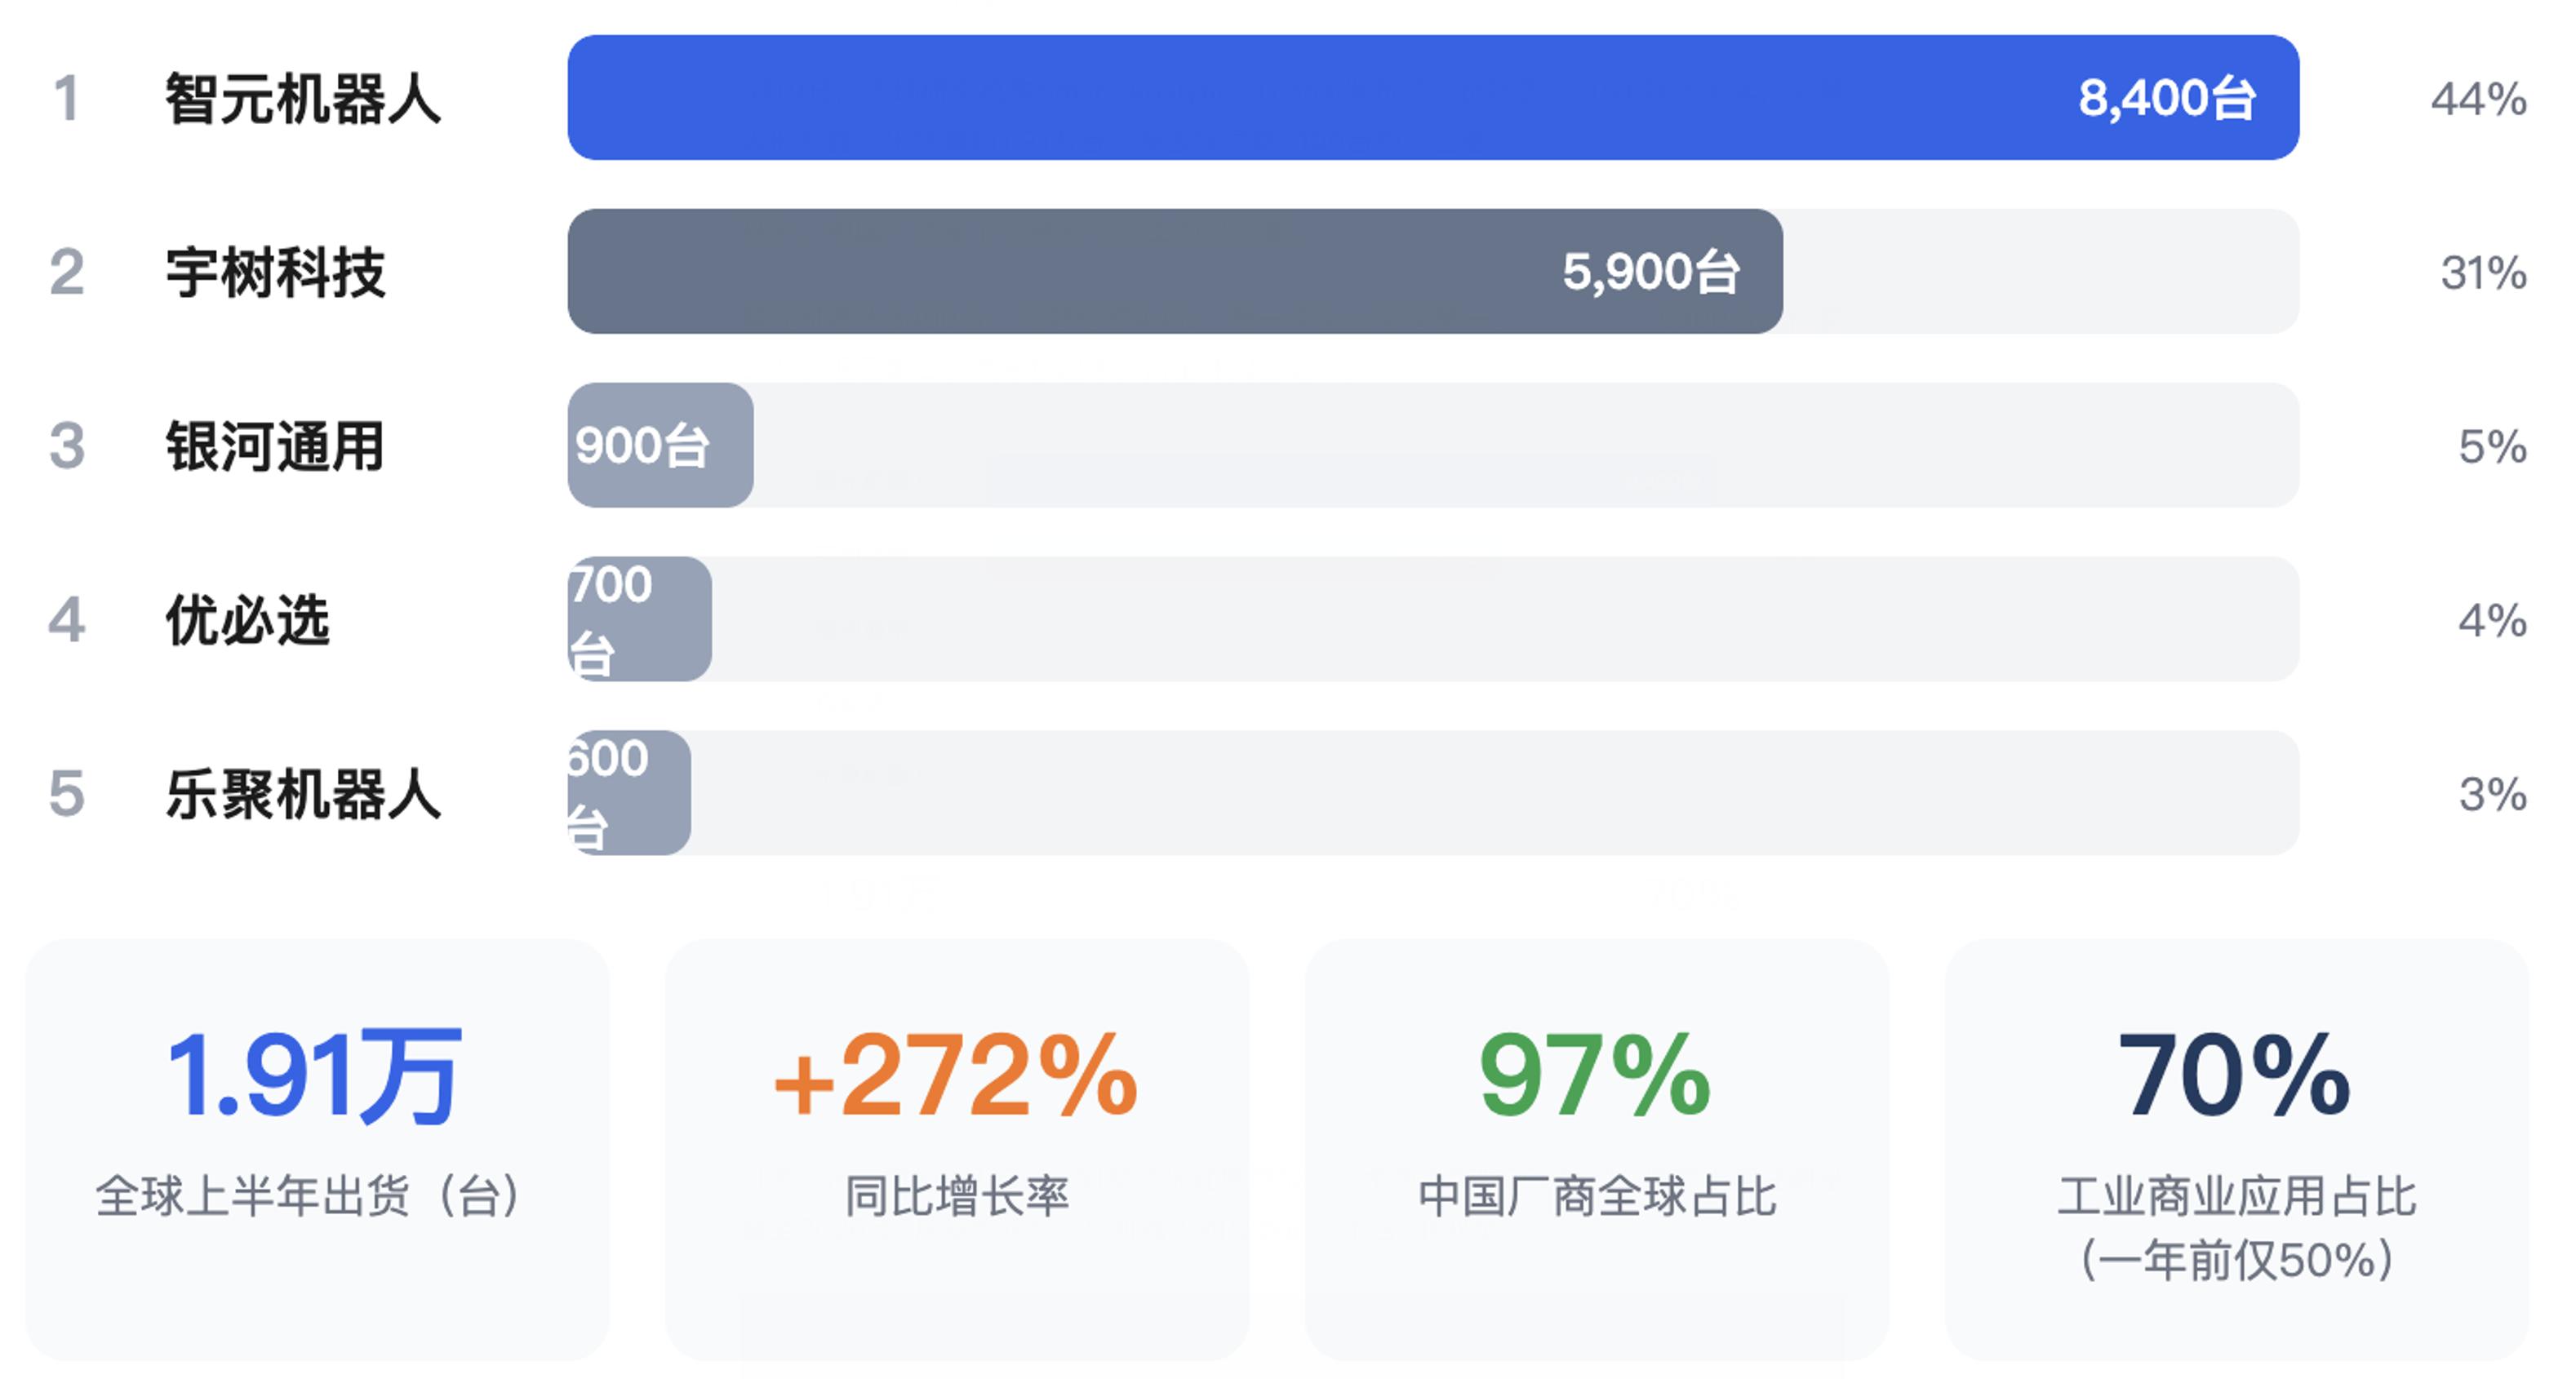
当资本需要故事,而产线与场景应用需要可靠,“泛化”这一次便需要正视其祛魅时刻。
04 潮涌AI观点
Figure这次最值钱的是从9%到56%的对照。
它把泛化的来源换了一个地方,从“每个场景采一遍数据”换成“先把人类行为预训练进去、再到新场景零样本执行”。
这条路径如果成立,泛化的成本结构会变,行业现在拼数采工厂的那套逻辑要重算。
国内不缺泛化的说法,缺的是同一把尺子。王兴兴的80%和Figure的56%都是各自定的,第三方真机榜单2026年才刚跑起来,真正把成绩打上去的公司还不多。
谁的数字是自己测的、谁的是第三方测的,读的时候要分清楚。榜单本身也要看——分数谁打的、数据能不能回溯,RoboArena回滚评测数据的事就发生在三个月前。
要关注的数字还有一个,那就是接管比例。泛化不够的时候,机器人背后站着一个人随时准备接手。谁把人类接管从50%降到20%、再降到0,谁才算交出了泛化的证据。国内只有智元公开说出这个数字,也承认自己还在50%。
现在的出货量可说明不了泛化能力如何。
六成以上的人形机器人卖给了科研教育、数据生产和商业演出,那不是泛化能力的证明,那是数据采购和节目需求。
等哪一天国内公司敢把机器人放进三十户陌生人家、任务全做完才算成功,那个数字才有比较的意义。
参考内容:
1、Figure《Helix 2.5: Zero-Shot 30-Home Generalization》
2、科创板日报《具身智能短板补齐?Figure发布Helix 2.5模型机器人可“自主做家务”》
3、上海证券报《宇树上市后,王兴兴最新公开发声》
4、文汇报《智元一天发布两款模型,一款让机器人“边看边动”,一款让它“越学越会”》
5、硅基观察Pro《a16z最新洞察:具身智能从Demo到落地,必须跨越的5个鸿沟》
6、智讯智库《具身智能等不来自己的“ChatGPT时刻”》
本文来自微信公众号“潮涌AI”,作者:盐,36氪经授权发布。