Der neue 56 %-Maßstab von Figure löst die große Generalisierungsvalidierungsprüfung für alle Embodied Agents aus.
Dreißig Haushalte in der San Francisco Bay Area übergaben im August dieses Jahres ihre Häuser an denselben Roboter – Figure hatte keines dieser Häuser während des Trainings jemals betreten, und die Sofas, Betten und Klapptische in den Räumen gehörten alle den Eigentümern selbst.
Der Roboter erledigt jeweils nur eine Aufgabe: Er kann Dutzende von Spielzeugen, die im Wohnzimmer auf dem Boden verteilt sind, lückenlos in einen Korb sammeln, alle Handtücher falten und in den Korb legen, oder zwei Kissen und die Bettdeckenkanten auf das obere Drittel des Bettes ausrichten. Welche Aufgabe er ausführt, wird von der Prüfstelle zufällig ausgewählt.
Es gibt keine Teilpunkte: Wird die Aufgabe nicht abgeschlossen, gilt sie als fehlgeschlagen, auch wenn jemand während des Vorgangs eingreift, um den Roboter zu schützen.
Veranstalter dieser Prüfung ist genau Figure AI.
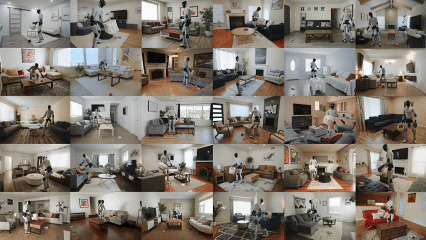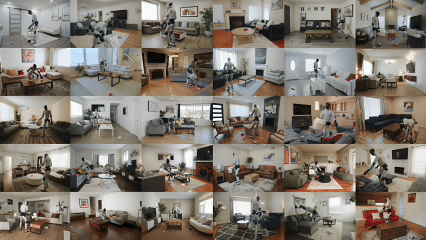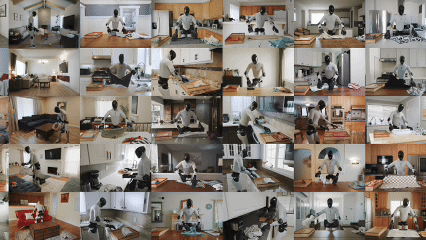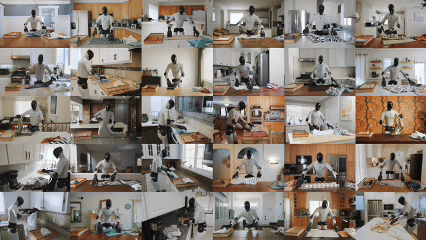
Am 17. September veröffentlichte Figure Helix 2.5, das auf dem Modell Figure 03 installiert ist.
Von 420 Versuchen wurden 237 erfolgreich abgeschlossen. In gewisser Hinsicht hat sich die Generalisierungsfähigkeit des humanoiden Roboters so verbessert, dass die Aufgaben-Erfolgsrate von 9 % auf 56 % gestiegen ist.
„Generalisierung“ ist längst ein universelles Adjektiv in der PR-Rhetorik der Embodied Intelligence. Dieses Mal definiert Figure die Diskussionsgrundlage mit nachprüfbaren Fähigkeitsvorführungen neu – und welche Mittel können die inländischen Akteure im Bereich Embodied Intelligence einsetzen, um auf diesen konkreten Fortschritt zu reagieren?
01 Von 9 % auf 56 %
Die Zahl 56 % muss man genauer betrachten.
Beim Bettenmachen wurden 94 von 140 Versuchen erfolgreich absolviert (67 %), beim Falten von Handtüchern 87 von 140 (62 %) und beim Sammeln von Spielzeugen 56 von 140 (40 %). Für alle dreißig Häuser wurde derselbe Modell-Checkpoint verwendet, es gab keine Anpassung an irgendein Haus, und die Bewertung erfolgte im Blindtest.
Die von Figure definierte Zero-Shot-Grenze lautet: Weder die Häuser noch die zu manipulierenden Objekte wurden dem Modell zuvor gezeigt, die drei Verhaltensweisen selbst wurden dem Modell jedoch anhand von Daten aus anderen Umgebungen beigebracht.
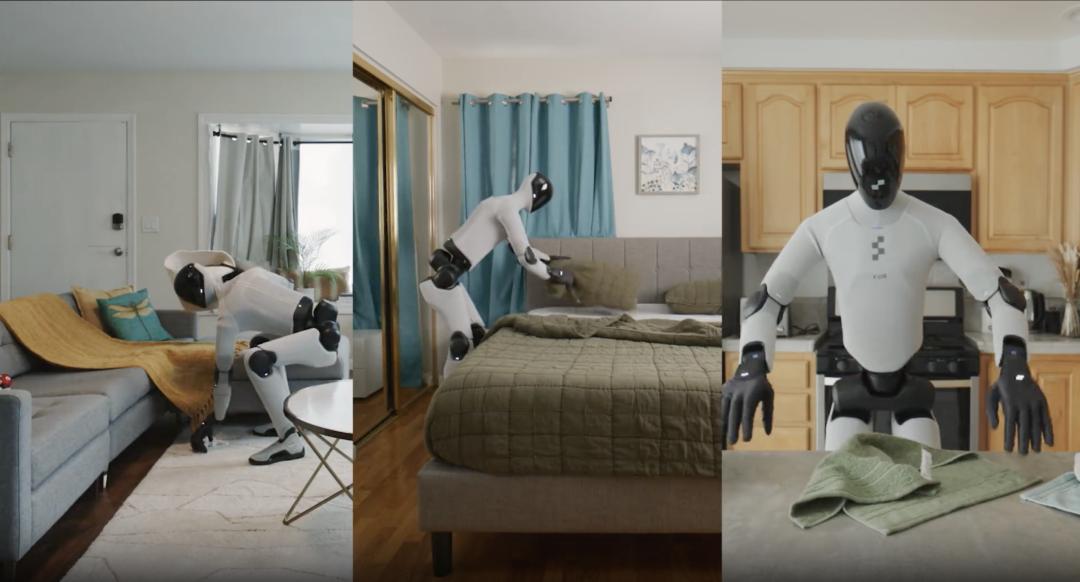
Figure AI-Test
Hinter diesen Zahlen steckt ein kontrolliertes Experiment: Figure hat zwei Strategien mit demselben Satz an Aufgabendaten trainiert. Eine begann mit zufälligen Gewichtungen, die andere mit dem auf Index vortrainierten Helix 2.5. Architektur, Optimierer, Hyperparameter, nachgeschaltete Daten und Bewertungsmethoden wurden vollständig festgelegt – der einzige Unterschied bestand darin, ob ein Index-Vortraining durchgeführt wurde.
Die Strategie mit Index erreichte eine Zero-Shot-Erfolgsrate von etwa 56 %, die von Grund auf trainierte Strategie nur 9 % – ein Unterschied von mehr als dem Sechsfachen. Im Index-Datensatz macht keine einzige Bewertungsaufgabe mehr als 1,90 % des Gesamtumfangs aus.
Figure bezeichnet diesen Vorgang als – soweit bekannt – erste Umsetzung einer zero-shot Ganzkörpergeneralisierung in diesem Umfang bei humanoiden Robotern.
Zugleich wird klargestellt, dass Helix 2.5 von der zufälligen Initialisierung ausgeht und vollständig auf Index vortrainiert wird, während die Vorgängerversion Helix 02 auf einem bereits vortrainierten visuellen Sprachmodell basierte.
Die Bilanz des Datenumfangs liegt nun offen auf dem Tisch.
Im Vergleich zur Vorgängerversion Helix 02 hat Helix 2.5 nur die Hälfte der aufgabenspezifischen Daten verwendet, um dieselben Verhaltensweisen in 30 Mal so vielen Umgebungen umzusetzen.
Noch entscheidender ist, dass Figure eine Scaling-Kurve vorgelegt hat.
Vier Modelle wurden auf verschachtelten Teilmengen von Index ausgeführt, wobei der Umfang der Vortrainingsdaten sich um das Achtfache erstreckte, während Modellgröße und nachgeschaltetes Training unverändert blieben. Allein anhand der Ergebnisse der kleinen Skalen kann der Testverlust des größten Experiments vor Beginn des Trainings auf vier Nachkommastellen genau vorhergesagt werden, wobei der Vorhersagefehler nur 0,54 % der gesamten Schwankungsbreite im Achtfachen-Datenbereich beträgt.
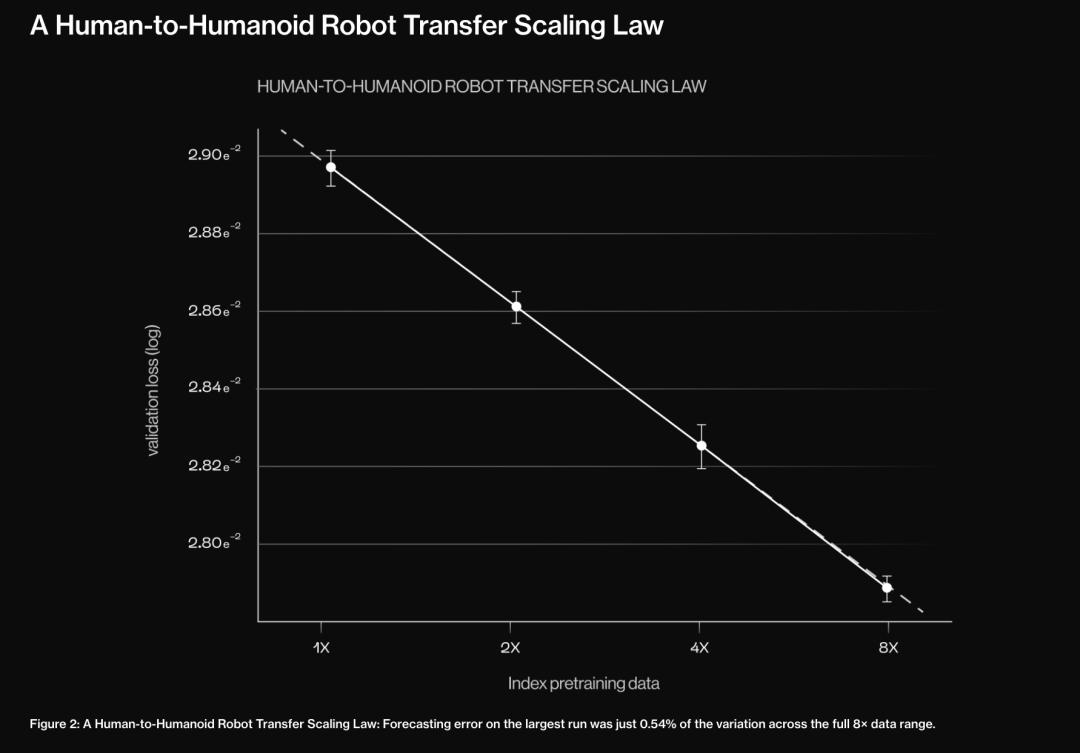
Figure bezeichnet dies als das erste an humanoiden Robotern gemessene Scaling-Gesetz für die Übertragung von menschlichem Verhalten auf Roboter.
Die Grundlage dieser Logik bildet der am 25. August vorgestellte Index: Das Unternehmen gibt an, dass pro Sekunde etwa 35 Minuten neuer menschlicher Verhaltensdaten erzeugt werden, insgesamt wurden mehr als 16 Millionen Videos gesammelt und 15 Millionen US-Dollar an die Beitragenden gezahlt.
Am 3. September unterzeichnete Figure einen mehrjährigen Vertrag mit Nscale, der zunächst 3,5 Milliarden US-Dollar an Rechenleistung vorsieht und bis zu 100.000 GPUs der Nvidia Vera-Rubin-Plattform sichert. Der Vertragsumfang kann bis zu 6 Milliarden US-Dollar erreichen, die ersten GPUs sollen im zweiten Halbjahr 2027 in Texas installiert werden.
Seine technische Grundlage ist das duale Systemarchitektur von Helix. S2 ist das „langsame Gehirn“, das für Aufgabenverständnis und Planung zuständig ist. S1 ist das „schnelle Gehirn“, das in der ersten Helix-Generation die Gelenke des Oberkörpers in Echtzeit mit einer Frequenz von 200 Mal pro Sekunde steuert. Die im Januar 2026 veröffentlichte Helix 02 erweiterte die Steuerung von S1 auf den gesamten Körper und fügte eine weitere Schicht S0-Kleinhirn hinzu, das speziell für Gleichgewicht und gesamte Körperkoordination zuständig ist.
Das „Ganzkörper“ bei dieser „Ganzkörpergeneralisierung“ bedeutet, dass der Roboter in einem unbekannten Raum sich hinknien, um das Bett herumgehen und seine Haltung wechseln muss, um neue Kraft aufzubringen – nicht nur seine Hände sind in Bewegung.
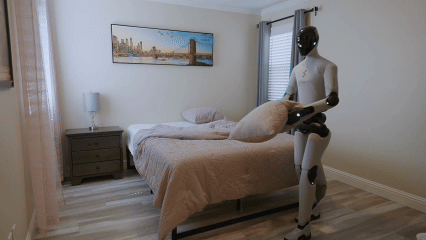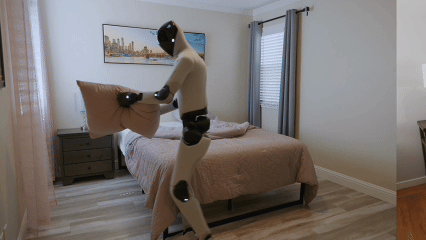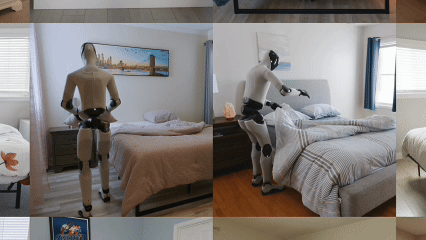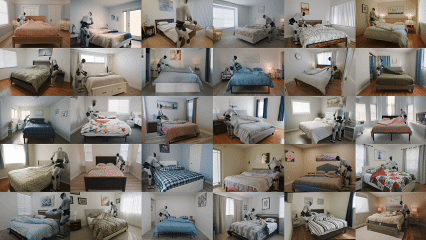
Figure AI-Test
Dieses Ergebnis muss dennoch dialektisch betrachtet werden: Die Bewertung wurde von Figure selbst durchgeführt, es gibt keine unabhängige Überprüfung durch Dritte, und 56 % bedeuten auch, dass 44 % der Versuche nicht abgeschlossen wurden.
Gründer Brett Adcock sagte im Veröffentlichungsvideo, dass dies das wichtigste Projekt sei, das Figure je durchgeführt hat. Er veröffentlichte zudem fast vier Stunden Aufnahmematerial, das aber keine vollständige Aufzeichnung der 420 Bewertungen darstellt. Ähnlich wie bei der Sortier-Live-Übertragung im Mai wiesen einige Zuschauer auf eine etwa halbe Sekunde lange Aktionsverzögerung und eine verdächtige, ferngesteuerte Berührung des Kopfes hin. Das Unternehmen bestritt die Fernsteuerung, veröffentlichte aber keine Hintergrunddaten.
02 Wang Xingxings Maßstab liegt bei 80 %
Wang Xingxing, Gründer von Unitree Robotics, wies in seiner Grundsatzrede auf der Weltroboterkonferenz am 20. August direkt darauf hin, dass der größte Engpass der Branche die unzureichende Generalisierungsfähigkeit ist.
Er sagte, dass Modelle, die in festen Szenarien ausreichend gesammelt und trainiert wurden, eine Aufgaben-Erfolgsrate von fast 100 % erreichen. Sobald aber die zu manipulierenden Objekte oder die Umgebung gewechselt werden, sinkt die Erfolgsrate stark. Bei jeder neuen Aufgabe muss das Modell neu trainiert werden, was zu hohen Anpassungskosten führt.
Wang Xingxing legte der Öffentlichkeit einen Maßstab vor: Die Industrie erreicht den kritischen Punkt des Durchbruchs erst, wenn ein Roboter in 80 % der unbekannten Szenarien nur über Sprach- oder Textbefehle etwa 80 % der Aufgaben erledigen kann.
Seine Einschätzung lautet: Das kann in zwei bis drei Jahren geschehen, im schlimmsten Fall dauert es fünf bis zehn Jahre.
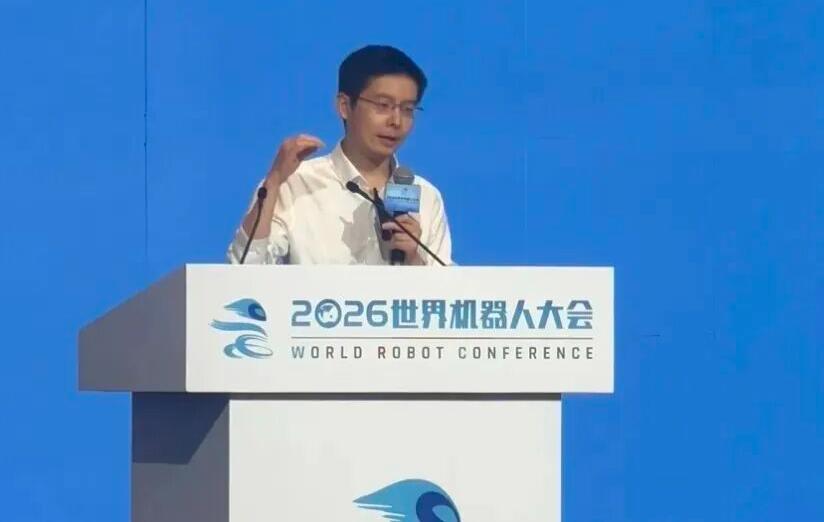
Wang Xingxing auf der Weltroboterkonferenz 2026
Wo genau der Engpass liegt, erklärte er als Akkumulation von Abweichungen: Die Ein- und Ausgaben von Sprachmodellen verursachen im Vektorraum fast keine Verluste, aber bei jedem Wahrnehmungs-, Entscheidungs- und Ausführungsprozess des Roboters treten Abweichungen auf. Die allgemeine Richtung der Aufgabe ist korrekt, aber die letzten Millimeter lassen sich nicht korrigieren.
Gemessen an diesem Maßstab hat Figure dieses Mal 56 % erreicht, während die Zahlen der inländischen Embodied-Intelligence-Unternehmen weit verteilter sind.
Wang He, Gründer von Galaxy Universal, legte eine ähnliche Definition vor. Den „ChatGPT-Moment“ der Embodied Intelligence sieht er erreicht, wenn Roboter bei Aufgaben, die normale Menschen nicht extra lernen müssen, eine Erfolgsrate von 70 % bis 80 % erreichen. Er erwartet diesen Zeitpunkt für das Jahr 2028.
Am 9. September veröffentlichte Agibot Robotics GE-Act 2.0, das mit vier Datensätzen von 300 Stunden, 1200 Stunden, 5000 Stunden und 30.000 Stunden trainiert wurde. Nach dem Training wurde das Modell nicht für die Testaufgaben feinabgestimmt oder mit Demonstrationen versehen, sondern die Roboter wurden direkt unbekannten Objekten ausgesetzt. Die Anzahl der Aufgaben mit einer nicht-null Erfolgsrate stieg von 39 auf 76, die Gesamterfolgsrate stieg von 17,1 % auf 44,1 %. Auch bei 30.000 Stunden Daten war die Sättigung noch nicht erreicht. Es gibt nur wenige veröffentlichte Generalisierungs-Scaling-Kurven mit echten Daten – dies ist eine davon.
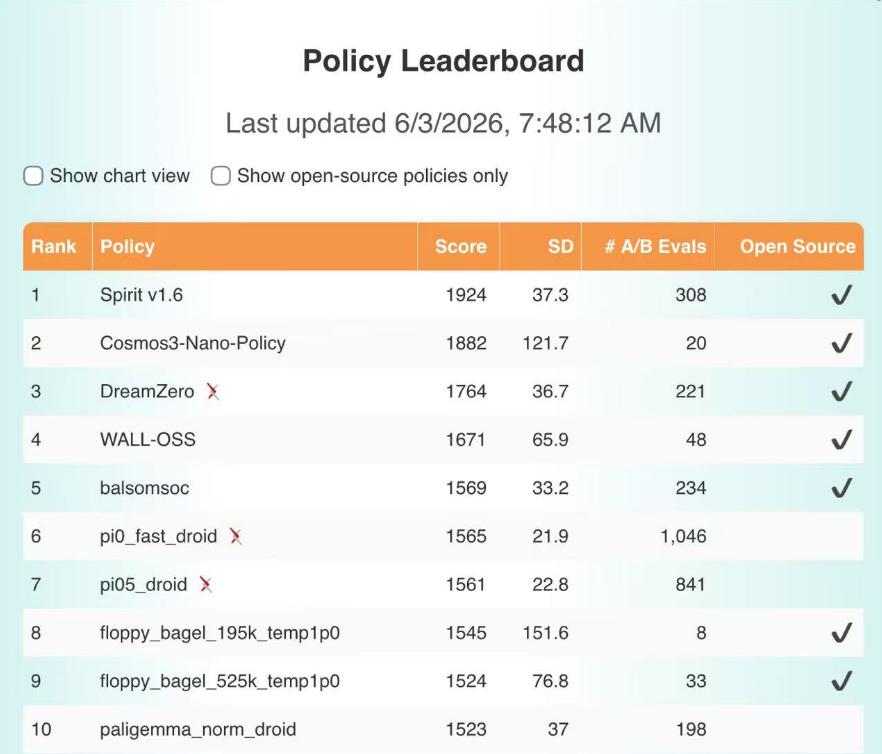
Qianxun Intelligent wählt den Weg der Drittanbieter-Ranglisten. Im Januar erreichte sein Modell Spirit v1.5 66,09 Punkte und eine Erfolgsrate von 50,33 % bei 30 realen Roboteraufgaben im RoboChallenge, übertraf das seit Monaten an der Spitze stehende π0.5 und war das einzige Modell mit einer Erfolgsrate von über 50 %. Im Juni erreichte Spirit v1.6 den ersten Platz im RoboArena und übertraf Nvidia Cosmos3 sowie π0.5 von Physical Intelligence. Später kam es zu Kontroversen um diesen Spitzenplatz: Beobachter wiesen darauf hin, dass mehr als 70 % der Punkte in den Bewertungsaufzeichnungen von zwei Konten stammten. RoboArena rollte die zweifelhaften Daten zurück und aktualisierte die Rangliste, sodass Spirit v1.6 von der Liste entfernt wurde. Qianxun hat bislang keine öffentliche Stellungnahme dazu abgegeben. In den Produktionslinien von CATL erreicht sein Roboter bei dem Einstecken von Hochspannungsprüfsteckern eine stabile Erfolgsrate von über 99 %.
AstraBrain-WBC 0.5 von Galaxy Universal wurde mit 20.000 Stunden menschlicher Aktionsdaten und 80,4 Millionen Parametern trainiert. Das Unternehmen gibt an, dass es auf realen Robotern die zero-shot-Ausführung vieler unbekannter Aktionen erreicht. Man muss dies aber differenziert betrachten: Die von ihm im August auf der Weltroboterkonferenz vorgeführte Generalisierung der Ganzkörperbewegungssteuerung wurde offiziell als ferngesteuerte Demonstration markiert.
Das am 15. September von Songyan Power vorgestellte HERON-CRA erreicht eine Generalisierung über verschiedene Roboterplattformen hinweg: Derselbe Modell treibt sowohl einen Manipulatorarm als auch einen radgetriebenen humanoiden Roboter an. Die Erfolgsrate beim ersten Test des Sockenfaltens beträgt 38,5 %, nach der Aktivierung des Reinforcement Learning 97,8 % – beide Zahlen wurden vom Unternehmen selbst gemessen.
G0.5 von Star Map erreicht auf dem DROID-Benchmark eine durchschnittliche Zero-Shot-Erfolgsrate von 82,5 % bei zehn Desktop-Aufgaben und übertrifft π0.5 bei jeder einzelnen Aufgabe. Auf der Weltroboterkonferenz im August erledigte der Roboter im Vorlager nach Online-Bestellungen von Zuschauern selbstständig die Erkennung, Planung, das Greifen, das Öffnen von Taschen und das Verpacken – während der Messe wurden insgesamt 900 Bestellungen abgeschlossen.
Accelerated Evolution ließ auf der zweiten Weltmeisterschaft der humanoiden Roboter 80 Roboter selbstständig ihre Formationen wechseln. Gründer Cheng Hao trennte dies von der Gruppensteuerung ab und erklärte, dass jeder Roboter selbst mit seinem Laserradar berechnet, wohin er als nächstes fährt. Das Team von Professor Zhao Mingguo von der Tsinghua-Universität nutzte den Booster T1 des Unternehmens für Fußballforschungen, die im August in der Zeitschrift *Science Robotics* veröffentlicht wurden. Der Roboter wurde zero-shot auf Rasen, Steinplatten, Erde und Asphalt eingesetzt und erreichte eine Erfolgsrate von etwa 90 % bei Torschüssen im Vorfeld …
