罗福莉也学雷军玩直播,小米新模型训练首次公开,一小时狂烧20万
就在刚刚,小米 MiMo 团队公布了最新进展。
小米 MiMo 负责人罗福莉在 X 平台发文表示,过去近半年团队一直围绕一个问题展开研究:强化学习(RL)还能扩展到什么程度。
她透露,目前 MiMo-V2.6 正处于 RL 训练过程中,团队正在扩大三个方向的规模,包括计算资源、训练环境与任务体系,以及奖励评估机制。未来几周,小米 MiMo 团队将陆续公开更多技术细节。
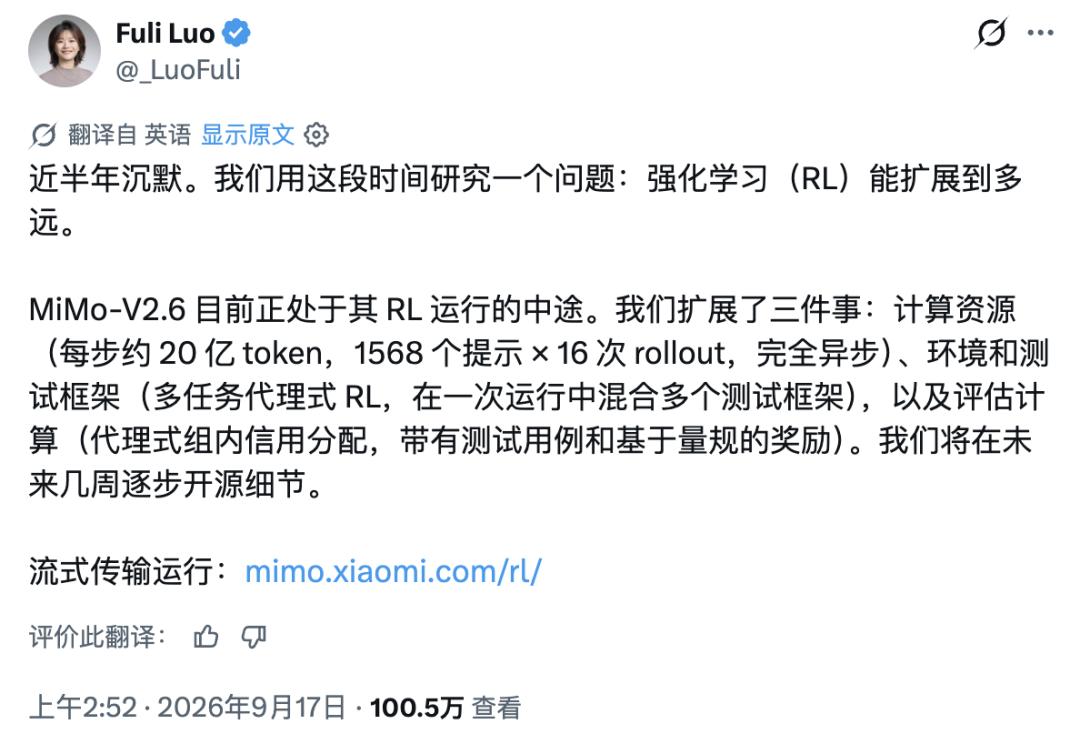
直播🔗 https://mimo.xiaomi.com/rl/#overview
与此同时,罗福莉还分享了 MiMo-V2.6 的实时训练页面,让外界首次看到这一代模型强化学习阶段的部分训练状态。
从罗福莉公开的训练页面来看,MiMo-V2.6 当前正在进行一次大规模 Agent 强化学习实验。页面展示了模型训练进度、Token 消耗、训练成本、样本数量以及多个内部指标变化。
目前训练页面中包含两个版本,分别是 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash。
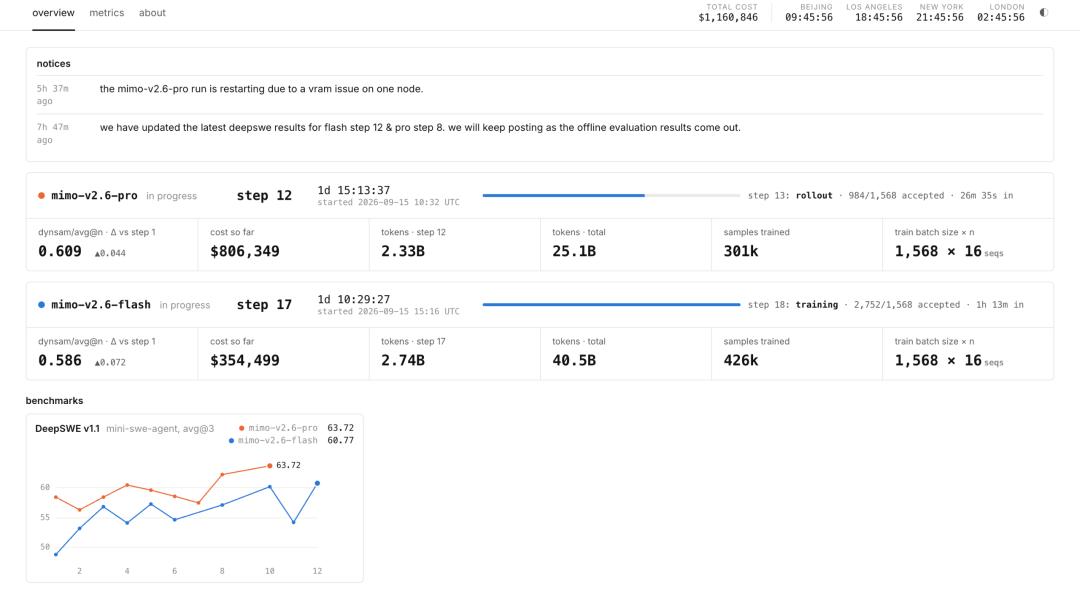
其中,MiMo-V2.6-Pro 当前处于 step 12 阶段,累计训练样本达到约 301K,训练成本约 806,349 美元,累计消耗 Token 达到 25.1B。
MiMo-V2.6-Flash 当前处于 step 17 阶段,累计训练样本达到约 426K,训练成本约 354,499 美元,累计消耗 Token 达到 40.5B。
两个版本当前累计训练成本已经超过 116 万美元,平均每小时计算成本约达到 3.09 万美元(折合人民币 20.72 万元)。不过,从训练面板的数据来看,小米此次公开的重点并不是成本,而是展示 RL 训练过程中模型如何通过大规模任务交互不断提升能力。
MiMo-V2.6 正在挑战 RL 的规模边界
罗福莉在 X 中提到,MiMo-V2.6 本轮强化学习训练重点扩大了三个方向。
第一个方向是计算规模。
她表示,团队将单个训练 step 的规模提升到约 2B tokens,同时采用 1568 个 prompts × 16 rollouts 的训练方式,并使用 fully async,也就是完全异步训练。
按照这一配置计算,单个训练 step 理论上会产生约 2.5 万次模型尝试,相当于让 AI 同时探索大量不同解决路径。
在这种训练方式下,模型面对一个任务时,不会只生成一次答案,而是会同时尝试多种解决方案,再根据奖励反馈判断哪些路径更加有效。
对于 Agent 模型来说,大规模探索能力非常关键。过去的大模型更多依靠预训练获得知识,再通过监督微调调整输出方式。
但当 AI 开始承担编程、办公、资料分析等复杂任务后,模型需要的不只是回答问题,还需要规划步骤、调用工具、验证结果。
强化学习的价值,就在于让模型通过大量尝试和反馈,逐渐形成更有效的任务执行策略。
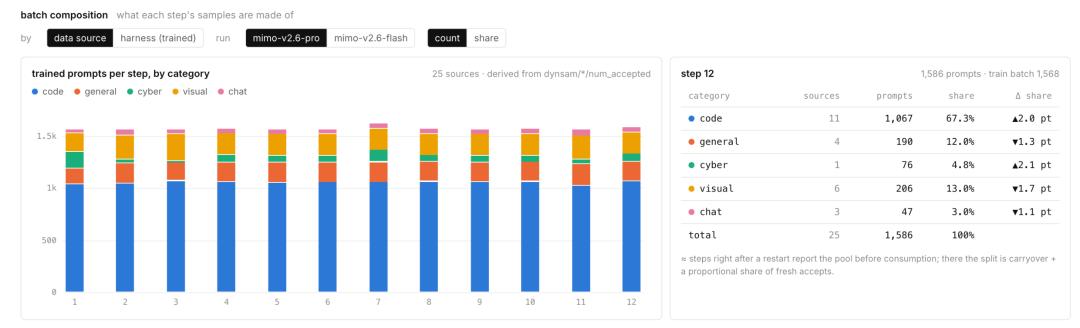
第二个方向是训练环境。罗福莉表示,团队扩大了 environments 和 harnesses,引入 multi-task agentic RL,将多个任务环境混合到一次训练流程中。
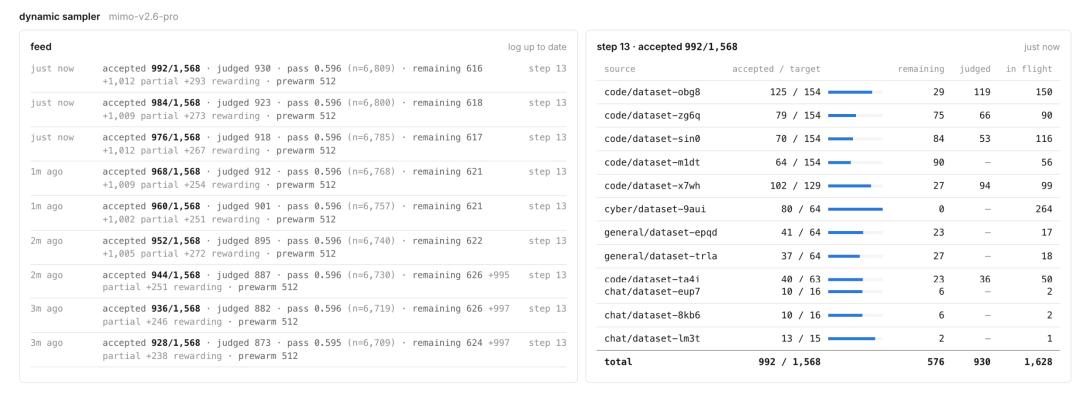
从 MiMo-V2.6 实时监控面板显示的数据来看,当前训练任务覆盖视觉、代码、通用任务以及聊天任务。
页面中可以看到 visual/dataset-jz3d、visual/dataset-gtaV、visual/dataset-vs3e 等视觉数据集,也包含 code/dataset-4qn 等代码任务,以及 general、chat 类数据集。
这意味着 MiMo-V2.6 并不是只优化某一种能力,而是在尝试让模型同时适应不同类型的 Agent 场景。
第三个方向是增加评判系统的计算投入。
罗福莉提到,团队引入了 agentic in-group credit assignment,并结合 test-case 和 rubric-based rewards。
复杂 Agent 任务通常包含多个执行步骤。
模型可能需要先搜索信息,再制定方案,然后调用工具完成任务。
罗福莉提到,团队采用智能体式的组内贡献归因,并结合测试用例和评分细则提供奖励。面对多种任务和多条执行轨迹,评判系统需要提供有区分度的反馈,帮助模型从不同尝试中学习更有效的任务执行策略。
更细致的奖励分配机制,可以帮助模型学习更加有效的执行路径。
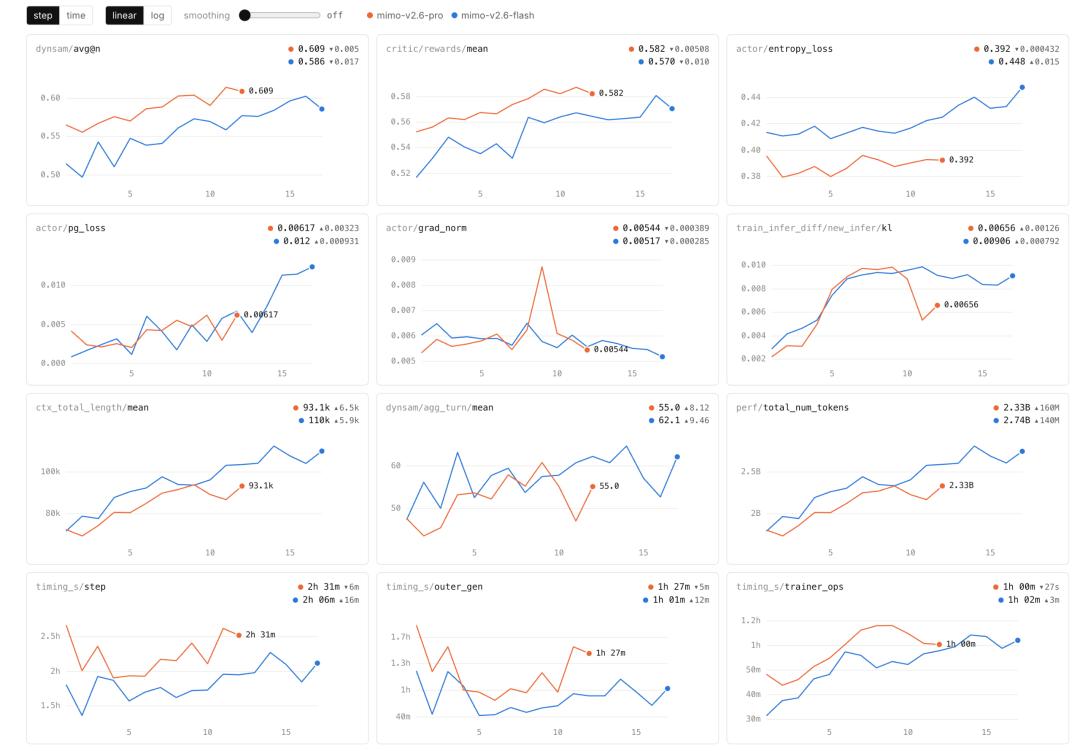
从页面中的指标变化来看,MiMo-V2.6 的奖励相关指标正在随着训练推进提升。
例如从 critic/rewards/mean 曲线来看,Pro 的平均奖励由训练早期约 0.55 提高至 0.582,Flash 则由约 0.52 提高至 0.570,两条曲线均在波动中整体上升。
训练页面透露出的信号,小米正在押注 Agent 时代
除了展示训练过程,罗福莉公开的训练页面还透露了 MiMo-V2.6 当前的能力变化。
截至发稿前,从该训练面板的数据来看,MiMo-V2.6-Pro 当前 DeepSWE v1.1 benchmark 得分达到 63.72,MiMo-V2.6-Flash 得分达到 60.77。
DeepSWE 主要用于测试模型的软件工程能力,包括代码理解、修改以及复杂开发任务处理。
与此同时,训练页面中的上下文长度指标也持续增长。其中,ctx_total_length 数据显示,MiMo-V2.6-Pro 当前平均上下文长度已经接近 10 万 Token,Flash 版本也超过这一规模。
对于 Agent 模型而言,长上下文能力意味着模型可以持续记住此前的操作步骤、工具反馈以及任务状态,这也是完成复杂工作的基础。
值得注意的是,此次小米公开的是训练过程,而不是最终模型成绩。
过去,大模型公司通常只在模型发布时公布参数、榜单成绩和应用案例,训练过程往往处于黑盒状态。此次罗福莉分享实时训练页面,让外界能够看到模型训练中的计算规模、任务组成以及能力变化。
目前,Pro 和 Flash 的训练仍在继续。
随着曲线延伸,我们将能持续追踪三个关系:计算投入与能力提升的关系,执行长度与任务效果的关系,以及环境多样性与模型适应能力的关系。
罗福莉提出的「强化学习能扩展多远」,也将通过这些关系逐渐得到回答:增加的计算,能否让模型在更多环境中,更稳定、更高效地完成复杂任务。
本文来自微信公众号“APPSO”,作者:发现明日产品,36氪经授权发布。