Luo Fuli hat es Lei Jun gleichgetan und betreibt Live-Streaming. Das neue Modelltraining von Xiaomi wurde erstmals öffentlich vorgestellt, wobei innerhalb einer Stunde 200.000 Yuan verbrannt wurden.
Gerade eben hat das MiMo-Team von Xiaomi die neuesten Fortschritte bekannt gegeben.
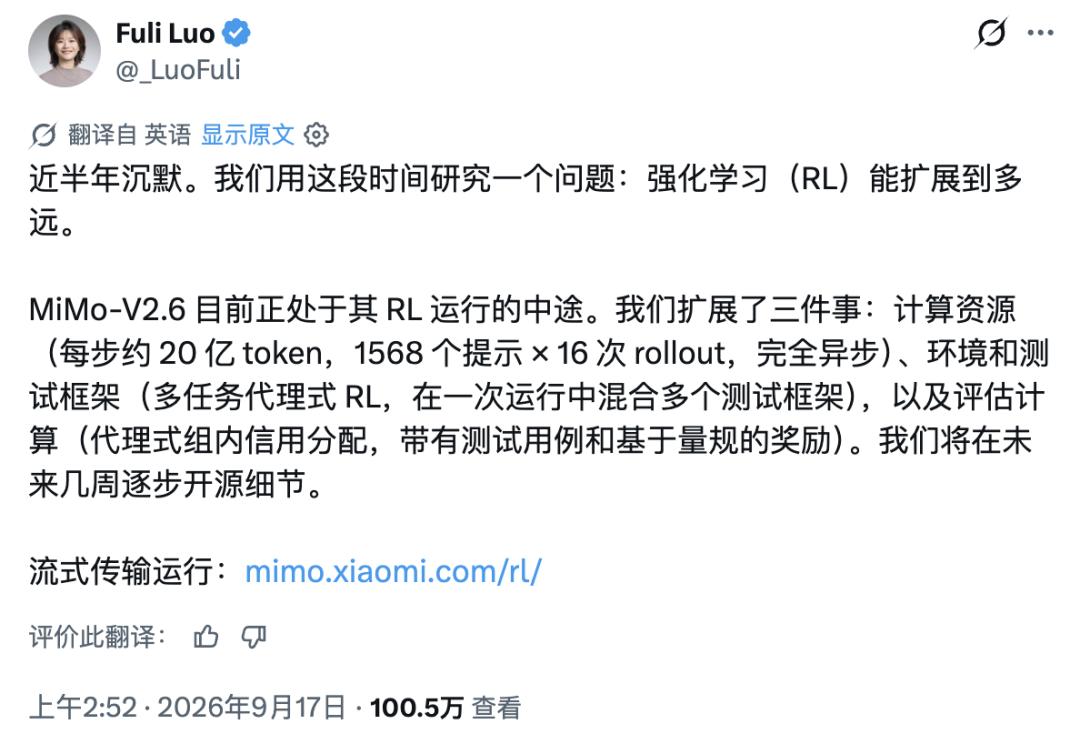
Luo Fuli, Leiterin von Xiaomi MiMo, hat auf der Plattform X einen Beitrag veröffentlicht, in dem sie angibt, dass das Team in den vergangenen fast sechs Monaten seine Forschung um eine Frage herum konzentriert hat: In welchem Umfang kann Reinforcement Learning (RL) noch skaliert werden.
Sie verriet, dass sich MiMo-V2.6 derzeit im RL-Training befindet. Das Team skaliert drei Bereiche: Rechenressourcen, Trainingsumgebungen und Aufgabensysteme sowie der Belohnungsbewertungsmechanismus. In den kommenden Wochen wird das Xiaomi MiMo-Team schrittweise weitere technische Details veröffentlichen.
Live-Stream🔗 https://mimo.xiaomi.com/rl/#overview
Gleichzeitig teilte Luo Fuli auch die Echtzeit-Trainingsseite von MiMo-V2.6 mit, sodass die Öffentlichkeit erstmals einen Teil des Trainingszustands dieser Modellgeneration in der Phase des Reinforcement Learning sehen kann.
Aus der von Luo Fuli veröffentlichten Trainingsseite geht hervor, dass MiMo-V2.6 derzeit ein groß angelegtes Agent-Reinforcement-Learning-Experiment durchführt. Die Seite zeigt den Trainingsfortschritt des Modells, den Token-Verbrauch, die Trainingskosten, die Anzahl der Stichproben sowie die Veränderung mehrerer interner Metriken.
Derzeit enthält die Trainingsseite zwei Versionen: MiMo-V2.6-Pro und MiMo-V2.6-Flash.
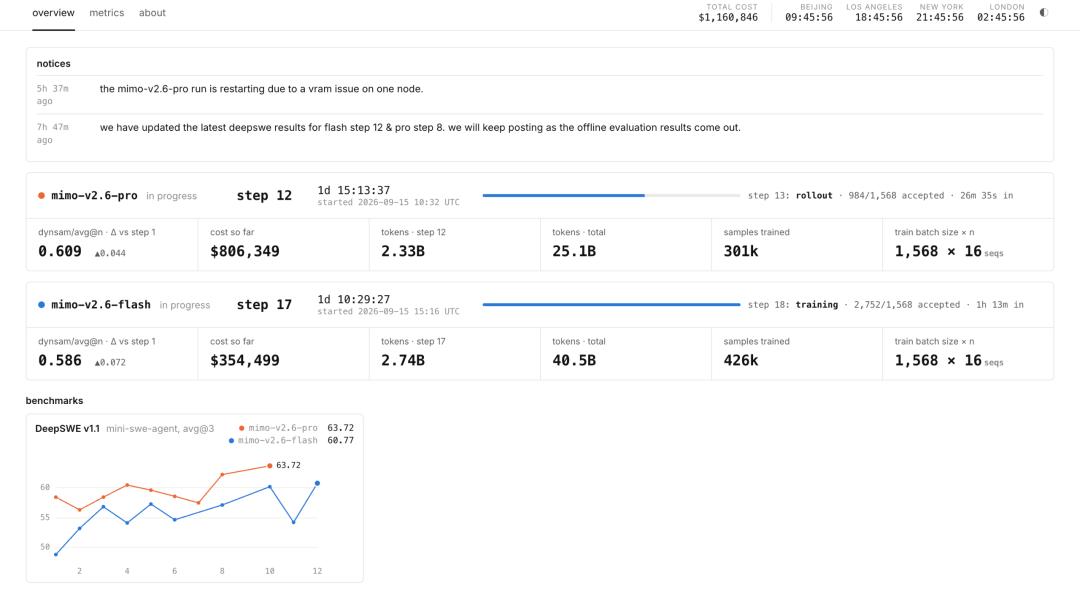
Darin befindet sich MiMo-V2.6-Pro derzeit in Phase Schritt 12, mit insgesamt etwa 301K Trainingsstichproben, Trainingskosten von etwa 806.349 US-Dollar und einem kumulierten Token-Verbrauch von 25,1 Milliarden.
MiMo-V2.6-Flash befindet sich derzeit in Phase Schritt 17, mit insgesamt etwa 426K Trainingsstichproben, Trainingskosten von etwa 354.499 US-Dollar und einem kumulierten Token-Verbrauch von 40,5 Milliarden.
Die kumulierten Trainingskosten der beiden Versionen haben bereits 1,16 Millionen US-Dollar überschritten, die durchschnittlichen Rechenkosten pro Stunde betragen etwa 30.900 US-Dollar (umgerechnet 207.200 Yuan). Aus den Daten des Trainingsdashboards geht jedoch hervor, dass der Schwerpunkt der öffentlichen Bekanntgabe von Xiaomi nicht auf den Kosten liegt, sondern darauf zu zeigen, wie das Modell während des RL-Trainings seine Fähigkeiten durch groß angelegte Aufgabeninteraktionen ständig verbessert.
MiMo-V2.6 fordert die Skalierungsgrenzen von RL heraus
Luo Fuli erwähnte auf X, dass das Team bei dieser Runde des Reinforcement-Learning-Trainings von MiMo-V2.6 drei Bereiche gezielt skaliert hat.
Der erste Bereich ist der Rechenumfang.
Sie gab an, dass das Team den Umfang eines einzelnen Trainingsschritts auf etwa 2 Milliarden Token angehoben hat, gleichzeitig die Trainingsmethode von 1568 Prompts × 16 Rollouts anwendet und vollständig asynchrones Training nutzt.
Nach dieser Konfiguration erzeugt ein einzelner Trainingsschritt theoretisch etwa 25.000 Modellversuche, was bedeutet, dass die KI gleichzeitig eine Vielzahl unterschiedlicher Lösungspfade erkundet.
Bei dieser Trainingsmethode generiert das Modell bei einer Aufgabe nicht nur einmal eine Antwort, sondern probiert gleichzeitig mehrere Lösungsansätze aus und beurteilt dann anhand von Belohnungsfeedback, welche Pfade effektiver sind.
Für Agent-Modelle ist die Fähigkeit zur groß angelegten Erkundung sehr entscheidend. Frühere große Sprachmodelle haben ihr Wissen hauptsächlich durch Vortraining erworben und dann die Ausgabeweise durch überwachte Feinabstimmung angepasst.
Aber wenn die KI komplexe Aufgaben wie Programmierung, Büroarbeit und Datenanalyse übernimmt, braucht das Modell nicht nur Fragen zu beantworten, sondern auch Schritte zu planen, Tools aufzurufen und Ergebnisse zu überprüfen.
Der Wert des Reinforcement Learning liegt darin, dass das Modell durch zahlreiche Versuche und Feedback allmählich effektivere Strategien zur Aufgabenausführung bildet.
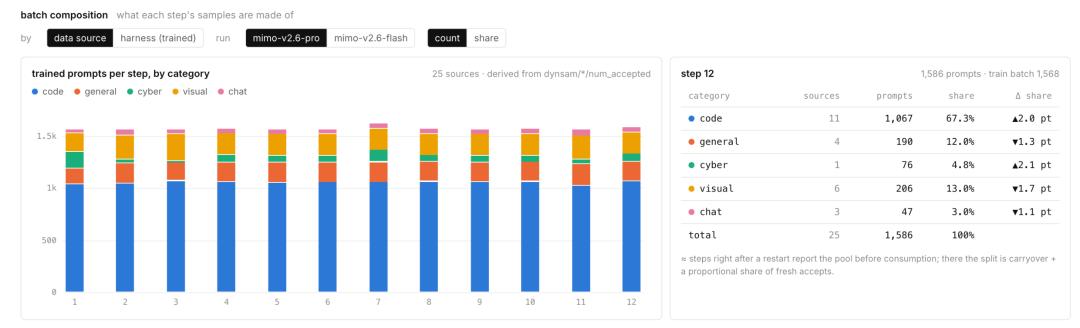
Der zweite Bereich ist die Trainingsumgebung. Luo Fuli gab an, dass das Team die Umgebungen und Harnesses erweitert, multi-task agentisches RL eingeführt und mehrere Aufgabenumgebungen in einen einzigen Trainingsablauf gemischt hat.
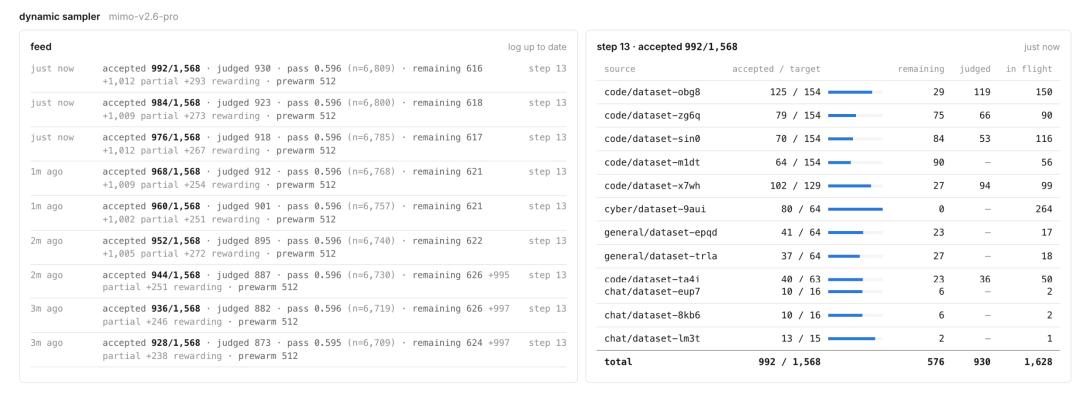
Aus den Daten des Echtzeit-Überwachungsdashboards von MiMo-V2.6 geht hervor, dass die aktuellen Trainingsaufgaben visuelle Aufgaben, Code-Aufgaben, allgemeine Aufgaben und Chat-Aufgaben abdecken.
Auf der Seite sind visuelle Datensätze wie visual/dataset-jz3d, visual/dataset-gtaV und visual/dataset-vs3e zu sehen, außerdem Code-Aufgaben wie code/dataset-4qn sowie allgemeine und Chat-Datensätze.
Das bedeutet, dass MiMo-V2.6 nicht nur eine einzelne Fähigkeit optimiert, sondern versucht, das Modell gleichzeitig an verschiedene Arten von Agent-Szenarien anzupassen.
Der dritte Bereich ist die Erhöhung des Rechenaufwands für das Bewertungssystem.
Luo Fuli erwähnte, dass das Team agentische In-Gruppen-Leistungszuordnung eingeführt und diese mit Testfällen und rubrikbasierten Belohnungen kombiniert hat.
Komplexe Agent-Aufgaben umfassen normalerweise mehrere Ausführungsschritte.
Das Modell muss möglicherweise zuerst Informationen suchen, dann einen Plan erstellen und schließlich Tools aufrufen, um die Aufgabe abzuschließen.
Luo Fuli erwähnte, dass das Team eine agentische Leistungsattribution innerhalb der Gruppe einsetzt und Belohnungen in Kombination mit Testfällen und Bewertungsrichtlinien bereitstellt. Angesichts verschiedener Aufgaben und mehrerer Ausführungspfade muss das Bewertungssystem differenziertes Feedback liefern, um dem Modell zu helfen, aus verschiedenen Versuchen effektivere Strategien zur Aufgabenausführung zu lernen.
Ein feinerer Belohnungsverteilungsmechanismus kann dem Modell helfen, effektivere Ausführungspfade zu lernen.
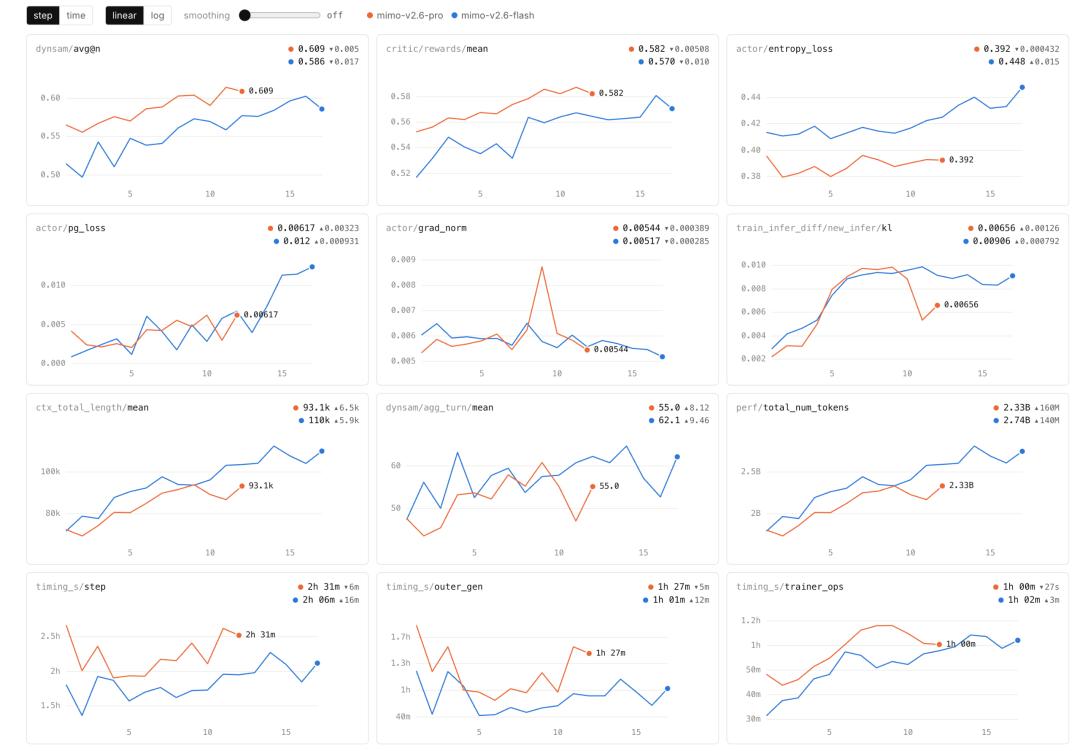
Aus der Veränderung der Metriken auf der Seite geht hervor, dass die belohnungsbezogenen Metriken von MiMo-V2.6 mit fortschreitendem Training steigen.
Zum Beispiel aus der Kurve von critic/rewards/mean: Die durchschnittliche Belohnung von Pro stieg von etwa 0,55 in der frühen Trainingsphase auf 0,582, die von Flash stieg von etwa 0,52 auf 0,570, beide Kurven steigen insgesamt bei Schwankungen an.
Das Signal der Trainingsseite: Xiaomi setzt auf das Agent-Zeitalter
Neben der Darstellung des Trainingsprozesses gibt die von Luo Fuli veröffentlichte Trainingsseite auch Aufschluss über die aktuellen Fähigkeitsveränderungen von MiMo-V2.6.
Nach den Daten dieses Trainingsdashboards vor Redaktionsschluss erreicht MiMo-V2.6-Pro derzeit einen Score von 63,72 im DeepSWE v1.1 Benchmark, MiMo-V2.6-Flash erreicht einen Score von 60,77.
DeepSWE wird hauptsächlich zur Prüfung der Software-Engineering-Fähigkeiten des Modells verwendet, einschließlich Code-Verständnis, Code-Modifikation und Bearbeitung komplexer Entwicklungsaufgaben.
Gleichzeitig steigt die Metrik der Kontextlänge auf der Trainingsseite stetig an. Aus den Daten von ctx_total_length geht hervor, dass die durchschnittliche Kontextlänge von MiMo-V2.6-Pro derzeit fast 100.000 Token erreicht, die Flash-Version überschreitet ebenfalls diesen Umfang.
Für Agent-Modelle bedeutet die Fähigkeit zur langen Kontextlänge, dass das Modell sich ständig an vorherige Betriebsschritte, Tool-Feedback und Aufgabenstatus erinnern kann, was auch die Grundlage für die Erledigung komplexer Arbeiten ist.
Es ist bemerkenswert, dass Xiaomi dieses Mal den Trainingsprozess und nicht die endgültigen Modellleistungen veröffentlicht hat.
In der Vergangenheit haben Unternehmen für große Sprachmodelle normalerweise nur bei der Modellveröffentlichung Parameter, Ranglistenleistungen und Anwendungsfälle bekanntgegeben, der Trainingsprozess befand sich oft in einem Black-Box-Zustand. Indem Luo Fuli die Echtzeit-Trainingsseite teilt, kann die Öffentlichkeit den Rechenumfang, die Aufgabenkomposition und die Fähigkeitsveränderungen während des Modelltrainings sehen.
Derzeit laufen die Trainings von Pro und Flash noch weiter.
Mit der Fortsetzung der Kurven können wir drei Zusammenhänge ständig verfolgen: den Zusammenhang zwischen Rechenaufwand und Fähigkeitsverbesserung, den Zusammenhang zwischen Ausführungslänge und Aufgabenergebnis sowie den Zusammenhang zwischen Umgebungsvielfalt und Modellanpassungsfähigkeit.
Die Frage von Luo Fuli "Wie weit kann Reinforcement Learning skaliert werden?" wird durch diese Zusammenhänge allmählich beantwortet: Ob der erhöhte Rechenaufwand es dem Modell ermöglichen kann, komplexe Aufgaben in mehr Umgebungen stabiler und effizienter zu erledigen.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "APPSO", Autor: Entdeckung von Produkten für morgen, veröffentlicht mit Genehmigung von 36Kr.