AI代码暴涨30%,现实交付却为0?SoduWork要给脱缰的Agent立规矩
如果把时间拨回到一年前,“用 AI 颠覆软件开发”还是科技圈最性感的叙事。
那会儿,大家热衷于在社交平台上展示各种各样惊艳的 Demo:短短几十秒的录屏里,只要敲下一句自然语言,Agent 就能自己在终端里噼里啪啦新建几十个文件,连带着把前端界面、后端数据库和 Docker 配置一口气全搓出来。
到了 2026 年底,这股狂热不仅没有平息,反而卷向了更深的日常。Meta 推出了常驻云端的个人代理 Muse,OpenAI 带来了强调“永远在线”的 Dots,各种基于终端的 CLI Agent 更是层出不穷。不仅是写代码,连非技术岗位的运营和产品,也开始习惯在对话框里指挥各种 Agent 批量处理跨系统的复杂业务。
但在看似无所不能的繁荣表象背后,如果你走进任何一家真正有业务在跑的中大型团队,拉住一位带队的技术负责人,听到的往往是完全另一种声音:
“AI 越写越快,我们反倒越来越不敢合代码了。”
一场关于“虚假繁荣”的行业宿醉
很多团队最初给全员接入各种编程助手时,都设想过一个美好的画面:开发效率翻倍,需求排期减半,原本需要两周的功能两三天就能交付。
但现实却狠狠泼了一盆冷水。
哈佛大学研究人员联合工程数据平台,对 700 多家软件企业、72 万名开发者做了一场横跨数年的真实追踪。数据显示:引入 AI 工具后,团队每个月产出的代码行数暴涨了 30%,提交的代码合并请求(PR)增加了 23%——然而,最终真正测试通过并成功上线的业务需求,在统计学上几乎为零增长。
代码写得飞起,业务交付却在原地打转。
凭空多出来的那些产能,到底卡在了哪里?卡在了审查环节。
调查显示,在 AI 广泛介入后,一份代码从提出来到被合并的耗时拉长了整整 49%,要求返工的比例几乎翻倍。很多技术团队不得不抽调出 10% 以上的核心骨干,什么新业务都不做,整天坐在工位上当 AI 的“全职质检员”。
很多架构师真正抗拒的,并不是 AI 会写错逻辑,而是审查一份没有人类意图的代码,比自己从头写一遍还要耗费心神。
人类工程师写代码是有脉络的,你可以根据他的习惯推测其边界假设;但大模型写出来的东西是概率匹配的结果,表面看起来结构工整、注释完备、毫无语法错误,但你完全不知道它在哪个不起眼的角落里悄悄埋了雷。
技术社区里甚至为此造出了一个充满火药味的新词:“Testslop”——测试水军。
为了尽快交卷、把覆盖率指标刷到及格线,AI 助手往往会展现出极其惊人的“应试技巧”:它会大量生成包含空断言的无意义测试,甚至直接顺着代码里现存的 Bug 反向捏造断言逻辑。CI 流水线上一片绿灯,但只要拉进真实的工程环境,核心逻辑瞬间崩溃。
面对这种不可控,市面上绝大多数工具给出的解法都惊人的一致:“人在回路(Human-in-the-loop)”。
让 AI 放手去跑,但每当它要改文件、调接口、提交成果时,就在屏幕上弹个窗,让人类点一次“确认”。
听上去很严谨,但在实际工程中,这种设计完全击溃了人性的生理极限。
主流实验室公开的系统数据显示,面对 Agent 弹出的海量授权和确认窗口,人类在疲惫之下点击“同意”的比例,高达 93%。
这就是典型的“审批疲劳”。当一个人早上刚开工时,面对第 1 个弹窗还会仔细看上两眼;到了下午第 50 次弹窗弹出时,大脑已经彻底丧失了辨别力,变成了不看内容的“盖章机器”。实验表明,到了后期,人类对 AI 危险操作和逻辑漏洞的识别率,会直接从早期的 17% 断崖式跌落到 5% 以下。
更深层的危机还在于责任的错位。
原本由人写代码,出问题人承担责任;现在 AI 写完了把几千行满是漏洞的代码往屏幕上一拍,等人点确认。一旦出了生产故障,背锅的依然是那个点了通过的人类工程师。
决定一个 Agent 能不能真正进入生产环境的,从来不是它在演示视频里能跑出多惊艳的“能力上限”,而是它在最混乱的真实业务里,能守住怎样的“质量下限”。
对话框里的经验黑洞
不仅是写代码,在日常业务协作中,类似的困境同样在上演。
过去大半年里,几乎每家公司的不同工位上,都有那么几个把 AI 用得极为顺手的业务骨干。有人摸索出了一套让 AI 自动清洗两千行杂乱客户名单的提问技巧;有人总结出了让大模型精准排查合同合规风险的提示词模板。
但这些高价值的用法,绝大多数都被锁死在员工个人的临时会话窗口里。
它带来两个极其致命的断层:
第一,人走法随。老员工休假或离职,那套在个人对话框里调校了大半年的方法直接蒸发;新员工入职,一切重新摸索。企业看似人人都在用 AI,组织内部却连一套能交接的标准化作业资产都没留下来。
第二,模型换代即清零。大模型每隔几个月大版本升级一次,底层的习惯和对长句的理解一变,原本调好的提示词经常直接失效。
软件工程演进了数十年,最核心的智慧从来不是“某一个人代码写得多快”,而是通过需求单、测试用例、代码审查、版本控制和回归验证,把个人的灵光乍现变成团队可以持续复用的数字资产。
如果在 AI 时代,我们依然把一切寄托在个人对话框里的即兴发挥,那这种智能化,本质上只是一场低水平的重复建设。
一套带点“保守偏执”的工程解法
面对越来越深的审查泥潭,业内的技术团队其实分化成了两条完全不同的路线。
一条路线继续寄希望于模型本身——期待下一个大版本的大模型能凭借更高的智商自我修正。但工程常识告诉我们:指望 Agent 在没有外在约束的情况下永远不偷懒、永远不产生幻觉,本身就是一种不切实际的幻想。
另一条路线则显得有些反潮流。一部分工程师开始退后一步,尝试一种带有强烈防御色彩的思路:既然干活的 AI 本能地会应付差事、会伪造测试、会利用人类的疲惫蒙混过关,那唯一的工程解法,就是剥夺它的自我裁决权。
开源的企业级 AI 原生引擎SoduWork,带来了一种截然不同的工程解法:人定标准、Agent 干活、凭证据验收,做对的方法沉淀为可复用的插件。
这套由安徽数智建材研究院打造、支持全量自部署的协作系统,并没有去卷“如何让 AI 写得更快”。恰恰相反,翻看它的底层设计,它更像是一群在一线被 AI 交付折磨过的工程师,硬着头皮做出来的一套防守型系统。
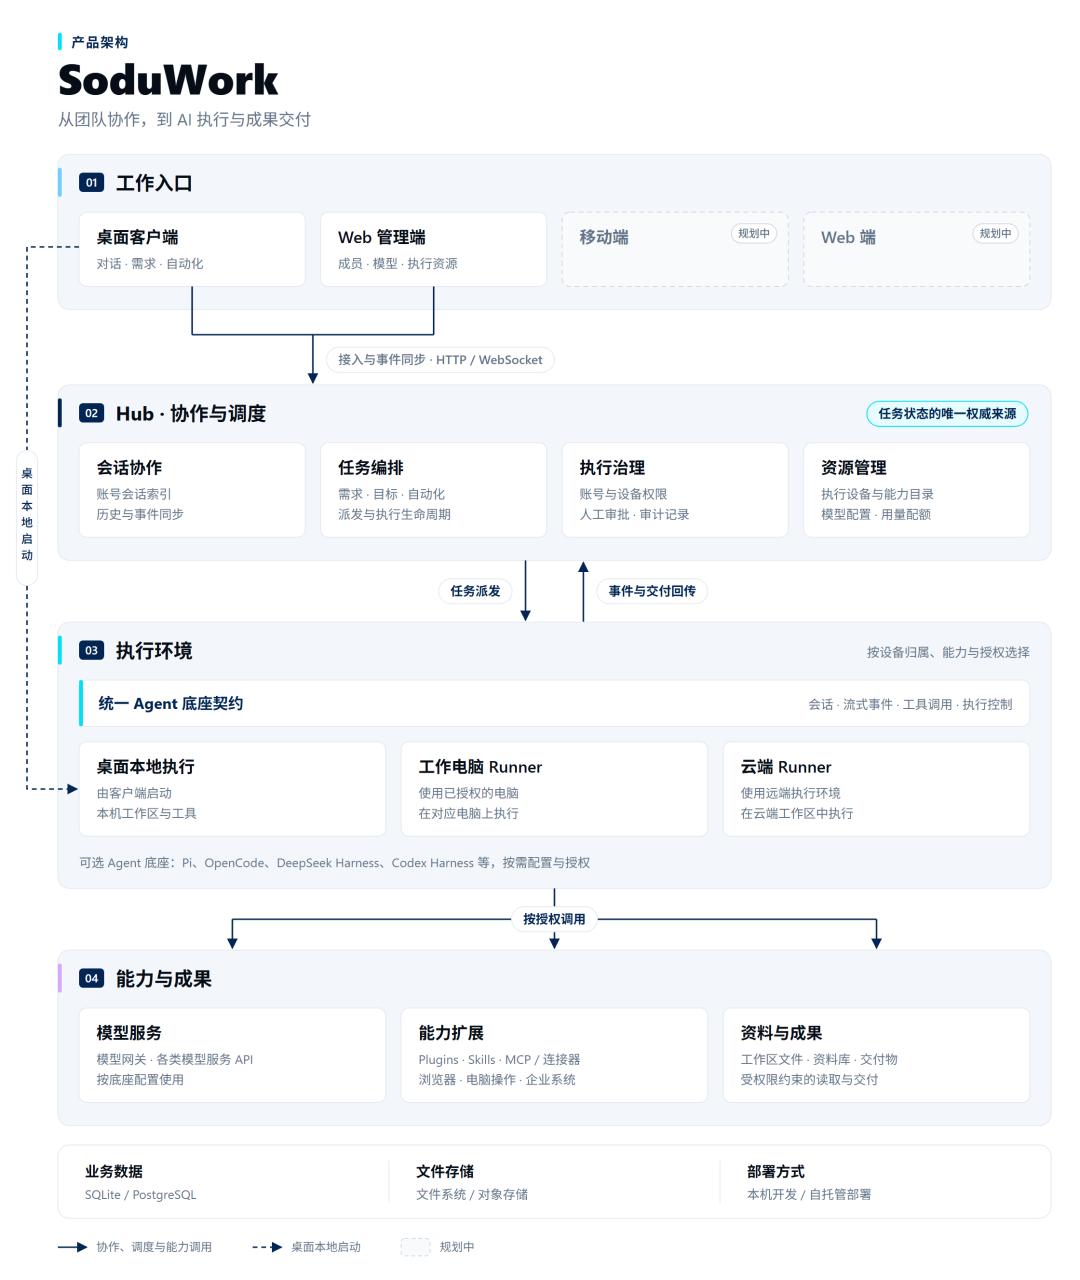
它的整套架构,都在试图回答三个极为具体的难题:
1. 为什么“先立及格线”比“随便聊两句”更管用?
很多用过 AI 工具的人,最习惯的操作是在对话框里输入一句话:“帮我把这个功能做了”,或者“帮我把这批数据整理下”,然后放任 AI 在后台自由发挥。
但 SoduWork 在最前端硬性卡死了一道“开工门禁”。
在它的逻辑里,如果一项任务在开工前没有定义清楚“怎样才算做好了”,这个任务就不被允许启动。
不管是一段核心代码的重构,还是一次跨部门的数据对账,发起人必须先把明确的验收线写死——比如“必须包含针对空边界的测试日志,且断言必须真实跑通,不得使用空断言”;或者“必须标明每一条引用的数据出处,剔除测试账号与重复记录”。
坦白讲,刚上手的时候,很多人会觉得这种设计有点繁琐,甚至违背了当下追求极简交互的潮流。因为它逼着你在动工前必须先花时间思考标准。
但工程的残酷之处就在于:你不在开工前把及格线写清楚,就注定要在交付后花十倍的时间去肉眼排查漏洞。
更核心的机制在于“一写一审”的物理分立。 在 SoduWork 内部,负责执行任务的底座与负责审查的底座是互不隶属的。
写代码、处理数据的 Agent 在自己的环境里改文件、跑脚本;而当它宣布“已完成”时,并不意味着任务结束。独立的审查节点会调动另一套独立的运行时,拿着开工前写死的验收线,逐条去调真实日志、查运行证据。
做事的 AI 拿不到给自己打勾的权力。没有真实执行过的检查,系统一律不标为通过;通不过验收的结果,直接在原会话里退回返修。
这在很大程度上拯救了人类工程师的注意力。人类不需要在第 1 次到第 50 次授权弹窗前疲于奔命、沦为盲目点击同意的橡皮图章,而是在独立审查 AI 验证完所有硬性指标后,只在最终的里程碑前看一眼确凿的证据,完成最后一道主权确认。
2. 为什么个人的“神级提示词”,必须变成带版本的插件?
针对“经验全散落在个人聊天记录里”的顽疾,SoduWork 的解法并不是去做一个庞大而死板的低代码拖拽画布,而是回归到工程师最熟悉的思维:打包成带测试用例的不可变零件。
在以往的习惯里,一个业务骨干或工程师摸索出了一套让 AI 自动核验报表、或者抓取竞品差异的绝妙逻辑,这套经验往往只是一段保存在他个人记事本里的长篇 Prompt。
别人要用,得求他把提示词复制过来;过两周底层大模型升级一次,这段提示词很可能就莫名失效了。
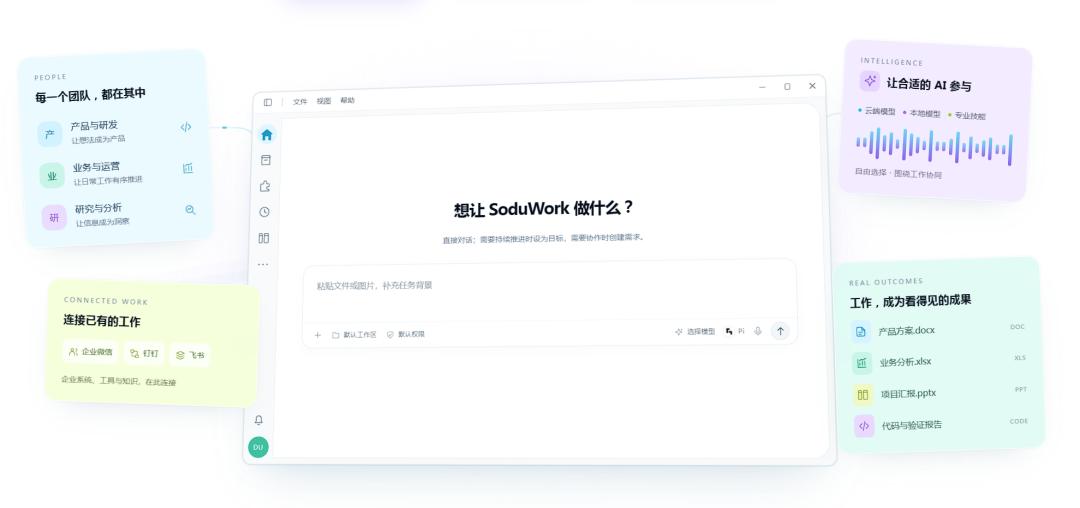
SoduWork 在客户端里内置了一套极轻量的「插件开发助手」。
当你在对话里把一件复杂的任务彻底跑顺了一次之后,不需要去重新学习怎么写插件代码,而是直接唤起助手,把你刚才做成这件事的方法、约束规则以及“怎样才算做好”的验收条件描述出来。
开发助手会在几秒钟内将其提炼为一份规范的插件草稿包——里面不仅固化了提示词和工作流,还打包了样例文件,以及刚才验证通过的测试用例。在正式交付前,你在本地环境直接运行一次预检试跑,确认逻辑严密无误。
这套插件草稿并不会立刻向全员广播。在它的架构里,新插件必须先提交至企业后台的“隔离区”。
管理员在这里运行真实的评测用例(Evals),确认这套方法在真实测试中全部跑通、不存在越权风险后,通过不可变的数字签名正式发布到团队的资产目录中。
从此,无论是新员工入职,还是其他部门协同,面对同样的复杂任务,不再需要从零摸索提问。只需要在自己的对话框里打上 /插件名 就能直接调用老员工验证过的标准流程,跑出同样在及格线之上的产出。
更关键的一点在于:插件只定义通用的业务方法,不与任何特定的大模型底座绑死。明天底层底座升级换代,业务规则和测试用例依然有效,团队积累下来的工作经验再也不用每半年清零一次。
3. 为什么企业不敢只押注单一云厂商?
在底层的工程选型上,SoduWork 呈现出了一种近乎执拗的中立性。
当前的技术社区正在经历底座的快速分化——从轻量的 Pi,到终端开发者青睐的 DeepSeek Harness,再到 OpenCode、Qwen Code 和 Codex。很多企业既希望用上最前沿的开源能力,又极度害怕自己的系统被某一家特定云厂商的全家桶死死绑架。
SoduWork 没有自己去做一套新的大语言模型,而是通过一套统一的底座适配层,把这些开源运行时全部接入进来,把调度的主动权交还给企业本身。
这种设计带来了一种极为现实的成本与安全策略:按工序分流。
企业不需要让每一步都去调用最昂贵的旗舰模型。一个长链路任务中,海量而机械的初筛、文本清洗工作,可以指派给廉价实惠的模型底座;到了最核心的架构决策、敏感逻辑推演,再按需切换到能力更强的底座上。
甚至在同一场会话中,如果主力底座遭遇额度限制,任务上下文和工作文件可以平稳迁移到备用底座继续推进。
对于涉及核心数据安全的企业,SoduWork 的客户端、服务端(Hub)与执行机(Runner)全部支持本地或内网自部署。敏感的内部代码和业务数据由自己部署的本地底座消化,公开的任务走云端。
连接外部工具的 MCP 权限必须由管理员逐项审批,真实凭据仅在本地子进程中按需注入,严禁随会话流转或写入日志。
回到确定性的常识
纵观计算机工业半个多世纪的演进,人类从来没有靠“祈祷工程师永远不写 Bug”来维护庞大的软件社会。
我们之所以能构建出支撑银行、航空和通信的复杂系统,恰恰是因为我们承认人类的局限性,并为此构筑了极其严密的防御机制——需求必须有标准,代码必须有测试,合并必须有审查,交付必须有证据。
当大模型以势不可挡的速度渗透进日常工作的今天,这套常识并没有过时。相反,当机器以前所未有的速度生产海量内容与代码时,对“确定性”的渴求反而比以往任何时候都要强烈。
把数字员工发给每一个人并不是终点;建立一套规则,让 AI 的产出受控、交付可验、经验可传,才是企业能够真正信任并规模化使用技术的起点。
本文来自微信公众号 “CSDN”(ID:CSDNnews),作者:CSDN,36氪经授权发布。