Die Menge an KI-generiertem Code stieg sprunghaft um 30 % an, während die tatsächliche produktive Lieferung gleich Null ist? SoduWork will den außer Kontrolle geratenen Agenten verbindliche Regeln auferlegen.
Wenn man die Zeit ein Jahr zurückdreht, war „Softwareentwicklung mit KI revolutionieren“ noch die faszinierendste Erzählung in der Tech-Branche.
Damals waren die Menschen begeistert davon, auf sozialen Plattformen verschiedene beeindruckende Demos zu präsentieren: In einer nur wenigen Sekunden langen Bildschirmaufnahme konnte der Agent durch die Eingabe eines einzigen Satzes in natürlicher Sprache Dutzende von Dateien im Terminal selbstständig erstellen und dabei gleichzeitig die Frontend-Oberfläche, die Backend-Datenbank und die Docker-Konfiguration auf einmal fertigstellen.
Bis zum Ende des Jahres 2026 hat sich diese Begeisterung nicht abgeschwächt, sondern ist stattdessen in den tieferen Alltag eingedrungen. Meta hat den in der Cloud ansässigen persönlichen Assistenten Muse vorgestellt, OpenAI hat Dots auf den Markt gebracht, das den Schwerpunkt auf „ständige Verfügbarkeit“ legt, und verschiedene terminalbasierte CLI-Agenten tauchen immer wieder auf. Nicht nur beim Programmieren, sondern auch nicht-technische Mitarbeiter in den Bereichen Betrieb und Produktmanagement gewöhnen sich daran, verschiedene Agenten im Dialogfeld zu steuern, um komplexe geschäftliche Vorgänge systemübergreifend in großen Mengen zu bearbeiten.
Doch hinter der scheinbar allmächtigen Prosperität verbirgt sich eine ganz andere Stimme, wenn man in jedes mittelständische oder große Team mit laufenden Geschäftsprozessen geht und einen technischen Leiter anspricht:
„Je schneller die KI Code schreibt, desto weniger trauen wir uns, den Code zusammenzuführen.“
Ein Branchen-Kater über „falsche Prosperität“
Viele Teams haben sich zu Beginn, als sie allen Mitarbeitern verschiedene Programmierassistenten zur Verfügung stellten, ein schönes Bild vorgestellt: Die Entwicklungseffizienz verdoppelt sich, die Planungszeit für Anforderungen halbiert sich, und Funktionen, die ursprünglich zwei Wochen dauerten, können in zwei oder drei Tagen geliefert werden.
Aber die Realität hat sie hart getroffen.
Forscher der Harvard University haben gemeinsam mit einer Plattform für Ingenieurdaten über mehrere Jahre hinweg 720.000 Entwickler in mehr als 700 Softwareunternehmen verfolgt. Die Daten zeigen: Nach der Einführung von KI-Tools ist die Anzahl der Codezeilen, die das Team monatlich erzeugt, um 30 % gestiegen, und die Anzahl der eingereichten Pull Requests (PR) hat um 23 % zugenommen – aber die Anzahl der geschäftlichen Anforderungen, die letztendlich die Tests bestanden und erfolgreich in Betrieb genommen wurden, hat statistisch fast nicht zugenommen.
Der Code wird in rasantem Tempo geschrieben, aber die Auslieferung der Geschäftsprozesse stagniert.
Wo steckt die zusätzlich entstandene Produktivität fest? Im Prüfprozess.
Untersuchungen zeigen, dass nach der breiten Beteiligung von KI die Zeit, die für die Einreichung und Zusammenführung eines Codes benötigt wird, um ganze 49 % gestiegen ist, und der Anteil der Rücksendungen zur Nachbearbeitung hat sich fast verdoppelt. Viele technische Teams müssen mehr als 10 % ihrer Kernmitarbeiter abstellen, die keine neuen Geschäftsvorgänge bearbeiten, sondern den ganzen Tag als „Vollzeit-Qualitätskontrolleur“ für die KI arbeiten.
Was viele Architekten wirklich ablehnen, ist nicht, dass die KI falsche Logik schreibt, sondern dass die Prüfung eines Codes ohne menschliche Absicht mehr Energie kostet, als ihn selbst von Grund auf neu zu schreiben.
Menschliche Ingenieure schreiben Code mit einem nachvollziehbaren Verlauf, man kann die Grenzannahmen anhand ihrer Gewohnheiten ableiten; aber das, was große Modelle erzeugen, ist das Ergebnis von Wahrscheinlichkeitsabgleichen. Oberflächlich betrachtet ist die Struktur ordentlich, die Kommentare vollständig und es gibt keine Syntaxfehler, aber man weiß überhaupt nicht, an welcher unscheinbaren Stelle sie heimlich eine Gefahrenquelle versteckt hat.
In technischen Communities wurde sogar ein scharfer neuer Begriff geprägt: „Testslop“ – Test-Spammer.
Um die Aufgabe schnell abzuschließen und die Abdeckungsmetrik auf die bestandene Linie zu bringen, zeigen KI-Assistenten oft erstaunliche „Prüfungsfähigkeiten“: Sie erzeugen massenhaft sinnlose Tests mit leeren Assertionen und erfinden sogar direkt Assertion-Logik, die an vorhandene Fehler im Code angepasst ist. Auf der CI-Pipeline leuchten alle Lichter grün, aber sobald sie in einer echten Ingenieurmgebung eingesetzt werden, bricht die Kernlogik sofort zusammen.
Angesichts dieser Unkontrollierbarkeit ist die Lösung, die die meisten Tools auf dem Markt anbieten, erstaunlich einheitlich: „Human-in-the-loop“ (Mensch in der Schleife).
Man lässt die KI frei arbeiten, aber jedes Mal, wenn sie eine Datei ändern, eine Schnittstelle anpassen oder ein Ergebnis einreichen will, erscheint ein Popup-Fenster auf dem Bildschirm, und der Mensch muss einmal auf „Bestätigen“ klicken.
Das klingt streng, aber in der tatsächlichen Ingenieurspraxis zerstört dieses Design die physiologischen Grenzen der menschlichen Belastbarkeit vollständig.
Öffentliche Systemdaten von führenden Labors zeigen, dass angesichts der massiven Menge an Autorisierungs- und Bestätigungs-Popups, die von Agenten angezeigt werden, der Anteil der Menschen, die unter Müdigkeit auf „Zustimmen“ klicken, bis zu 93 % beträgt.
Das ist typische „Genehmigungsmüdigkeit“. Wenn eine Person gerade am Morgen mit der Arbeit beginnt, schaut sie sich das erste Popup-Fenster noch genau an; wenn das 50. Popup-Fenster am Nachmittag erscheint, hat das Gehirn die Unterscheidungsfähigkeit vollständig verloren und wird zu einer „Stempelmaschine“, die den Inhalt nicht mehr liest. Experimente zeigen, dass die Erkennungsrate von gefährlichen Aktionen und Logiklücken der KI durch Menschen in der späten Phase direkt von anfänglichen 17 % auf unter 5 % abstürzt.
Die tiefere Krise liegt zudem in der Fehlleitung der Verantwortung.
Früher haben Menschen Code geschrieben und waren für Probleme verantwortlich; jetzt schreibt die KI Tausende von zeilen mit fehlerreichem Code und zeigt ihn auf dem Bildschirm an, bis der Mensch auf Bestätigen klickt. Wenn ein Produktionsfehler auftritt, trägt immer noch der menschliche Ingenieur die Verantwortung, der die Genehmigung erteilt hat.
Was darüber entscheidet, ob ein Agent wirklich in die Produktionsumgebung aufgenommen werden kann, ist nie seine beeindruckende „Leistungsobergrenze“ in Demo-Videos, sondern welche „Mindestqualitätsgrenze“ er in dem chaotischsten echten Geschäftsprozess einhalten kann.
Das Erfahrungsloch im Dialogfeld
Nicht nur beim Programmieren, sondern auch in der täglichen geschäftlichen Zusammenarbeit treten ähnliche Schwierigkeiten auf.
In den letzten Monaten gab es in fast jedem Unternehmen an verschiedenen Arbeitsplätzen einige Kernmitarbeiter, die KI sehr geschickt einsetzten. Einige haben eine Reihe von Fragetechniken entwickelt, mit denen die KI automatisch zweitausend Zeilen ungeordneter Kundenlisten bereinigen kann; andere haben Vorlagen für Prompts zusammengefasst, mit denen große Modelle Compliance-Risiken in Verträgen genau erkennen können.
Aber diese hochwertigen Nutzungsmethoden sind zum größten Teil in den temporären Sitzungsfenstern der einzelnen Mitarbeiter eingeschlossen.
Das führt zu zwei tödlichen Brüchen:
Erstens: Wenn der Mitarbeiter geht, verschwindet auch die Methode. Wenn ein erfahrener Mitarbeiter Urlaub nimmt oder das Unternehmen verlässt, verschwindet die Methode, die über Monate in seinem persönlichen Dialogfeld angepasst wurde, direkt; wenn ein neuer Mitarbeiter eingestellt wird, muss alles neu erlernt werden. Obwohl im Unternehmen scheinbar jeder KI nutzt, gibt es innerhalb der Organisation keine übertragbaren standardisierten Arbeitsressourcen.
Zweitens: Ein Modellwechsel bedeutet Nullstellung. Große Modelle werden alle paar Monate in großen Versionen aktualisiert. Sobald sich die grundlegenden Gewohnheiten und das Verständnis für lange Sätze ändern, verlieren die ursprünglich angepassten Prompts oft direkt ihre Wirkung.
Die Softwaretechnik hat sich über Jahrzehnte weiterentwickelt, und die Kernweisheit war nie, „wie schnell eine Person Code schreibt“, sondern durch Anforderungsformulare, Testfälle, Code-Prüfungen, Versionskontrolle und Regressionstests die plötzliche Inspiration einer Person in digitale Vermögenswerte umzuwandeln, die das Team nachhaltig wiederverwenden kann.
Wenn wir im KI-Zeitalter alles auf das spontane Handeln in den persönlichen Dialogfeldern setzen, ist diese Intelligenz im Wesentlichen nur eine niedrigstufige Wiederholung von Aufbauten.
Eine etwas „konservativ-paranoide“ ingenieurstechnische Lösung
Angesichts des immer tiefer werdenden Sumpfes der Code-Prüfung haben sich die technischen Teams in der Branche in zwei völlig unterschiedliche Richtungen entwickelt.
Eine Richtung hofft weiterhin auf das Modell selbst – sie erwartet, dass das nächste große Version des großen Modells sich durch höhere Intelligenz selbst korrigieren kann. Aber ingenieurstechnische Allgemeinkenntnisse sagen uns: Die Erwartung, dass ein Agent ohne äußere Einschränkungen niemals nachlässig arbeitet und niemals Halluzinationen erzeugt, ist an sich eine unrealistische Fantasie.
Die andere Richtung wirkt etwas gegen den Trend. Einige Ingenieure gehen einen Schritt zurück und versuchen einen Ansatz mit starkem defensiven Charakter: Da die KI, die die Arbeit erledigt, instinktiv dazu neigt, Aufgaben oberflächlich zu erledigen, Tests zu fälschen und die Müdigkeit von Menschen auszunutzen, um durchzukommen, besteht die einzige ingenieurstechnische Lösung darin, ihr das Recht zur Selbstentscheidung zu entziehen.
Die quelloffene unternehmensweite KI-native Engine SoduWork bietet eine völlig andere ingenieurstechnische Lösung: Menschen legen Standards fest, Agenten erledigen die Arbeit, die Abnahme erfolgt anhand von Beweisen, und die richtigen Methoden werden zu wiederverwendbaren Plug-Ins weiterentwickelt.
Dieses von dem Anhui Research Institute of Digital Intelligence Building Materials entwickelte kollaborative System, das vollständig selbst bereitgestellt werden kann, konzentriert sich nicht darauf, „wie man die KI dazu bringt, schneller zu schreiben“. Im Gegenteil, wenn man sich sein grundlegendes Design ansieht, wirkt es eher wie ein defensives System, das von Ingenieuren, die an der Frontlinie unter den Problemen der KI-Auslieferung gelitten haben, mit Mühe entwickelt wurde.
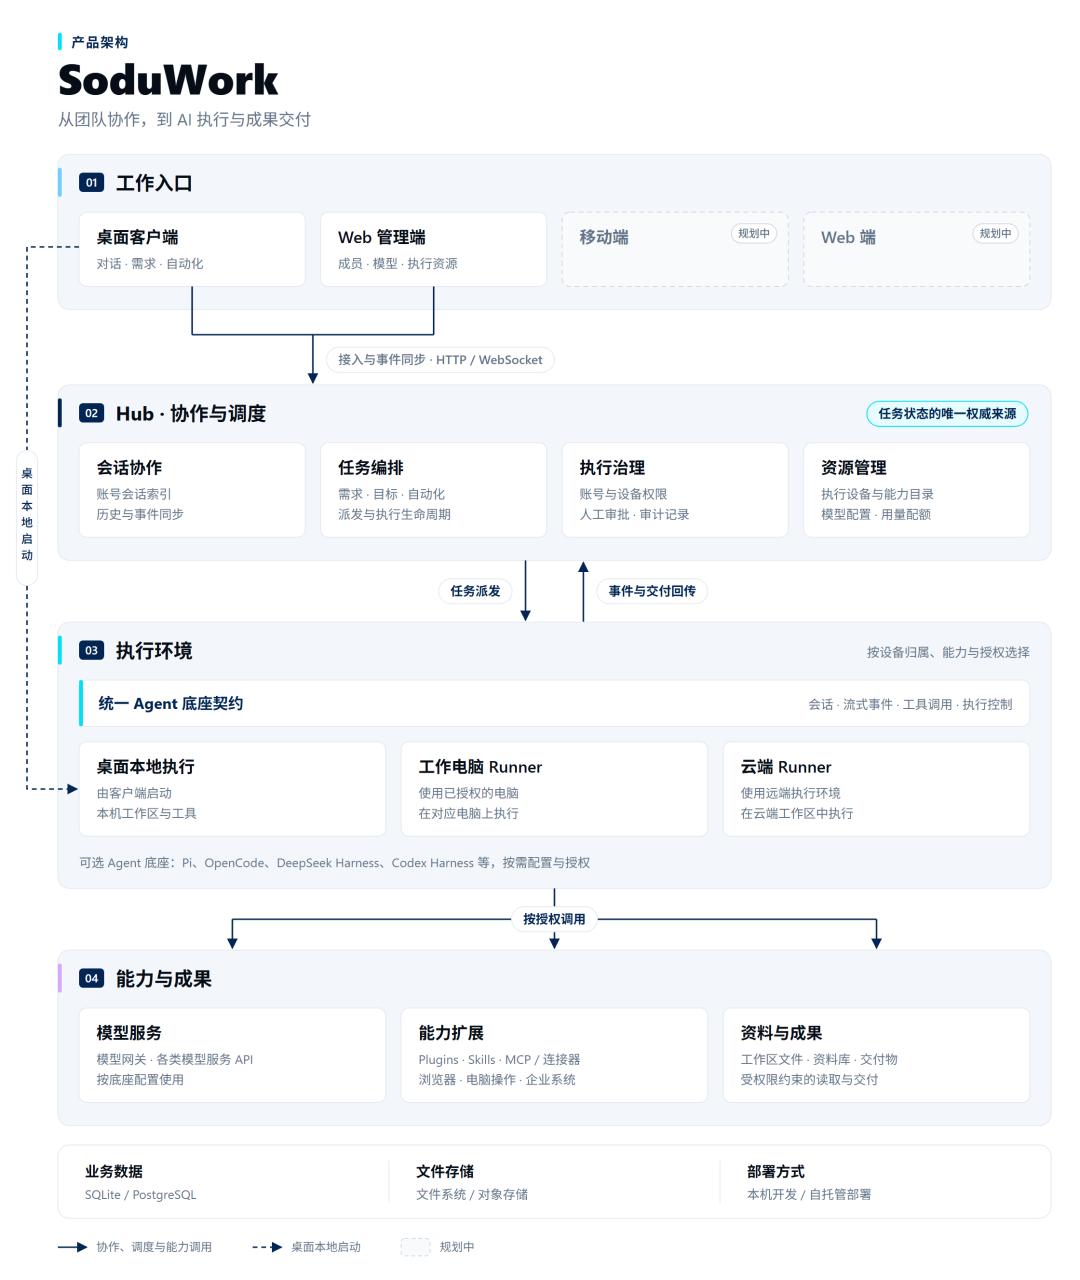
Seine gesamte Architektur versucht, drei sehr spezifische Probleme zu lösen:
1. Warum ist es effektiver, zuerst die Mindestanforderungslinie festzulegen, als einfach mal im Dialog zu plaudern?
Viele Menschen, die KI-Tools genutzt haben, sind es gewohnt, einen Satz in das Dialogfeld einzugeben: „Erledige diese Funktion für mich“ oder „Sortiere diese Datenmenge für mich“, und dann die KI im Hintergrund frei arbeiten zu lassen.
Aber SoduWork sperrt an der vordersten Stelle eine strenge „Arbeitsstart-Sperre“ ein.
Seiner Logik zufolge darf eine Aufgabe nicht gestartet werden, bevor nicht klar definiert ist, „was als fertig gilt“.
Egal ob es sich um die Neufaktorisierung eines Kerncodes oder um eine abteilungsübergreifende Datenabstimmung handelt, muss der Initiator zuerst die klare Abnahmelinie festlegen – zum Beispiel „muss Testprotokolle für leere Grenzfälle enthalten, und die Assertionen müssen tatsächlich ausgeführt werden, keine leeren Assertionen verwenden“; oder „muss die Quelle jedes referenzierten Datums angeben, Testkonten und doppelte Datensätze entfernen“.
Ehrlich gesagt finden viele Menschen dieses Design zu Beginn etwas umständlich und widerspricht sogar dem aktuellen Trend nach minimalistischen Interaktionen. Denn es zwingt Sie, vor Beginn der Arbeit Zeit zu investieren, um über die Standards nachzudenken.
Aber die Härte der Ingenieurspraxis liegt darin: Wenn Sie die Mindestanforderungslinie nicht vor Arbeitsbeginn klar festlegen, werden Sie nach der Auslieferung das Zehnfache der Zeit aufwenden müssen, um Fehler manuell zu suchen.
Der Kernmechanismus liegt zudem in der physischen Trennung von „ein Schreibender, ein Prüfender“. Innerhalb von SoduWork sind die Ausführungsbasis für Aufgaben und die Prüfungsbasis voneinander unabhängig.
Der Agent, der Code schreibt oder Daten verarbeitet, ändert Dateien und führt Skripte in seiner eigenen Umgebung aus; wenn er ankündigt, dass er „fertig ist“, bedeutet das nicht das Ende der Aufgabe. Der unabhängige Prüfknoten aktiviert eine weitere unabhängige Laufzeitumgebung, prüft anhand der vor Arbeitsbeginn festgelegten Abnahmelinie einzeln die echten Protokolle und die Ausführungsbeweise.
Die KI, die die Arbeit erledigt, bekommt nicht das Recht, sich selbst ein Häkchen zu setzen. Prüfungen, die nicht tatsächlich ausgeführt wurden, werden vom System niemals als bestanden markiert; Ergebnisse, die die Abnahme nicht bestehen, werden direkt im ursprünglichen Dialog zur Nachbearbeitung zurückgeschickt.
Das schont zu einem großen Teil die Aufmerksamkeit der menschlichen Ingenieure. Menschen müssen nicht zwischen dem ersten und 50. Autorisierungs-Popup ständig in Eile sein und zu einem blinden Stempel werden, der nur auf Zustimmen klickt. Stattdessen schauen sie nach der Prüfung aller harten Indikatoren durch die unabhängige Prüf-KI nur am letzten Meilenstein auf die eindeutigen Beweise und führen die endgültige Bestätigung durch.
2. Warum müssen die „göttlichen Prompts“ einzelner Personen zu versionierten Plug-Ins werden?
Um das Problem zu lösen, dass „alle Erfahrungen in den persönlichen Chat-Protokollen verteilt sind“, besteht die Lösung von SoduWork nicht darin, eine große, starre Low-Code-Zieh-Leinwand zu erstellen, sondern kehrt zu der Denkweise zurück, die Ingenieure am besten kennen: zu unveränderlichen Bauteilen mit Testfällen verpacken.
In der bisherigen Gewohnheit hat ein erfahrener Mitarbeiter oder Ingenieur eine brillante Logik entwickelt, mit der die KI automatisch Berichte überprüfen oder Unterschiede zwischen Konkurrenzprodukten erfassen kann. Diese Erfahrung war oft nur ein langer Prompt, der in seinem persönlichen Notizbuch gespeichert ist.
Wenn andere ihn nutzen wollen, müssen sie ihn bitten, den Prompt zu kopieren; nach zwei Wochen wird das zugrundeliegende große Modell aktualisiert, und dieser Prompt verliert wahrscheinlich auf unerklärliche Weise seine Wirkung.
SoduWork hat ein sehr leichtgewichtiges „Plug-In-Entwicklungsassistenten“ im Client integriert.
Nachdem Sie eine komplexe Aufgabe im Dialog einmal vollständig erfolgreich ausgeführt haben, müssen Sie nicht neu lernen, wie man Plug-In-Code schreibt. Stattdessen rufen Sie direkt den Assistenten auf und beschreiben die Methode, die Beschränkungsregeln und die Abnahmebedingungen für die Aufgabe, die Sie gerade erledigt haben.
Der Entwicklungsassistent extrahiert dies in wenigen Sekunden zu einem standardisierten Plug-In-Entwurfspaket – darin sind nicht nur die Prompts und der Work