李泽湘系团队做了款贴在手机背后的墨水屏Agent,获祥峰、五源、源码等投资|硬氪首发
作者|黄楠
编辑|袁斯来
硬氪获悉,「Flowtica AI」日前已完成新一轮数千万元融资,投资方为祥峰资本、源码资本、五源资本、清水湾基金。山与资本担任独家财务顾问。
过去两年,AI硬件赛道经历了一轮密集的产品迭代。录音卡、翻译耳机、AI眼镜等,几乎每一个能够被大模型增强的物理形态,都有团队在尝试。
而一个尴尬的事实是:AI的能力边界在快速扩张,但普通用户调动它的效率并没有同步提升。用户依然需要主动打开App、输入指令、复制粘贴结果。AI在云端飞速进化,但落到真实工作流里,仍然隔着一段很长的操作路径。
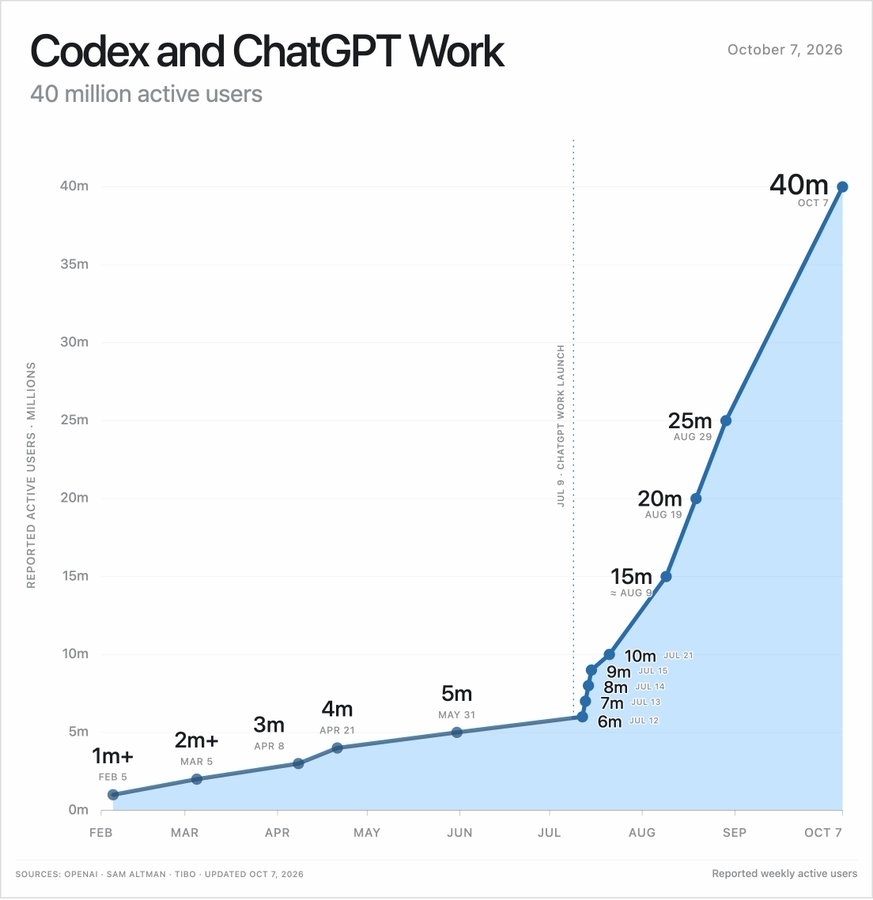
Codex+ChatGPT Work周活跃用户增长曲线(图源/Open AI公开数据整理)
Flowtica最早切入的,正是这段路径里最具体的一环——快速录音。2025年,Flowtica发布了首款AI录音笔产品Scribe,海外众筹超百万元,于2026年初完成发货并常态化销售。
官方数据显示,自Scribe发货以来,有42%的硬件激活用户转化为Flowtica的订阅付费用户。这款产品验证了一件事:用户愿意为会话信息的捕获与整理付费,尤其当AI不止能完成转写,还可以进一步输出结构化纪要、拆解可执行待办。
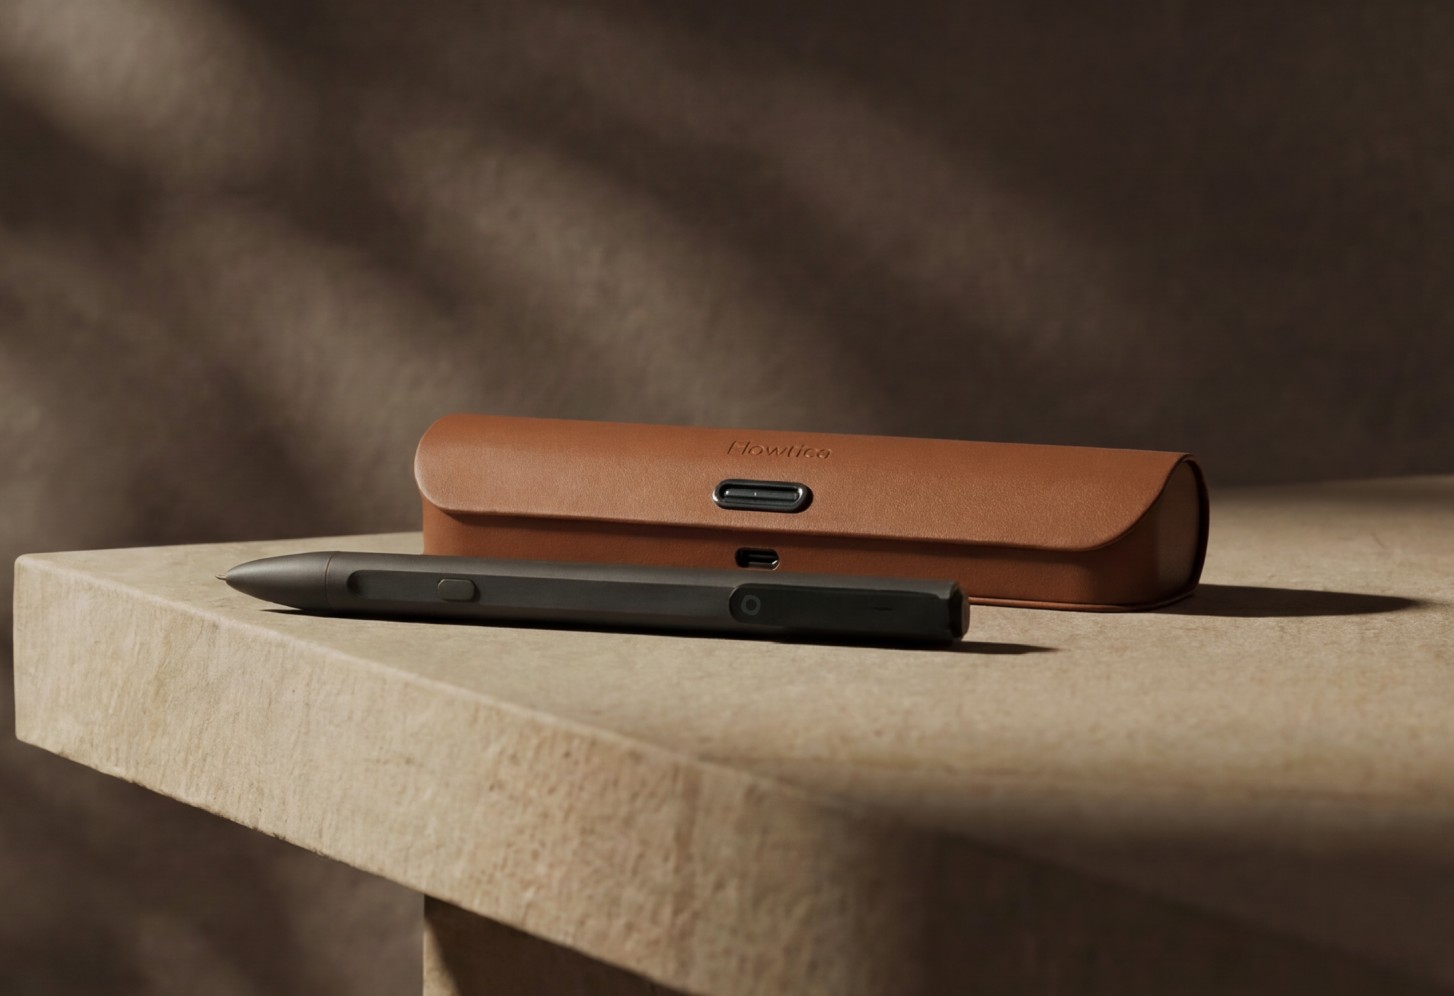
Flowtica首款产品,AI录音笔Scribe(图源/企业)
但Scribe也让团队看到了一个上限,“录音结束,产品的任务就到此为止——这是市场上绝大多数同类产品的终点。但我们发现,对用户来说,记录只是整个工作流程的开端。”Rian告诉硬氪。
一条会议录音变成了一份纪要,而接下来的待办拆解、日程同步、跟进邮件的草拟等繁复动作,用户仍然需要手动完成。
“模型能力越变越强,但用户与之交互的方式还停留在上一个时代。”在Rian看来,AI硬件的机会,不在于把一堆新功能封装进硬件外壳,而是能主动出现在用户的工作流里。“用户需要的不是一个需要反复唤醒的工具,而是一个能够记录、梳理,并推动事项落地的AI。”
这正是Flowtica团队捕捉到的市场空白:让AI从需要被反复交代的工具,变成能够稳稳地接住用户需求的智能助手。
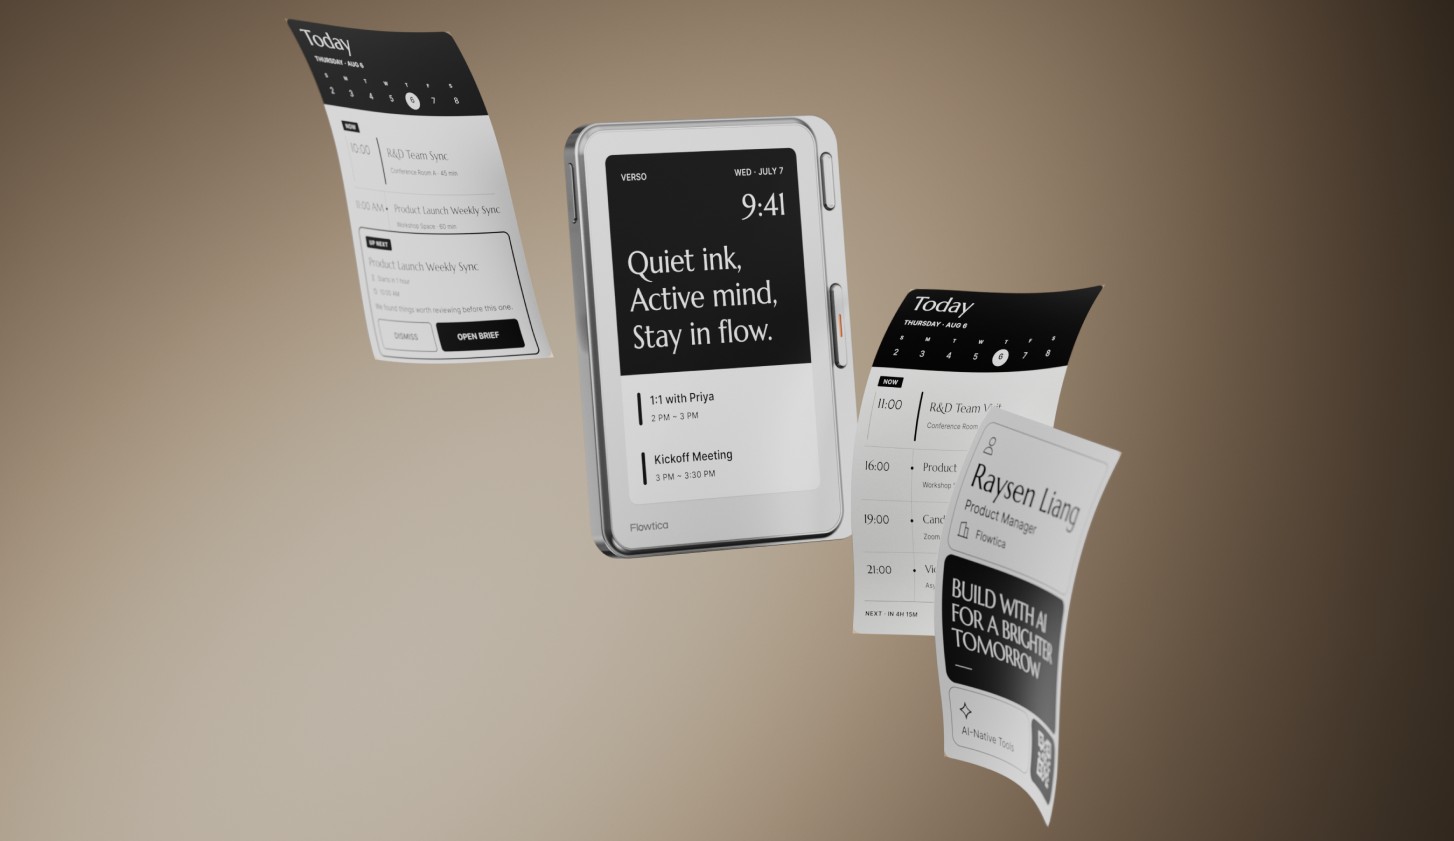
Verso产品图(图源/企业)
Flowtica创始人Rian毕业于香港科技大学,师从李泽湘教授,拥有计算机视觉与3D方向学术背景。他拥有十余年的硬件创业经历,曾从主导全球首款智能手机手持云台Vimble的研发与量产、农业AI分拣机器人,团队在机器视觉与边缘AI领域积累了完整的工程方法论。
2024年,随着大模型能力开始向终端设备外溢,Rian判断,AI硬件将迎来一轮结构性机会,他成立Flowtica,尝试通过硬件载体实现AI应用深度落地,做下一代AI原生个人硬件与Agent系统。团队带着Scribe积累的供应链能力和对用户场景的理解,开始定义第二款硬件产品Verso。
Verso是一款厚度6.5mm、仅重78g的磁吸式墨水屏Agent硬件。其正面搭载一块常显电子墨水屏,机身配备独立实体交互按键与Type-C充电接口,内置4麦克风阵列与骨传导传感器。
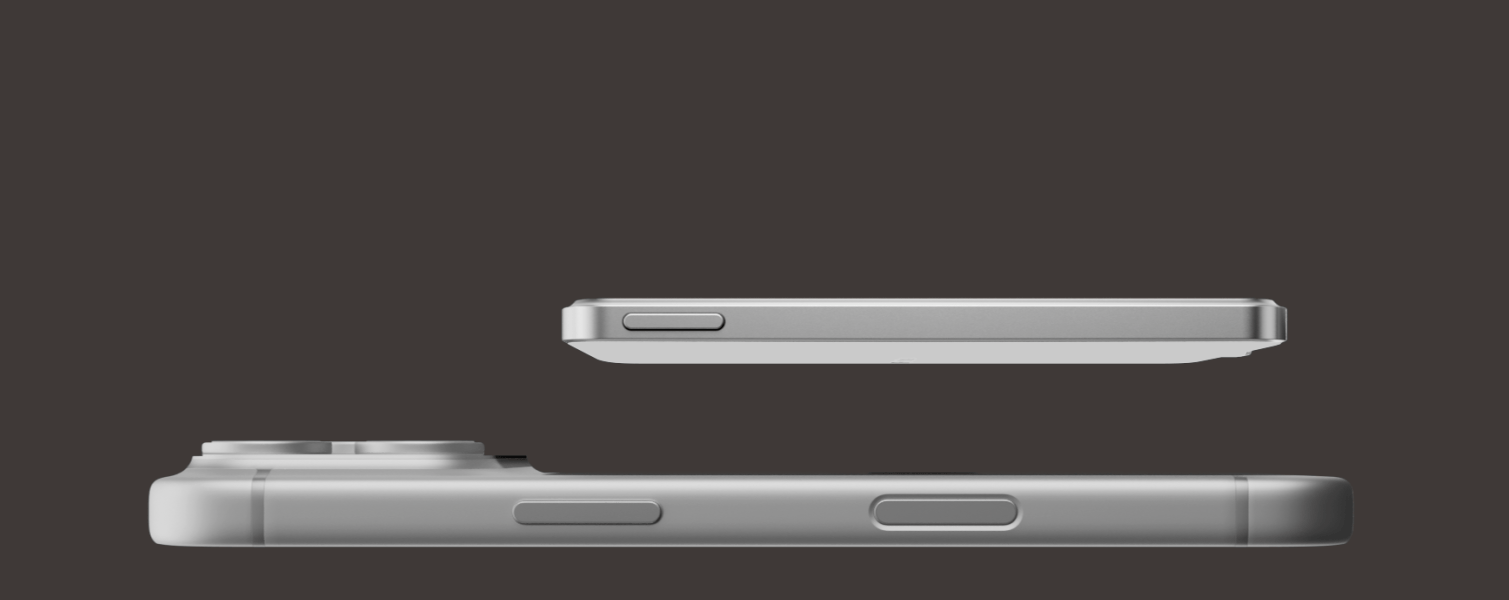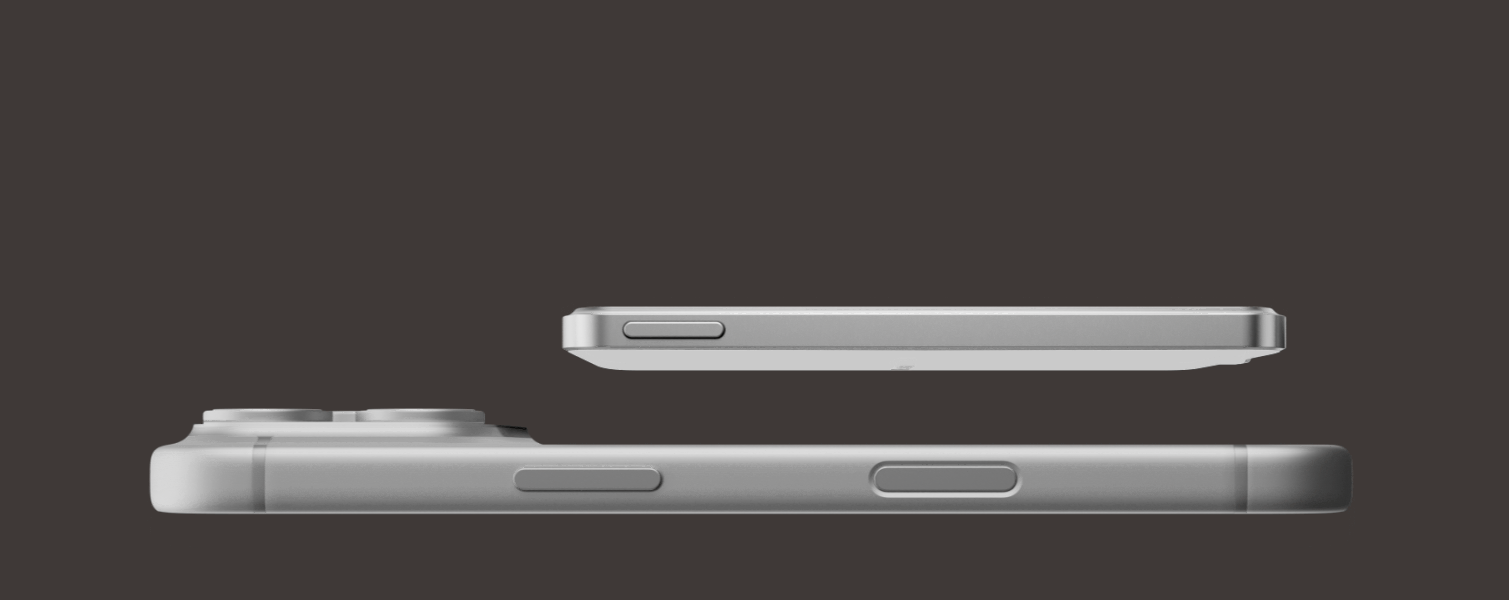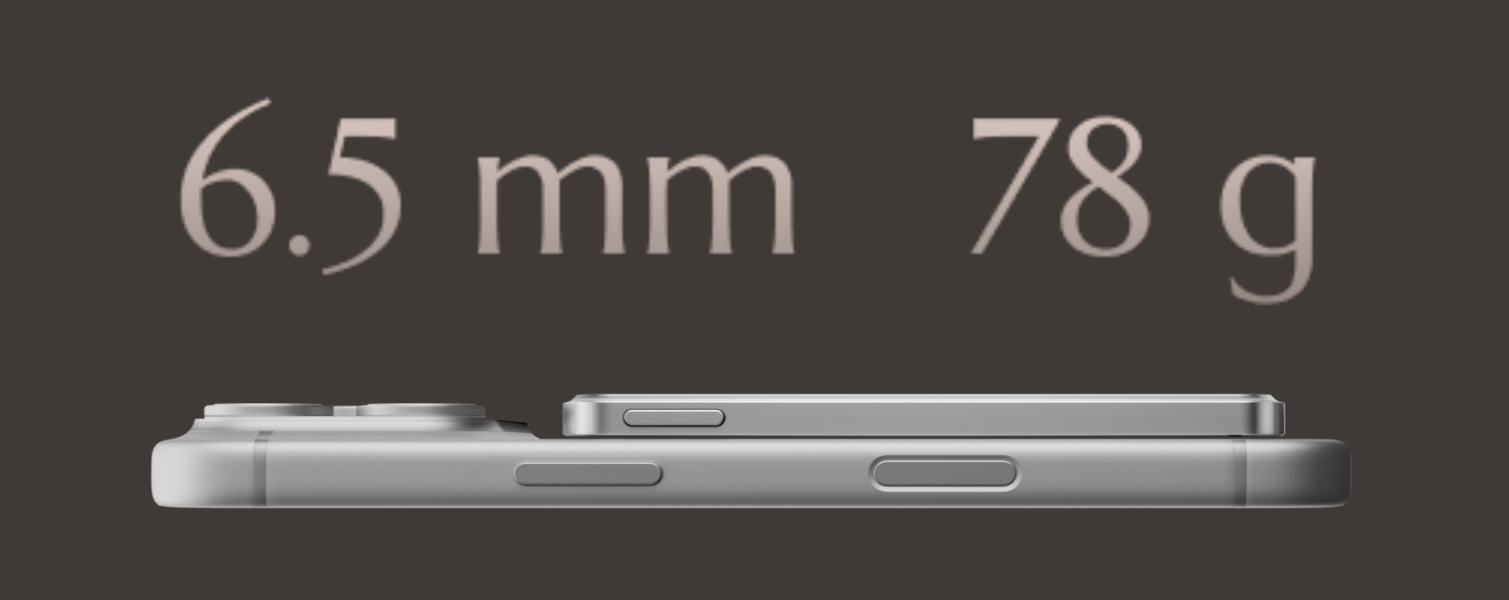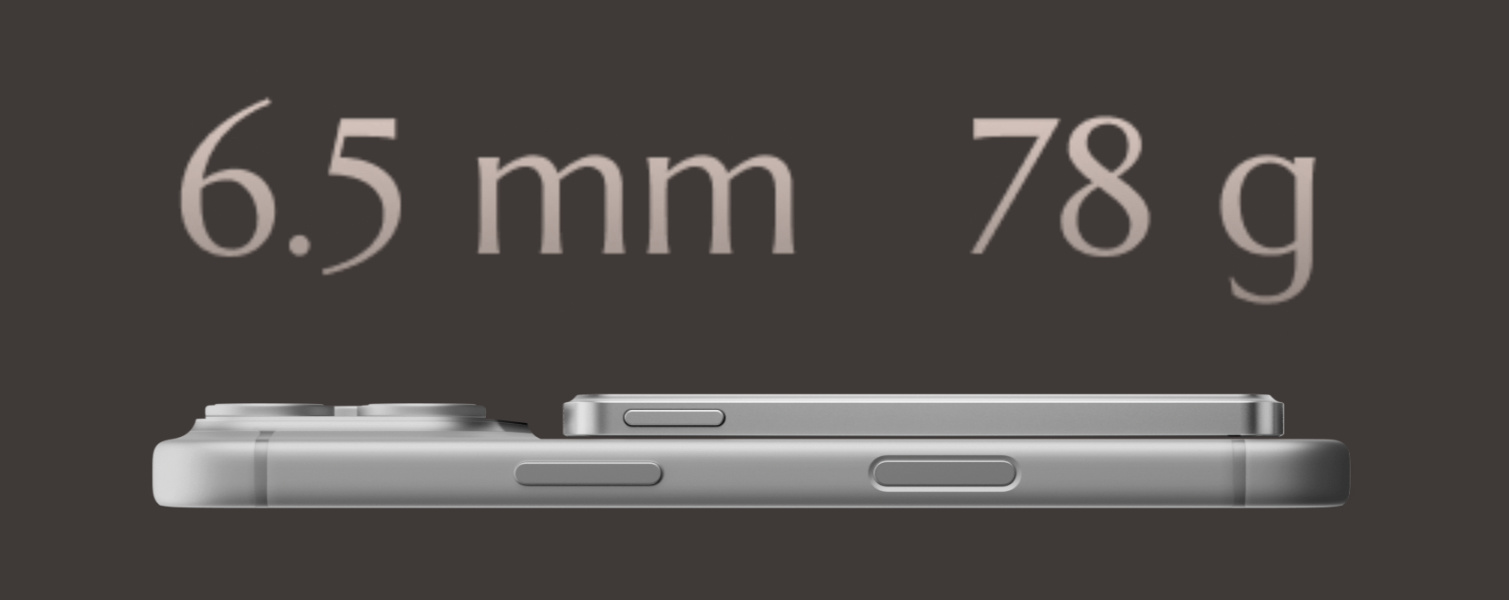
Verso重量参数(图源/企业)
过去十年,消费电子行业默认了一个方向:功能越多、屏幕越炫、参数越强,产品就越有竞争力。但这套逻辑在AI硬件上并不成立。用户面对一块功能密集的屏幕,注意力被不断切割;每一次解锁手机查看通知,都可能陷入分心的信息海洋。
Flowtica 团队在定义产品之初,并没有将追求极致轻薄作为首要目标,而是基于用户真实使用体验权衡取舍。比如多保留0.5mm的机身厚度,换取通用Type‑C接口与额外20小时续航。这类选择在参数表上貌似不讨巧,却直接决定用户长期使用的舒适度。
同样的思路也延伸到了产品功能层面。市面上已经不缺能处理会议的AI工具,录音、转写、摘要,这些能力正在变成标配。但团队认为,真正缺位的不是“如何让会议更智能”,而是如何服务那些会议密度极高的人,帮用户管理注意力和精力,而不是往其信息流中塞更多无效内容。
Verso被设计为一块“主动降噪”的副屏,常显墨水屏让用户“一眼即得”,无需点亮手机,就能掌握当下的日程、核心待办与AI提炼的关键信息。
“我们不是在做一块更吸睛的屏幕,我们是在做一块更安静的屏幕。这种交互方式可以更好地保护用户专注力,让其保持在心流状态中。”Rian告诉硬氪,“AI硬件的价值不在于让用户做更多事,而在于帮用户少做无关的事。”
为了适应高频、碎片化场景,Verso也在ID设计上做了一次反常规的取舍。产品结构采用非对称屏幕布局与侧边实体按键。当用户在通话时,即使单手握住手机的同时,食指也能自然地落在侧边台阶处的录音键,盲操录音。当正面转过来开始阅读时,拇指也能舒适地落在“Ask AI”键上,随时提问与记录。
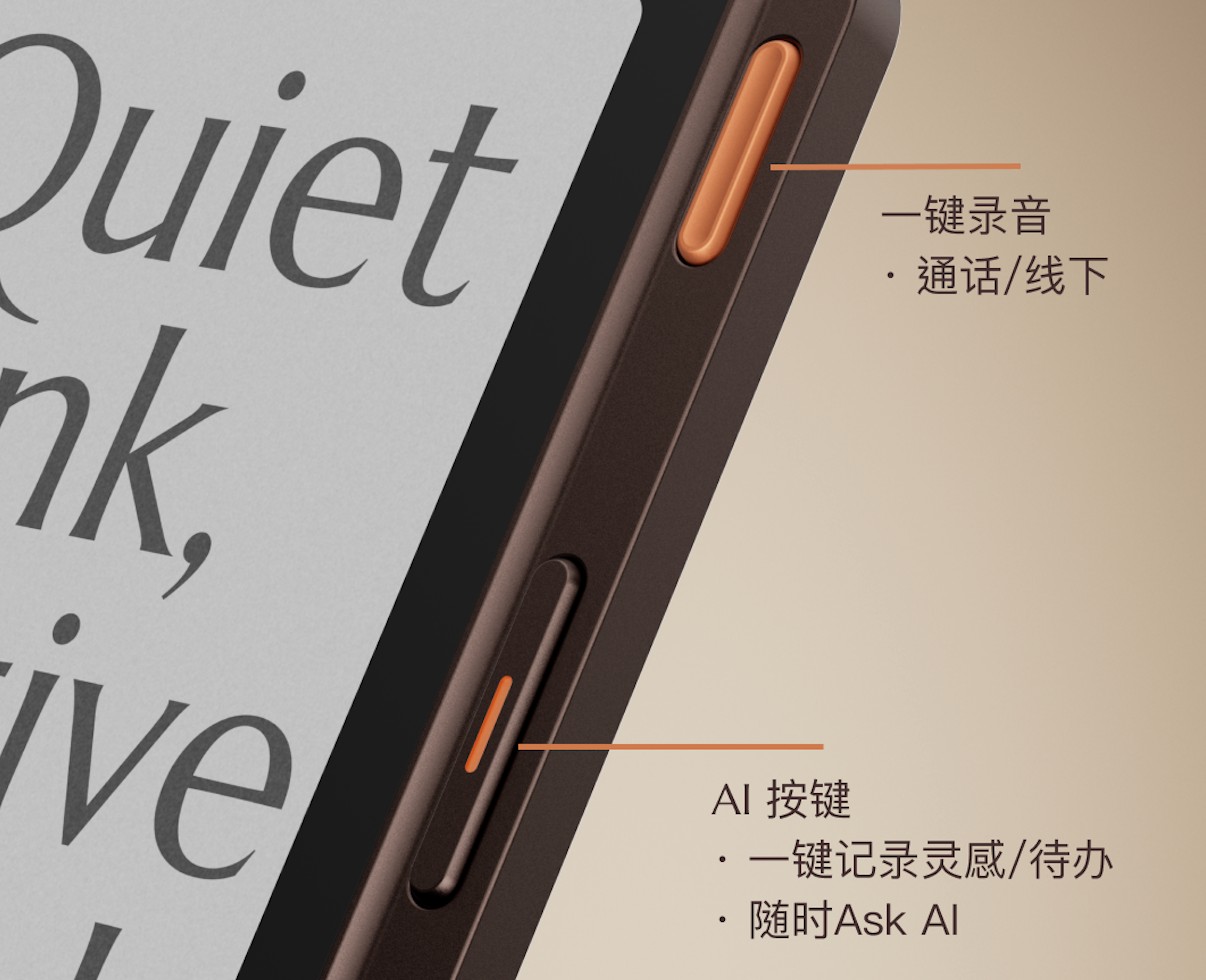
Verso按键设计(图源/企业)
但硬件只是入口。Flowtica Verso更精准的定位,是一个以硬件为载体的个人上下文操作系统(Personal Context OS),围绕Memory、Attention、Workflow Closure三个层面构建完整闭环。
Memory层解决的是“记住什么”。云端共享大脑把会议、日程、待办、邮件、文档串成一条连续的个人长期记忆,而非停留在一次性转写。信息不再随会议结束而散落,而是沉淀为可随时调取、可跨场景复用的上下文资产。
Attention层解决的是“不被打断”。常显墨水屏、磁吸形态与实体盲操的组合,本质是一套注意力降噪系统——用户无需解锁手机、无需跳入信息流,只需一瞥或一按,就能拿到当下最需要的信息,让注意力保持在心流里,而不是被通知切碎。
Workflow层解决的是“事情真正做完”。从会前Brief、会中标记,到会后Action Items与跟进草稿,系统把“记录”推进到“执行”,形成工作流的完整闭环。会议结束不是终点,而是下一步行动的起点。
三层叠加,Verso才真正成为“Agent硬件”,它不只是拾音与转写的工具,而是一个拥有个人上下文感知能力、可主动执行闭环任务的随身Agent实体入口。
而不同硬件形态,解决的是现实世界里不一样的信息捕获场景,其背后是基于Flowtica自主研发的Cloud-First云端大脑。
Flowtica选择把笔、屏和多端软件放进同一套协同框架里,在工作流上实现多端打通,短期看,既构成了“一脑多终端”的办公产品矩阵;长期看,则是在争夺用户办公信息的入口,进而统一沉淀成可复用的个人资产。
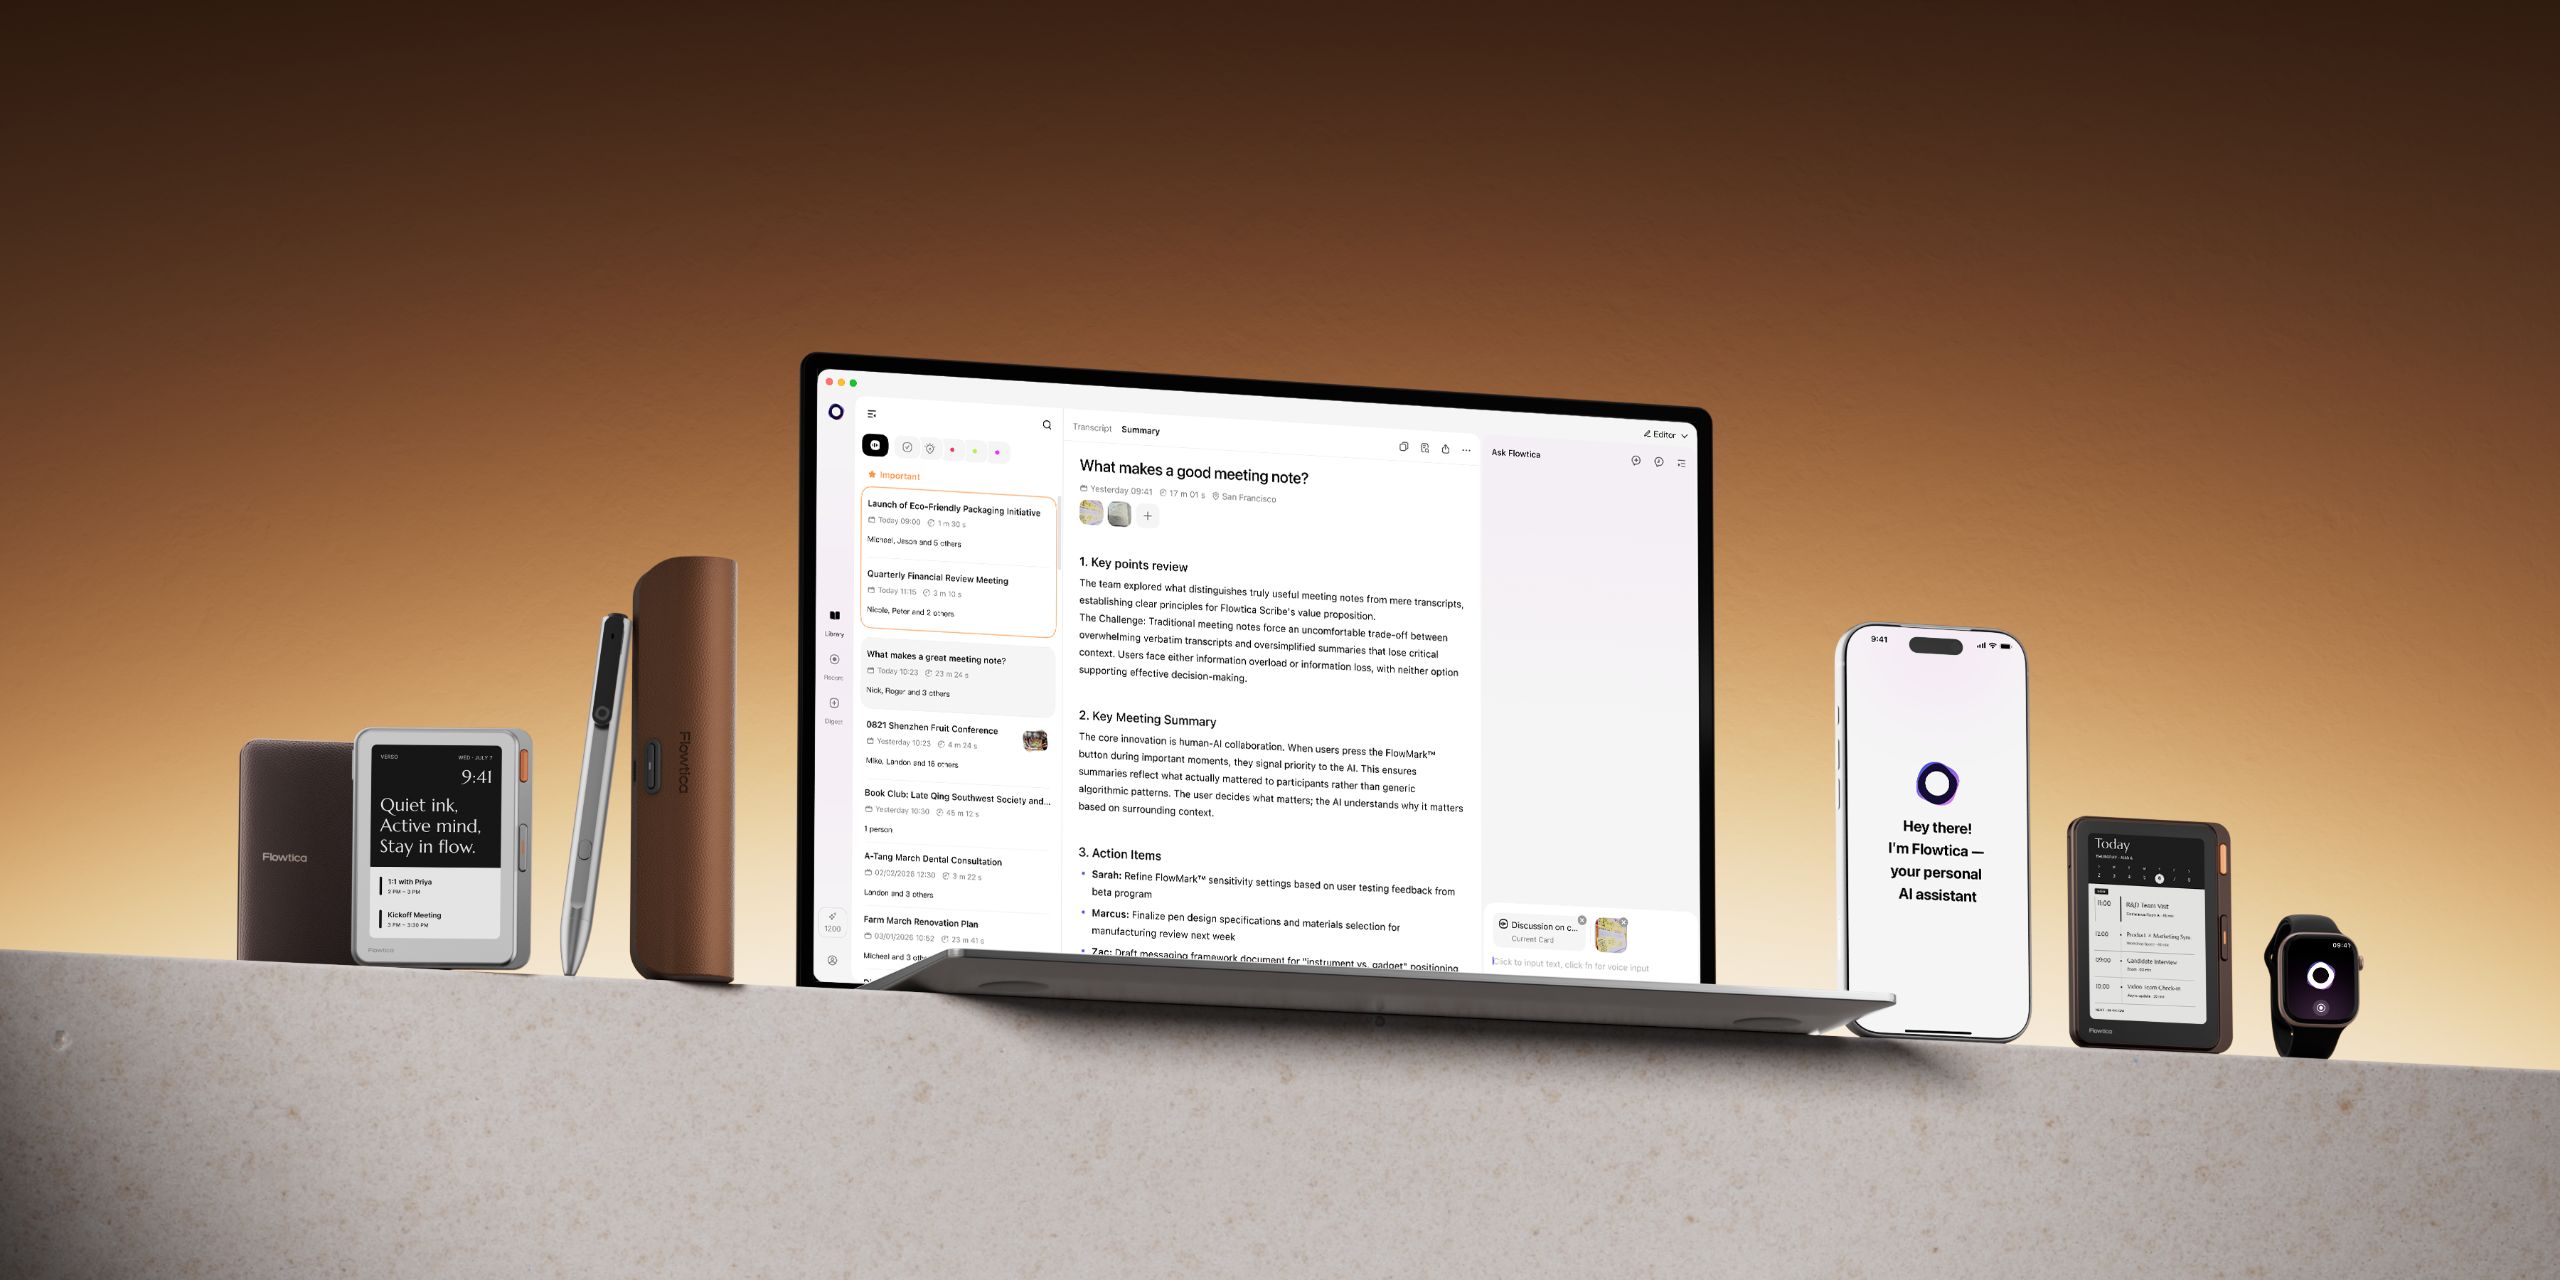
Flowtica产品矩阵(图源/企业)
Rian告诉硬氪,“录音转写、摘要生成这些能力,正在变成基础设施。单点功能的竞争会迅速同质化,真正拉开差距的,在于谁能把分散的信息串成一条连续的线,并且让这条线随着使用时间的增加越来越有价值。”
这句话背后,是Flowtica对产品边界的重新划定。单款硬件只能覆盖工作流中的一个片段,而公司目标远不局限于做出一款好用的录音设备,而是搭建一套覆盖“记录—整理—执行”全链路的办公生态。
Rian进一步指出了一个被行业普遍忽视的体验摩擦,“当下AI能力本身已经不再稀缺,工具看似在提效,但用户每次打开一个AI工具,都要告诉它你是谁、你在做什么、你关心什么。行业不缺智能能力,缺的是上下文的连续性。我们做硬件,就是想让AI能更直达地进入用户的上下文,不需要反复解释。从Scribe录音笔到Verso卡片,再到Apple Watch和Mac,我们在构建的是一个多端生态——在任何场景下,都有一个离你最近的入口,让AI无缝地接住你的上下文。”
据Flowtica透露,Verso自9月在德国IFA正式宣发后,反响热烈,本周已开启定金预收,首批量产产品将于12月正式出货,核心用户瞄准在企业管理者、高强度知识工作者,以及有专注需求(如ADHD)的人群。
以下为硬氪与Flowtica创始人Rian的访谈节选(略经编辑):
硬氪:语音交互已经成为AI硬件的标配,为什么Flowtica还要在硬件上保留一块墨水屏?视觉在这个产品形态里解决了什么问题?
Rian: 语音是最高效的输入方式,但它不是高效的输出方式。
我们在产品定义阶段做过一个很具体的推演,如果Agent用语音给你回一段50字的内容,可能需要30秒才能听完。同样一段信息呈现在屏幕上,你扫一眼就完成了。语音的线性特征决定了它无法被快速浏览、无法被跳读、无法被结构化呈现。用户需要的是“知道什么重要”,而不是“听完所有内容”。
所以我们的判断是,语音负责输入和指令,视觉负责呈现和决策。Agent给出会议纪要、待办拆解、日程准备时,最适合的载体不是语音播报,而是一块能快速扫读的屏幕。
选择墨水屏而不是常规彩色屏,同样基于这个逻辑。手机屏幕的信息过载本身就是问题的一部分——用户每解锁一次手机,就可能被通知、消息、社交应用带离当前任务。墨水屏常显、低刷新、不打扰,它的设计目标不是吸引注意力,而是减少注意力消耗。用户瞥一眼就能掌握日程和关键待办,不需要进入手机的信息流。
这背后是一个更底层的产品判断:Agent硬件的价值不是替代手机,而是在手机之外提供一个更低干扰、更高直达性的信息入口。语音解决“随手记录和下达指令”,视觉解决“快速理解和做出判断”,两者缺一不可。只做录音和语音交互,产品就退化成录音卡;加上视觉和主动呈现,它才具备Agent硬件应有的交互完整性。
硬氪:很多创业公司担心自身产品能力会随着大模型发展逐渐被吃掉。你们怎么判断哪些能力是可持续的,哪些只是过渡性的?
Rian: 我们内部有一个判断标准,如果一项能力的价值随模型变强而缩小,它就不适合作为长期壁垒。
过去很多创业公司做的是“补模型短板”的生意,比如上下文不够长就做压缩,输出不够结构化就做后处理接口,不会调用工具就做一层编排中间件。这些能力在特定阶段有价值,但本质是在填补模型能力与用户需求之间的临时断层。模型每升级一次,断层就收窄一次。
我认为可持续的能力有两类。第一类是与场景深度绑定的用户数据资产。模型是通用的,用户是个性化的。同一个会议,不同的人关注重点不同、表达习惯不同、决策链路不同。这些差异不会因为模型变强而消失,反而需要更强的模型才能被充分理解。我们的Memory系统记录的不只是会议内容,还有行为模式、关注偏好和任务推进习惯。模型越强,这些数据的价值越大。
第二类是产品层的交互定义与场景编排。模型提供通用能力,但“在什么时机、以什么方式介入用户的工作流”是产品层的问题。同样一个会议结束,Agent该主动弹出待办拆解,还是等用户开口问?这些判断不取决于模型能力,而取决于对用户场景的理解。
此外,合规与数据基础设施也是容易被低估的壁垒。我们从去年开始,就在推进各项数据合规,这类能力不是模型能解决的,需要时间、流程和持续投入,一旦建立就是长期的信任壁垒。
所以我们不做“补模型短板”的中间层,而是做“放大模型能力”的场景层。前者的价值随模型增强而衰减,后者的价值随模型增强而增长。