港科大团队:让Agent找回长对话中“失联的记忆”
在长期对话、个性化服务和多轮任务协作中,AI Agent 经常要回答一类看似简单、实际很难的问题:一段信息与另一段信息相隔很远,表面上几乎没有相同的词,却必须同时被找回来,答案才完整。
例如,用户问“我最早是在哪里遇见那位影响我职业选择的人?”系统需要同时找到“这位老师影响了我的职业选择”和“我是在某场活动上认识他的”两段对话。前者与“职业”高度相关,后者却未必带有任何相近词。如果只按相似度检索,AI Agent 很容易知道“是谁”,却答不出“在哪里”。
为此,来自香港科技大学(广州)、吉林大学与香港中文大学的研究团队提出了 HeLa-Mem(Hebbian Learning Associative Memory),尝试解决这种长期记忆中的关联缺口:让对话里的经历不只被单独保存,也能在一次次共同被唤起的过程中逐渐建立连接。相关论文已被 ACL 2026 Main 接收。
论文链接:https://aclanthology.org/2026.acl-long.625/GitHub 地址:https://github.com/ReinerBRO/HeLa-Mem
在 LoCoMo 上的实验表明,HeLa-Mem 在使用显著更少的上下文 token 的同时,在四个问题类别中均表现出了出色的性能。
这项工作的价值在于把 AI Agent 长期记忆的重点从“保留多少历史”推进到“历史之间如何形成关系”。当 AI Agent 需要陪伴用户、跟进复杂任务或跨会话协作时,真正重要的信息往往在多段经历逐渐形成的关联之中。
让记忆在使用中建立连接
当前不少 AI Agent 记忆系统会把历史对话切成片段、写入向量库,再按照语义相似度召回。这样的方式能够高效找回与问题措辞接近的内容,但长对话中的关键线索往往不是“看起来最像”的那一条。
人的记忆并不完全依赖词语相似。一次活动中认识的人,可能会在后来影响职业选择;某段旅行经历,也可能与一个长期偏好有关。这些内容在文字上相距很远,但在真实经历里彼此关联。HeLa-Mem 将这种关系作为长期记忆系统的一部分:每轮对话都是一个记忆节点,节点之间的边记录它们曾经共同被使用的程度。
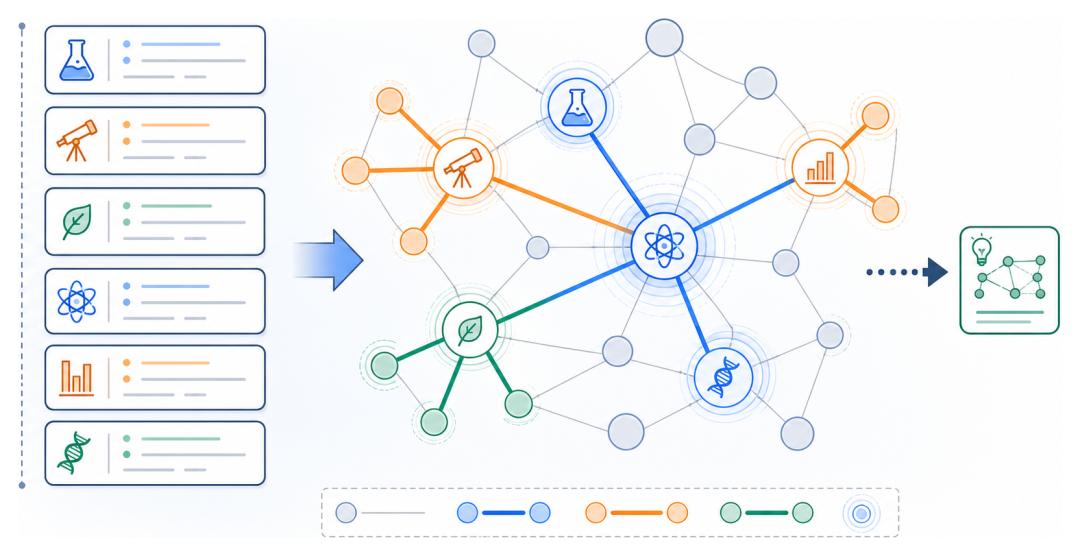
图|HeLa-Mem 将对话历史组织为带权关联图。反复共同被唤起的记忆会形成更强连接。
下图把 HeLa-Mem 的完整闭环放在一起:每轮对话先写入情景记忆网络;面对新问题,系统同时从语义相似和既有关系中寻找线索; 反思 Agent 再根据网络状态提炼知识、淘汰过期节点。两路检索结果与语义记忆共同构成 LLM 的回答上下文,新的使用过程会继续更新关联强度。
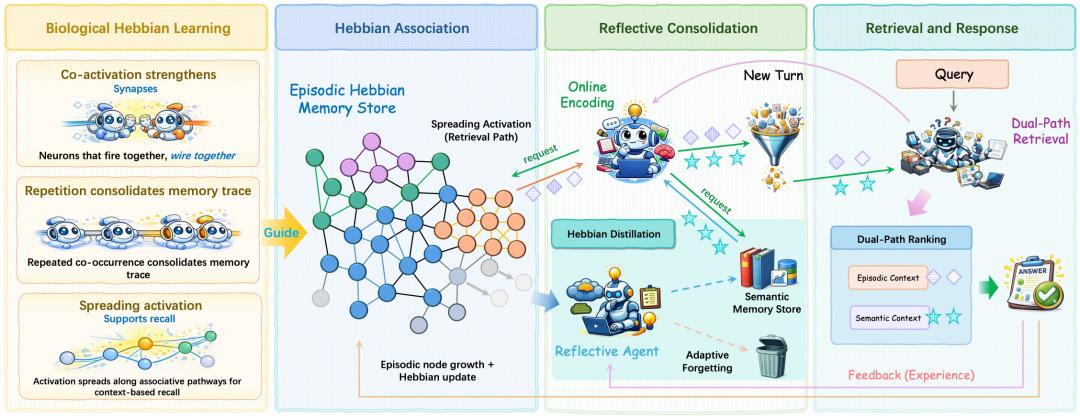
图|论文中的 HeLa-Mem 方法总览。赫布式关联构建情景记忆网络, 反思整合 负责记忆提炼与遗忘,检索阶段通过双路径取回上下文。
HeLa-Mem 的第一步,是将每个对话回合编码为情景记忆节点,保存原文、时间、角色、关键词和向量表示。当若干节点在一次检索中共同出现时,系统会加强它们之间的关联;长期没有被使用的弱连接会逐渐衰减。随着交互不断累积,记忆库会形成一张带有强弱关系的网络。
系统还会定期审视这张网络。对于关联密集的节点及其邻域,反思 Agent 会提炼其中可复用的信息,形成稳定的语义记忆,例如用户偏好、事件关系或带有绝对时间的事实。关联弱、长期未用且近期没有访问过的节点,则会成为遗忘候选,以控制记忆规模和噪声。
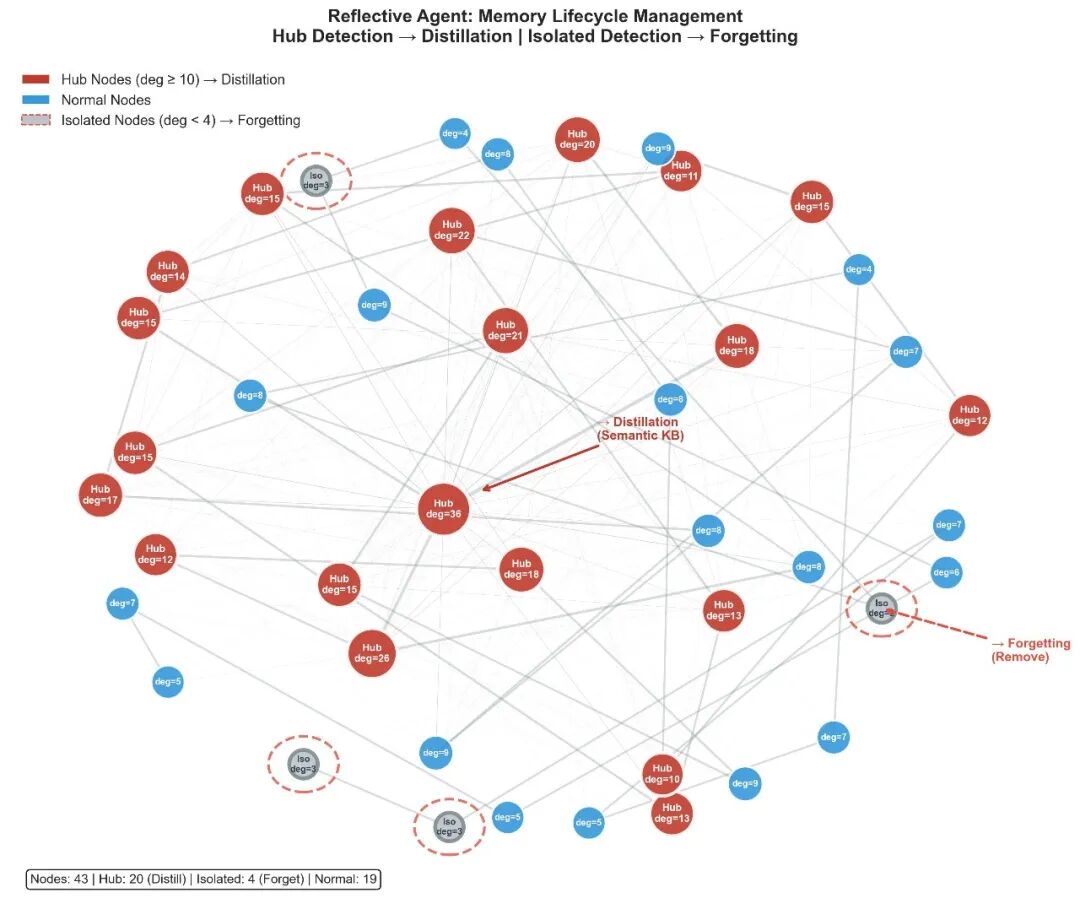
图|反思 Agent 围绕高关联度节点提炼语义知识,并识别孤立、陈旧且未访问的遗忘候选。
检索时,HeLa-Mem 走两条路径:一条路径根据向量相似度、关键词和时间因素直接召回候选记忆;另一条路径从高分节点出发,沿着关联边扩散激活,找到文字上不够相似、但与问题存在历史关联的内容。两路结果再与语义记忆合并,交给 LLM 生成答案。
在前面的“职业选择”案例中,语义检索可以先定位“职业建议”相关回合;关联路径则会沿着既有连接补回“初次见面地点”。这使系统能够完成跨片段、多跳的回忆。
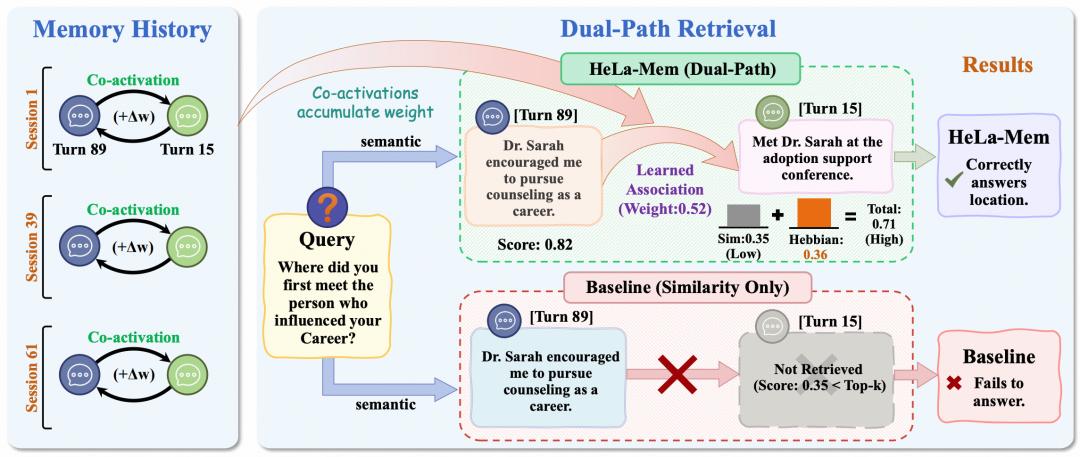
图|语义路径先定位职业相关记忆,关联路径再沿已学习的连接召回地点信息。
在长对话记忆基准上的表现
研究团队在 LoCoMo 基准上评估了 HeLa-Mem。该基准包含平均约 300 个回合、约 9K tokens 的长对话,问题覆盖多跳、时间、开放域和单跳等类别。
如下图,以 GPT-4o-mini 为底座时,HeLa-Mem 在 LoCoMo 的多跳推理、时间推理、开放域和单跳问答四类任务中,F1 分别达到 40.14、47.29、29.70 和 51.89。
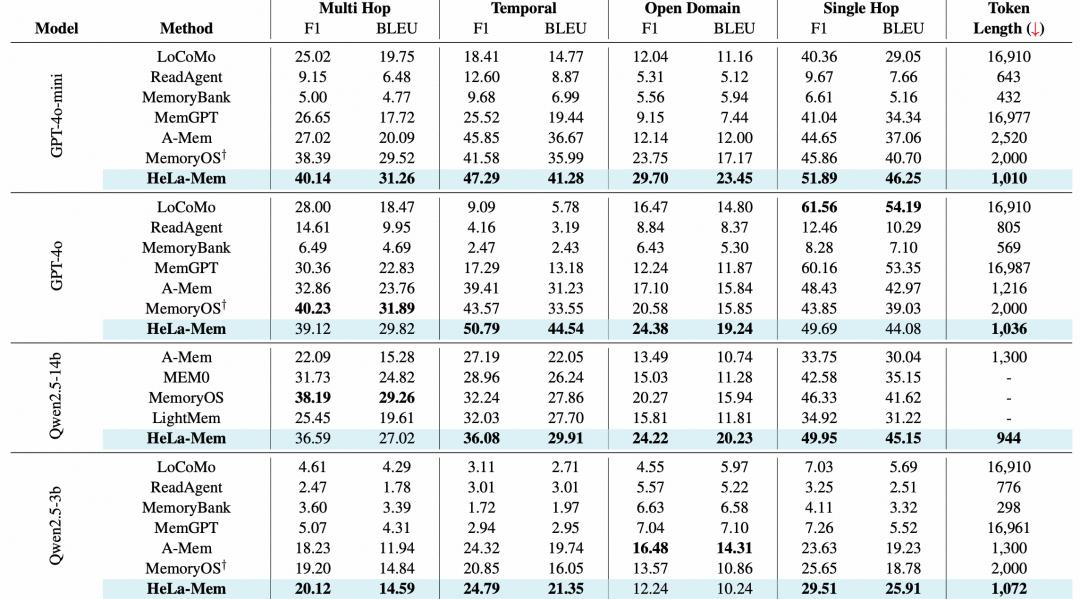
与此同时,HeLa-Mem 平均只需 1010 tokens 的检索上下文;MemoryOS 约为 2000 tokens,直接输入完整 LoCoMo 对话的基线约为 16910 tokens。跨 GPT-4o-mini、GPT-4o 与 Qwen2.5-3B 三个底座,HeLa-Mem 在四类任务中的平均排名为 1.25(数值越低越好)。
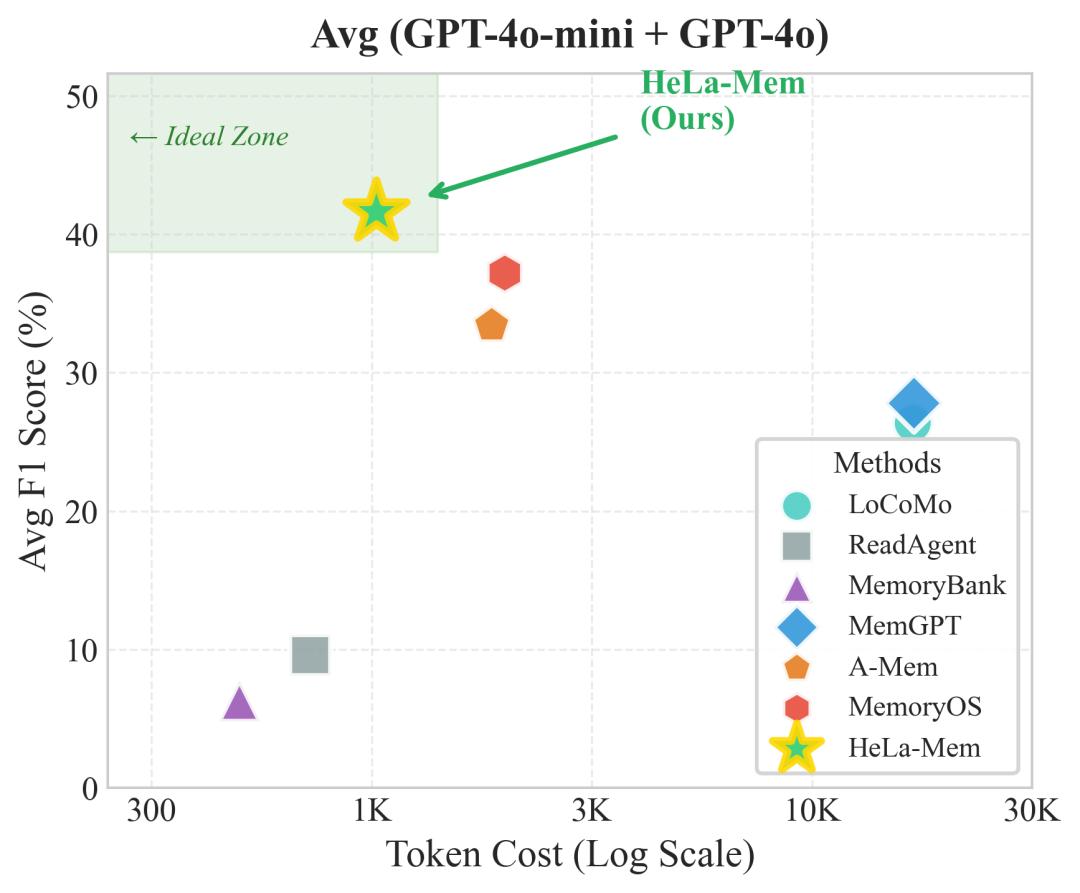
图|论文报告的性能—token 开销对比。横轴为 token 成本(对数坐标),纵轴为平均 F1;图中汇总 GPT-4o-mini 与 GPT-4o 的结果。
当然,这项研究仍存在一些局限。例如,HeLa-Mem 的关联权重需要在持续交互中逐步积累,因此在交互历史较少时仍会面临冷启动挑战。反思式巩固所提炼的语义知识,也会受到基础 LLM 能力的影响。
本文来自微信公众号 “学术头条”(ID:SciTouTiao),作者:学术头条,36氪经授权发布。