Das Team der Hong Kong University of Science and Technology: Lassen Sie den Agenten die „verlorenen Erinnerungen“ in langen Konversationen wiederfinden
In langwierigen Dialogen, personalisierten Diensten und kooperativen Aufgaben über mehrere Runden hinweg müssen AI-Agenten häufig eine Art von Frage beantworten, die scheinbar einfach, aber in Wirklichkeit sehr schwierig ist: Zwei Informationsstücke liegen weit auseinander, weisen oberflächlich kaum gemeinsame Wörter auf, müssen aber gleichzeitig abgerufen werden, um eine vollständige Antwort zu erhalten.
Zum Beispiel fragt der Nutzer „Wo habe ich die Person getroffen, die meine Berufswahl am frühesten beeinflusst hat?“ Das System muss gleichzeitig zwei Dialogabschnitte finden: „Dieser Lehrer hat meine Berufswahl beeinflusst“ und „Ich habe ihn bei einer bestimmten Veranstaltung kennengelernt“. Ersteres ist stark mit „Beruf“ verknüpft, während Letzteres möglicherweise keine ähnlichen Wörter enthält. Wenn nur nach Ähnlichkeit gesucht wird, weiß der AI-Agent leicht, „wer“ es ist, kann aber nicht beantworten, „wo“ es stattgefunden hat.
Aus diesem Grund hat ein Forschungsteam der Hong Kong University of Science and Technology (Guangzhou), der Jilin University und der Chinese University of Hong Kong HeLa-Mem (Hebbian Learning Associative Memory) vorgeschlagen, um diese Assoziationslücke im Langzeitgedächtnis zu schließen: Die Erfahrungen im Dialog werden nicht nur einzeln gespeichert, sondern bauen allmählich Verbindungen auf, wenn sie immer wieder gemeinsam abgerufen werden. Die zugehörige Arbeit wurde von ACL 2026 Main angenommen.
Link zum Paper: https://aclanthology.org/2026.acl-long.625/ Adresse von GitHub: https://github.com/ReinerBRO/HeLa-Mem
Experimente auf LoCoMo zeigen, dass HeLa-Mem bei deutlich weniger verwendeten Kontext-Tokens gleichzeitig eine hervorragende Leistung in allen vier Fragestellungsklassen erzielt.
Der Wert dieser Arbeit liegt darin, den Fokus des Langzeitgedächtnisses von AI-Agenten von der Frage „Wie viel Geschichte wird behalten?“ zu der Frage „Wie entstehen Beziehungen zwischen historischen Informationen?“ voranzubringen. Wenn AI-Agenten Nutzer begleiten, komplexe Aufgaben verfolgen oder sitzungsübergreifend zusammenarbeiten müssen, befinden sich die wirklich wichtigen Informationen oft in den Assoziationen, die sich allmählich aus mehreren Erfahrungen ergeben.
Verbindungen zwischen Gedächtnisinhalten im Nutzungsprozess aufbauen
Viele aktuelle AI-Agenten-Gedächtnissysteme schneiden historische Dialoge in Fragmente, schreiben sie in Vektordatenbanken und rufen sie dann nach semantischer Ähnlichkeit ab. Diese Methode kann Inhalte effizient abrufen, die der Formulierung der Frage ähneln, aber die entscheidenden Hinweise in langen Dialogen sind oft nicht derjenige, der „am ähnlichsten aussieht“.
Das menschliche Gedächtnis hängt nicht vollständig von der Ähnlichkeit von Wörtern ab. Eine Person, die man bei einer Veranstaltung kennengelernt hat, kann später die Berufswahl beeinflussen; eine bestimmte Reiseerfahrung kann auch mit einer langfristigen Vorliebe zusammenhängen. Diese Inhalte sind textlich weit voneinander entfernt, aber in der realen Erfahrung miteinander verknüpft. HeLa-Mem macht diese Beziehungen zu einem Teil des Langzeitgedächtnissystems: Jede Dialogrunde ist ein Gedächtnisknoten, und die Kanten zwischen den Knoten zeichnen auf, in welchem Maße sie gemeinsam genutzt wurden.
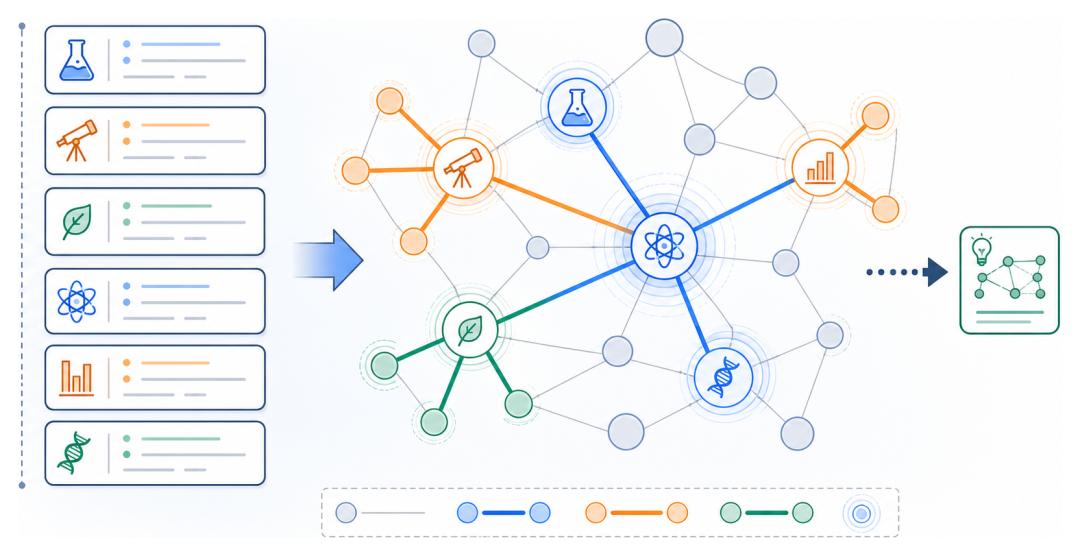
Abbildung|HeLa-Mem organisiert den Dialogverlauf als gewichteten Assoziationsgraphen. Gedächtnisinhalte, die wiederholt gemeinsam abgerufen werden, bilden stärkere Verbindungen.
Die folgende Abbildung stellt den vollständigen geschlossenen Kreislauf von HeLa-Mem zusammen: Jede Dialogrunde wird zuerst in das episodische Gedächtnisnetzwerk geschrieben; bei neuen Fragen sucht das System gleichzeitig nach Hinweisen in semantischer Ähnlichkeit und bestehenden Beziehungen; das Reflexions-Agent extrahiert dann Wissen aus dem Netzwerkzustand und entfernt veraltete Knoten. Die Ergebnisse der beiden Suchpfade bilden zusammen mit dem semantischen Gedächtnis den Antwortkontext für das LLM, und der neue Nutzungsprozess aktualisiert weiterhin die Assoziationsstärken.
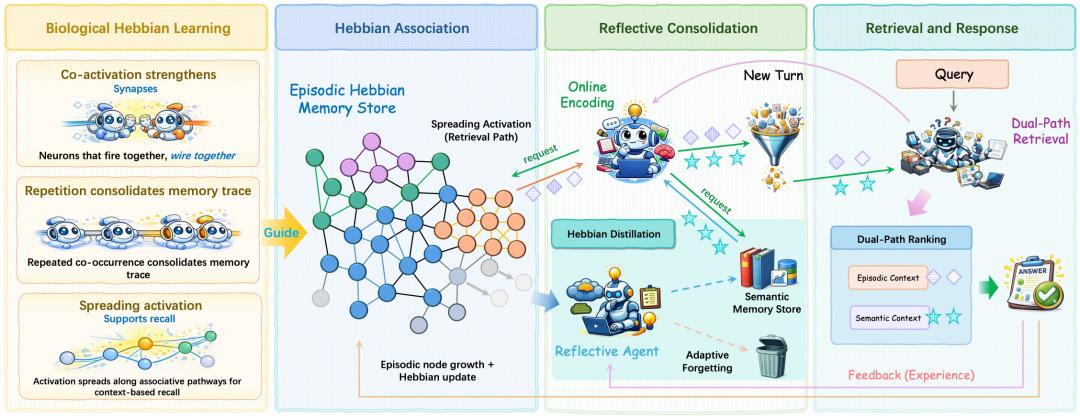
Abbildung|Übersicht über das HeLa-Mem-Verfahren aus dem Paper. Hebbsche Assoziationen bauen das episodische Gedächtnisnetzwerk auf, die Reflexionsintegration übernimmt die Extraktion und das Vergessen von Gedächtnisinhalten, und in der Abrufphase wird der Kontext über zwei Pfade zurückgeholt.
Der erste Schritt von HeLa-Mem besteht darin, jede Dialogrunde als episodischen Gedächtnisknoten zu kodieren und Originaltext, Zeit, Rolle, Schlüsselwörter und Vektorrepräsentation zu speichern. Wenn mehrere Knoten bei einem Abruf gemeinsam auftreten, verstärkt das System die Assoziation zwischen ihnen; schwache Verbindungen, die lange nicht genutzt wurden, klingen allmählich ab. Mit zunehmender Interaktion bildet die Gedächtnisbibliothek ein Netzwerk mit Beziehungen unterschiedlicher Stärke.
Das System prüft dieses Netzwerk außerdem regelmäßig. Für Knoten mit dichteren Assoziationen und deren Nachbarschaft extrahiert das Reflexions-Agent wiederverwendbare Informationen daraus, um ein stabiles semantisches Gedächtnis zu bilden, z. B. Nutzervorlieben, Beziehungen zwischen Ereignissen oder Fakten mit absoluter Zeitangabe. Knoten mit schwachen Assoziationen, die lange nicht genutzt und in letzter Zeit nicht aufgerufen wurden, werden zu Kandidaten für das Vergessen, um den Umfang des Gedächtnisses und das Rauschen zu kontrollieren.
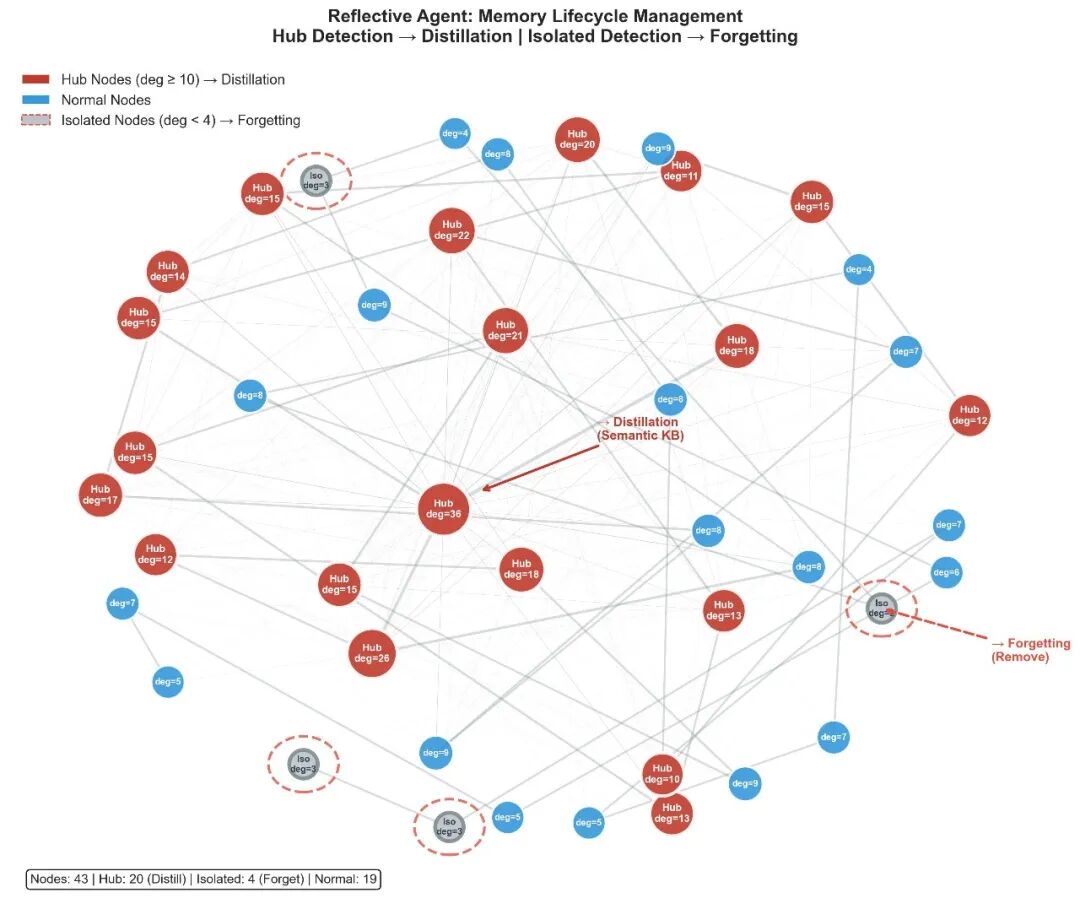
Abbildung|Das Reflexions-Agent extrahiert semantisches Wissen um Knoten mit hohem Assoziationsgrad und identifiziert isolierte, veraltete und nicht aufgerufene Kandidaten für das Vergessen.
Beim Abruf nutzt HeLa-Mem zwei Pfade: Ein Pfad ruft Kandidatengedächtnisse direkt nach Vektorähnlichkeit, Schlüsselwörtern und Zeitfaktoren ab; der andere Pfad geht von Knoten mit hohem Score aus, aktiviert sich entlang der Assoziationskanten und findet Inhalte, die textuell wenig ähnlich sind, aber eine historische Assoziation mit der Frage aufweisen. Die Ergebnisse beider Pfade werden mit dem semantischen Gedächtnis zusammengeführt und an das LLM zur Generierung der Antwort übergeben.
Im oben genannten Fall der „Berufswahl“ kann die semantische Suche zuerst die mit „Berufsberatung“ verbundenen Runden lokalisieren; der Assoziationspfad ergänzt dann den „Ort des ersten Treffens“ entlang bestehender Verbindungen. Dadurch kann das System fragmentübergreifende, mehrstufige Erinnerungen durchführen.
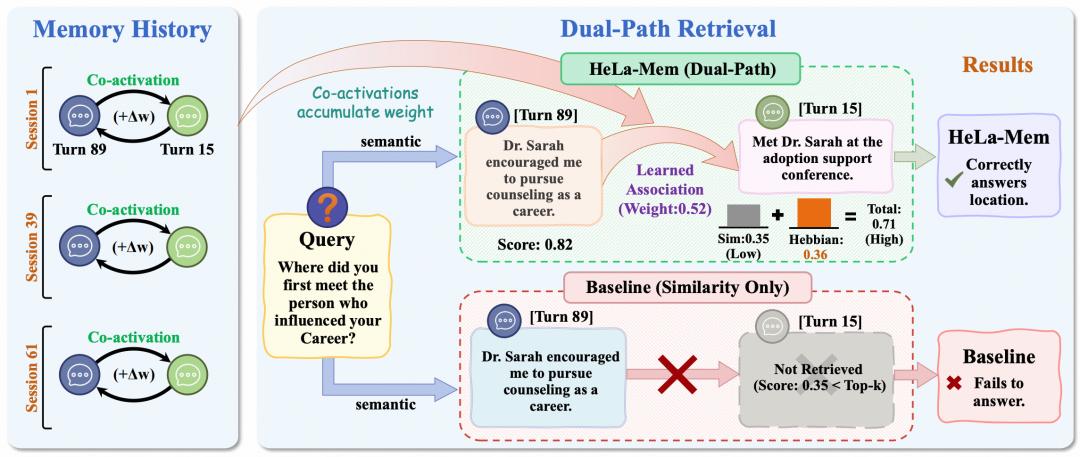
Abbildung|Der semantische Pfad lokalisiert zuerst die berufsbezogenen Gedächtnisinhalte, der Assoziationspfad ruft dann die Ortsinformationen entlang der erlernten Verbindungen ab.
Leistung auf dem Benchmark für Langdialoggedächtnis
Das Forschungsteam hat HeLa-Mem auf dem LoCoMo-Benchmark evaluiert. Dieser Benchmark enthält lange Dialoge mit durchschnittlich etwa 300 Runden und etwa 9K Tokens, wobei die Fragen die Kategorien Mehrschrittschlussfolgerung, Zeit, offenes Domänenwissen und Einschrittschlussfolgerung abdecken.
Wie in der folgenden Abbildung zu sehen ist, erreicht HeLa-Mem bei Verwendung von GPT-4o-mini als Basismodell in den vier Aufgabenkategorien von LoCoMo – Mehrschrittschlussfolgerung, Zeitschlussfolgerung, offenes Domänenwissen und Einschritt-Frage-Antwort – F1-Werte von 40,14, 47,29, 29,70 bzw. 51,89.
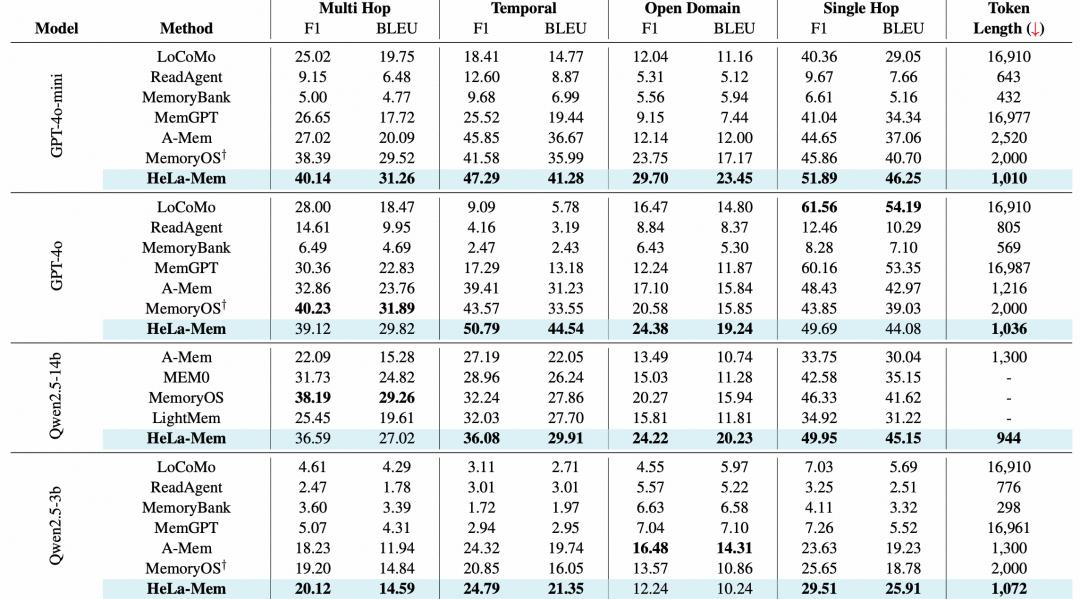
Gleichzeitig benötigt HeLa-Mem durchschnittlich nur 1010 Tokens an Abrufkontext; MemoryOS benötigt etwa 2000 Tokens, die Baseline mit direkter Eingabe des vollständigen LoCoMo-Dialogs etwa 16910 Tokens. Über die drei Basismodelle GPT-4o-mini, GPT-4o und Qwen2.5-3B hinweg liegt der durchschnittliche Rang von HeLa-Mem in den vier Aufgaben bei 1,25 (niedrigere Werte sind besser).
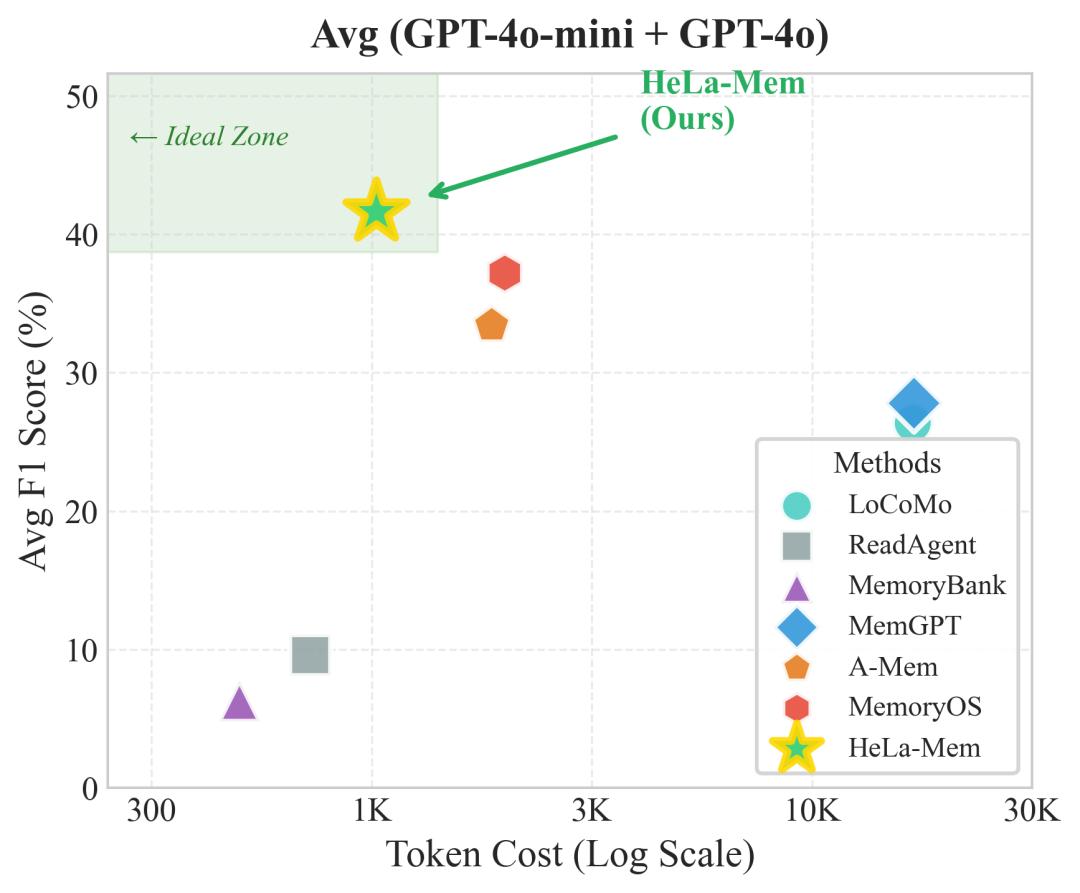
Abbildung|Der vom Paper berichtete Vergleich von Leistung und Token-Aufwand. Die horizontale Achse stellt die Token-Kosten dar (logarithmische Skala), die vertikale Achse den durchschnittlichen F1-Wert; die Abbildung fasst die Ergebnisse von GPT-4o-mini und GPT-4o zusammen.
Natürlich weist diese Studie noch einige Einschränkungen auf. Zum Beispiel müssen die Assoziationsgewichte von HeLa-Mem im laufenden Interaktionsprozess schrittweise angesammelt werden, sodass es bei wenig Interaktionshistorie immer noch Herausforderungen beim Kaltstart gibt. Das semantische Wissen, das durch reflexive Konsolidierung extrahiert wird, wird außerdem von den Fähigkeiten des zugrundeliegenden LLM beeinflusst.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Academic Headline“ (ID: SciTouTiao), Autor: Academic Headline, veröffentlicht mit Genehmigung von 36Kr.