谷歌开源Harness,支持 OpenCode 和 Codex:国内开发者接入Jev实测“真行”
谷歌研究团队开源了一套名为 Harness² 的智能体框架,试图让 AI Agent 在不修改模型权重的情况下,通过持续调整系统提示词、记忆、工具指导、skill、子智能体等外部组件,实现递归式能力提升。
目前,Harness² 已在 GitHub 以 Apache 2.0 协议开源,支持 OpenCode 和 Codex,默认使用 OpenCode,也可以切换至 Codex。Google Research 同时强调,Harness² 仍属于研究项目,并非谷歌官方支持的产品。
GitHub 地址:https://github.com/google-research/harness2
团队将这套可修改的 Harness 拆成 8 类组件,包括系统提示词、护栏、记忆、工具指导、子智能体、Skills、脚本和插件。这些组件共同决定 Agent 如何构建上下文、调用工具、委派任务,以及如何在多轮工具调用中完成工作。
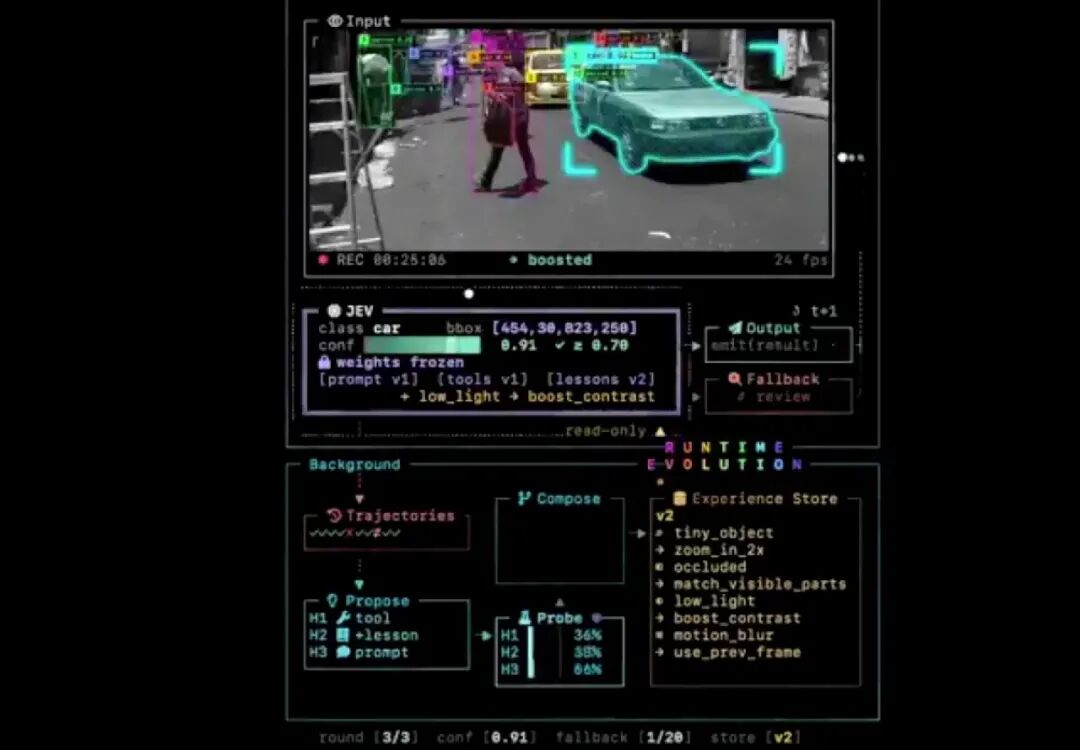
国内开发者 Joseph Zhou 称,将 Harness² 接入 Jev 1.14 后,在不调整模型权重的情况下大幅提升了视觉任务表现。按照其说法,底层系统会调整自身提示词、构建执行能力并提炼经验。
不知道标准答案,也要改进自己
Harness² 全称为“面向开放世界的递归智能体 Harness(Recursive Agent Harnessing for an Open World)”。
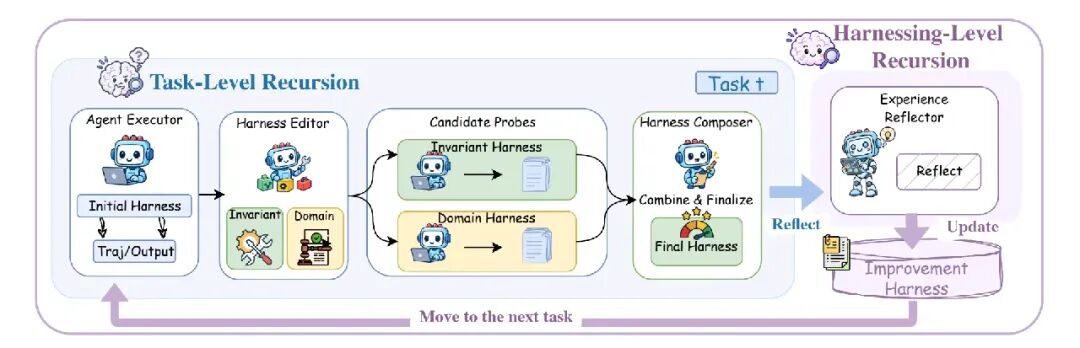
它最核心的设计,是两层递归机制。第一层发生在单个任务内的“任务级递归”。当 Agent 遇到一个 Harness 设计阶段没有见过的新任务时,系统不会完全依赖预先写好的固定策略,而是执行一轮“提出—探测—组合”:先生成多个 Harness 修改方案,让不同版本实际执行同一个任务,再观察它们产生的行为差异,最后重新组合出一套更合适的 Harness。
特别的是,Harness² 并不要求任务一定存在明确的标准答案。
许多自动优化方法依赖评测集、奖励信号或真实标准验证器来判断一次修改是否更好。但真实企业环境中的大量任务并不存在唯一答案,甚至可能在 Agent 上线之前从未出现过。Harness² 因此更多通过实际执行观察修改带来的行为差异,采用有执行证据支持的修改,再将经验用于后续任务。
第二层则发生在任务之间的“Harnessing 级递归”。
Harness² 不会在一个任务结束后把刚刚得到的经验全部丢掉,而是维护一个持续存在的 Improvement Harness,将此前采用过的 Harness 方案以及有执行证据支持的经验保存下来,用于指导之后的优化。
由此,可以形成一个闭环:Agent 面对任务、修改执行方式、实际运行验证修改结果、保留有效经验,再利用这些经验指导下一轮 Harness 调整。
Google Research 已经在 JobBench、LAB 和 WorkBuddy-Bench 三类专业任务 Benchmark,以及 4 种“模型—Harness”配置上测试 Harness²,使用的基础模型包括 GLM-5 和 Gemini 3.5 Flash。
结果显示,仅进行一步 Harness² 优化,在模型权重保持不变的情况下,WorkBuddy-Bench 成绩最高提升 11.5 分,JobBench 最高提升 4.5 分,LAB 部分通过率最高提高 11.8 个百分点。继续增加任务级递归预算后,性能还会进一步提升。
Harness² 同时提供并行和顺序两种递归方式。前者同时探索多套 Harness,更偏向“搜索得更宽”;后者把上一轮优化结果和执行证据带入下一轮,更偏向“优化得更深”。
但这种提升并不是免费的。每增加一轮递归,都意味着为同一个任务运行更多候选 Agent 和模型调用,本质上是在用更多测试时计算换取更高成功率。
另外,Harness² 当前 executor 默认网络访问不受限制,而且 Codex executor 会关闭 sandbox。官方提醒,公开 Benchmark 的评分细则或答案可能通过互联网获取,因此正式评测需要另外限制网络访问。
“Harness 真的很难做!”
“Harness 真的很难做!”长期参与 Harness 开发、并与多支生产团队合作的工程师 Viv 感叹道。
Harness 并不是一层可以脱离模型单独设计的通用软件。 Viv 将这一点概括为“模型 -Harness- 任务匹配”。
在他看来,Harness 的作用既是控制模型行为,也是放大模型已有能力。钩子、控制提示词、自动上下文管理等机制,本质上都在帮助模型把原生能力更稳定地用于某类具体任务。
不同模型适合的工具形态、提示词方式以及问题拆解方式也并不相同。一套针对 Claude 优化的上下文管理和工具策略,未必适合 Gemini;Codex 中有效的 Agent Loop,也未必可以直接迁移到 GLM 或 Qwen。这使 Harness 很难出现完全独立于模型的“统一最优解”。
此外,Harness 很大程度上是上下文工程的交付机制。对于大模型而言,上下文窗口就是计算边界,因此 Harness 最重要的职责之一,就是让每个子任务能够方便地建立并维持一个干净的上下文。
与此同时,Harness 的实际效果又很难在上线之前准确预测。“凭感觉当然很好,但如果你只是‘凭感觉’做 Harness,那基本等于主动放弃了一部分性能。”
在生产环境中,开发者需要持续观察任务通过率、Token 消耗和执行轨迹,定位 Agent 究竟在哪里失败,再针对具体组件进行修改。Viv 将 Eval 视为当前 Agent 时代的一种“训练数据”:Harness 构建本身就是不断收集 Trace、建立评估目标和实验的过程。
Viv 目前尤其关注一条循环路径:Harness Engineering → Post-Training → Harness Engineering,即先通过 Harness 找到模型在真实任务中的缺陷,再由后训练吸收一部分能力,模型升级后又重新调整 Harness。
而今年业内还越来越多地开始探索 AutoHarness,即把 Harness 工程本身的迭代交给 Agent,要解决的本质上是 Harness 工程无法跟上模型和任务变化的问题。
学术届在这一方向上有了不少成果。比如,Self-Harness,把优化者收回到 Agent 自身:不再依赖一个更强的外部模型,而是让 Agent 从自己的执行 Trace 中识别失败模式,提出最小化 Harness 修改,再通过回归测试决定是否接受。
Adaptive Auto-Harness 则针对真实任务不断变化的问题,不再维护一个持续被反复修改的唯一 Harness,而是建立 Harness Tree,根据任务动态选择不同 Harness,并保留人工干预入口。研究团队指出,在开放任务流中,单一 Harness 反复更新后可能反而出现性能下降。
另一条 Continual Harness 路线,则尝试让 Agent 在一次持续运行过程中直接修改自己的提示词、子智能体、Skills 和记忆,而不需要重置任务。它最初来自长期游戏 Agent 的实践,随后进一步发展出模型和 Harness 相互改进的闭环。
谷歌开源的 Harness² 则把问题推进到更为开放的层面:系统不要求任务一定存在标准答案,而是通过不同 Harness 执行同一个任务产生的行为差异进行“提出—探测—组合”,再把有证据支持的经验写入长期 Improvement Harness。
Eval、回滚和成本问题
但是现实问题是:如果 Agent 可以自动修改 AGENTS.md、Skills、Tools 甚至整个执行逻辑,它怎么证明自己真的变好了?
一种正在形成的工程思路,是把代码仓库中的真实任务、PR 和故障变成可评分任务,让 Agent 完成任务后回看失败的工具调用、模糊文档、Prompt 和缺失 Skill,再提出 Harness 修改。
随之而来的问题是 Eval 应该评估什么?显然,只看最终答案是否正确已经不够。Agent 可能仍然得到正确答案,但内部执行方式已经从高效文件检索退化成大规模递归扫描,带来更多 Token、更高延迟和更高成本。因此,工具调用、Trace、Token 消耗、延迟和成本都开始被纳入 Harness Eval。
回归问题也因此变得重要。一次 Benchmark 平均成绩提升,并不能证明某些关键能力没有倒退。一些开发者开始维护专门的历史失败案例集,每次 Harness 或模型更新都首先重新运行这些任务,只要过去已经解决的问题再次出现,就阻止更新上线。新能力提升,并不一定等于系统整体进步。
安全边界则是另一个现实问题。如果 AutoHarness 只能修改 System Prompt,风险还相对有限;如果允许它修改 Tool、中间件、Shell、记忆和运行时逻辑,就意味着 Agent 实际上开始生成并执行新的程序。
A-Evolve 的 GitHub Issues 中已经有开发者指出,由 Proposer 产生的 harness.py 可能在加载阶段直接执行模块级代码,而候选 Harness 的前置 Gate 仅进行 compile() 检查。这使沙箱、权限控制和代码审查成为 AutoHarness 必须面对的问题。
成本也是一个很大的问题。Harness² 开源后,社区很快提出支持本地 Benchmark、增加 --max-usd 成本上限,以及允许人工参与 Harness 选择和经验总结等需求。
原因并不复杂:每生成一个候选 Harness,都可能意味着额外模型调用、完整任务执行以及回归测试。如果为了提高几个百分点的成功率,需要付出数十倍 Token 的搜索成本,“自我进化”在 Benchmark 上有效,并不代表生产环境一定划算。
与此同时,开发者们也开始反思 Harness 工程是否正在变得“过度”。
一名开发者曾分享自己用 8 个月、883 次提交构建一套 Agent Harness 的经历。系统不断加入代码图、RAG、确定性编排、隔离 Worker、崩溃恢复、模型路由、Replay、验证 Gate、自我改进实验和 Dashboard,最终维护 Harness 本身消耗的时间甚至超过了真正使用 Agent。
因此,当前 AutoHarness 的演化方向并不只是不断给 Agent 增加组件,而是试图形成一套更完整的反馈循环:发现失败、理解失败、尝试修改、验证修改,并在修改没有收益时重新删除。
结束语
这个方向目前还很早期,社区也开源了一些相关软件。
比如,Prime Intellect 在 8 月采用 MIT 协议开源的 Prime Agent 则进一步把“自我改进 Harness”直接做进 Agent 产品。Prime Agent 使用 Continual Harness 保存提示词、记忆、Skill 和可复用子智能体等持久状态,Agent 可以根据实际执行经验,对这些组件进行小幅、可追踪的修改。
还有 NeoSigma 开源的 auto-harness,开发者给它一个 Agent 文件和 Benchmark,Coding Agent 会读取失败案例,自动修改 System Prompt 和 Tools,再用自己维护的 Eval Suite 做回归检查。另一个开源项目 kayba-ai/autoharness 则不会要求开发者更换原来的 Agent,而是接管候选修改、Benchmark、迭代和 Champion Harness 管理,并支持 Codex CLI、Claude Code 等不同提案生成器。
参考链接:
https://github.com/google-research/harness2
https://x.com/openmys/status/2112024812751294954
https://arxiv.org/abs/2605.09998
https://github.com/A-EVO-Lab/a-evolve/issues
https://www.reddit.com/r/AgentsOfAI/comments/1w8h7r5/i_spent_883_commits_and_8_months_building_an_llm/
本文来自微信公众号 “InfoQ”(ID:infoqchina),作者:褚杏娟,36氪经授权发布。