Google veröffentlicht Harness als Open Source und unterstützt OpenCode sowie Codex: Inländische Entwickler, die Jev integriert haben, bestätigen in Praxistests, dass es wirklich hervorragend funktioniert.
Das Forschungsteam von Google hat ein Agent-Framework namens Harness² als Open-Source veröffentlicht. Es zielt darauf ab, dass KI-Agenten ohne Änderung der Modellgewichte durch kontinuierliche Anpassung externer Komponenten wie Systemprompts, Gedächtnis, Anweisungen für Tools, Skills und Subagenten eine rekursive Leistungssteigerung erzielen.
Derzeit ist Harness² auf GitHub unter der Apache-2.0-Lizenz quelloffen verfügbar. Es unterstützt OpenCode und Codex, verwendet standardmäßig OpenCode und kann auch auf Codex umgestellt werden. Google Research betont gleichzeitig, dass Harness² noch ein Forschungsprojekt ist und kein offiziell von Google unterstütztes Produkt.
GitHub-Adresse: https://github.com/google-research/harness2
Das Team hat dieses anpassbare Harness in 8 Komponentenkategorien unterteilt, darunter Systemprompts, Schutzschranken, Gedächtnis, Anweisungen für Tools, Subagenten, Skills, Skripte und Plugins. Diese Komponenten bestimmen gemeinsam, wie der Agent Kontexte aufbaut, Tools aufruft, Aufgaben delegiert und die Arbeit in mehreren Runden von Tool-Aufrufen erledigt.
Der inländische Entwickler Joseph Zhou gibt an, dass nach der Integration von Harness² in Jev 1.14 die Leistung bei visuellen Aufgaben ohne Anpassung der Modellgewichte erheblich gesteigert wurde. Seinen Angaben zufolge passt das zugrundeliegende System seine eigenen Prompts an, baut Ausführungsfähigkeiten auf und verfeinert Erfahrungen.
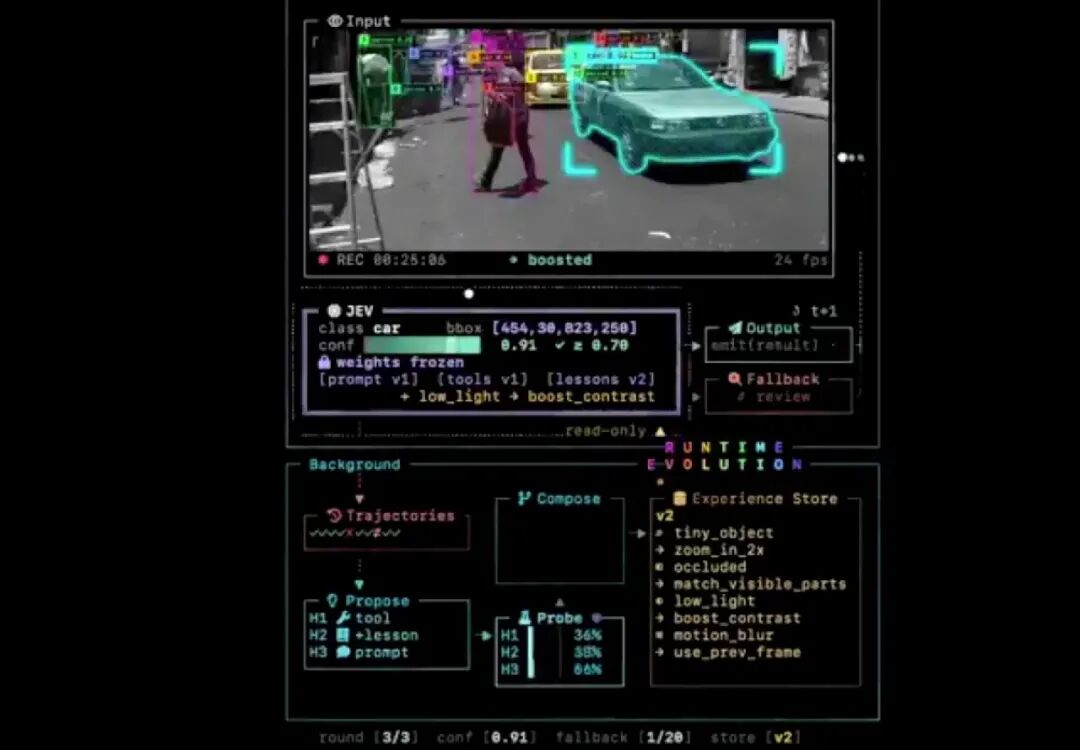
Ohne die richtige Antwort zu kennen, muss man sich trotzdem verbessern
Der vollständige Name von Harness² lautet „Recursive Agent Harnessing for an Open World“ (rekursives Agent-Harness für eine offene Welt).
Das Kernstück seines Designs ist ein zweistufiger rekursiver Mechanismus. Die erste Stufe ist die „aufgabenbezogene Rekursion“ innerhalb einer einzelnen Aufgabe. Wenn der Agent auf eine neue Aufgabe stößt, die in der Entwurfsphase von Harness noch nie vorgekommen ist, verlässt sich das System nicht vollständig auf vorgefertigte feste Strategien, sondern führt eine Runde von „Vorschlag – Erprobung – Kombination“ durch: Zuerst werden mehrere Modifikationsvorschläge für Harness generiert, verschiedene Versionen führen dieselbe Aufgabe tatsächlich aus, dann werden die Unterschiede in ihrem Verhalten beobachtet, und schließlich wird ein besser geeignetes Harness neu zusammengesetzt.
Besonders hervorzuheben ist, dass Harness² nicht verlangt, dass für eine Aufgabe unbedingt eine eindeutige Standardantwort existiert.
Viele automatische Optimierungsmethoden verlassen sich auf Bewertungsdatensätze, Belohnungssignale oder echte Standardprüfer, um zu beurteilen, ob eine Modifikation besser ist. Aber für eine große Anzahl von Aufgaben in echten Unternehmensumgebungen gibt es keine eindeutige Antwort, und manche Aufgaben sind sogar noch nie aufgetreten, bevor der Agent in Betrieb genommen wird. Daher beobachtet Harness² die Verhaltensunterschiede, die durch Modifikationen entstehen, stärker durch tatsächliche Ausführung, wendet Modifikationen an, die durch Ausführungsbeweise gestützt werden, und nutzt die Erfahrungen dann für nachfolgende Aufgaben.
Die zweite Stufe ist die „Harnessing-bezogene Rekursion“ zwischen verschiedenen Aufgaben.
Harness² verwirft nicht alle gerade gesammelten Erfahrungen nach Abschluss einer Aufgabe, sondern pflegt ein dauerhaft vorhandenes Improvement Harness, das die zuvor verwendeten Harness-Lösungen und die durch Ausführungsbeweise gestützten Erfahrungen speichert, um die nachfolgenden Optimierungen zu leiten.
Auf diese Weise kann ein geschlossener Kreislauf entstehen: Der Agent stellt sich der Aufgabe, ändert die Ausführungsweise, überprüft das Ergebnis der Modifikation im praktischen Betrieb, behält wirksame Erfahrungen und nutzt diese Erfahrungen, um die nächste Anpassung von Harness zu leiten.
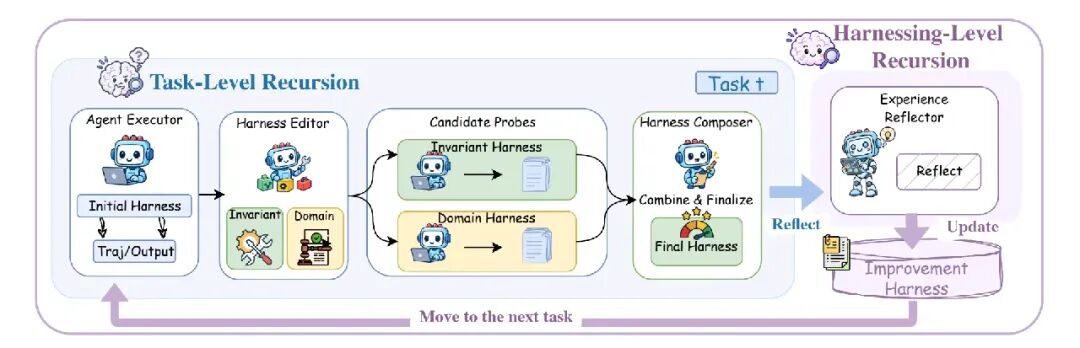
Google Research hat Harness² bereits an drei professionellen Aufgaben-Benchmarks, nämlich JobBench, LAB und WorkBuddy-Bench, sowie auf 4 Konfigurationen von „Modell – Harness“ getestet. Die verwendeten Basismodelle umfassen GLM-5 und Gemini 3.5 Flash.
Die Ergebnisse zeigen, dass nach nur einem Optimierungsschritt von Harness² bei unveränderten Modellgewichten die Punktzahl bei WorkBuddy-Bench um bis zu 11,5 Punkte, bei JobBench um bis zu 4,5 Punkte und die Durchlaufrate bei LAB um bis zu 11,8 Prozentpunkte gesteigert werden konnte. Wenn das Budget für die aufgabenbezogene Rekursion weiter erhöht wird, verbessert sich die Leistung noch weiter.
Harness² bietet gleichzeitig zwei Rekursionsarten an: parallele und sequenzielle. Die erstere erforscht mehrere Harness-Varianten gleichzeitig und zielt eher auf eine „breitere Suche“ ab; die letztere überträgt das Optimierungsergebnis und die Ausführungsbeweise der vorherigen Runde in die nächste Runde und zielt eher auf eine „tiefere Optimierung“ ab.
Diese Leistungssteigerung ist jedoch nicht kostenlos. Jede zusätzliche Rekursionsrunde bedeutet, dass mehr Kandidaten-Agenten und Modellaufrufe für dieselbe Aufgabe ausgeführt werden müssen. Im Wesentlichen wird mehr Rechenaufwand während der Testphase gegen eine höhere Erfolgsrate eingetauscht.
Darüber hinaus ist der standardmäßige Netzwerkzugriff des aktuellen Executors von Harness² nicht beschränkt, und der Codex-Executor deaktiviert die Sandbox. Die offizielle Seite weist darauf hin, dass die Bewertungsrichtlinien oder Antworten der öffentlichen Benchmarks möglicherweise über das Internet abgerufen werden können, daher muss der Netzwerkzugriff bei formellen Bewertungen zusätzlich eingeschränkt werden.
„Harness ist wirklich schwer zu entwickeln!“
„Harness ist wirklich schwer zu entwickeln!“, seufzt der Ingenieur Viv, der seit langem an der Entwicklung von Harness beteiligt ist und mit mehreren Produktionsteams zusammenarbeitet.
Harness ist keine allgemeine Software, die unabhängig vom Modell entworfen werden kann. Viv fasst diesen Punkt als „Modell-Harness-Aufgaben-Abstimmung“ zusammen.
Seiner Ansicht nach dient Harness sowohl dazu, das Verhalten des Modells zu steuern, als auch die vorhandenen Fähigkeiten des Modells zu verstärken. Mechanismen wie Hooks, Steuerungsprompts und automatische Kontextverwaltung helfen dem Modell im Wesentlichen, seine nativen Fähigkeiten stabiler für bestimmte Arten von konkreten Aufgaben einzusetzen.
Verschiedene Modelle eignen sich für unterschiedliche Werkzeugformen, Prompt-Verfahren und Methoden zur Aufgabenzergliederung. Eine Kontextverwaltung und Werkzeugstrategie, die für Claude optimiert ist, ist nicht unbedingt für Gemini geeignet; eine im Codex wirksame Agent-Schleife kann nicht unbedingt direkt auf GLM oder Qwen übertragen werden. Dadurch ist es sehr schwierig, eine „einheitliche optimale Lösung“ für Harness zu finden, die völlig unabhängig vom Modell ist.
Darüber hinaus ist Harness zu einem großen Teil der Bereitstellungsmechanismus für die Kontexttechnik. Für große Sprachmodelle ist das Kontextfenster die Rechengrenze, daher ist eine der wichtigsten Aufgaben von Harness, dass jede Teilaufgabe bequem einen sauberen Kontext aufbauen und aufrechterhalten kann.
Gleichzeitig ist die tatsächliche Wirkung von Harness schwer genau vorherzusagen, bevor es in Betrieb genommen wird. „Es ist natürlich gut, nach Gefühl zu arbeiten, aber wenn Sie Harness nur ‚nach Gefühl‘ entwickeln, geben Sie im Grunde einen Teil der Leistung freiwillig auf.“
In der Produktionsumgebung müssen Entwickler kontinuierlich die Aufgabendurchlaufrate, den Token-Verbrauch und die Ausführungsverfolgung beobachten, um festzustellen, wo genau der Agent fehlschlägt, und dann gezielt einzelne Komponenten modifizieren. Viv betrachtet Eval als eine Art „Trainingsdaten“ im aktuellen Agent-Zeitalter: Der Aufbau von Harness selbst ist ein Prozess, bei dem ständig Trace-Daten gesammelt, Bewertungsziele festgelegt und Experimente durchgeführt werden.
Viv befasst sich derzeit besonders mit einem zyklischen Pfad: Harness Engineering → Post-Training → Harness Engineering, d. h. zuerst werden die Mängel des Modells bei echten Aufgaben durch Harness ermittelt, dann absorbiert das Post-Training einen Teil der Fähigkeiten, und nach der Aktualisierung des Modells wird Harness neu angepasst.
In diesem Jahr erforscht die Branche zudem zunehmend AutoHarness, also die Übergabe der Iteration der Harness-Entwicklung selbst an den Agent. Das löst im Wesentlichen das Problem, dass die Harness-Entwicklung nicht mit den Änderungen von Modellen und Aufgaben Schritt halten kann.
In der akademischen Welt gibt es bereits viele Ergebnisse in dieser Richtung. Zum Beispiel gibt es Self-Harness, bei dem der Optimierer wieder in den Agent selbst integriert wird: Statt auf ein stärkeres externes Modell angewiesen zu sein, lässt der Agent Fehlermuster aus seiner eigenen Ausführungs-Trace erkennen, minimale Modifikationen für Harness vorschlagen und dann durch Regressionstests entscheiden, ob diese akzeptiert werden.
Adaptive Auto-Harness befasst sich mit dem Problem, dass sich echte Aufgaben ständig ändern. Statt ein einziges Harness zu pflegen, das ständig wiederholt modifiziert wird, wird ein Harness-Baum aufgebaut, der je nach Aufgabe dynamisch verschiedene Harness-Varianten auswählt und einen Eingriffspunkt für menschliche Eingriffe behält. Das Forschungsteam weist darauf hin, dass in offenen Aufgabenströmen die Leistung eines einzelnen Harness nach wiederholten Aktualisierungen sogar abnehmen kann.
Ein weiterer Ansatz namens Continual Harness versucht, den Agent dazu zu bringen, seine eigenen Prompts, Subagenten, Skills und sein Gedächtnis direkt während eines fortlaufenden Betriebs zu modifizieren, ohne die Aufgabe zurückzusetzen. Er stammt ursprünglich aus der Praxis von langfristig laufenden Spiel-Agenten und hat sich später zu einem geschlossenen Kreislauf entwickelt, in dem sich Modell und Harness gegenseitig verbessern.
Das von Google als Open-Source veröffentlichte Harness² treibt das Problem auf eine offenere Ebene: Das System verlangt nicht, dass für Aufgaben unbedingt Standardantworten existieren, sondern führt die Schritte „Vorschlag – Erprobung – Kombination“ anhand der Verhaltensunterschiede durch, die entstehen, wenn verschiedene Harness-Varianten dieselbe Aufgabe ausführen, und schreibt die durch Beweise gestützten Erfahrungen dann in das langfristige Improvement Harness.
Probleme bei Eval, Rollback und Kosten
Aber das reale Problem lautet: Wenn der Agent automatisch AGENTS.md, Skills, Tools oder sogar die gesamte Ausführungslogik modifizieren kann, wie kann er beweisen, dass er wirklich besser geworden ist?
Ein sich abzeichnender technischer Ansatz besteht darin, echte Aufgaben, PRs und Fehler aus Code-Repositories in bewertbare Aufgaben umzuwandeln. Nachdem der Agent die Aufgabe erledigt hat, blickt er zurück auf fehlgeschlagene Tool-Aufrufe, unklare Dokumente, Prompts und fehlende Skills und schlägt dann Modifikationen für Harness vor.
Das daraus resultierende Problem lautet: Was soll Eval bewerten? Offensichtlich reicht es nicht mehr, nur zu prüfen, ob die endgültige Antwort korrekt ist. Der Agent kann immer noch die richtige Antwort erhalten, aber seine interne Ausführungsweise hat sich von einer effizienten Dateiabfrage zu einer groß angelegten rekursiven Suche verschlechtert, was zu mehr Token-Verbrauch, höherer Latenz und höheren Kosten führt. Daher werden Tool-Aufrufe, Trace-Daten, der Token-Verbrauch, die Latenz und die Kosten zunehmend in die Harness-Bewertung einbezogen.
Aus diesem Grund wird das Regressionsproblem ebenfalls wichtig. Eine durchschnittliche Leistungssteigerung bei einem Benchmark beweist nicht, dass keine wichtigen Fähigkeiten zurückgegangen sind. Einige Entwickler pflegen spezielle Sammlungen historischer fehlgeschlagener Fälle. Bei jeder Aktualisierung von Harness oder dem Modell werden diese Aufgaben zuerst erneut ausgeführt. Sobald ein bereits gelöstes Problem erneut auftritt, wird die Inbetriebnahme der Aktualisierung blockiert. Eine Steigerung neuer Fähigkeiten bedeutet nicht unbedingt einen Gesamtfortschritt des Systems.
Sicherheitsgrenzen sind ein weiteres reales Problem. Wenn AutoHarness nur das Systemprompt modifizieren kann, ist das Risiko relativ begrenzt. Wenn es erlaubt ist, Tools, Middleware, Shell, Gedächtnis und Laufzeitlogik zu modifizieren, bedeutet das, dass der Agent tatsächlich neue Programme generiert und ausführt.
In den GitHub-Issues von A-Evolve haben Entwickler bereits darauf hingewiesen, dass das von Proposer generierte harness.py möglicherweise direkt Code auf Modulebene während der Ladephase ausführt, während die Vorprüfung für Kandidaten-Harness nur eine compile()-Prüfung durchführt. Dadurch werden Sandboxen, Zugriffskontrollen und Code-Prüfungen zu Problemen, die AutoHarness unbedingt bewältigen muss.
Die Kosten sind ebenfalls ein großes Problem. Nach der Veröffentlichung von Harness² als Open-Source hat die Community schnell Anforderungen aufgeworfen, lokale Benchmarks zu unterstützen, eine Kostenobergrenze von --max-usd hinzuzufügen und menschliche Beteiligung an der Auswahl von Harness und der Zusammenfassung von Erfahrungen zu ermöglichen.
Der Grund ist nicht kompliziert: Jede Generierung eines Kandidaten-Harness kann zusätzliche Modellaufrufe, die vollständige Ausführung der Aufgabe sowie Regressionstests bedeuten. Wenn man für eine Erhöhung der Erfolgsrate um wenige Prozentpunkte den Suchaufwand mit einem Vielfachen an Token bezahlen muss, ist die „Selbstverbesserung“ zwar auf dem Benchmark wirksam, aber nicht unbedingt in der Produktionsumgebung wirtschaftlich.
Gleichzeitig beginnen Entwickler, darüber nachzudenken, ob die Harness-Entwicklung nicht „übermäßig“ wird.
Ein Entwickler hat einmal seine Erfahrung geteilt, dass er 8 Monate und 883 Commits benötigt hat, um ein Agent-Harness aufzubauen. Das System wurde ständig um Code-Graphen, RAG, deterministische Orchestrierung, isolierte Worker, Absturzwiederherstellung, Modellrouting, Wiedergabe, Validierungs-Gates, Experimente zur Selbstverbesserung und ein Dashboard erweitert. Am Ende verbrachte er sogar mehr Zeit mit der Wartung von Harness selbst als mit der tatsächlichen Nutzung des Agent.
Daher besteht die aktuelle Entwicklungsrichtung von AutoHarness nicht nur darin, dem Agent ständig weitere Komponenten hinzuzufügen, sondern einen vollständigeren Feedback-Kreislauf zu bilden: Fehler erkennen, Fehler verstehen, Modifikationen ausprobieren, Modifikationen validieren und Modifikationen wieder löschen, wenn sie keinen Nutzen bringen.
Schlusswort
Dieser Bereich befindet sich derzeit noch in einem sehr frühen Stadium, und die Community hat bereits einige zugehörige Software als Open-Source veröffentlicht.
Zum Beispiel hat Prime Intellect im August Prime Agent unter der MIT-Lizenz quelloffen veröffentlicht, das die „selbstverbessernde Harness“-Funktion direkt in das Agent-Produkt integriert. Prime Agent verwendet Continual Harness, um dauerhafte Zustände wie Prompts, Gedächtnis, Skills und wiederverwendbare Subagenten zu speichern. Der Agent kann diese Komponenten auf der Grundlage praktischer Ausführungserfahrungen geringfügig und nachverfolgbar modifizieren.
Es gibt auch das von NeoSigma als Open