GPT价格砍半,比DeepSeek还便宜了
果然,这年头,性价比才是商业竞争最朴素的杀招,AI 圈也不例外。
前脚,Anthropic 刚发布 Claude Opus 5.5。
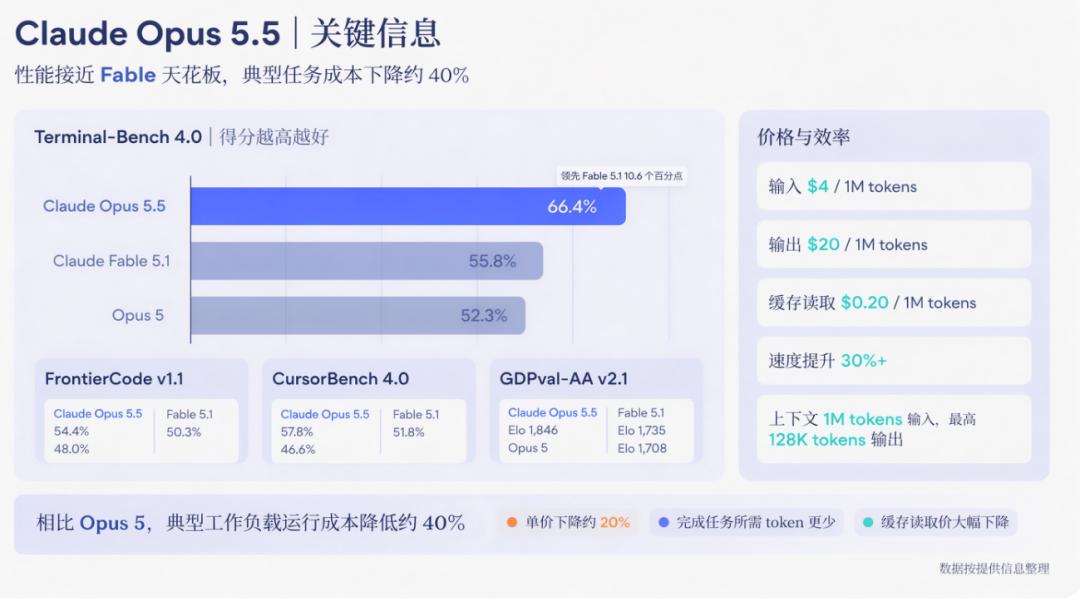
后脚,OpenAI 又给 GPT-6 家族补上了两款新模型:GPT-6 Sol 和 GPT-6 Luna。
明眼人都看得出来, OpenAI 这是对着人家的模型开卷:跑分要比,价格也要砍。
但这次,OpenAI 并不是简单地在 GPT-6 下面再塞两个“便宜版”。
它的打法是: 能力下放,价格腰斩 。
Astra 继续负责最难、最复杂的任务;Sol 主打复杂日常工作和 Agent;Luna 则瞄准摘要、抽取、分类、路由等高频、标准化任务。
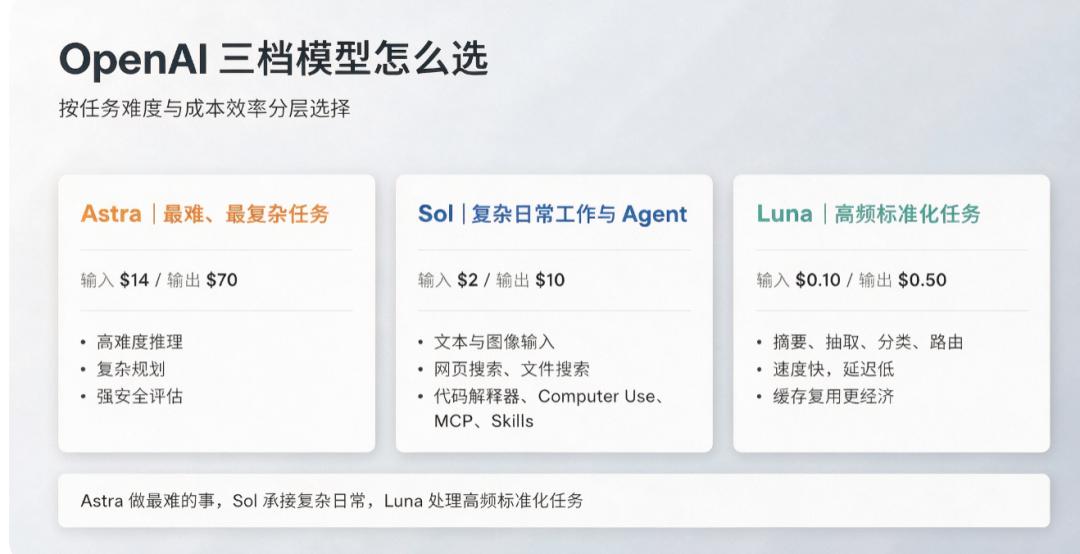
Sol 和 Luna 都支持文本、图像输入,也能调用网页搜索、文件搜索、代码解释器、Computer Use、MCP 和 Skills。
也就是说,过去需要旗舰模型才能承担的一些工作,现在开始有了更便宜的选择。
价格战打到 DeepSeek 门口了
价格方面,Opus 刚把价格打下来,GPT 也开始重新算账。
Sol 和 Luna 的 API 标价,相对 GPT-5.6 同档促销价直接砍了 50%。
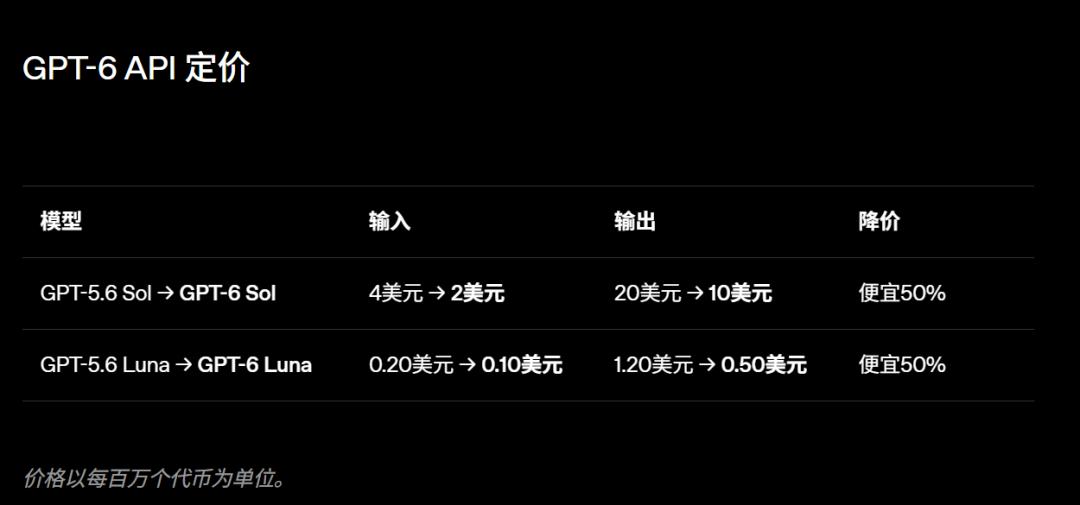
OpenAI 表示,主要原因是缓存和推理效率提升,而且这次价格并不是限时促销而是长期定价。
真正有意思的是 GPT-6 Luna,0.10 美元/百万输入 tokens,已经开始可以和 DeepSeek-V4.1-Flash 正面开刚了。
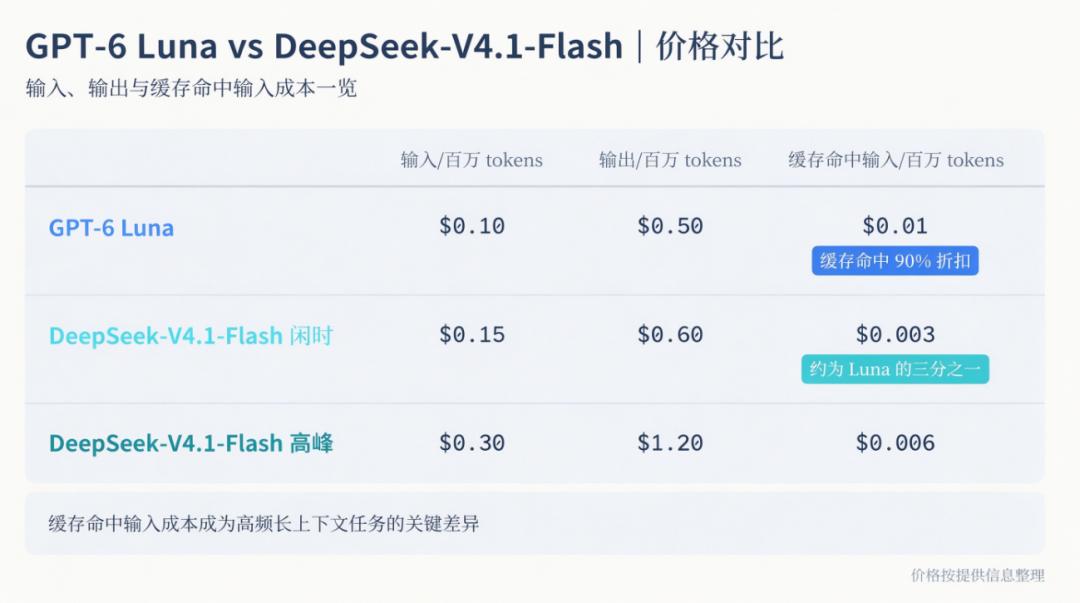
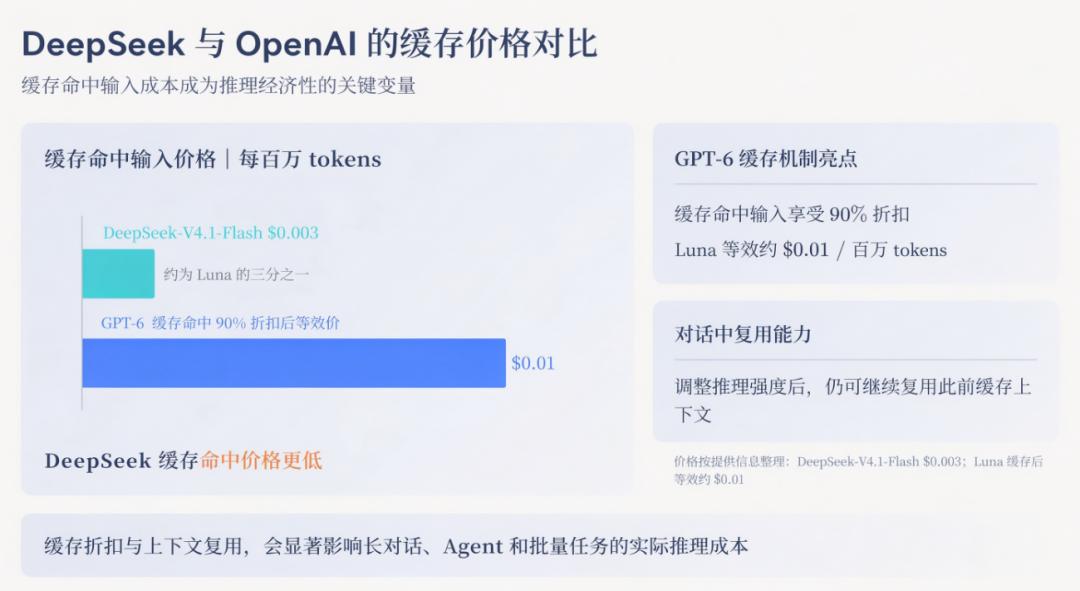
当然,DeepSeek 还有一张王牌:缓存命中价格更低。
对于 Agent 这种会反复携带同一套代码、文档、系统提示和工具定义的场景,缓存命中会直接影响最终账单。
以前 Agent 跑到一半,如果临时提高推理强度,或者调整工具配置,可能会影响此前缓存上下文的复用。
而 OpenAI 这次也在缓存机制上动了手术,现在 GPT-6 允许开发者在对话过程中调整推理力度、启用或关闭工具,同时保留已有缓存上下文。
这意味着 Agent 即使连续跑几十轮、上百轮,中途改变一次配置,也不用把前面已经处理过的大段上下文重新算一遍。
所以,现在不能简单说“谁的缓存更便宜”,毕竟两家思路就不一样:DeepSeek 把缓存单价压得更低,OpenAI 则在提高缓存的复用效率。
价格打折,能力不打折
前面说了这么多价格,问题也来了:便宜是便宜了,能力有没有跟着打折?
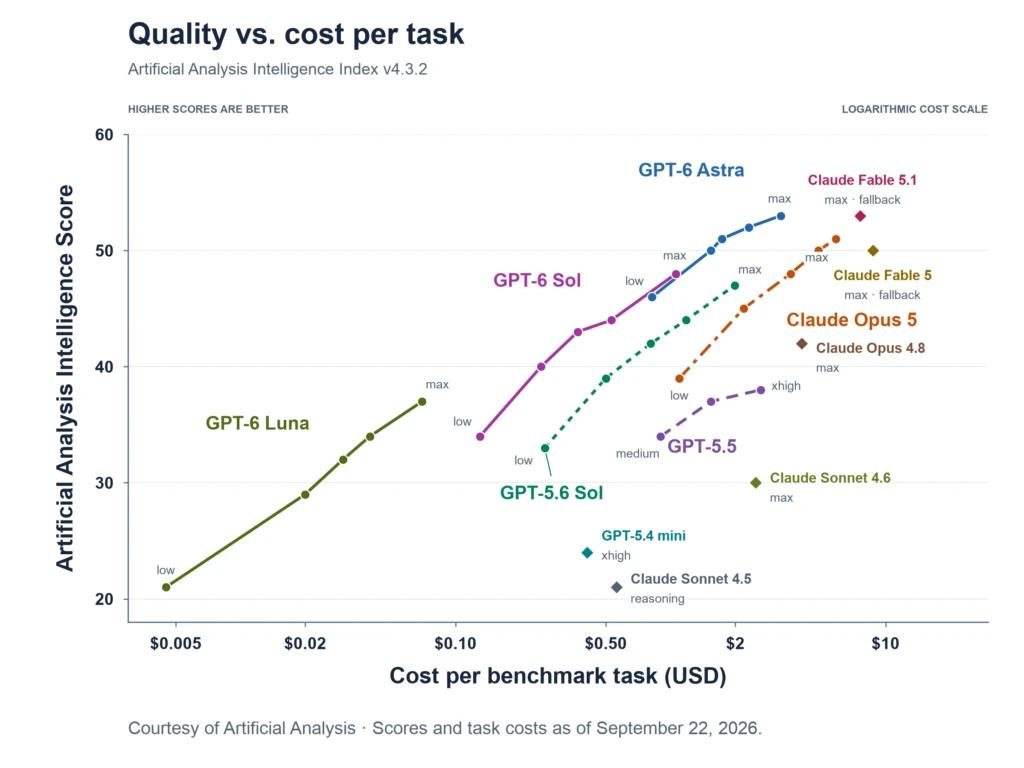
从目前公开的几项测试来看,OpenAI 这次的思路并不是单纯“牺牲性能换价格”,而是尽量把 GPT-6 Astra 的能力用便宜的价格获得。
GPT-6 Sol 最明显,以长链路真实软件工程测试 DeepSWE 为例,GPT-6 Sol 在 max 推理强度下取得 68.8%,仅比 Claude Fable 5 的 69.9% 低 1.1 个百分点。
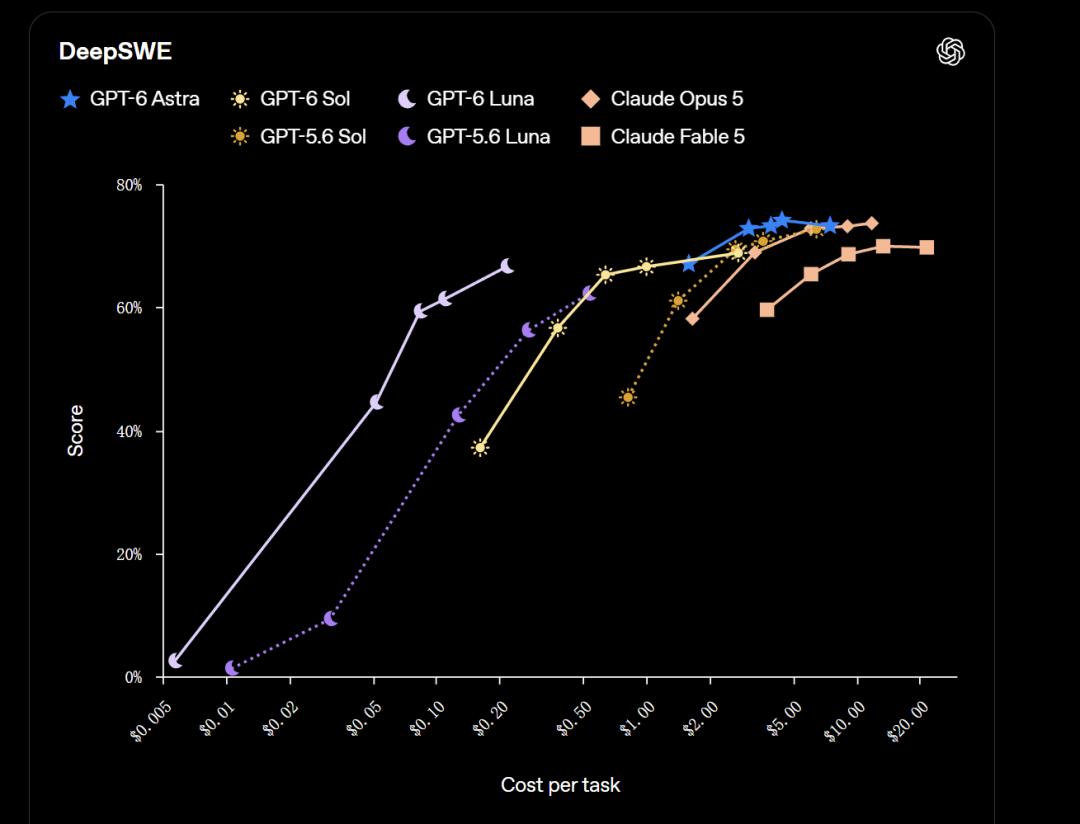
但按 OpenAI 的估算,其单任务成本低约 80%。
换句话说,你可以在代码库理解、修改代码、排错等代码 Agent 工作中少花八成的钱。
在跨应用 Agent 测试 AutomationBench 中,在 xhigh 推理强度下的任务完成率为 33.2%,高于 Claude Opus 5 在 max 档的 26.9%。
成本方面,单任务成本只要 0.27 美元,Opus 5 大概是它的 11 倍。
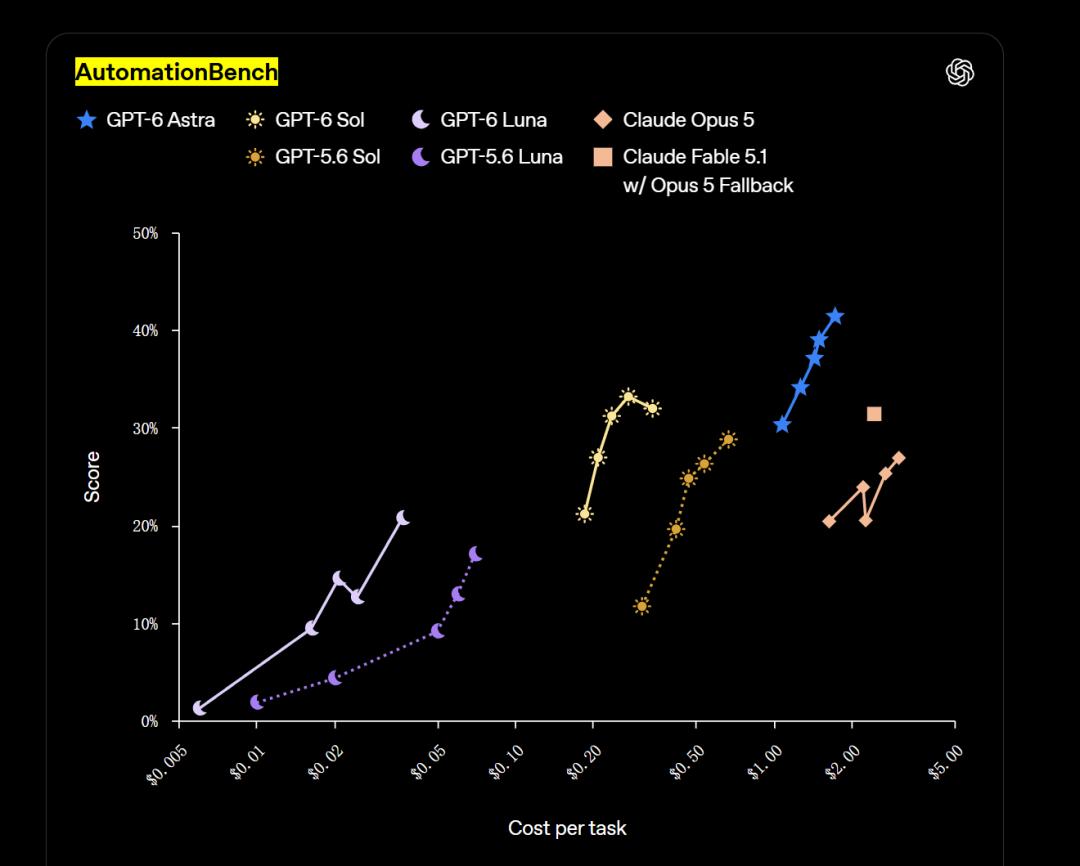
可见,写代码、调工具、跑多步骤任务,GPT-6 Sol 能给你接近旗舰的表现,但成本能更低。
GPT-6 Luna 则是另一种取舍:把足够强的代码和 Agent 能力,压到更低的成本档位。
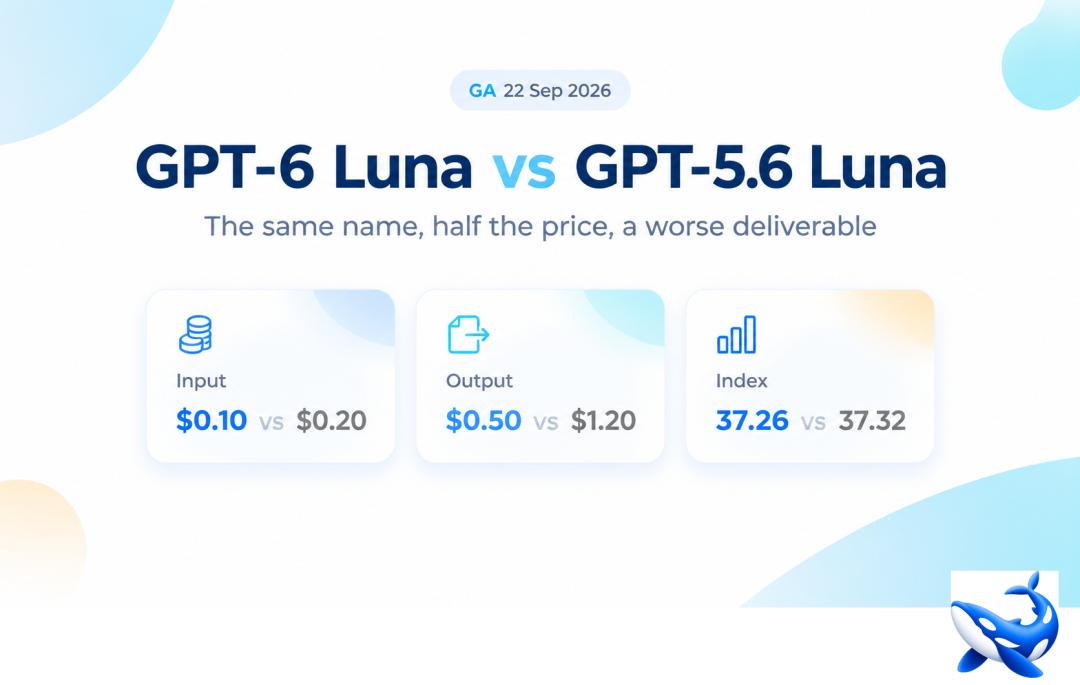
GPT-6 Luna 在 max 推理强度下也有 66.6%,只比 Sol 低 2.2 个百分点。
但成本呢?OpenAI 说比 Claude Opus 5 低 93%,比 Fable 5 低 96%。
除此之外,长上下文和推理能力也没有被砍掉。
GPT-6 Sol 和 GPT-6 Luna 都支持约 100 万 token 上下文,最高输出 128K token。
长代码库、文档集合、多轮 Agent 状态,都可以直接放进去。
两者还支持可调的推理强度,而且比 Astra 多了一个 none 档,可以完全关闭显式推理。
简单抽取、分类、路由,直接关推理拼速度;复杂编码、跨文档分析,再把推理档位拉高。
实测:这么便宜,到底能干到哪一步?
海外开发者 Nate Herk 用 10 项真实任务让 GPT-6 Sol 和 Claude Opus 5.5 正面刚了一整天,结果是 Opus 7 胜、Sol 1 胜、两项因文件夹冲突无效。
Opus 更胜一筹的地方有很多,比如:网站设计做出了多层纵深和开罐冒烟的细节,视频剪辑有节奏有音效,3D 学习世界能逛能玩,Canva 绘图甚至比之前 Astra 的表现还接近参考图。
Sol 唯一赢的是代码审查与修复,30 项检查全过拿满分,Opus 是 29/30。
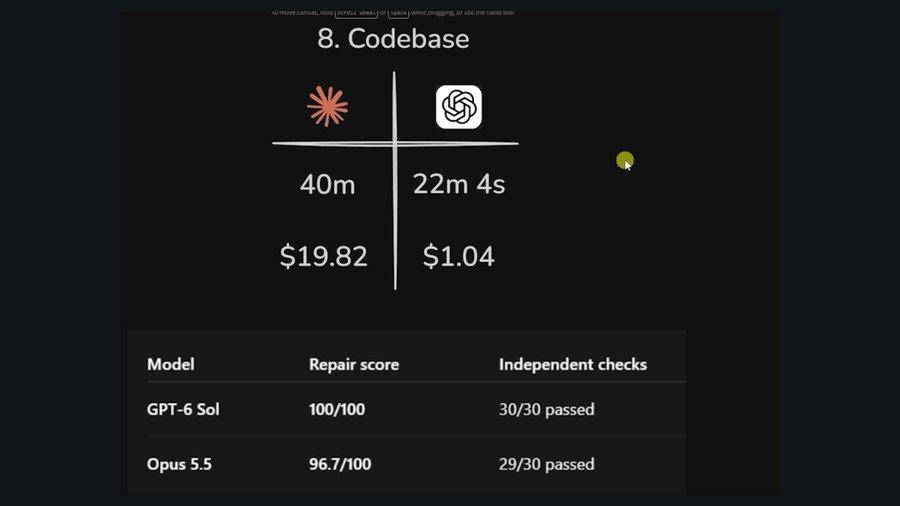
但成本差距也是十分明显,Opus 花了 213 美元,而 Sol 只花了 74.46 美元。
Nate 得出的结论是:用 Opus 做创意和判断,Sol 执行明确任务,这才是比较好的打开方式。
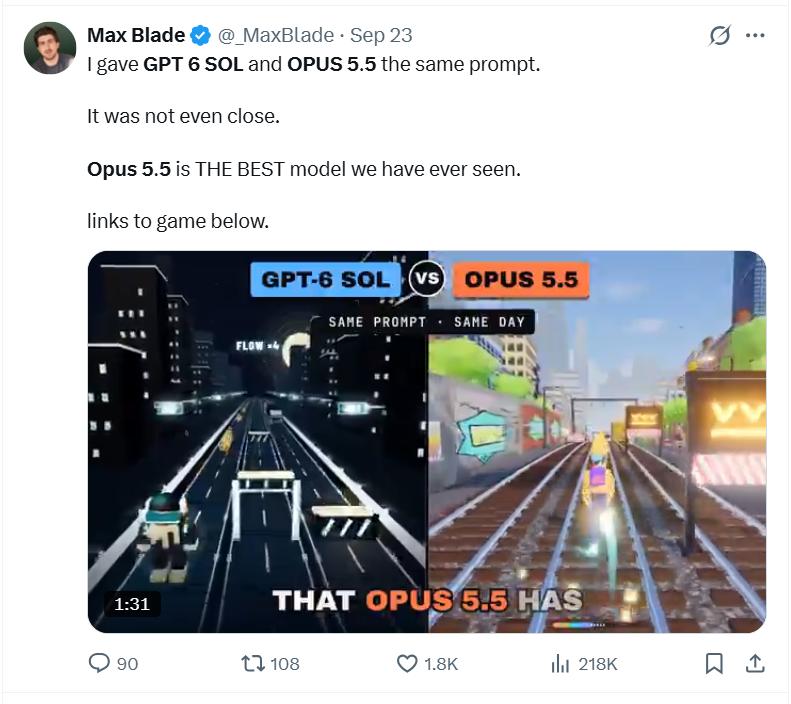
其他博主的反馈也类似,多数场景下都是 Opus 好得多。比如下方的游戏设计,Opus 的细节明显更丰富。
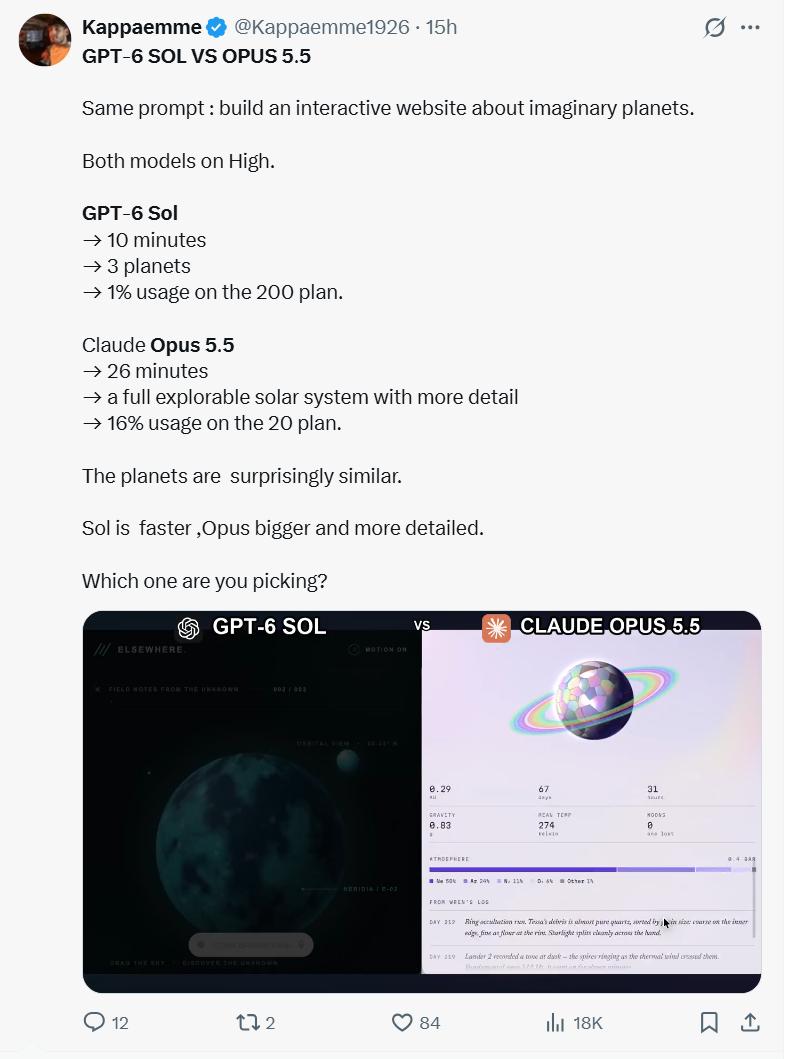
还有一个更直观的同题对比,“做一个想象行星的互动网站”,Sol 10 分钟做了 3 颗行星,200 美元档只耗 1 %。
Opus 26 分钟端出完整太阳系,20 美元档耗 16%。行星看起来差不多,区别是Sol 更快更省,Opus 更大更细。
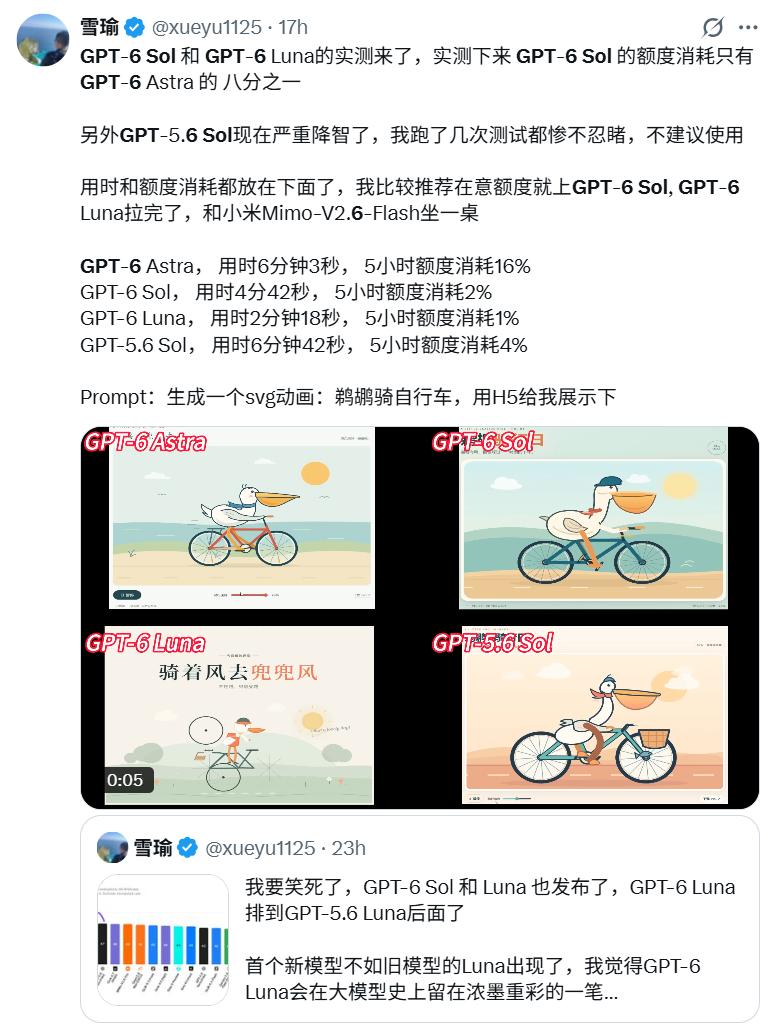
博主@雪瑜也做了一组额度实测:同一道“鹈鹕骑自行车”的 SVG 动画题,Sol 和 Luna 的额度消耗都明显低于 Astra,只是便宜终归是粗糙很多。
总的来说,同一天两大巨头都在卷“性价比”,对消费者来说总归是好事,选择变多了,试错成本也低了。
毕竟不是谁都需要顶级模型,但每个人都值得一个付得起的价格。
这场价格战,恐怕会越来越精彩。
参考资料:openAI官网、X等网络平台
本文来自微信公众号 “科技狐”(ID:kejihutv),作者:狐妹,36氪经授权发布。