Salesforce放大招:联手英伟达反攻Claude
在刚结束的 Dreamforce 大会上,Salesforce 发布了2个看起来自相矛盾的新产品:
一个与 Anthropic 联合推出的 Claudeforce,让客户可以在 Claude 中直接调用 Salesforce 完成任务。
另一个则是与英伟达联合推出的 Koa ——一个属于 Salesforce 自己的垂直模型。而这个模型的使命,就是在一部分任务上替换 Claude、OpenAI 等闭源模型。
第一个产品,是加强和 Claude 的合作;第二个产品,则是加强对 Claude 的替代。
首先简单介绍一下 Koa,它是基于英伟达开源权重模型 Nemotron 后训练而成。
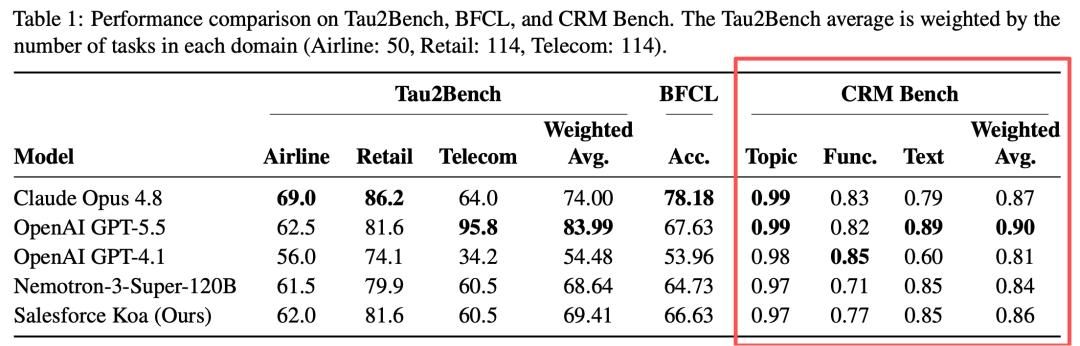
根据 Salesforce 的测评数据,在 Salesforce CRM 任务的处理上(CRM Bench),包括更新商机、安排后续跟进等任务,Koa 的表现(加权平均得分8.6)虽然不及 Claude Opus 4.8(得分8.7)和 OpenAI GPT-5.5(得分9.0),但是超过了 GPT-4.1(得分8.1)。
来源:Salesforce Koa
也就是说,虽然离顶尖模型还有一段距离,但是在一批边界明确、预先定义好的 CRM 工作流上,Koa 已经具备了较强的可用性。
另外,作为 Koa 的“零号客户”,Salesforce 在官网产品页宣称:在调用工具方面,Koa 提升了11%的精度;在上下文回忆方面,Koa 的可靠性提升了2.1倍;而在“长时间对话“中,Koa 对上下文的记忆能力提升了15%。
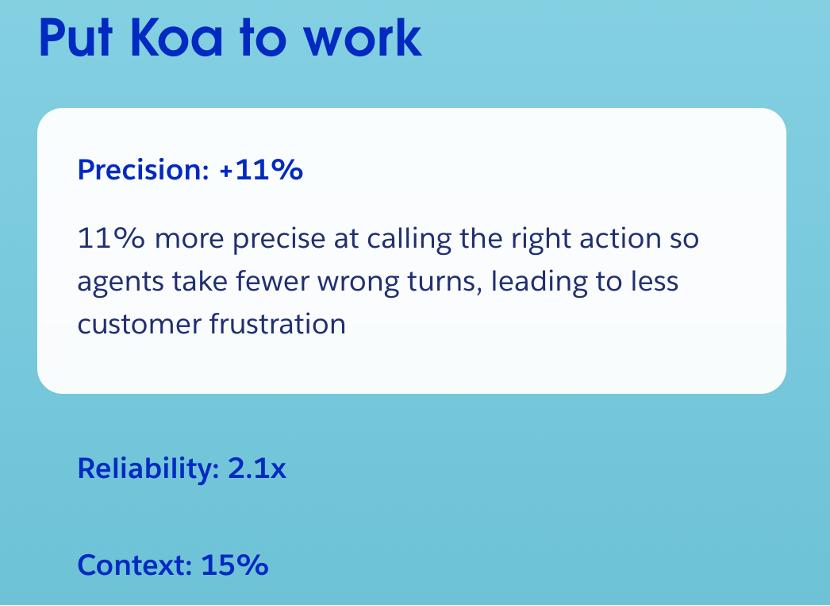
要知道,企业 AI 的特点,就是工具频繁调用,以及长上下文和多轮对话处理。Salesforce 的内部测试显示,Koa 已经具备了进入试点的能力。
一、Salesforce 为什么推出 Koa?
那 Salesforce 为什么要推出 Koa 呢?主要是3个原因。
首先是闭源模型的信任危机。
最近,智谱被爆出在后台偷偷打包用户的工作区文件并上传,智谱随后在客户群回应并致歉,宣称是系统 bug,目前已修复。但受害方(太原承明科技有限公司)并不买账:
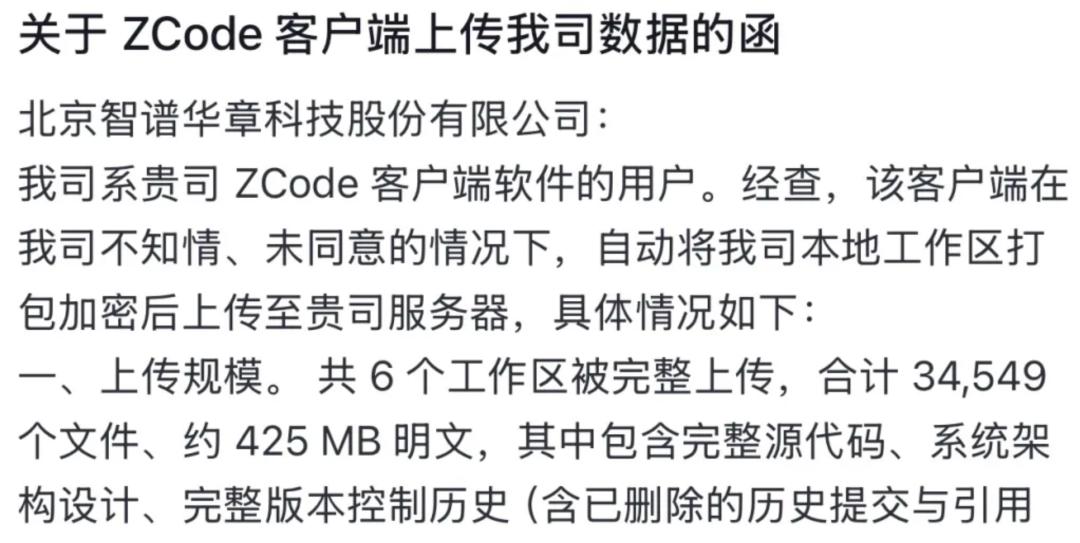
来源: 太原承明科技有限公司
是不是 bug 我们暂且不论,但是大模型厂商以后还会不会出现类似的情况,我想恐怕没人敢打包票。
而 Salesforce 推出自己的垂直大模型,意味着客户的一部分核心数据,不必再额外传送给第三方大模型服务商,自然就减少了一部分泄露的可能性。
你可能会说,那 Salesforce 会不会擅自使用客户的数据呢?
这里的一个关键点在于:Salesforce 研发 Koa 的方式,是通过后训练。
前沿大模型的预训练相当于从小学到博士的通用能力训练,需要万亿级的通用语料;而后训练相当于员工入职以后的工作培训,需要的是高质量、可验证的业务数据。
所以,Salesforce 平台与工程总裁 Rohan Kumar 在介绍 Koa 时明确表示:“没有使用哪怕一个字节的客户数据。” Salesforce 官方说明也强调,其训练语料完全由合成场景构成,模拟了 Agentforce 在 CRM 工作流中的推理、工具使用和决策过程,完全没有使用客户的原始数据。
从目前来看,Salesforce 的表态还是得到了客户的认可。比如,在 Koa 的首批试用客户中,就有 Baxter Credit Union(信用社)和 UChicago Medicine(医院)这类对数据安全高度敏感的客户。
Salesforce 推出 Koa 的第二个原因,是减少对前沿大模型的依赖。
一直以来,SaaS 公司都面临来自大模型厂商的威胁:大模型每进一步,SaaS 公司就要退一步。
但 Koa 证明,SaaS 公司同样有能力构建自己的垂直大模型。考虑到开源大模型的能力也在快速进步,基于开源的垂直大模型能力也会越来越强。
另外,前沿大模型是一项高毛利的生意,比如,Anthropic 就预计其毛利率在2026年将达到50%,到了2028年,更是将达到77%。
有了 Koa,Salesforce 有机会降低对外部模型的依赖,并为改善毛利率,以及向客户让利留下空间。
除了数据安全、减少对前沿大模型的依赖,我认为 Salesforce 推出 Koa 还有一个战略上的考量:那就是 SaaS 公司自身的 AI 转型。
随着大模型能力越来越强,一个致命危机也在慢慢浮现:那就是甲方可能会绕开软件公司,直接用大模型构建自己的 Agent 软件。
对了应对这个趋势,SaaS 公司必须问自己一个问题:如何成为甲方自研绕不开的一环?
而转型为一家垂直领域的大模型公司,成为甲方自研的基础设施,帮助甲方更高效、高质量的自研,恐怕是最好的选择。
二、Koa 背后的推手
Koa 的推出,背后最重要的推手就是英伟达。英伟达不仅提供了 Nemotron 开放权重模型,而且还提供了后训练工具链、工程协作等。
在这次 Salesforce 的 Dreamforce 大会上,英伟达 CEO 黄仁勋甚至亲自给 Koa 站台,他说:
开源模型的使用率从去年年初的30%增长到现在的70%左右。人们一方面以指数级速度采用闭源模型,另一方面也在构建自己的定制人工智能——因为每一家软件公司都是一家 AI 公司,每一家企业都将成为 AI 企业。”
黄仁勋
说白了就是告诉其他 SaaS 公司:快来找我合作,你们也可以像 Salesforce 一样,拥有自己的模型。
那英伟达就没有考虑过,这么做会得罪 Anthropic 等大客户吗?
这就涉及到英伟达的长期战略:企业主权 AI——即帮助每家企业都成为 AI 公司。
要知道,虽然 Anthropic 是英伟达的大客户,但世界上的 AI 实验室数量毕竟有限,和明显更庞大的企业市场相比,根本不值一提。
另外,Anthropic 等 AI 实验室也在积极"去 NVIDIA 化",比如:Anthropic 目前已有超过 100 万颗 AWS 的 Trainium2 芯片在运行 Claude 模型。另外,为了拿到亚马逊 330 亿美元投资,Anthropic 还承诺十年内在 AWS(Graviton/Trainium)花费超 1000 亿美元。
所以,没有永恒的朋友,也没有永恒的敌人,只有永恒的利益。
显然,帮助 Salesforce 这样的软件公司后训练垂直大模型,更符合英伟达的长期利益。
三、Koa 会不会成为行业趋势?
那么,后训练垂直大模型会不会成为行业趋势呢?我个人认为:会。
原因除了企业在数据安全、成本方面的考量,还有一个非常重要的原因,就是开源模型越来越强大。
虽然短时间内开源模型还无法超过顶尖闭源模型,但是结合后训练、Harness 工程,已经能够满足企业的大部分需求。
在这种情况下,软件公司和企业就很有动力采取“混合模型策略”——对于 CRM、HR 等高度专业、动作标准、上下文明确的任务,交给更便宜、更安全的垂直大模型;而开放式研究、复杂创作、跨领域推理等任务,仍然会调用 Claude、GPT 这样的前沿模型。
但是,这并不意味着黄仁勋口中的“企业主权 AI”时代会很快到来。这里面有2个非常关键的障碍。
首先是人才障碍。
能够做高质量后训练的人才,大部分都在顶尖 AI 实验室或者互联网大厂,很多软件公司都不具备这样的人才,更不要说传统企业。
另外就是性价比问题。
Salesforce 能后训练垂直大模型的前提,是拥有全球最大的 CRM 系统调用量。要知道,Salesforce Agentforce + Data 360 的单季度收入,已经接近39亿美元,如此大的收入体量,才能摊薄后训练的巨额成本。
但显然,大部分软件公司都没有如此大的 AI 收入体量。
不过,即便如此,长期来看,我仍然看好后训练垂直大模型成为趋势。
因为不管是人才问题,还是训练成本问题,随着市场需求的持续扩大,必然都会逐步缓解。
以移动互联网时代为例,iPhone 刚发布时,Salesforce 的贝里奥夫就意识到了一个新的时代正在来临。于是他迅速组建了移动端 SaaS 研发团队,然而一开始研发非常不顺利,核心原因就是缺乏 IOS 开发人员。
不过,没过几年,IOS 开发人才就大爆发,到今天,甚至已经出现了过剩的局面。
说白了,只要市场需求持续旺盛,供给自然就会加速扩大,价格自然就会降下来。特别是在中国,我们发愁的从来不是产能,而是市场需求。
当然了,即便垂直大模型普及,Claude 等前沿大模型也不会被全面替代,毕竟一些开放式、跨领域的复杂任务,前沿大模型的表现肯定会更好。
但是,一旦垂直大模型普及,企业软件行业的格局就会被彻底改变。
SaaS 公司本来就离客户更近,一旦他们掌握了垂直大模型,解决了卡脖子问题,AI 就会从一个巨大的威胁,转变为一个巨大的机会。
本文来自微信公众号“ToB老人家”,作者:王戴明,36氪经授权发布。