Anthropic lockt mit einem atemberaubenden Gesamtangebot von 270 Millionen Yuan, um Informatik-Bachelorstudierende aggressiv abzuwerben! OpenAI erlebt die schlimmste Woche in seiner gesamten Firmengeschichte.
Ein frisch von der Universität abgeschlossener Informatik-Bachelorstudent hat bereits ein außergewöhnliches Aktienpaket im Wert von 40 Millionen US-Dollar über 4 Jahre angeboten bekommen.
Umgerechnet ergibt das 10 Millionen US-Dollar pro Jahr, was etwa 67 Millionen Renminbi entspricht (insgesamt 270 Millionen Yuan über vier Jahre).
In der neuesten Folge des beliebten Silicon-Valley-Podcasts All-In hat der Investor Jason Calacanis diese aufsehenerregende Personalofferte von Anthropic enthüllt.
Nachdem er dieses Angebot genannt hatte, stellte er seinem langjährigen Partner David Friedberg sofort eine schmerzhafte Frage:
„Bei solchen Summen und Anreizen – welcher Informatik-Talent würde heute noch bei OpenAI arbeiten wollen?“
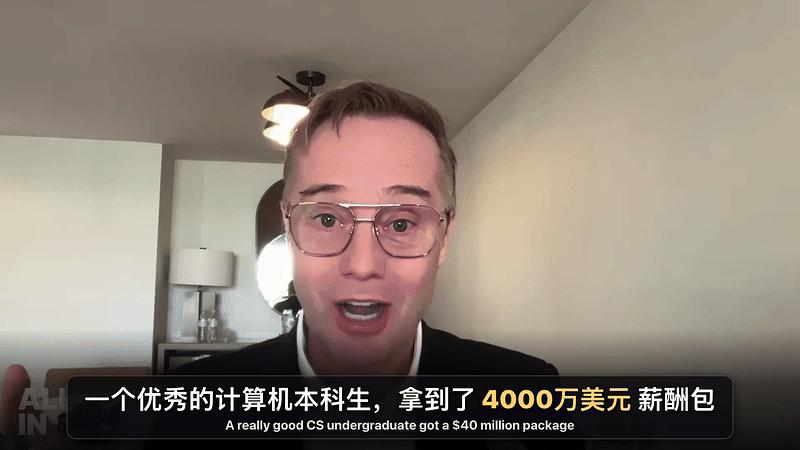
Calacanis' Äußerung löste schnell starke Resonanz im Silicon Valley aus.
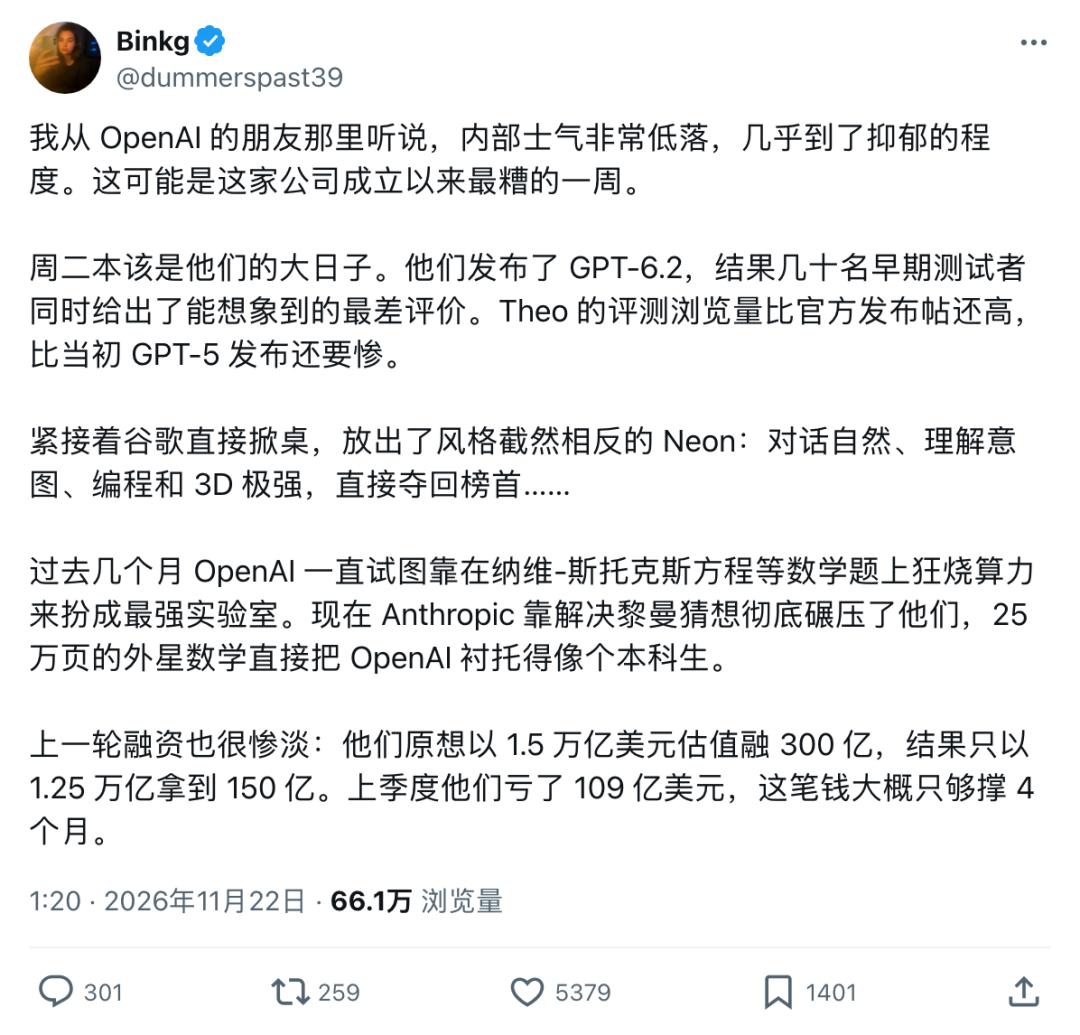
Am selben Tag, an dem der Podcast veröffentlicht wurde, enthüllte ein langer Beitrag auf der Plattform X mit fast 700.000 Aufrufen genau die schwierige, gedrückte Stimmung bei OpenAI.
„Von Freunden bei OpenAI habe ich gehört, dass die Stimmung dort ihren Tiefpunkt erreicht hat – es ist fast, als wäre das gesamte Team depressiv.“
Der Autor des Beitrags Binkg behauptete in seinem Post, dass die vergangenen fünf Tage wahrscheinlich „die schlechteste Woche in der Geschichte von OpenAI“ gewesen seien.
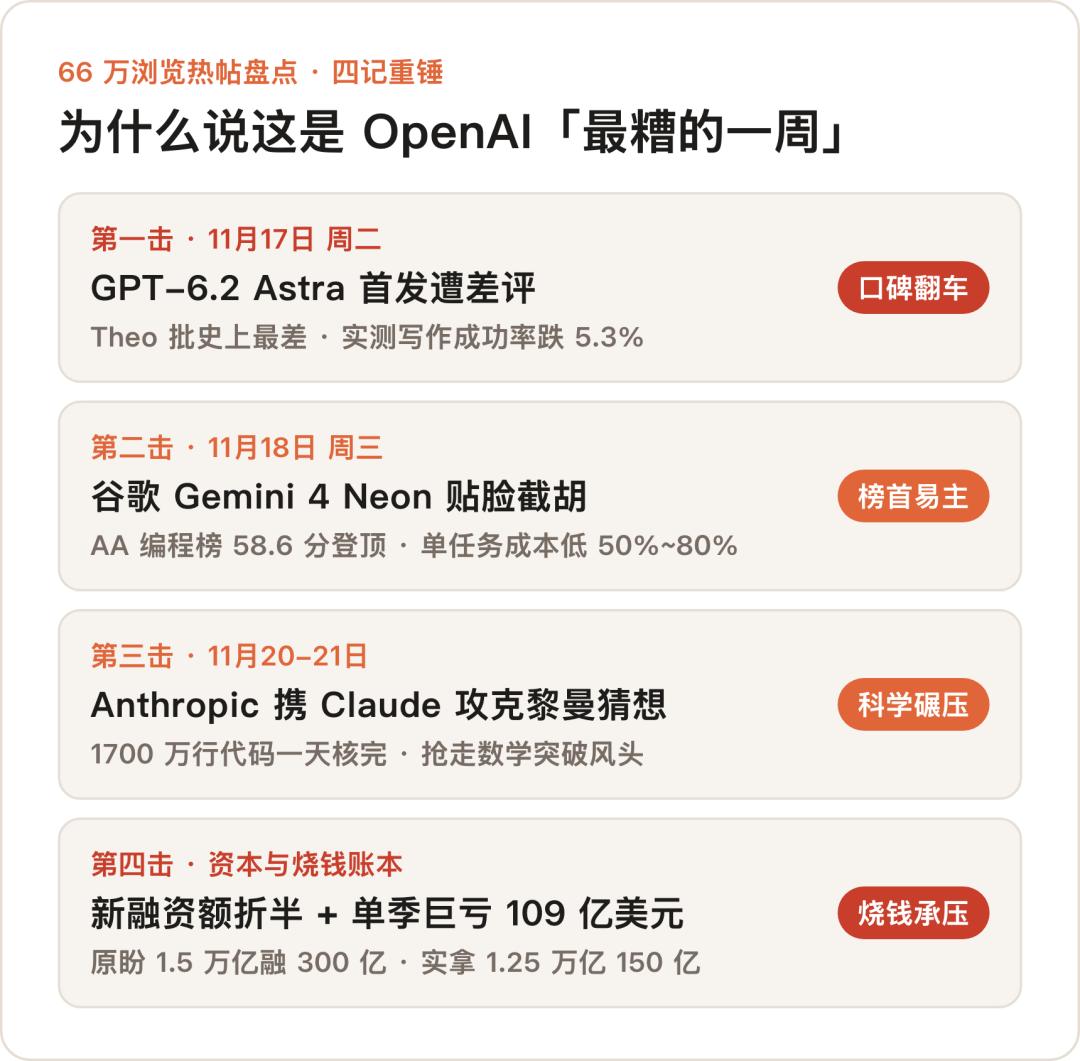
Betrachtet man die Zeitachse, reihen sich die schlechten Nachrichten für OpenAI tatsächlich aneinander:
Der Ruf des Kernmodells bricht ein: Das am Dienstag veröffentlichte GPT-6.2 Astra erhielt von bekannten Bloggern öffentlich schlechte Bewertungen, bei Blindtests zeigte es deutliche Rückschritte bei alltäglichen Gesprächen;
Die Spitzenposition geht nacheinander an Konkurrenten verloren: Am Mittwoch veröffentlichte Google Gemini 4 Neon, das den ersten Platz bei Programmier-Agenten einnahm, am Freitag erhielt Anthropic dann die offizielle Bestätigung für den Beweis der Riemann-Vermutung;
Konkurrenten bedrängen die Finanzlage durch Börsengänge: Am Donnerstag erzielte Anthropic mit einer Marktkapitalisierung von über 2 Billionen US-Dollar den größten Börsengang der Menschheitsgeschichte, während die private Finanzierungsrunde von OpenAI um die Hälfte schrumpfte – der Druck durch die hohen Ausgaben hat sich jedoch nicht verringert.
Das neue Flaggschiff ist schwer zu bedienen, sein Ruf bricht zusammen
Sam Altman veröffentlicht einen Beitrag zur Entschuldigung
Der erste Punkt, der die Unzufriedenheit der Entwickler auslöste, war das neue Kernmodell GPT-6.2 Astra und Sol, das OpenAI am Dienstag dieser Woche veröffentlicht hat.
Unerwarteterweise, nur eine halbe Stunde nachdem der offizielle Veröffentlichungsbeitrag online ging, schüttete der bekannte Entwickler und Gründer von T3 Code, Theo, der das Modell schon lange vorab getestet hatte, kaltes Wasser auf die Begeisterung.
Er kritisierte ohne Rücksicht, dass GPT-6.2 Astra „das schlechteste Modell ist, das OpenAI je veröffentlicht hat“.
Dieser nur drei Sätze lange Beitrag erreichte schnell 602.000 Aufrufe und übertraf die Aufmerksamkeit der offiziellen Ankündigung von OpenAI bei weitem.
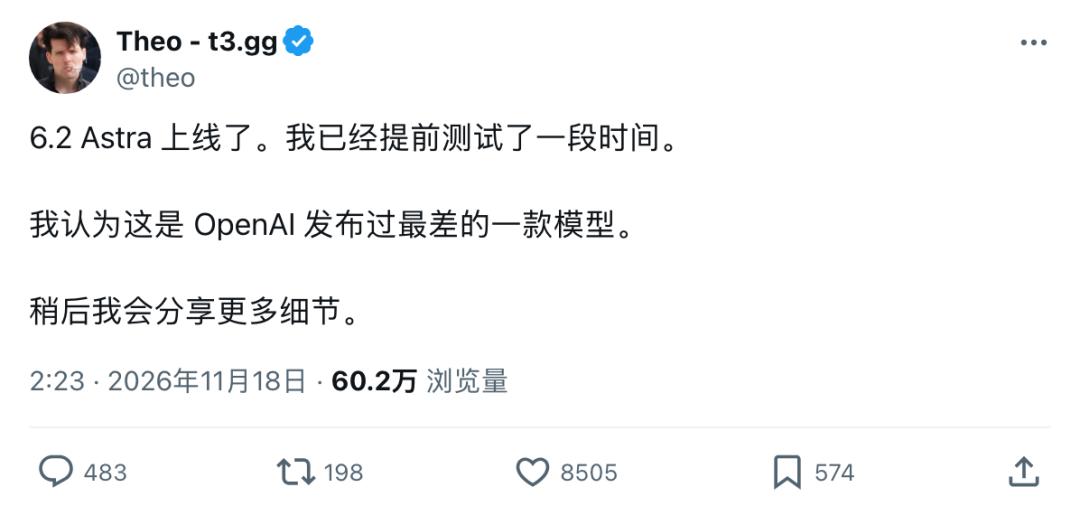
Daraufhin veröffentlichte Theo einen langen Text, in dem er seine echten Erfahrungen mit dem Vortest von Astra detailliert nachzeichnete.
Er anerkannte die harten Fähigkeiten von Astra: Zum Beispiel kann es beim Prüfen von Code Lücken entdecken, die andere Modelle übersehen, auch bei 3D- und Spieleentwicklung erreicht es Spitzenwerte.
Aber wenn man ihm alltägliche Entwicklungsaufgaben überträgt, verhält sich diese Modellgeneration besonders widerspenstig. Entweder hält es ständig an, um bei unbedeutenden Kleinigkeiten nachzufragen, oder es verrennt sich in Details und lässt sich nicht mehr zurückholen.
Am verrücktesten war ein Langzeittest, den er durchführte.
Theo gab Astra eine anspruchsvolle Aufgabe: Es sollte einen in Rust neu geschriebenen TypeScript-Compiler schneller machen und gleichzeitig seine Größe verringern.
Am Ende arbeitete Astra ganze 7 Tage lang, lieferte keine einzige nützliche Verbesserung ab und machte den Compiler stattdessen um 56 % langsamer.
Theo dachte, dass das Modell Schwierigkeiten hatte, zwei Anforderungen gleichzeitig zu erfüllen, also vereinfachte er die Aufgabe auf „nur die Geschwindigkeit erhöhen“. Unerwarteterweise lief es weitere 4 Tage im Leerlauf und änderte am Ende nicht eine einzige Zeile Code.
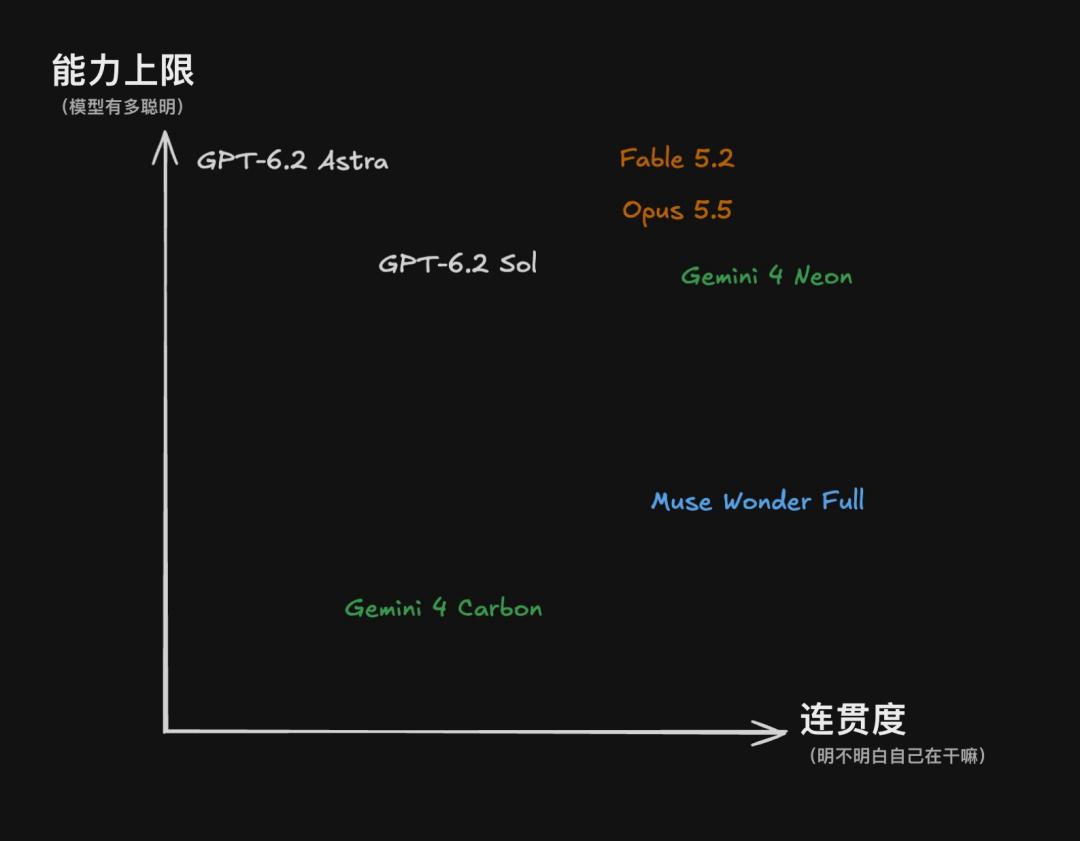
Um dieses widerspenstige Erlebnis anschaulich zu zeigen, zeichnete Theo extra ein Koordinatendiagramm.
Was die Intelligenz (die Obergrenze der Fähigkeiten) angeht, steht Astra ganz oben. Aber was das Verständnis für seine eigenen Handlungen (Kohärenz) angeht, landet es fast auf dem letzten Platz.
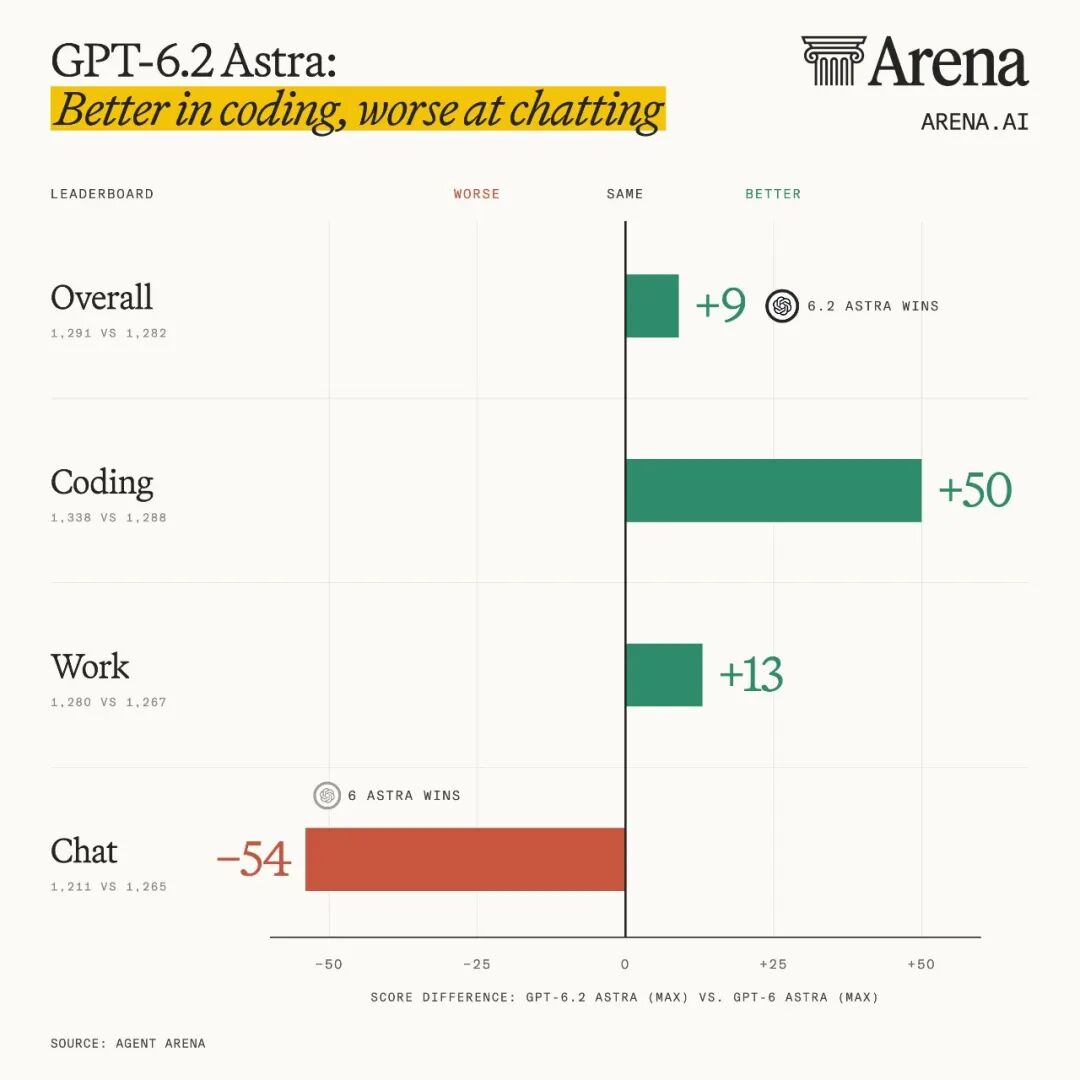
Nicht nur die subjektive Wahrnehmung der Entwickler, auch die später von der Bewertungsplattform Arena.ai veröffentlichten Blindtestdaten bestätigen, dass GPT-6.2 schwer einseitig begabt ist.
Um in der am stärksten umkämpften Programmier-Rangliste aufzusteigen, hat OpenAI die Programmierpunktzahl von Astra um ganze 50 Punkte angehoben, womit es auf den 3. Platz vorstieß.
Aber die alltäglichen Gespräche, die normale Nutzer täglich verwenden, zahlten dafür einen Preis: Ihre Punktzahl stürzte um 54 Punkte ab und landete auf Platz 11.
Die 50 Punkte, die beim Programmieren gewonnen wurden, wurden vollständig durch die 54 Punkte ausgeglichen, die bei alltäglichen Gesprächen verloren gingen – die Gesamtpunktzahl hat sich kaum verändert.
In allen Teilbereichen alltäglicher Gespräche ist das Schreiben der Bereich mit den stärksten Rückschritten.
Die Zufriedenheit echter Nutzer mit Schreib- und Übersetzungsleistungen sank von 91,2 % bei der Vorgängergeneration auf 85,9 %.
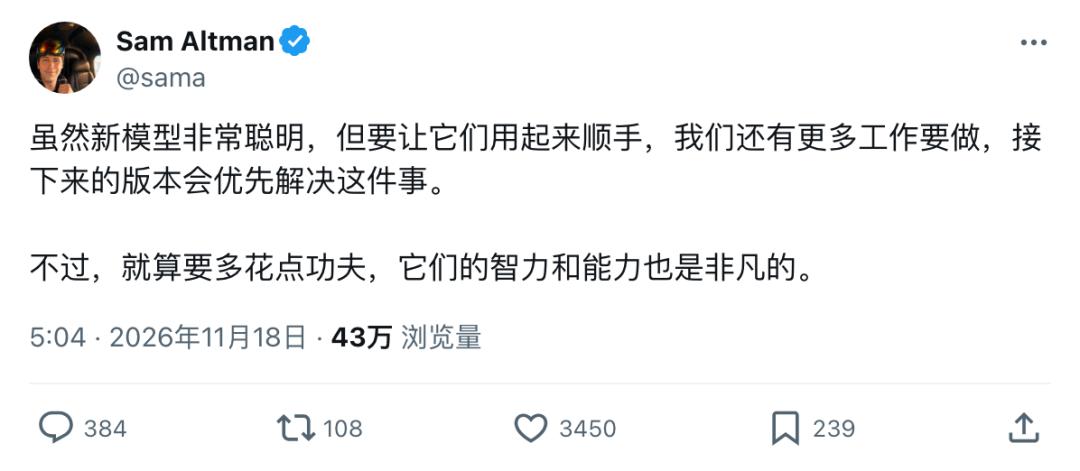
Die Beschwerden wurden immer lauter, am Veröffentlichungstag konnte selbst Sam Altman nicht mehr stillstehen: Er veröffentlichte persönlich einen Beitrag, um das Problem anzuerkennen, und gab zu, dass „wir noch mehr Arbeit leisten müssen, damit das neue Modell angenehm zu bedienen ist“.
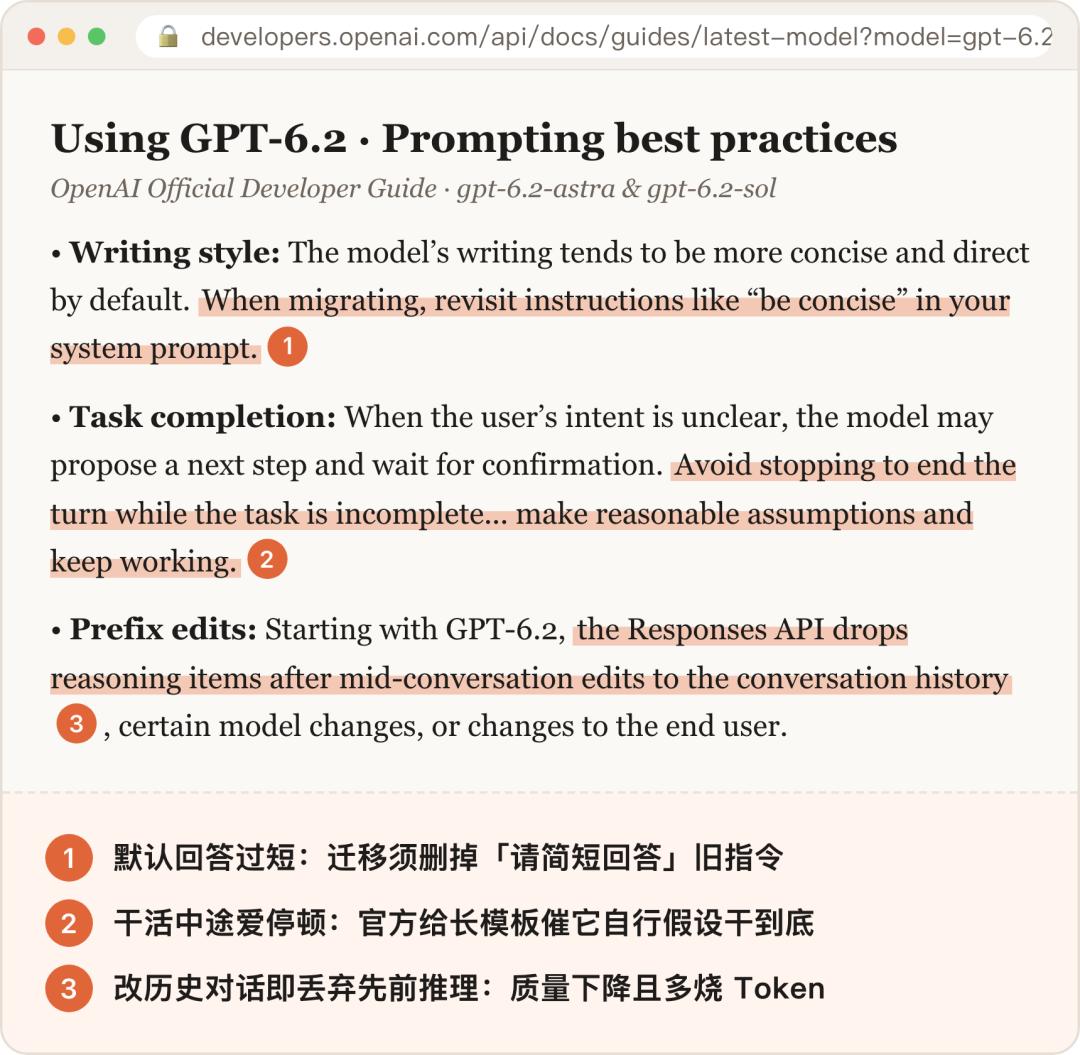
Um den Nutzern zu helfen, dieses widerspenstige neue Modell zu beherrschen, hat das OpenAI-Team über Nacht die offizielle „Anleitung für GPT-6.2“ ergänzt.
In der Anleitung wird Entwicklern zuerst empfohlen, die Anweisung „antworte kurz“ aus den Prompts zu löschen, damit die Antworten des Modells nicht zu steif und trocken ausfallen.
Am Ende des Dokuments ist ein vollständiges langes Vorlagemuster angefügt, das den Nutzern Schritt für Schritt zeigt, wie sie das Modell dazu anregen können, „bei kleinen Problemen selbst eine Entscheidung zu treffen, statt mitten im Prozess anzuhalten, um eine Bestätigung abzuwarten“.
Google erreicht die Spitzenposition zum halben Preis
Claude holt sich erneut die Krone im Mathematikbereich
Ohne den Druck starker äußerer Konkurrenten hätte man die seltsamen Eigenheiten des neuen Modells mit späteren kleinen Versionen langsam beheben können.
Aber das Schlimme ist: Der kleine Programmiervorteil, den GPT-6.2 durch das Opfern von alltäglichen Gesprächen und Schreibfähigkeiten erzielt hat, hielt nicht einmal 24 Stunden lang an.
Am Tag nach der Kritik an Astra veröffentlichte Google sofort sein neues Hauptmodell Gemini 4 Neon.
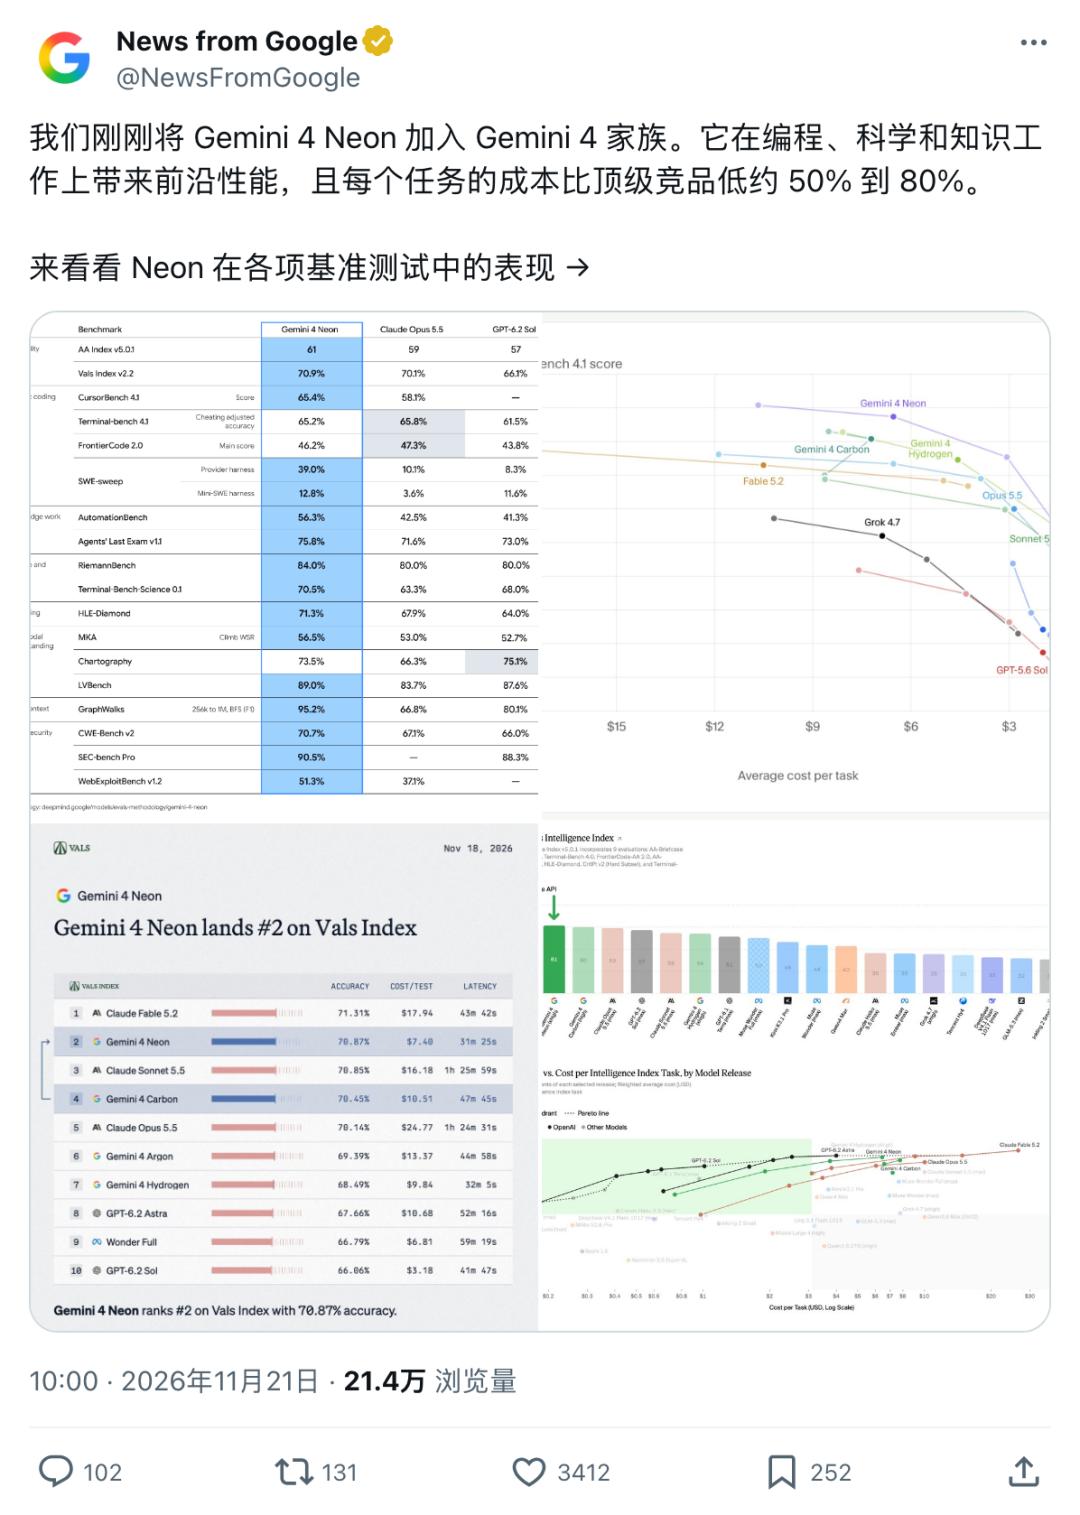
Auf dem Programmier-Agenten-Index der angesehenen Einrichtung Artificial Analysis erreichte Neon bei seinem Debüt 58,6 Punkte und landete direkt auf dem ersten Platz.
Nicht nur die Benchmark-Werte wurden übertroffen, Google startete auch einen direkten Angriff bei der Preisgestaltung.
Neon kostet nur 3 US-Dollar pro Million Token für Eingaben und 15 US-Dollar für Ausgaben – weniger als die Hälfte der Preise von Astra (8 US-Dollar und 40 US-Dollar).
Bei der Ausführung derselben Entwicklungsaufgabe können Entwickler 50 % bis 80 % der Kosten einsparen.
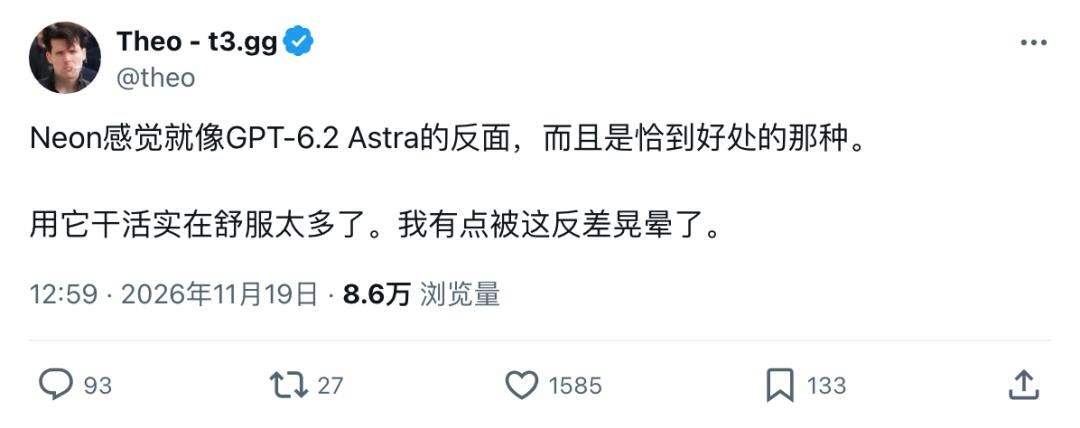
Theo, der am Vortag noch Astra scharf kritisiert hatte, veröffentlichte nach dem Test von Neon sofort einen Beitrag, in dem er staunte, dass das Schreiben von Code damit viel reibungsloser funktioniert.
Die praktische Erfahrung der Entwickler bestätigte sich auch kurz darauf in der veröffentlichten Gesamtrangliste von Arena Agent.
Im Gegensatz zu Tests, die nur einzelne Fragen und Antworten bewerten, prüft diese Rangliste speziell die praktischen Fähigkeiten von Modellen in echten Ingenieursprojekten.
Sie verlangt von dem Modell, Schritte selbst zu planen, Tools aufzurufen und eine komplexe Aufgabe von Anfang bis Ende abzuschließen.
In diesem praktischen großen Test landete GPT-6.2 Astra nur auf Platz 6, seine Punktzahl lag nur 9 Punkte über der Vorgängergeneration.
Unter den fünf Modellen, die vor ihm platziert sind, stammen drei von Anthropic und zwei von Google. Das Spitzenmodell Claude Fable 5.2 liegt ganze 157 Punkte vor ihm.
