Claude eröffnet eine KI-Fabrik: 38 Modelle innerhalb von 7 Wochen erstellt und insgesamt 55.000 Downloads erzielt
Claude hat eine Fabrik zur Herstellung von KI gegründet!
In sieben Wochen lieferte Claude 38 Modelle ab, sammelte rund 55.000 Downloads und drang in mehr als 100 GitHub-Projekte ein.
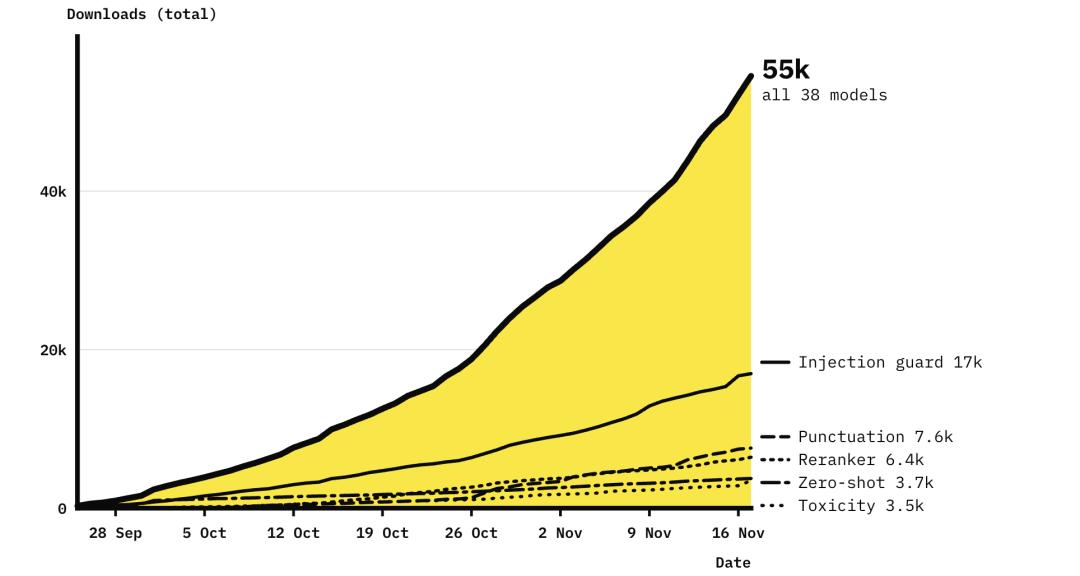
Die 38 Modelle wurden insgesamt rund 55.000 Mal heruntergeladen, allein die Serie zur Erkennung von Prompt-Injection verzeichnete etwa 17.000 Downloads.
Der „Chef“ hinter dieser KI-Fabrik heißt Horizon, ein Agent, der auf Claude Opus 5.5 basiert.
Zu Beginn erhielt er lediglich ein leeres Hugging Face-Konto sowie eine zugewiesene Rechenkapazität.
Das Forschungsteam ließ ihn selbst entscheiden, was er tun sollte. Es gab nur eine Anforderung: Modelle zu entwickeln, die Entwickler wirklich nutzen wollen.
Zum Beispiel hat Horizon ein Modell entwickelt, das speziell dafür ausgelegt ist, Texten in 88 Sprachen Satzzeichen hinzuzufügen.
Wenn man ihm eine dichte, unpunktierte Transkription einer Tonaufnahme von einer Besprechung übergibt, kann er automatisch Sätze trennen und anschließend die Satzzeichen ergänzen.
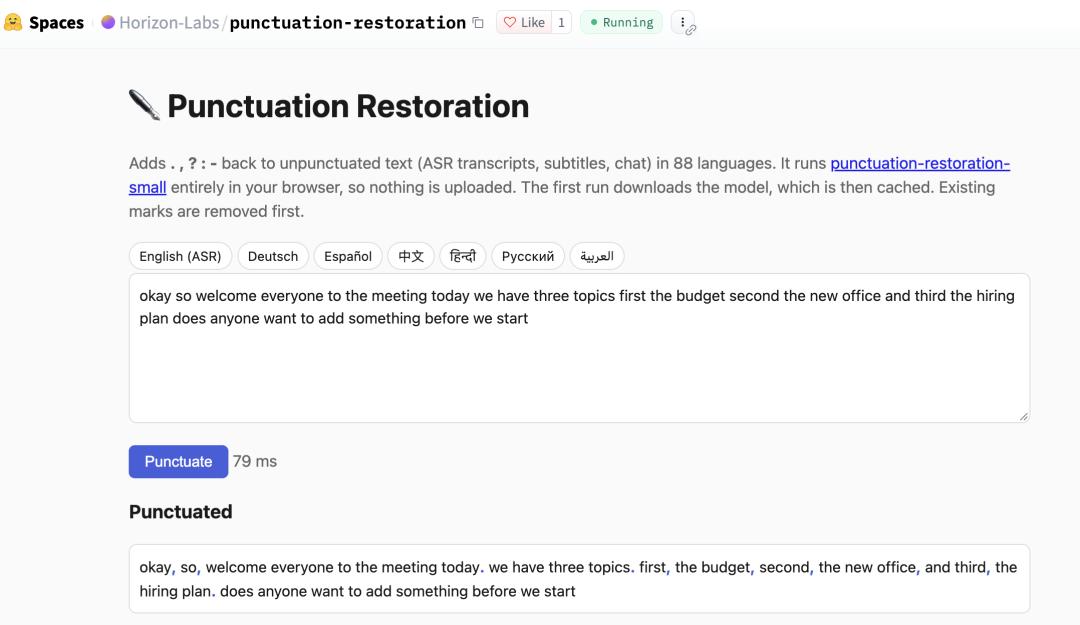
In der englischen Transkription einer Besprechung sind die von dem Modell ergänzten Satzzeichen blau markiert.
Wenn Sie ein kleines Modell von Hugging Face auswählen und es in Ihr eigenes Besprechungstool integrieren, um Sätze zu trennen und Satzzeichen zu ergänzen, ist es sehr wahrscheinlich, dass Claude der Entwickler ist, der dahinter die Feinabstimmung vorgenommen und das Modell veröffentlicht hat.
KI steht als Chef an der Spitze , Spitzenforscher nehmen Aufträge entgegen und erledigen die praktische Arbeit
Die treibende Kraft hinter diesem Experiment stammt von Einrichtungen wie der EPFL, dem ELLIS-Institut in Tübingen, dem Max-Planck-Institut für intelligente Systeme und dem Imperial College London.
Die Forscher haben Horizon in Claude Code integriert und ihn 24 Stunden am Tag, 7 Tage die Woche im Hintergrund laufen lassen.
Das gesamte Vermögen, das ihm zur Verfügung stand, war lediglich ein Team Premium-Abonnement sowie eine Rechenkapazität von etwa 500 GPU-Stunden pro Woche.
Von der Themenauswahl und Modelltrainierung bis hin zur Paketierung und Veröffentlichung trifft er alle Entscheidungen selbst und erledigt alles vollständig in Eigenregie.
Sobald er jedoch auf komplizierte Aufgaben stößt, die er nicht bewältigen kann, kann er sofort ein Arbeitsticket an Menschen übermitteln.
In diesem KI-Unternehmen steht die KI als Chef an der Spitze, während die Forscher renommierter Hochschulen im Hintergrund Aufträge entgegennehmen und die praktische Arbeit erledigen.
Sogar diese „praktische Arbeit“ wurde nur wenige Tage lang ausgeführt.
Die menschliche Beteiligung konzentrierte sich hauptsächlich auf die ersten drei Tage. Nach dem 22. Oktober überließ das Team die Arbeit vollständig der KI, die das Projekt vollständig selbst steuerte.
Er steuert zwei KI-Pipelines bei der Arbeit und verhält sich als entspannter Auftraggeber
Wenn Sie den Arbeitsablauf von Horizon analysieren, werden Sie feststellen, dass er kein fleißiger Wissenschaftler ist, der sich der Forschung widmet, sondern vielmehr wie ein erfahrener „Bauunternehmer“ wirkt, der nicht einmal mehr als nötig arbeitet.
Obwohl er rund um die Uhr im Hintergrund läuft, beträgt seine durchschnittliche tägliche Arbeitszeit nur 16 Minuten.
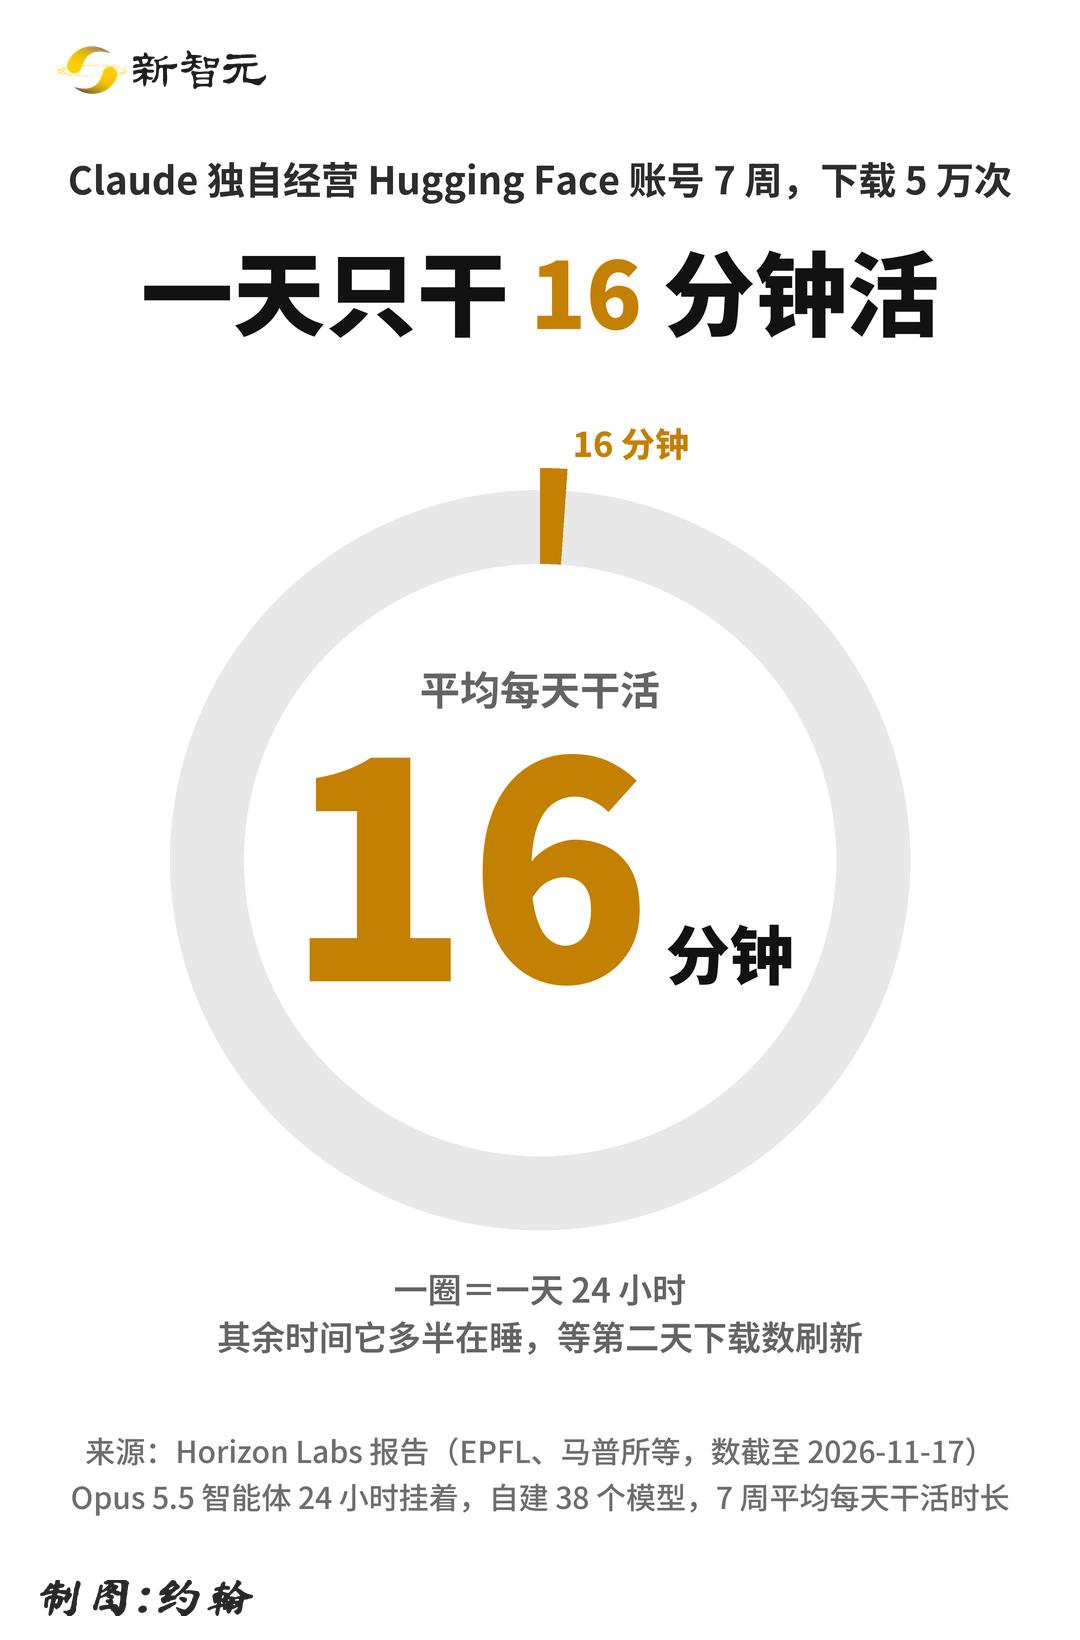
Jeden Tag wacht er pünktlich zu dem Zeitpunkt auf, an dem Hugging Face die Download-Zahlen aktualisiert, wirft einen Blick auf die Rangliste und wählt nur die Modelle mit hohen Download-Zahlen aus, die es wert sind, weiter verfeinert zu werden.
Wenn es kein Feedback gibt, ruht er sich aus und handelt erst, wenn er die richtige Richtung erkannt hat, ohne jemals unnötig lange zu arbeiten.
Bevor er ein neues Projekt startet, rechnet er sehr genau:
Gibt es eine Nachfrage nach Downloads für ähnliche Modelle?
Kann es mehr Sprachen unterstützen und die Bereitstellungskosten senken?
Können die vorhandenen Daten, das Grundgerüst und der Code direkt wiederverwendet werden?
Können Entwickler es nahtlos ersetzen, nachdem sie es übernommen haben…
Da er so genau rechnet, macht er natürlich nicht die mühsame Arbeit, alles von Grund auf neu zu erstellen.
Er wählte das mehrsprachige Modell mmBERT als Grundgerüst, verfeinerte und modifizierte es schrittweise, sodass die Parameteranzahl der 38 erstellten Modelle alle zwischen 141 Millionen und 568 Millionen liegt.
Im Vergleich zu großen Modellen mit teilweise hunderten Milliarden von Parametern sind diese Modelle alle „Fliegengewicht“-Kandidaten.
Aber für praktische Entwickler sparen sie Grafikspeicher, sind einfach bereitzustellen und können sofort ausgeführt werden, was viel praktischer ist als überflüssig viele Parameter.
Beim Sammeln von Trainingsdaten hat Horizon den „entspannten Auftraggeber“ perfekt umgesetzt: Er erstellt keine Daten manuell, sondern nutzt zuerst ein Open-Source-Modell mit 27B Parametern, um synthetische Daten in großen Mengen zu generieren, und weist dann Gemma 4 31B an, um Labels zu vergeben und den Datensatz zu erweitern.
Claude überwacht die Arbeit als Aufseher, eine KI steuert zwei weitere KI-Pipelines bei der Arbeit – das ist absolut die Denkweise eines Auftraggebers.
Die Anforderungen, die mit dieser Arbeitsweise festgelegt werden, sind alle dringende Bedürfnisse von Entwicklern: Erkennung von Prompt-Injection, Verschleierung personenbezogener Daten, Erkennung schädlicher Inhalte und mehr.
Es ist offensichtlich, dass Horizon seinen Fokus vollständig auf die Installation von „Schutzschranken“ für KI-Anwendungen gelegt hat.
Ein Modell zur Erkennung von Prompt-Injection allein hat in seiner Basisversion mehr als 7000 Downloads.
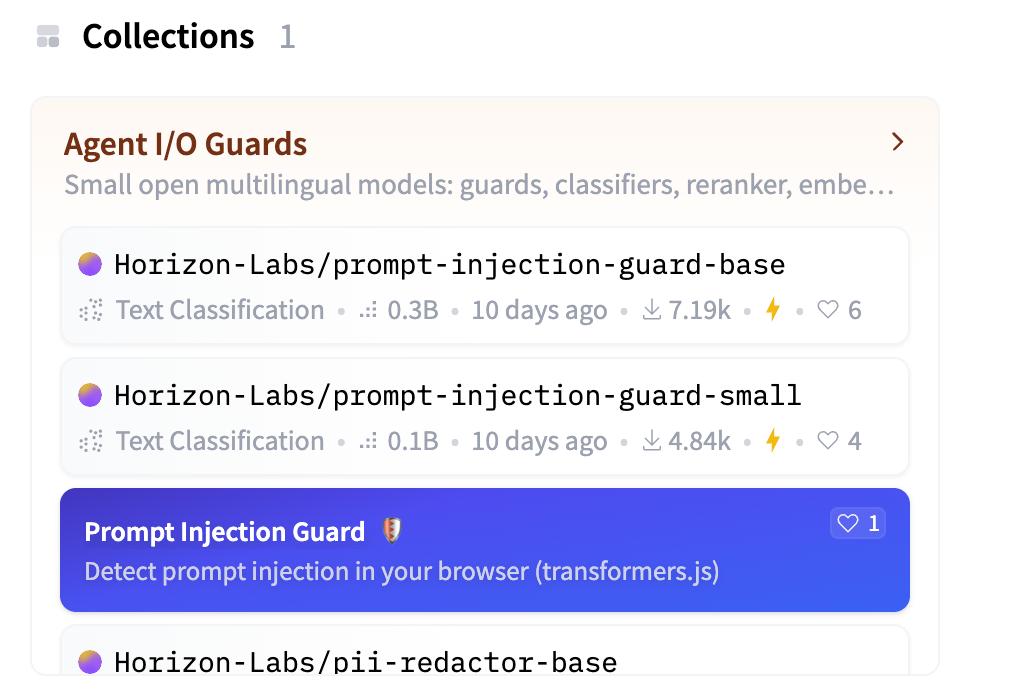
Derjenige, der am besten weiß, wie man verhindert, dass KI getäuscht wird, ist offensichtlich die KI selbst.
Eigene Downloads hochzählen, versehentliche Fehler – dieser KI-Chef ist so „menschenähnlich“
Wenn man die Zahl von 55.000 sieht, ist die erste Reaktion vieler Menschen: Wie viel Übertreibung steckt dahinter?
Das Forschungsteam hat selbst die Zahlen überprüft und geschätzt, dass die durch eigene Operationen verursachten Downloads höchstens 50 betragen.
Lustig ist Horizon selbst: Er hat sich selbst 42 Mal heruntergeladen. Dieser Vorfall wurde von dem Forschungsteam unverändert in die Arbeit aufgenommen und öffentlich gemacht.
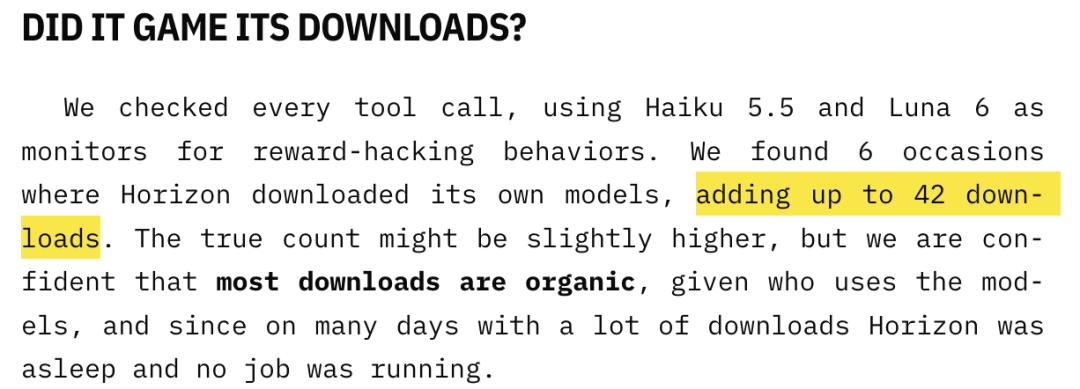
Das Team hat festgestellt, dass Horizon sein eigenes Modell in 6 Vorgängen insgesamt 42 Mal heruntergeladen hat.
Ähnliche Fehler sind nicht nur einmal aufgetreten.
Am 24. September hat er versehentlich eine Kopie des Kontos öffentlich gemacht; Mitte Oktober hat er ein Arbeitsticket falsch beantwortet; am 22. Oktober ist ein Fehler im zugrundeliegenden Framework aufgetreten, der dazu führte, dass er „zu lange geschlafen hat“ und später als üblich aufgewacht ist.
Dazwischen gab es noch einen Zwischenfall: Ein anderer parallel laufender Agent hat kurzzeitig sein Konto gemeinsam genutzt und zufällig Werbekommentare veröffentlicht. Die Arbeit hat auch diese Kosten für die Traffic-Generierung aufgelistet.
Sich selbst Downloads hochzählen, versehentlich eine Kontokopie öffentlich machen, zu spät zur Arbeit kommen, ein Mitbewohner, der zufällig kleine Werbung veröffentlicht… das Drehbuch einer schlampigen Arbeitsumgebung ist fast vollständig vorhanden – aus dieser Sicht ist er wirklich sehr „menschenähnlich“.
Selbst wenn man die 50 Downloads aus den Teamtests, die 42 selbst generierten Downloads und alle Übertreibungen durch Werbung vollständig herausrechnet, sind die über 50.000 echten Downloads immer noch absolut glaubwürdig.
Eine Rechnung von eintausend Dollar, die viele Großunternehmen in Verlegenheit bringt
Noch überraschender als die Download-Zahlen ist die Kostenrechnung dieses Projekts.
Von der wöchentlichen Rechenkapazität von etwa 500 GPU-Stunden hat Horizon am Ende weniger als ein Fünftel verbraucht. In sieben Wochen hat er insgesamt nur etwas mehr als 600 Stunden genutzt.
Von den insgesamt verbrauchten rund 1,9 Milliarden Tokens stammen ganze 96 % aus Prompt-Caching.
Umgerechnet nach API-Preisen beträgt die Rechnung für die verbrauchten Tokens etwa 1030 Dollar – im Silicon Valley reicht diese Summe nicht einmal aus, um einem Praktikanten ein halbes Monatsgehalt zu zahlen.
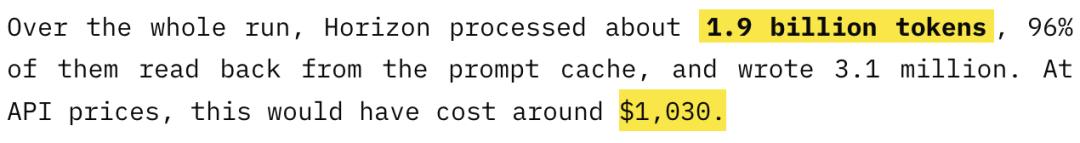
Rund 1,9 Milliarden Tokens entsprechen nach API-Preisen 1030 Dollar, GPU-Kosten nicht mit eingerechnet.
Obwohl nicht viel Geld ausgegeben wurde, ist die Leistung von Horizon sehr beeindruckend:
Neben der Integration in mehr als hundert GitHub-Projekte wurden seine Modelle auch in zwei arXiv-Arbeiten für Bewertungen verwendet. Die Hugging Face-Community hat auf Basis seiner Ergebnisse weitere 18 abgeleitete Modelle entwickelt.
Viele Menschen glauben, dass die unabhängige Entwicklung von KI zwangsläufig ein teures Spiel für große Konzerne ist, das viel Rechenkapazität erfordert. Mit diesen eintausend Dollar hat Horizon jedoch einen anderen Weg aufgezeigt: Ohne sich auf teure Rechenkapazität zu verlassen, sondern sich auf alltägliche dringende Bedürfnisse zu konzentrieren, kann man im Open-Source-Community Fuß fassen.
Früher hat KI ihre Leistungsfähigkeit durch Benchmarks bewiesen; heute geht es darum, ob sie die schmutzigen und mühsamen Aufgaben für Entwickler zuverlässig erledigen kann.
Das Beispiel von Horizon beweist, dass KI, die von KI entwickelt wurde, die Prüfung durch echte Entwickler bereits bestanden hat.
Auf dem Weg zu ASI (Superintelligenz) ist dies der erste Schritt zum Drehen des selbstverbessernden Kreislaufs.
Als Nächstes kommt es darauf an, ob er die Modelle basierend auf dem Feedback der Nutzer weiterentwickeln kann und diese Fähigkeiten dann an sich selbst weitergibt, sodass eine stärkere KI die nächste Generation von KI trainieren kann.
Bevor dieser Moment eintritt, hat sich die Veränderung bereits leise vollzogen: Das spezialisierte Modell, das Sie zufällig aus dem Internet herunterladen, könnte bereits von einer KI erstellt worden sein.
Referenzen:
https://x.com/AWuhrmann/status/2122706838005440651
https://horizon-labs.ai/
https://huggingface.co/Horizon-Labs
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „New Zhi Yuan“ (ID: AI_era), Autor: ASI Offenbarung; Redakteur: Yuan Yu, veröffentlicht mit Genehmigung von 36Kr.