In China hergestellte Chips bereiten sich auf den Dreisprung vor
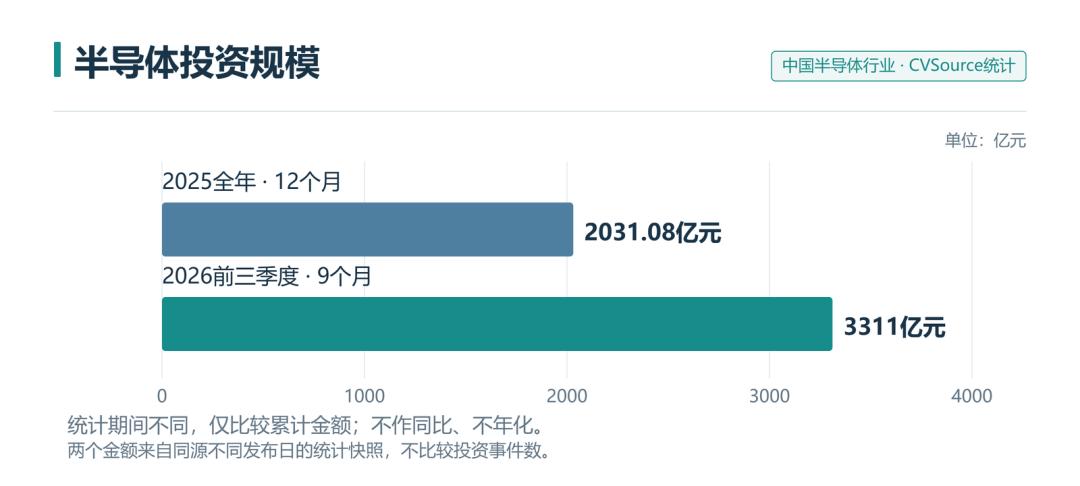
In den ersten drei Quartalen dieses Jahres haben die Investitionen in die inländische Halbleiterindustrie bereits das gesamte Niveau des Vorjahres überschritten. Laut Statistiken von CVSource von Touzhongjiachuan belief sich der Betrag auf 331,1 Milliarden Yuan, es gab insgesamt 1475 Investitionsereignisse. Im November werden noch neue Finanzierungsrunden von Rechenchip-Unternehmen offengelegt.
Die Produkte, auf die das Kapital zu warten bereit ist, haben bereits ein völlig anderes Erscheinungsbild angenommen. Einige Chips wurden bereits in die Serverräume der Kunden geliefert, und die neuen Mittel werden zur Vorbereitung der nächsten Generation verwendet. Andere haben gerade Musterchips aus der Fabrik erhalten und müssen noch Tests sowie Anpassungen an Gesamtsystemen durchlaufen. Finanzierungsnachrichten stellen diese Unternehmen auf dieselbe Liste, während die Beschaffung durch Kunden nach einer völlig anderen Reihenfolge abläuft.
Der dreistufige Sprung, den inländische Chips vorbereiten, verbirgt sich genau in dieser Lücke: Die Investitionen werden zuerst in nutzbare Produkte umgewandelt, dann zu einer kontinuierlich iterierbaren Versorgung aufgebaut und schließlich die Art und Weise verändert, wie Kunden Bestellungen verteilen. Derzeit befinden sich die verschiedenen Unternehmen an unterschiedlichen Positionen. Während eine Reihe neuer Produkte noch um den ersten großtechnischen Markt kämpfen, haben ChangXin Memory Technologies und Yangtze Memory Technologies den Wettbewerb bereits auf die Erneuerung von Herstellungsverfahren und Produktportfolios vorangetrieben. Noch bemerkenswerter ist, dass die immer stärkere Position von NVIDIA unterschiedliche Auswirkungen auf inländische Beschleuniger- und Speicherhersteller hat: Erstere sehen sich höheren Austauschschwellen gegenüber, während Letztere möglicherweise zusätzliche Nachfrage aus expandierenden Rechensystemen gewinnen können.
Fast 100.000 Chips verkauft – die nächste Generation muss neue Hürden überwinden
Anfang November schloss Lingchuan Technology eine Serie-B-Finanzierung über 1 Milliarde Yuan ab. Laut den von dem Investor Qiming Venture Partners offengelegten Informationen wurden die intelligenten Videochips des Modells SL200 insgesamt fast 100.000 Mal verkauft, zu den Kunden gehören Kuaishou, Alibaba Cloud und Baidu Cloud. Der nächste Chip für die KI-Videoproduktion wurde im April dieses Jahres als Prototyp hergestellt und kürzlich zurückgeliefert, das Ziel für den Massenversand ist für 2027 vorgesehen.
Im selben Unternehmen liegt zwischen den bereits verkauften Chips und den neu zu gewinnenden Geschäften noch eine weitere Produktentwicklungsphase. Die Verarbeitung traditioneller Videos und die Generierung von KI-Videos verbrauchen unterschiedliche Rechenressourcen. Eine hocheffiziente Videokodierung führt nicht automatisch zu den Berechnungen, die für Generierungsmodelle erforderlich sind. Dafür hat Lingchuan ein 3D-Stapellösung eingeführt, eine einheitliche Rechenplattform entwickelt und sie an Modelle wie Tongyi Wanxiang und Hunyuan Video angepasst. Die Kundenbeziehungen aus alten Produkten können neuen Produkten helfen, mit echten Geschäftsabläufen in Kontakt zu treten; die neue Generation von Chips muss in diesen Abläufen Leistung und Kosten erneut unter Beweis stellen.
Nach Erhalt der Musterchips müssen die Chips noch Tests, Softwareanpassungen und Vorbereitungen für die Massenproduktion durchlaufen, bevor sie zu Produkten werden, die von Kunden bereitgestellt werden können. Die neuen Mittel decken diese Investitionen vor der Auslieferung und ermöglichen es den Unternehmen, neben der Pflege bestehender Geschäfte die nächste Generation weiterzuentwickeln. Speicherhersteller zeigen diesen kontinuierlichen Wettbewerb noch deutlicher: Produkte müssen erneuert werden, Herstellungsverfahren müssen voranschreiten, schnellere Schnittstellen und größere Kapazitäten müssen schließlich auf Kosten fallen, die für Kunden tragbar sind.
Inländische Speicherhersteller kämpfen um Bestellungen für Flaggschiff-Smartphones und Server
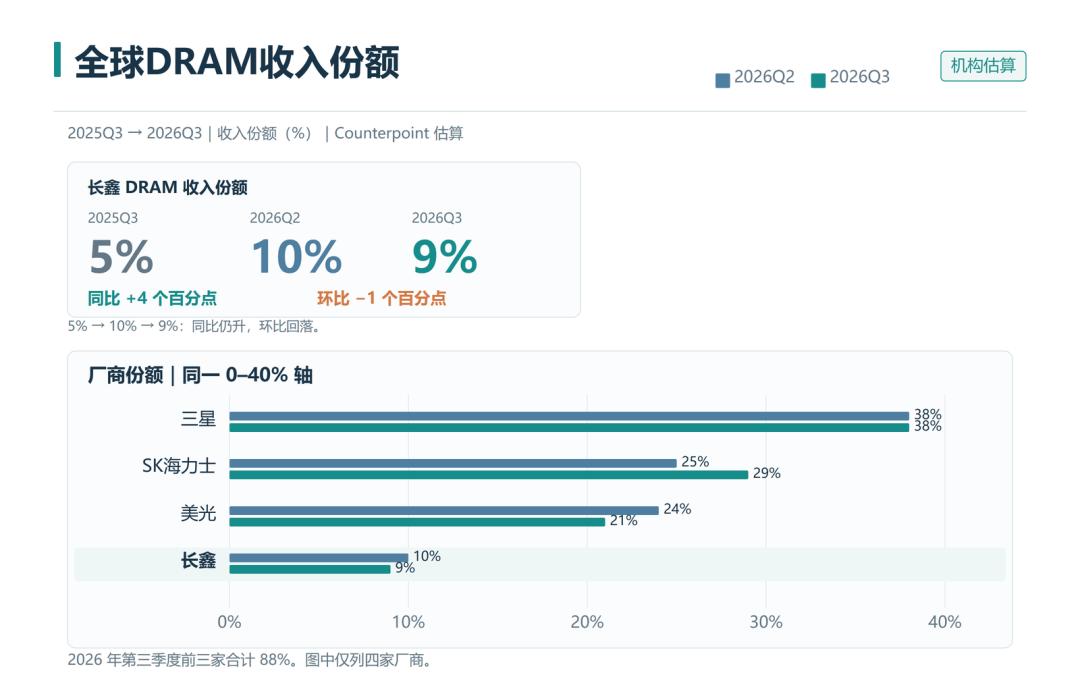
Die Veränderungen bei ChangXin zeigen sich bereits in der Einnahmeverteilung auf dem globalen Speichermarkt. Daten, die Counterpoint am 5. November veröffentlicht hat, zeigen, dass der Umsatzanteil von ChangXin bei DRAM im dritten Quartal dieses Jahres 9 % betrug – ein Rückgang um 1 Prozentpunkt gegenüber 10 % im zweiten Quartal, aber immer noch 4 Prozentpunkte höher als 5 % im dritten Quartal des Vorjahres. Samsung, SK Hynix und Micron machen zusammen 88 % aus, die drei großen Hersteller dominieren den Markt weiterhin, aber die Beschaffung durch Kunden hat bereits einen neuen Teilnehmer mit fast einem Zehntel des Umsatzes aufgenommen.
Im September dieses Jahres kündigte ChangXin die Massenproduktion der fünften Generation von DRAM-Technologieplattformen G5 an und stellte gleichzeitig LPDDR5X-Produkte mit einer Einzelkapazität von 24 Gb vor. Die Miniaturisierung von Speicherchips zielt letztendlich darauf ab, zu beantworten, wie viel Speicherkapazität auf einem Wafer untergebracht werden kann. Umgerechnet auf den einheitlichen Standard von 8-Gb-Partikeln gab ChangXin an, dass die Anzahl der Dies pro Wafer bei G5 mindestens um 50 % höher ist als bei G4. Bei gleicher Waferfläche kann mehr Speicherkapazität untergebracht werden, sodass die Investitionen in Fabriken und Geräte auf mehr Produkte verteilt werden können. Die tatsächlichen Kosten hängen noch von Verarbeitungsschritten, Ausbeute und Auslastung der Produktionslinie ab, aber die Erhöhung der Dichte schafft Raum für Kostensenkungen.
Das erklärt auch, warum die Verfolgung von Verfahren kontinuierlich stattfinden muss. Smartphone-Hersteller ordnen jedes Jahr Speicherkapazität, Bandbreite und Gesamtgerätekosten neu an. Die Aufnahme in die Lieferkette der vorherigen Generation ist nur der Ausgangspunkt für den nächsten Wettbewerb. ChangXin gab im selben September bekannt, dass LPDDR6 bereits mit dem Xiaomi 18 Fold auf den Markt gekommen ist, es bietet eine Gehäusekapazität von 16 GB und eine Übertragungsrate von 10667 Mbps bei Zusammenarbeit mit dem Prozessor. Das Unternehmen beteiligt sich nun an der Endimplementierung neuer Speicherstandards, sodass der Produktwettbewerb von der Ergänzung bestehender Spezifikationen bis hin zur Anpassung an den Entwicklungsrhythmus von Flaggschiff-Smartphones voranschreitet.
Konkurrenten der gleichen Generation arbeiten ebenfalls an diesem Thema. Das von Samsung veröffentlichte 16-GB-LPDDR6 wurde bereits auf der neuen Snapdragon-Plattform von Qualcomm als Muster geliefert und validiert, die maximale E/A-Rate beträgt 10,7 Gbps. Die Kapazität und Übertragungsrate der beiden Unternehmen liegen in ähnlichen Bereichen: ChangXin hat die kommerzielle Nutzung im Endgerät offengelegt, Samsung die Plattformvalidierung, beide entsprechen unterschiedlichen Kooperationsfortschritten. ChangXin ist bereits in den Wettbewerb von Produkten der gleichen Generation eingetreten; Stromverbrauch, Massenproduktionskosten und langfristige Zuverlässigkeit lassen sich noch nicht anhand dieser beiden Spezifikationen einordnen.
G5 und LPDDR6 entsprechen jeweils der Fertigungsplattform und dem Produktstandard. Erstere verbessert die Speicherkapazität, die pro Wafer bereitgestellt werden kann, Letztere gibt Smartphone-Herstellern eine zusätzliche Option bei der Entwicklung neuer Flaggschiff-Geräte. Die Anpassung an Standards und die Integration in Endgeräte geben inländische Speicherchips konkrete Produkte, um an der Gestaltung neuer Flaggschiff-Geräte teilzunehmen; die kontinuierliche Verbesserung der Herstellungskosten hängt davon ab, wie viele Gerätemodelle abgedeckt und wie groß die Beschaffungsmenge sein kann.
Yangtze Memory steht vor einer anderen Art von Speicherbedarf. Fotos auf Smartphones und Trainingsdaten auf Servern müssen auch nach dem Ausschalten des Geräts weiter gespeichert werden. In Smartphones und Servern mit SSD übernimmt NAND-Flash diese Aufgabe. Es muss ebenfalls die Speicherdichte erhöhen, aber nach dem Einzug in Rechenzentren kaufen Kunden oft eine SSD, die dauerhaft betrieben werden kann, sodass die Produktfähigkeiten außerhalb der Speicherpartikel genauso wichtig werden.
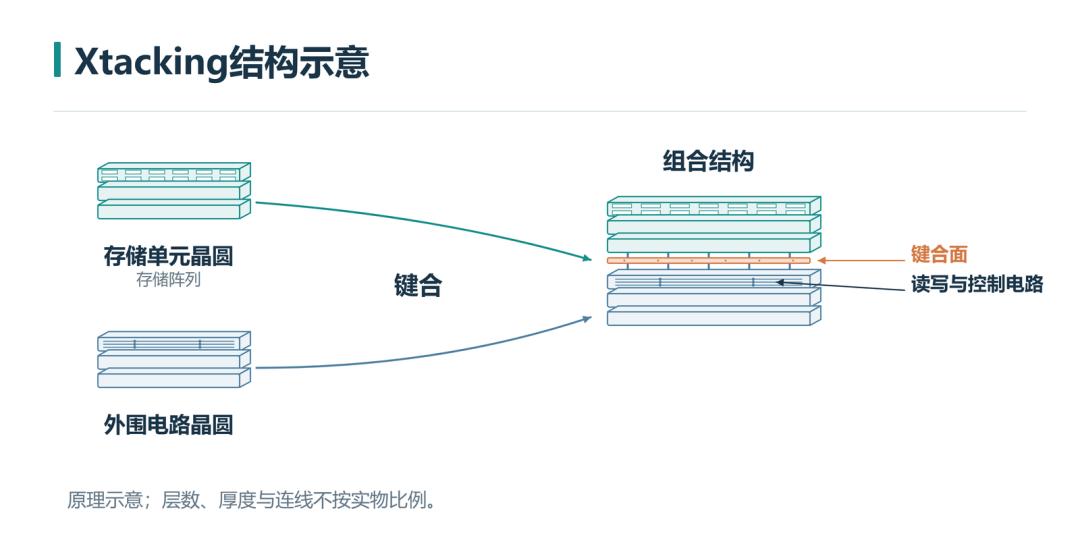
Die Xtacking-Architektur von Yangtze Memory stellt Speicherzellen und Peripherieschaltungen für Datenlesen, -schreiben und -steuerung getrennt her und verbindet sie anschließend. Dadurch können die Verfahren für die beiden Teile separat geplant werden, sodass die Speicherzellen eine höhere Dichte erreichen und die Peripherieschaltungen die Datenübertragungsfähigkeit verbessern können. Der Produktverlauf des Unternehmens zeigt, dass die fünfte Generation von TLC-Flash-Speichern 2024 in Massenproduktion ging und die fünfte Generation von QLC 2025 auf den Markt kam – die Technologie wurde entlang derselben Linie weiterentwickelt. Zuvor bestätigte TechInsights in der SSD der Heishen-Version von Zhitai TiPlus7100 die gemischte Bonding-Struktur von zwei Wafern von Xtacking 4.0, diese Fertigungslinie ist bereits in verkaufsfertigen Produkten angekommen.
Der Unterschied zwischen TLC und QLC lässt sich im Konto der Kapazität verstehen: Eine Speicherzelle speichert jeweils 3 bzw. 4 Bit, sodass QLC bei gleicher Anzahl an Zellen mehr Daten aufnehmen kann. Die unternehmensweite SSD PE501 von Yangtze Memory nutzt QLC und erreicht eine maximale Kapazität von 122,88 TB. Die gleiche Datenmenge kann weniger Laufwerksplätze belegen, was für Rechenzentren einen praktischen Wert hat. Internationale Hersteller haben bereits in diese Kapazitätsklasse investiert: Solidigm veröffentlichte im November 2024 die D5-P5336 mit 122,88 TB und lieferte sie damals bereits als Muster an Kunden aus. Yangtze Memory ist in den entsprechenden Produktbereich eingetreten, sodass der Wettbewerb außerhalb der Kapazität beginnt.
Für Datenbanken mit häufigen Aktualisierungen und Speicher, der hauptsächlich zum Lesen von Daten dient, gelten unterschiedliche Anforderungen an Kapazität und Schreiblebensdauer. Yangtze Memory bietet gleichzeitig die PE522 mit TLC an und unterscheidet zwischen Konfigurationen mit Schwerpunkt auf Lesevorgängen und gemischtem Lesen und Schreiben. Dieses Produktportfolio ermöglicht es dem Unternehmen, Kapazität, Haltbarkeit und Preis an verschiedene Geschäftsanforderungen anzupassen, anstatt ein einziges Produkt mit maximaler Kapazität für alle Kunden anzubieten.
Die Integration in Server erfordert zudem eine Systemvalidierung. In der NVMe-Liste des Interoperabilitätslabors der Universität New Hampshire in den USA wurden die PE501 und die angegebene Firmware-Version im Januar dieses Jahres registriert, die PE501N im Oktober. Diese Liste erfasst Interoperabilitäts- und Konformitätstests und zeigt, dass das Produkt die Phase der gemeinsamen Validierung mit externen Systemen erreicht hat. Für Hersteller von unternehmensweiten SSDs umfasst der Wettbewerb auch die Frage, wie der Aufwand für Kunden bei der Validierung neuer Produkte reduziert werden kann. Bei der Veröffentlichung des 122,88-TB-Produkts stellte Solidigm besonders vor, dass seine hochkapazitiven Produkte von 7 TB bis 122 TB einen gemeinsamen Controller nutzen, um die Validierung für Kunden zu erleichtern. Die Einführung weiterer Kapazitätsspezifikationen rund um vorhandene Hard- und Software kann dazu führen, dass eine einzelne Produktimplementierung einen breiteren Beschaffungsbedarf abdeckt.
Daher verändert die Erweiterung von Yangtze Memory auf unternehmensweite SSDs auch die Arbeitsteilung mit seinen Kunden. Beim Verkauf von Speicherpartikeln kann das Design der gesamten SSD noch von nachgeschalteten Kunden abgeschlossen werden; bei der Bereitstellung von unternehmensweiten SSDs müssen Controller, Firmware, Datenschutz und nachfolgende Dienstleistungen in das Produkt integriert werden. In einer Analyse im Oktober wies Counterpoint darauf hin, dass Yangtze Memory gleichzeitig von steigenden Preisen und wachsenden inländischen Verkäufen profitiert, bisher aber nicht vollständig die Prämien des Marktes für unternehmensweite SSDs erzielt hat. Die Erweiterung des Angebots auf der Fertigungsseite und die Etablierung der Produktposition bei hochwertigen Kunden sind zwei Aufgaben, die gleichzeitig vorangetrieben werden müssen.
Die globale Einnahmeverteilung hat sich bereits verändert. Laut Schätzungen von Counterpoint stieg der Umsatzanteil von Yangtze Memory auf dem NAND-Markt von 11 % im zweiten Quartal 2025 auf 14 % im gleichen Zeitraum dieses Jahres. Dieses Wachstum fand im Zyklus steigender Speicherpreise statt, die gleiche Einrichtung schätzt, dass die NAND-Preise im zweiten Quartal dieses Jahres im Vergleich zum Vorquartal um 55 % gestiegen sind. Steigende Preise können die Einnahmen des gesamten Marktes erhöhen, während der Anstieg des Marktanteils zeigt, dass Yangtze Memory einen größeren Teil davon erzielt hat.
Beim Kauf von KI-Chips muss die Rechnung für das gesamte System aufgestellt werden
Während inländische Chips weiter investiert werden, schreiten die Produkte der Wettbewerber ebenfalls voran. Am 27. Oktober kündigten NVIDIA und Oracle an, dass Vera Rubin NVL72 und Vera CPU auf der OCI-Cloud-Plattform offiziell verfügbar sind. Die nächste Generation von Plattformen, die Anfang des Jahres noch auf der Pressekonferenz vorgestellt wurde, ist jetzt bereits im Produktkatalog der Cloud-Dienste gelandet.
Der von Rubin dargestellte Wettbewerbsbereich geht weit über einen einzelnen GPU-Chip hinaus. Ein NVL72-Rack verbindet 72 GPUs über NVLink, das System erfordert zudem die Zusammenarbeit von CPU, Netzwerk, Datenprozessoren und Software. Wenn die Recheneinheiten beim Ausführen von Modellen nicht rechtzeitig Daten erhalten oder die Kommunikation zwischen mehreren GPUs nicht reibungslos verläuft, kann die angegebene Rechenleistung nicht voll ausgeschöpft werden. NVIDIA treibt all diese Glieder gemeinsam voran, sodass sich die Vergleichsobjekte der Kunden auf das gesamte System ausweiten.
Inländische Beschleuniger sammeln ebenfalls Fähigkeiten in diesen konkreten Arbeitsabläufen. Im Januar dieses Jahres veröffentlichte Baidu die Praxis der Bereitstellung von DeepSeek R1 auf dem Tianchi-Superknoten: Jeder Superknoten verbindet 32 XPU-Kerne von Kunlunxin. Das Team hat auf Basis des SGLang-Inferenzframeworks die Verarbeitung von Eingaben und die Generierung von Antworten getrennt bereitgestellt und anschließend Modellverteilung, Grafikspeicherauslastung und Kommunikationsplanung angepasst. Um Platz für längere Kontexte zu schaffen, wurden verschiedene Experten des Modells auf mehr Karten verteilt, wodurch die Gewichte, die jede einzelne Karte trägt, verringert wurden. Die Systemoptimierung ist bereits auf die Art und Weise ausgerichtet, wie Modelle ausgeführt werden, und beschränkt sich nicht mehr auf die Chip-Parameter.
Diese Arbeiten zeigen auch, dass der Preis einer einzelnen Karte nur ein Teil der Beschaffungskosten ist. Mit welcher Genau