Neues Paper von Google RSI: mit eigenem Gedächtnis und autonomer Iteration
Bericht von Zhidx am 19. November: Kürzlich haben die Forschungsteams von Google Cloud AI, Google DeepMind und der Pennsylvania State University gemeinsam das Paper „Self-Improvement Memory Enables Continual Recursive Self-Improvement“ veröffentlicht, in dem eine neue Methode namens Self-Improvement Memory (SIM) vorgestellt wird.
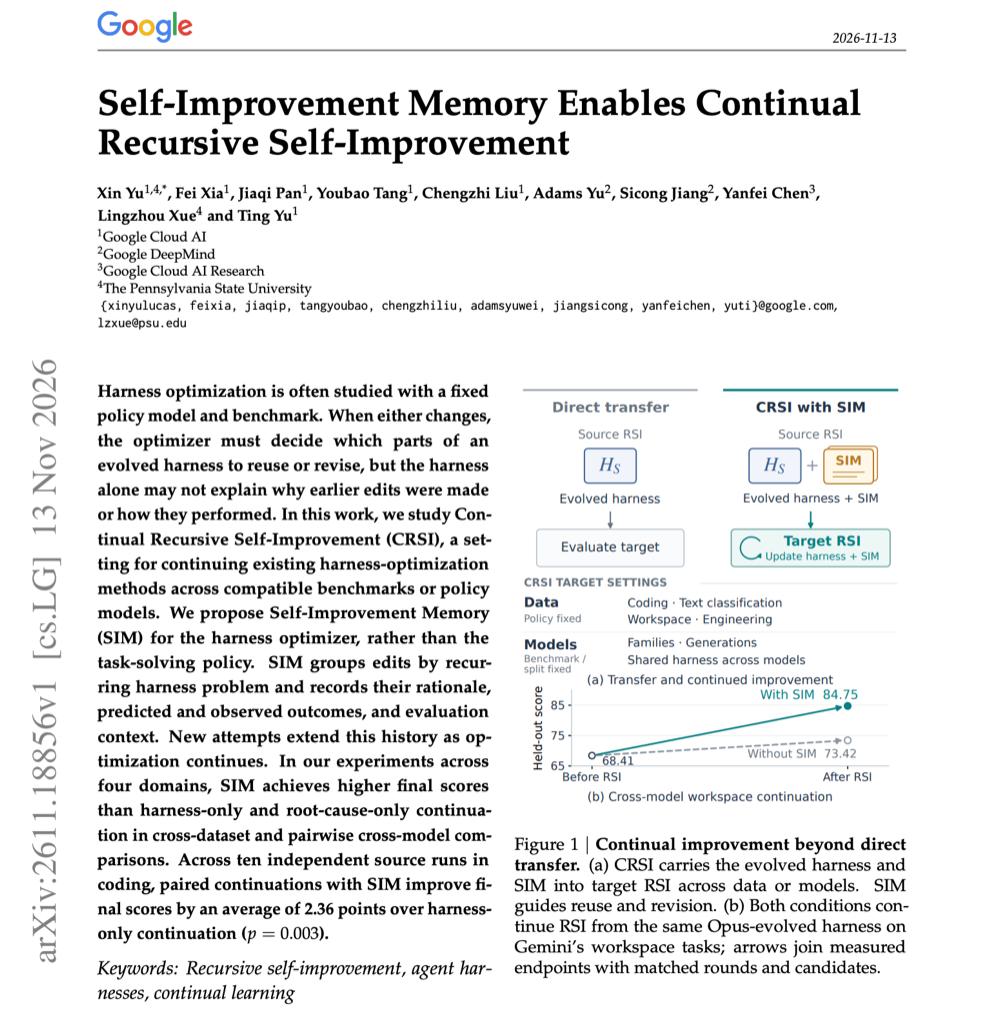
▲ „Self-Improvement Memory Enables Continual Recursive Self-Improvement“
Bisher konnte die KI zwar das externe Ausführungsframework (Harness) außerhalb des großen Modells eigenständig optimieren, nach dem Austausch von Modell oder Aufgabe war jedoch oft eine erneute Optimierung erforderlich. SIM organisiert erstmals die Gründe hinter den Codeänderungen, die erwarteten Effekte und die tatsächlichen Ergebnisse zu einem nachhaltig aktualisierbaren Gedächtnis, sodass die KI die vergangenen Verbesserungserfahrungen übernehmen und anpassen kann, um eine kontinuierliche rekursive Selbstverbesserung (CRSI) modell- und aufgabenübergreifend zu erreichen.
Anschließend führte das Forschungsteam Tests in vier Bereichen durch: Programmierung, Textklassifizierung, Büroaufgaben und Ingenieurdesign. In 10 unabhängigen kontrollierten Programmierexperimenten schnitten 9 der Schemata mit eingeführtem SIM besser ab und lagen im Durchschnitt um 2,36 Punkte vor. Bei einem weiteren modellübergreifenden Büroaufgabentest erreichte das Schema mit SIM eine Endpunktzahl von 84,75 Punkten, während das Schema ohne SIM nur 73,42 Punkte erzielte, was einem Unterschied von 11,33 Punkten entspricht.
Der Erstautor dieser Studie, Xin Yu, schloss 2023 sein Studium der Statistik an der Nankai-Universität ab und promoviert derzeit in Statistik an der Pennsylvania State University in den USA. Diese Studie wurde während seines Praktikums bei Google abgeschlossen.
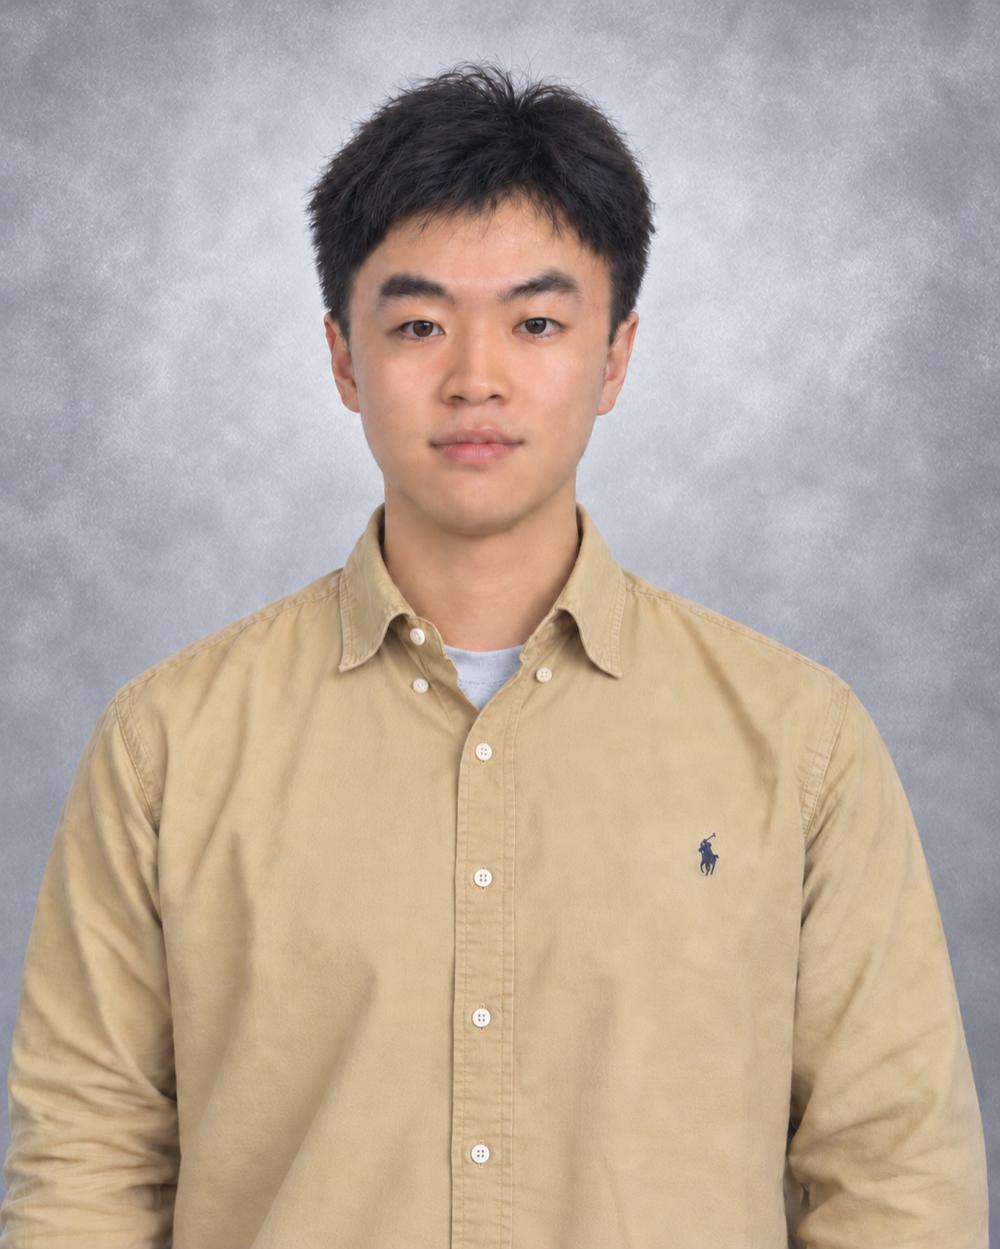
▲ Xin Yu
Xin Yu absolvierte nacheinander Praktika bei Microsoft Research Asia, Seed von ByteDance, TikTok und Meta und erhielt 2023 den Preis „Star of Tomorrow“ von Microsoft Research Asia. Mehrere von ihm mitverfasste Forschungsarbeiten wurden auf internationalen Spitzenkonferenzen für künstliche Intelligenz wie ICML, ICLR und NeurIPS veröffentlicht.
Ein weiterer Autor des Papers, Adams Wei Yu, ist Forscher bei Google DeepMind und war an Projekten wie Gemini, Bard sowie dem KI-Videogenerierungsmodell Veo beteiligt.
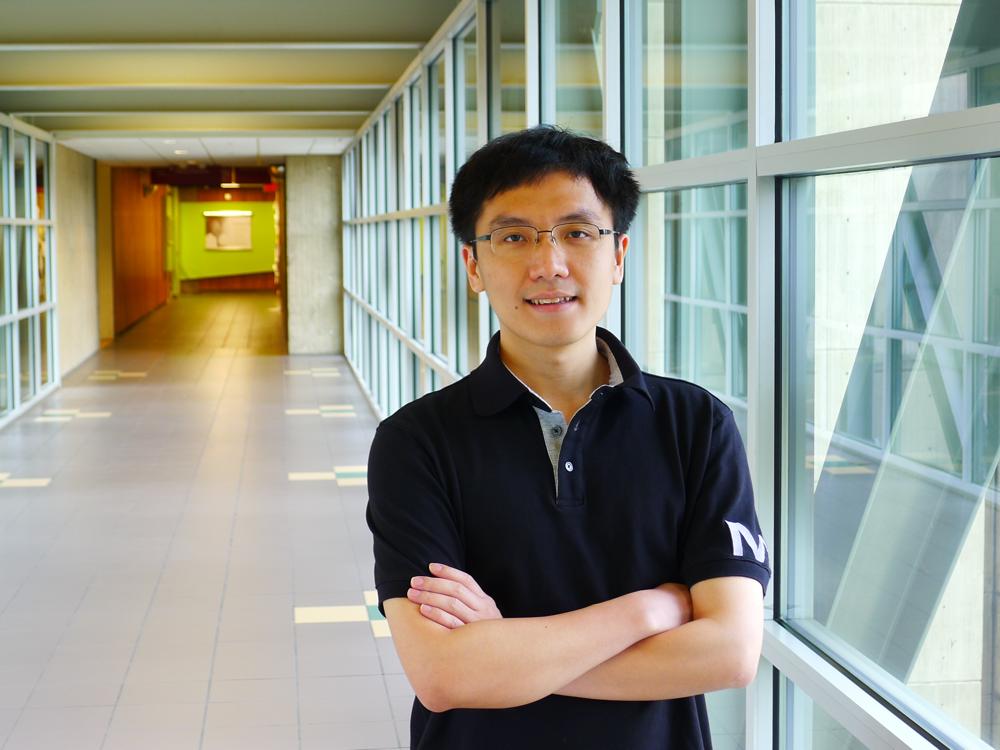
▲ Adams Wei Yu
Nach der Veröffentlichung des Papers stellte Xin Yu den Ausgangspunkt dieser Arbeit auf X vor. Er erwähnte, dass frühere Studien zur rekursiven Selbstverbesserung normalerweise auf feste große Modelle und Testaufgaben abzielen, aber Agenten in der realen Welt ständig neue Aufgaben, Datensätze und Modelle anpassen müssen. Daher hofft das Forschungsteam, dass die Optimierungserfahrung der KI sich mit der Veränderung der Umgebung kontinuierlich ansammeln kann.
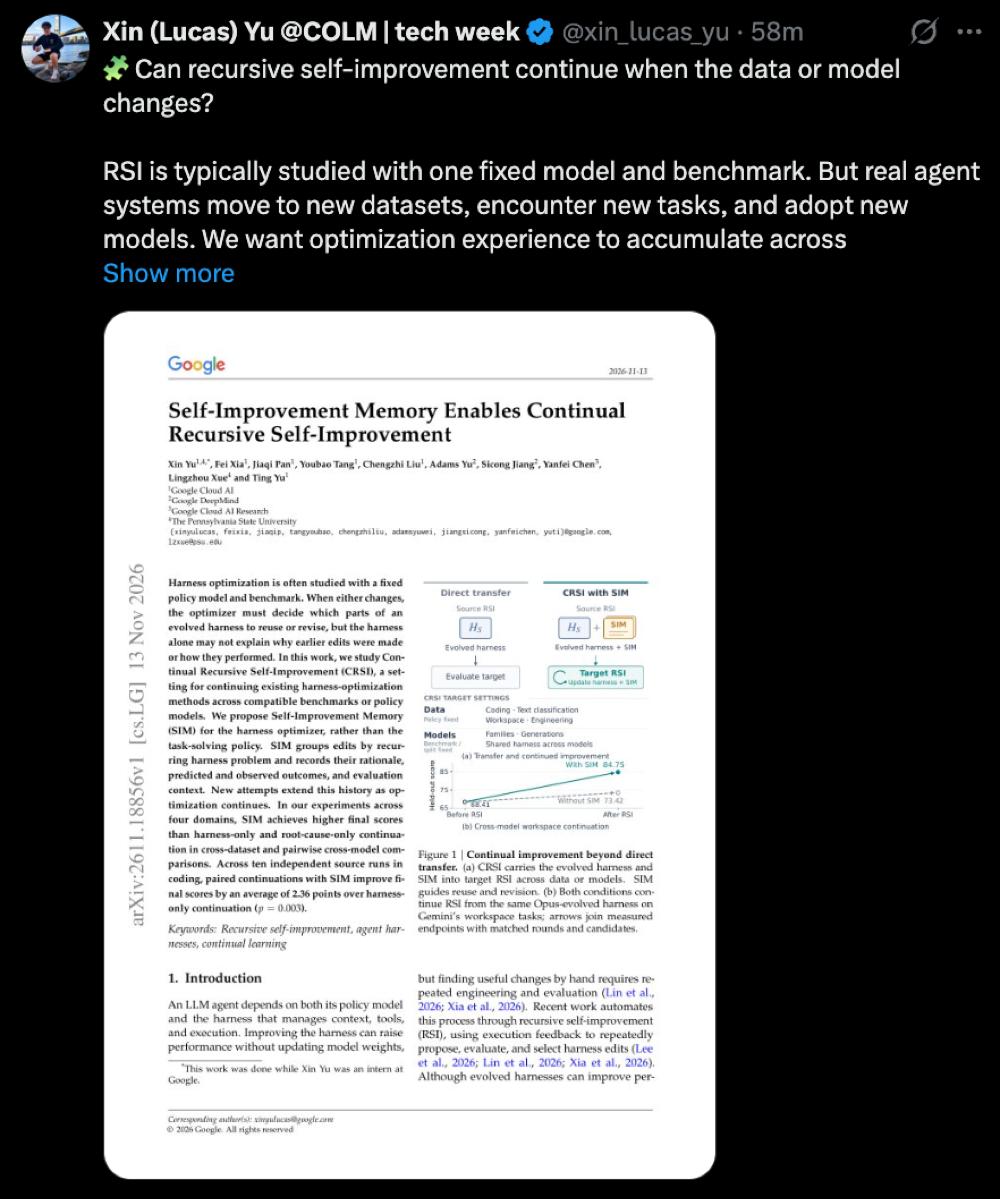
▲ Beitrag von Xin Yu
„Was weitergegeben werden soll, umfasst die Erfahrung hinter dem Code – nicht nur den Code selbst“, schrieb Xin Yu.
Link zum Paper: https://arxiv.org/abs/2611.18856
01.
Die KI kann den Code selbst ändern
und sich an Erfolg und Misserfolg jeder Verbesserung erinnern
Rekursive Selbstverbesserung (Recursive Self-Improvement, RSI) bedeutet, dass die KI an der Verbesserung des KI-Systems beteiligt ist und die Leistung durch wiederholte Iterationen steigert. In dieser Studie ist das Objekt der KI-Verbesserung nicht das große Modell selbst, sondern ein externes Programm, das um das große Modell herum ausgeführt wird – Harness.
Harness ist verantwortlich für die Verwaltung von Prompts, Kontexten, Tool-Aufrufen und Aufgabenausführungsabläufen. Wenn die KI beispielsweise eine Programmieraufgabe erledigen soll, kann Harness entscheiden, wann das Terminal aufgerufen wird, wie die Codeausführungsergebnisse überprüft werden und unter welchen Bedingungen die Aufgabe als abgeschlossen erklärt werden kann.
Durch RSI kann die KI den Harness-Code eigenständig ändern, die Wirkung der Änderungen wiederholt testen und die Version mit besserer Leistung behalten, wodurch die Aufgabenabschlussrate des Agenten erhöht wird, ohne die Gewichtungen des großen Modells zu aktualisieren.
Aber diese Art der Optimierung zielt normalerweise auf feste Modelle und Aufgaben ab. Ein Harness, der für Claude optimiert wurde, ist nach dem Wechsel zu Gemini nicht unbedingt noch wirksam; Regeln, die zuvor für Programmieraufgaben entwickelt wurden, sind möglicherweise auch nicht auf neue Aufgaben anwendbar.
Noch wichtiger ist, dass der geänderte Harness zwar den Code behält, aber nicht unbedingt die Gründe und Testerfahrungen hinter jeder Änderung speichert. Wenn sich das Modell oder die Aufgabe ändert, wiederholt die für die Optimierung verantwortliche KI möglicherweise frühere Versuche und löscht sogar ursprünglich wirksame Funktionen.
Aus diesem Grund schlägt das Forschungsteam die kontinuierliche rekursive Selbstverbesserung (Continual Recursive Self-Improvement, CRSI) vor, damit die automatische Optimierung von Harness modell- und aufgabenübergreifend fortgesetzt werden kann und die bisherigen Verbesserungserfahrungen über SIM gespeichert werden. SIM funktioniert wie ein „Experimentierprotokollbuch“, das jedes angenommene Änderungsschema, den Grund für die Änderung, das erwartete Ergebnis, die tatsächliche Wirkung sowie das entsprechende Modell und die Testumgebung aufzeichnet.
Wenn eine neue Aufgabe oder ein neues Modell auftaucht, kann die KI, die für die Optimierung von Harness verantwortlich ist, auf diese Aufzeichnungen verweisen, um zu beurteilen, welche Regeln beibehalten, geändert oder entfernt werden sollen, ohne neu experimentieren zu müssen.
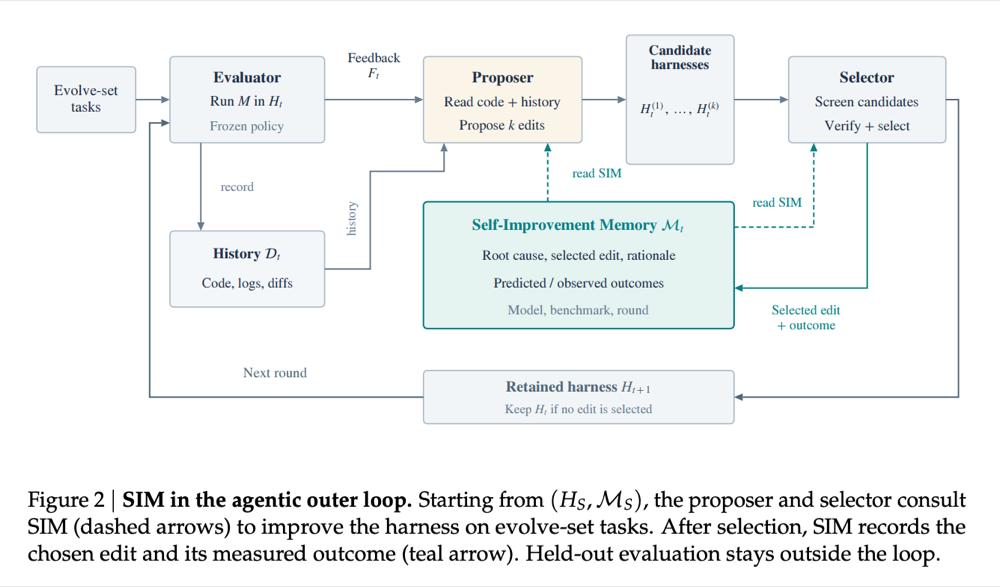
▲ Arbeitsablauf von SIM
Konkret liest die KI, die im System für die Erstellung von Vorschlägen zuständig ist, den aktuellen Code, die Ausführungsrückmeldungen und die SIM-Aufzeichnungen, um neue Änderungsvorschläge zu generieren; die für die Auswahl zuständige KI prüft die Kandidatenvorschläge und entscheidet anhand der Testergebnisse, ob sie übernommen werden.
Anschließend schreibt das System die angenommene Änderung und ihre tatsächliche Wirkung in SIM. Selbst wenn die Änderung die Erwartungen nicht erfüllt, wird das Fehlschlagergebnis beibehalten, um als Referenz für nachfolgende Optimierungen zu dienen.
Bei einer Konfigurationsaufgabe für einen Git-Server erklärte die KI die Aufgabe vorzeitig für abgeschlossen, nachdem der lokale Test erfolgreich war, übersah aber den entscheidenden Schritt der Erstellung des angegebenen Benutzerkontos, was dazu führte, dass die externe Überprüfung fehlschlug. Die Forscher fügten durch automatische Optimierung einen Aufgabenabschlussprüfmechanismus zum Ausführungsframework hinzu, um zu verhindern, dass die KI die Aufgabe vorzeitig beendet, wenn keine Ausführungsnachweise vorliegen.
Als der Test auf die Aufgabe der Lichtwellenleiter-Verkabelung umgestellt wurde, tauchte ein neues Problem auf: Obwohl der von der KI generierte Verdrahtungspfad die Einschränkungen erfüllte, bedeutete dies nicht, dass die Verdrahtungskosten bereits ausreichend niedrig waren. Daher behielt die nachfolgende Optimierung den vorherigen Prüfmechanismus bei und fügte gleichzeitig eine Erinnerung zur Überprüfung der Schemataqualität hinzu, um zu verhindern, dass die KI die Aufgabe beendet, nur weil sie die grundlegende Einschränkungsprüfung bestanden hat.
Das ist auch die Wirkung, die SIM erreichen möchte: Die KI kann sowohl die früheren wirksamen Verbesserungsmethoden übernehmen als auch sie entsprechend den Anforderungen der neuen Aufgabe weiter anpassen.
02.
9 von 10 Programmierexperimenten profitieren
Modellübergreifend bis zu 11,33 Punkte mehr
Um die Wirkung von SIM zu überprüfen, führte das Forschungsteam zwei Hauptarten von Experimenten durch: Eine behält das zugrundeliegende Modell unverändert bei und ersetzt die Aufgabendaten; die andere behält die Testaufgabe unverändert bei und ersetzt das zugrundeliegende Modell.
In der ersten Art von Experiment verwendeten die Forscher Gemini 3.8 Flash als zugrundeliegendes Modell und übertrugen das bereits optimierte Ausführungsframework auf neue Aufgaben.
Als Ergebnis erzielten in 6 Tests, die Programmierung, Textklassifizierung, Büroaufgaben und Ingenieurdesign abdecken, alle Schemata mit vollständig eingeführtem SIM die höchste Endpunktzahl und lagen um 2,43 bis 4,35 Punkte vor dem Schema, das nur das ursprüngliche Ausführungsframework übernahm.
Die zweite Art von Experiment betrifft die Übertragung zwischen verschiedenen Modellen. Die Forscher optimierten zuerst ein Harness für Claude Opus 5.5, ließen dann Gemini 3.8 Flash dieses Harness verwenden und führten weiterhin automatische Optimierungen durch.
Es stellte sich heraus, dass nach der direkten Übertragung des für Claude geeigneten Harness auf Gemini die anfängliche Leistung in allen 4 Testbereichen schlechter war als die Leistung von Gemini bei Verwendung des ursprünglichen Harness.
Aber nach der Einführung von SIM kann die für die Optimierung verantwortliche KI auf die bisherigen Änderungserfahrungen verweisen und die Teile anpassen, die nicht für Gemini geeignet sind. Schließlich erzielte das SIM-Schema in allen 4 Bereichen die höchste Punktzahl und lag um 3,60 bis 11,33 Punkte vor dem Schema ohne SIM.
Der größte Unterschied besteht bei dem Büroaufgabentest. Beide Schemata starteten bei 68,41 Punkten, das Schema mit SIM erreichte schließlich 84,75 Punkte, während das Schema ohne SIM 73,42 Punkte erzielte.
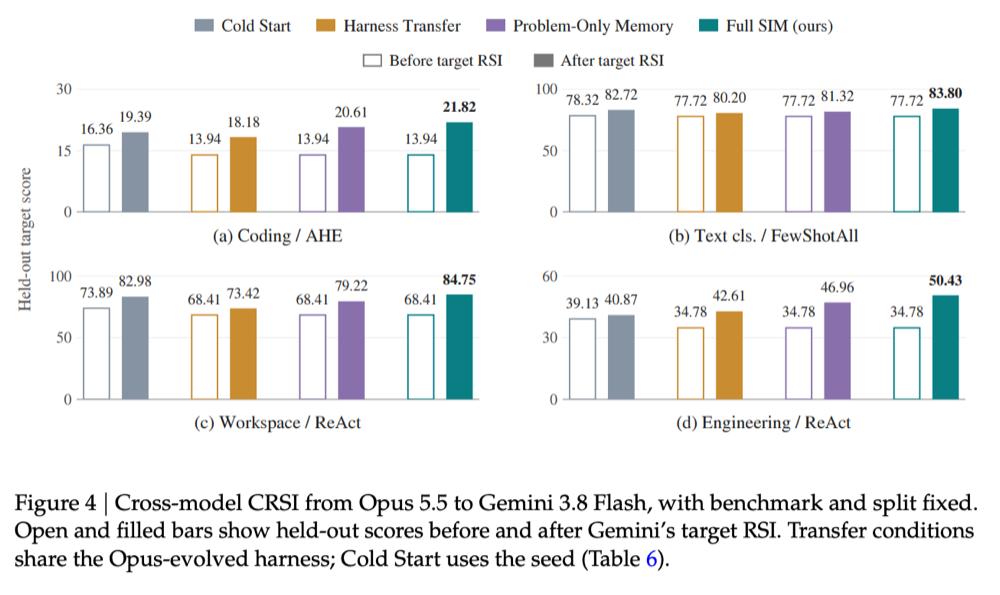
▲ Ergebnisse des modellübergreifenden Tests
Um die Wirkung weiter zu überprüfen, führten die Forscher auch 10 unabhängige kontrollierte Programmierexperimente durch.
Bei gleichem Ausgangscode, zugrundeliegendem Modell, Aufgabe und Optimierungsbudget erzielten 9 der Schemata mit hinzugefügtem SIM eine höhere Punktzahl, die durchschnittliche Endpunktzahl betrug 21,70 Punkte, während das Schema ohne SIM im Durchschnitt 19,33 Punkte erreichte. Der durchschnittliche Unterschied zwischen beiden betrug 2,36 Punkte, das statistische Testergebnis ergab p=0,003.
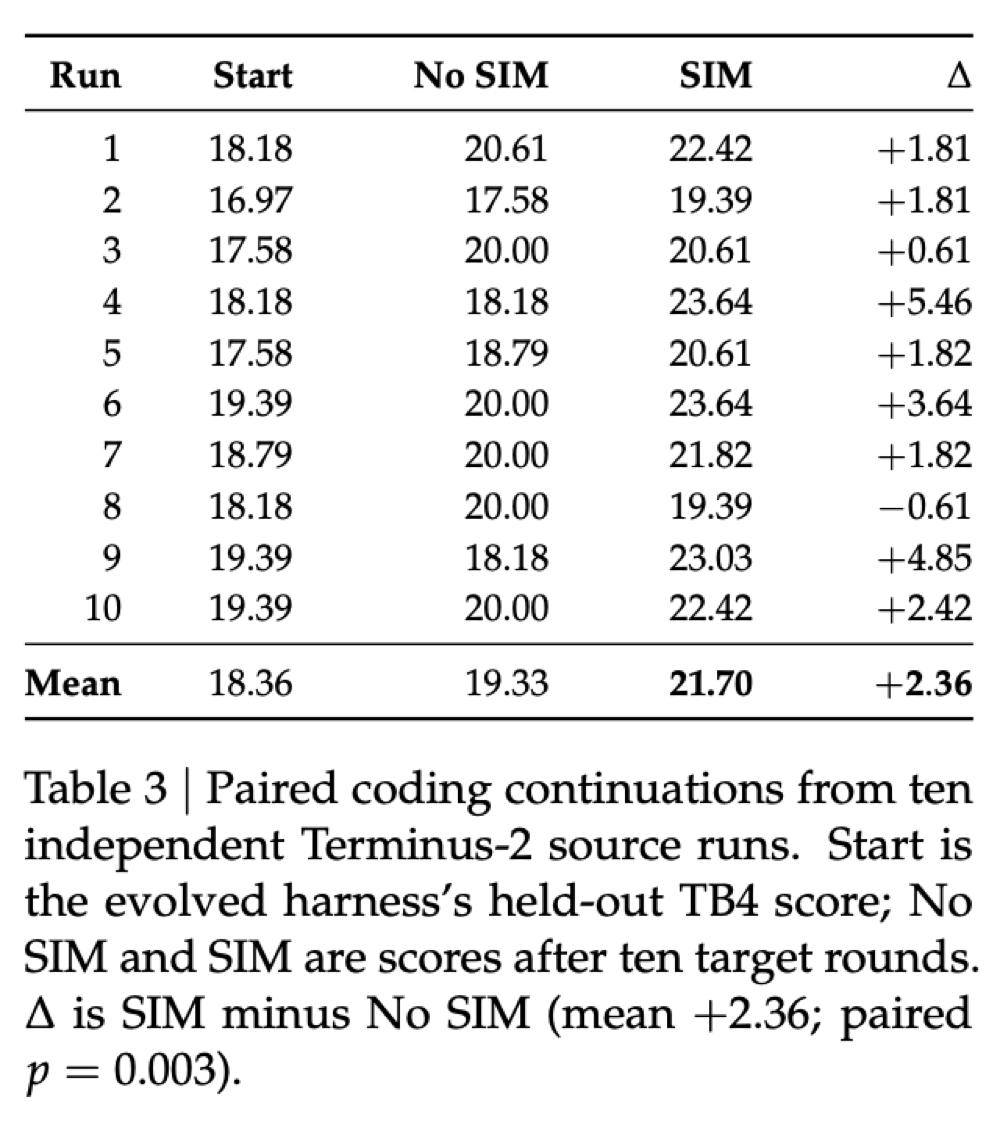
▲ Ergebnisse von 10 kontrollierten Programmierexperimenten
Das Forschungsteam versuchte auch, dieses Ausführungsframework und sein Gedächtnis nacheinander an Gemini 2.5 Flash, Gemini 3.5 Flash, Gemini 3.8 Flash und Gemini 4 Argon anzupassen.
Im Vergleich zur Optimierung jeder Modellgeneration von Grund auf lagen die Schemata mit übernommener historischer Erfahrung bei Gemini 3.5 Flash und Gemini 3.8 Flash um 3,5 Punkte bzw. 1,6 Punkte vor. Bei Gemini 4 Argon lag die Endpunktzahl des Schemas mit übernommener Erfahrung jedoch um 0,8 Punkte zurück.
Das zeigt, dass historische Erfahrungen der KI zwar helfen, die Optimierung modellübergreifend fortzusetzen, aber nicht garantieren, dass jede Übertragung bessere Ergebnisse erzielt.
03.
Kann die KI sich kontinuierlich weiterentwickeln?
Die Modellgewichtungen bleiben unverändert
Diese Studie hat auch Diskussionen auf X ausgelöst. Der Technik-Blogger Superman meint, dass frühere Versuche der KI, sich selbst zu verbessern, leicht dazu führten, dass sie frü