14 % Ertragssteigerung, OpenAI entwickelt Chips mithilfe von KI, schafft in 5 Monaten das Arbeitsaufkommen, für das Menschen ein ganzes Jahr benötigen, und Astra liegt an der Spitze.
Meldung von Zhidongxi vom 19. November: Gerade hat OpenAI bekanntgegeben, dass sein Modell den PPA (Kernindikator des Chipdesigns) des Flaggschiff-GPU-IP von AMD in weniger als fünf Monaten um bis zu 14 % verbessert hat – dies entspricht dem Entwicklungsaufwand von etwa einem ganzen Jahr, den menschliche Ingenieure zuvor erbracht hätten.
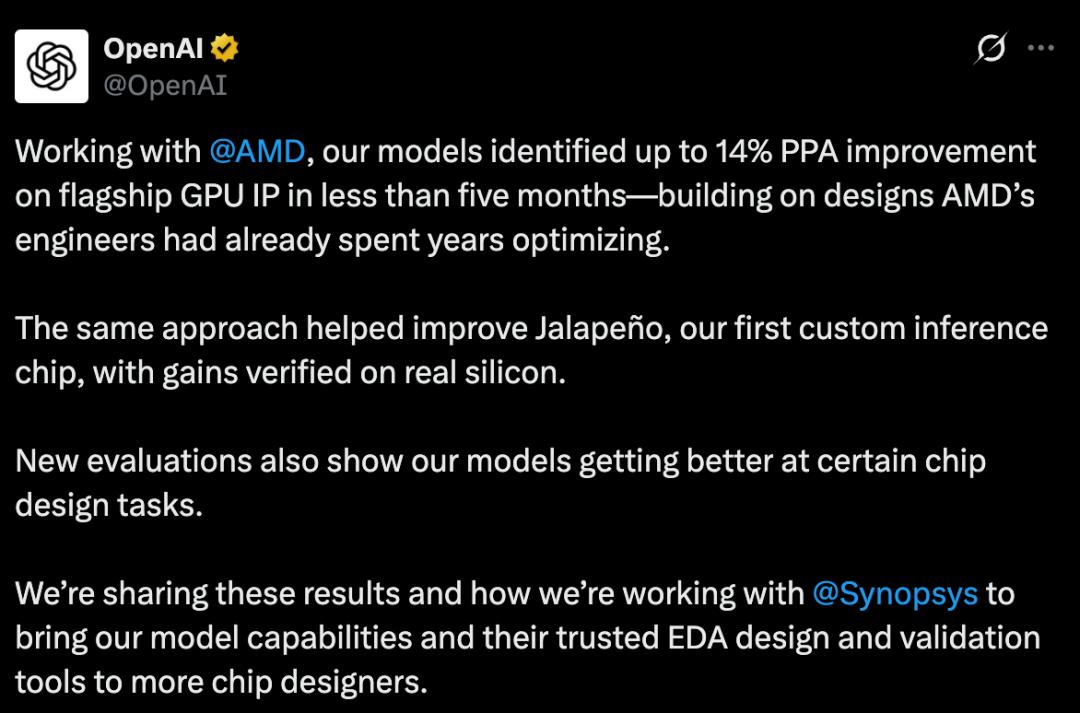
Die Forschungsergebnisse von OpenAI belegen, dass das Modell bei RISC-V-Bewertungsaufgaben völlig neue Prozessorarchitekturen erkunden kann; zudem lassen sich auf Basis ausgereifter Seriendesigns wie Jalapeño, dem nächsten Flaggschiff-GPU und CPU von AMD inkrementelle Optimierungen erreichen.
Jalapeño, der erste selbst entwickelte Inferenzchip von OpenAI, basiert auf den vom Modell vorgeschlagenen Modifikationen, wodurch die Fläche der Standardzellen der Vektoreinheit um etwa 13 % und die der Matrixeinheit um etwa 10 % reduziert wurde. Laut OpenAI wurden diese Optimierungseffekte bereits in der Phase des Tapeout-Debuggings von Jalapeño bestätigt.
Um die Fähigkeit seines Modells bei End-to-End-Chipdesign-Aufgaben zu messen, hat OpenAI mehrere Generationen von Modellen nacheinander für zwei Open-Source-Prozessordesigns bewertet. Die Ergebnisse zeigen, dass alle fünf Modelle – GPT-6.2 Astra, GPT-6 Astra, GPT-6.1 Sol, GPT-5.6 Sol und GPT-5.5 – bei der Neuentwicklung von Prozessorkernen aus Null auf Grundlage schriftlicher Anforderungen höhere Punkte erzielen als bei der Optimierung bestehender Designs.
Gleichzeitig arbeitet OpenAI mit Synopsys zusammen, um die fortschrittlichen KI-Fähigkeiten in die EDA-Toolkette zu integrieren, die Ingenieure derzeit für Chipdesign und -verifikation verwenden, damit die Fähigkeitsiteration auf einem vertrauenswürdigen Bewertungssystem basiert.
01.
Bereits in der Ära von GPT‑4o an Chipdesign beteiligt
OpenAI legt den Optimierungspfad für das KI-gestützte Chipdesign offen
Anfang 2025 wurde GPT‑4o bereits zur Unterstützung des Designs des selbst entwickelten Inferenzchips Jalapeño von OpenAI eingesetzt. Dieses frühe Modell hat bereits mehrere beachtliche PPA-Optimierungen erreicht.
Die Vektoreinheit ist für die Planung und Ausführung paralleler Berechnungsaufgaben zuständig. Die Optimierungsvorteile dieses Moduls ergeben sich aus Fließkomma-Addierern, Multiplizierern, Umwandlungsschaltungen, Reduktionslogik und Einheiten für spezielle Funktionen. Das Modell hat mehrere Logikimplementierungslösungen untersucht und gleichzeitig erforscht, wie Berechnungsaufgaben auf verschiedene Pipeline-Stufen aufgeteilt werden können, sodass Optimierungspotenziale für die Wiederverwendung von Hardware und die Reduzierung des Zwischenspeicheraufwands gefunden wurden.
Die Matrixeinheit ist die Rechenkomponente, deren Optimierungsvorteile sich aus mehreren Verbesserungen wie Fließkomma-Addierern, Multiplizierern und Schaltungen für niedrigpräzise Punktprodukte ergeben. Einer der Multiplizierer wurde neu entworfen, sodass die synthetisierte Zellenfläche um etwa 15 % reduziert und gleichzeitig die Latenz von zwei Taktzyklen auf einen Taktzyklus gesenkt wurde; eine überarbeitete Version eines weiteren Addierers erzielte ebenfalls eine Flächenoptimierung von etwa 15 % bei unveränderter Latenz von zwei Zyklen. Weitere Optimierungen der Punktproduktlogik und der Pipeline-Struktur brachten diesem Modul zusätzliche Vorteile.
OpenAI hat mit AMD an PPA-Optimierungen gearbeitet und für das Flaggschiff-GPU-IP auf Basis der bereits tief optimierten Referenzversion eine Leistungssteigerung von bis zu 14 % erreicht.
Laut OpenAI hat das Modell durch die Neufassung des Codes, der die Schaltung des Chips beschreibt, weitere Optimierungspotenziale erschlossen. Dies entspricht der Fertigstellung des Entwicklungsaufwands von etwa einem ganzen Jahr in weniger als 5 Monaten. AMD hat einige der optimierten Änderungen bereits in die kürzlich zum Tapeout eingereichten Designs übernommen, weitere Optimierungslösungen wurden in die Seriendesign-Dateien für nachfolgende Iterationsversionen aufgenommen.
Die Forscher haben beobachtet, dass das Modell das Niveau erfahrener Mikroarchitekten erreicht und RTL-Code schlussfolgernd analysieren kann. Das Modell kann Schaltungen neu schreiben, die für Berechnungen, Steueroperationen und Datentransporte zuständig sind. Es überprüft mit Hilfe von Synopsys-Tools, dass jede Neufassung die ursprüngliche Funktion des Moduls nicht verändert, und bewertet die Abwägung zwischen Stromverbrauch, Leistung und Fläche.
Die Verifikationsergebnisse von AMD zeigen, dass durch die Verwendung des von OpenAI-Modell generierten Designs mehrere Kernmodule des nächsten Flaggschiff-CPUs von AMD eine PPA-Steigerung von mehreren Prozentpunkten erzielt haben.
02.
GPT‑6.2 Astra
Führt den Optimierungstest für den Durchsatz von RISC-V-Kernen an
Die von OpenAI auf Jalapeño und AMD-Chips erzielten Ergebnisse belegen, dass das Modell Seriendesigns optimieren kann.
Um den Iterationsfortschritt der Chipdesign-Fähigkeiten verschiedener Modellgenerationen zu messen, hat OpenAI zwei Open-Source-32-Bit-RISC-V-Kerne für Tests verwendet: PicoRV32 ist ein schlanker Kern für neu programmierbare Chips wie FPGAs, OpenTitan verwendet Ibex als eingebetteten Prozessor in seinen Sicherheitschips. Beide sind vollständige Prozessorkerne für eingebettete Lasten und Mikrocontroller-Anwendungen.
Die Forscher haben jeder Modellgeneration den ursprünglichen Hardwarebeschreibungscode jedes Prozessorkerns zur Verfügung gestellt und es aufgefordert, den Durchsatz zu erhöhen. Das heißt, eine Änderung kann die Anzahl der Taktzyklen reduzieren, die für eine Anweisung benötigt werden, aber die Dauer eines einzelnen Taktzyklus erhöhen; der Durchsatzindikator kann die Gesamtwirkung dieser beiden Änderungen gleichzeitig messen.
Es überprüft die Ausgabenergebnisse jeder Designversion durch Simulation. Wenn ein Design die Überprüfung nicht besteht oder die belegte Fläche das 16-fache des ursprünglichen Kerns überschreitet, wird es mit 0 Punkten bewertet. Für Designs, die die Überprüfung bestehen, werden Testlasten verwendet, die das Modell noch nie gesehen hat, um die Anzahl der Anweisungen pro Taktzyklus (IPC) zu messen. Der geometrische Mittelwert dieser Lastenergebnisse wird genommen und mit der von Yosys geschätzten maximalen Taktfrequenz multipliziert, um den geschätzten Wert der Anzahl von Anweisungen pro Sekunde zu erhalten.
Für jeden Prozessorkern haben sie den optimalen Durchsatz, der unter denselben Einschränkungen beobachtet wurde, als Referenzwert 1,0 festgelegt.
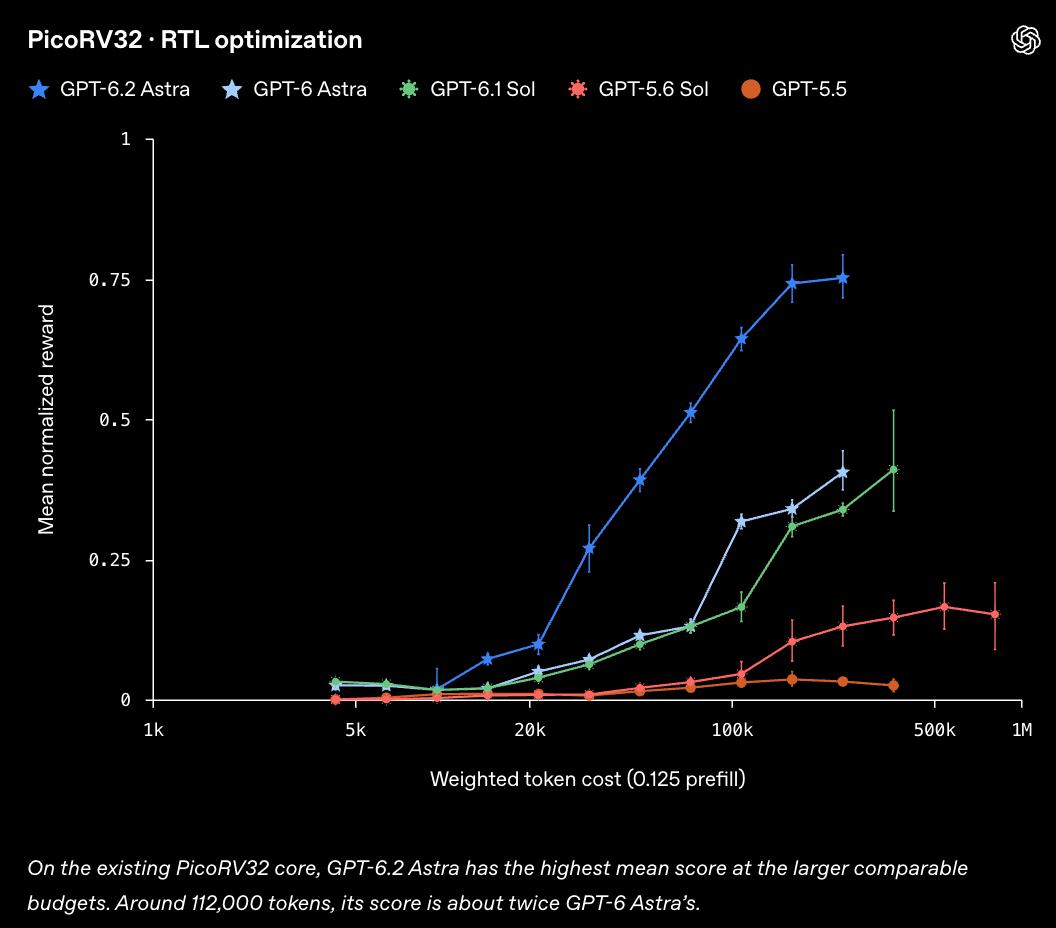
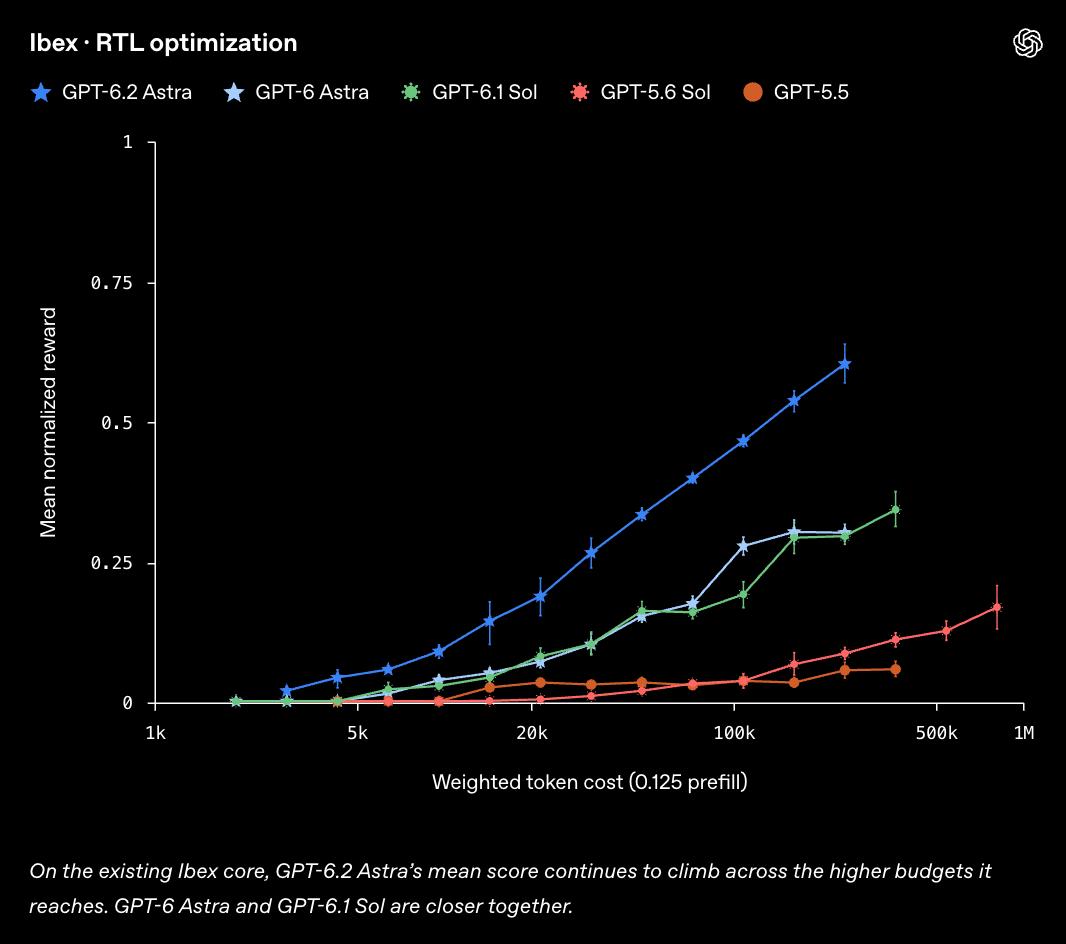
Bei gleichem Ressourcenaufwand von etwa 112.000 Tokens pro einzelnem Aufruf erzielte GPT‑6.2 Astra den höchsten Durchschnittswert auf beiden Prozessorkernen, und GPT‑6.1 Sol erzielte auf beiden Kernen höhere Punkte als GPT‑5.6 Sol.
Bei der zweiten Aufgabe haben die Forscher dem Modell schriftliche Anforderungen sowie Vorlagen im Open-Source-Code zur Verfügung gestellt. Diese Vorlagen definieren die Verbindungsweise zwischen dem Prozessorkern und anderen Teilen des Systems, und das Modell wählt selbstständig den Übertragungsweg der Daten im Kern sowie die Aufteilung der Arbeit in mehrstufige Pipelines.
Für beide Prozessorkerne bleiben die Korrektheitsprüfung, die Speicher- und Cache-Konfiguration sowie die Durchsatzziele mit denen der vorherigen RTL-Optimierungsaufgabe überein.
Bei einem Aufwand von etwa 112.000 Tokens pro einzelnem Aufruf erzielten alle fünf Modelle bei der Neuentwicklung von Prozessorkernen aus Null auf Grundlage schriftlicher Anforderungen höhere Punkte als bei der Optimierung bestehender Designs – diese Schlussfolgerung gilt sowohl für den PicoRV32- als auch für den Ibex-Kern.
Die Steigerung von GPT‑6.2 Astra auf Ibex ist größer als auf PicoRV32. Insgesamt wurden 9881 gültige Bewertungsläufe für die gesamte Bewertung abgeschlossen, die zwei Aufgaben, zwei Prozessorkerne und alle Token-Ressourcenkonfigurationen abdecken.
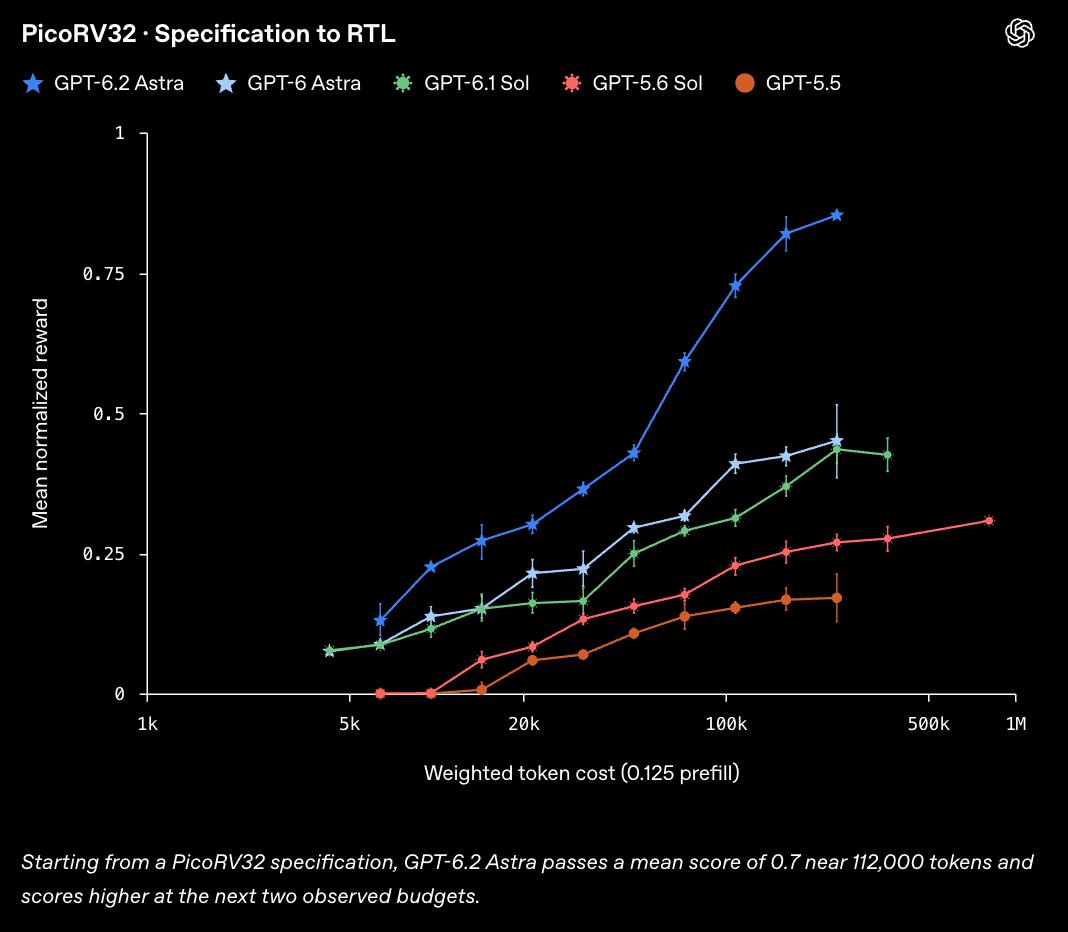
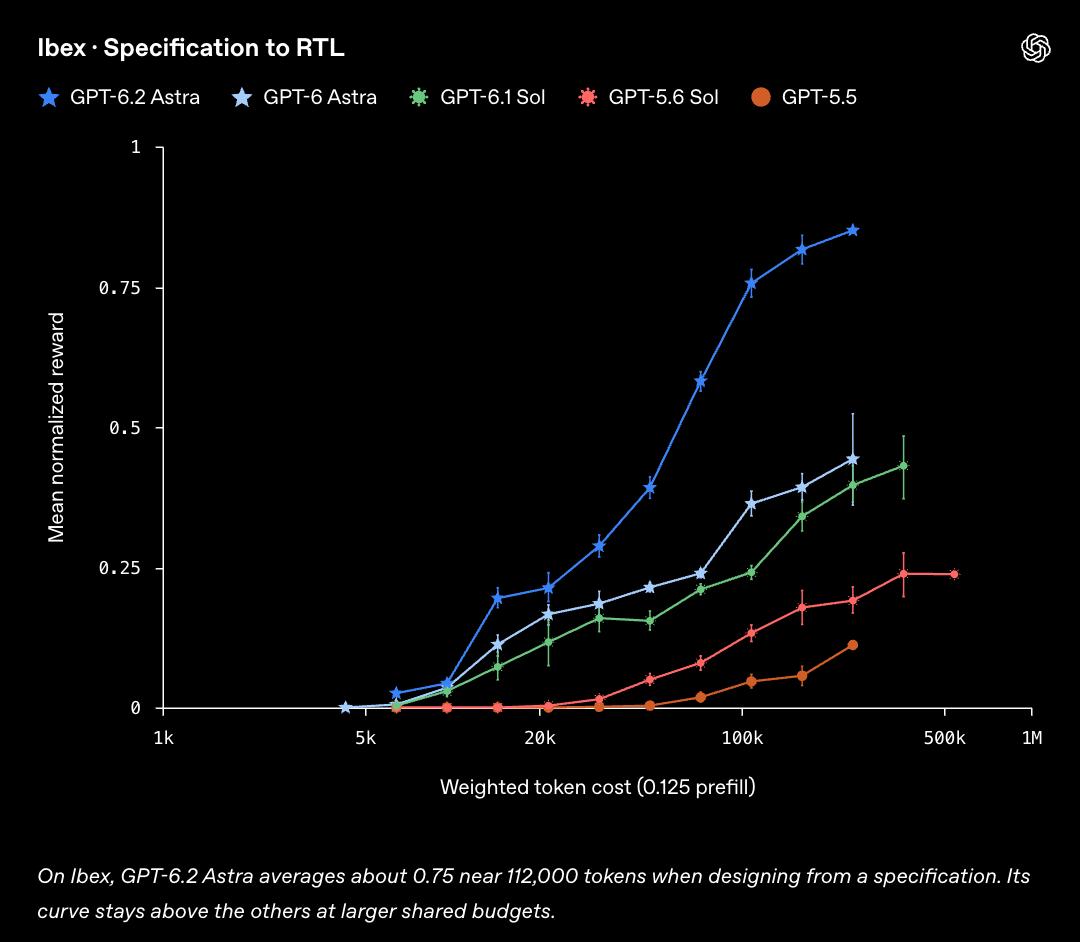
Bei der Neuentwicklung aus Null auf Grundlage schriftlicher Anforderungen kann das Modell einige Funktionen weglassen, die der ursprüngliche Kern mitbringt, wie beispielsweise Leistungsindikatoren und erweiterte Anweisungen. Diese Merkmale tragen nur begrenzt zur Durchsatzsteigerung unter den aktuellen Testlasten bei, was die höhere Punktzahl bei dieser Aufgabe teilweise erklären kann.
Laut OpenAI wird dieser Test realistischeren Szenarien des Serienchipdesigns näherkommen, wenn die Beibehaltung dieser Funktionen erzwungen, strengere Einschränkungen für die Schaltungsfläche festgelegt und eine Zeitprüfung nach der physischen Synthese durchgeführt werden.
03.
Schlussfolgerung: KI eröffnet ein neues Schlachtfeld für das Chipdesign
Aus den Forschungsergebnissen von OpenAI geht hervor, dass KI im Bereich des Chipdesigns bereits die Fähigkeit besitzt, inkrementelle Vorteile aus ausgereiften Seriendesigns zu erschließen und den Mikroarchitekturraum selbstständig auf Grundlage von Spezifikationen zu erkunden.
Dies könnte ein neues Schlachtfeld für den zukünftigen Wettbewerb um Chips hervorbringen: Chiphersteller müssen nicht nur auf Chipfertigungsverfahren, Gehäuse und die Architektur selbst achten, sondern auch darauf, wie die Effizienz durch KI gesteigert werden kann, um die PPA-Konvergenz schneller zu erreichen und den Entwicklungszyklus zu verkürzen.
Quelle: OpenAI
Dieser Artikel stammt vom WeChat-Offiziellen Konto „Zhidongxi“, Autor: Cheng Xi, Redakteur: Li Shuiqing, veröffentlicht mit Genehmigung von 36Kr.