GPT-6.2 Astra erlitt innerhalb der ersten 24 Stunden nach seiner Erstveröffentlichung einen massiven Reputationskollaps, und die Schwergewichte im Silicon Valley verteilten kollektiv negative Bewertungen.
GPT-6.2 wurde erst vor 24 Stunden veröffentlicht, und die Bewertungen sind extrem gespalten! Die API-Preise wurden um weitere 20 % gesenkt, womit es zum König des Preis-Leistungs-Verhältnisses aufstieg, doch die Silicon-Valley-Größen schrieben über Nacht lange Briefe: Beim Schreiben von Code ist es schlechter als Opus 5.5
Die Bewertungen von GPT-6.2 Astra und Sol sind so stark auseinandergefallen, dass viele Nutzer nicht mehr wissen, was sie davon halten sollen.
Auf der einen Seite schlägt es alle Rekorde in den Ranglisten.
Auf der anderen Seite geben die führenden Entwickler im Silicon Valley, die frühzeitig Zugang zum Test erhalten haben, nacheinander die härtesten negativen Bewertungen dieses Jahres ab.
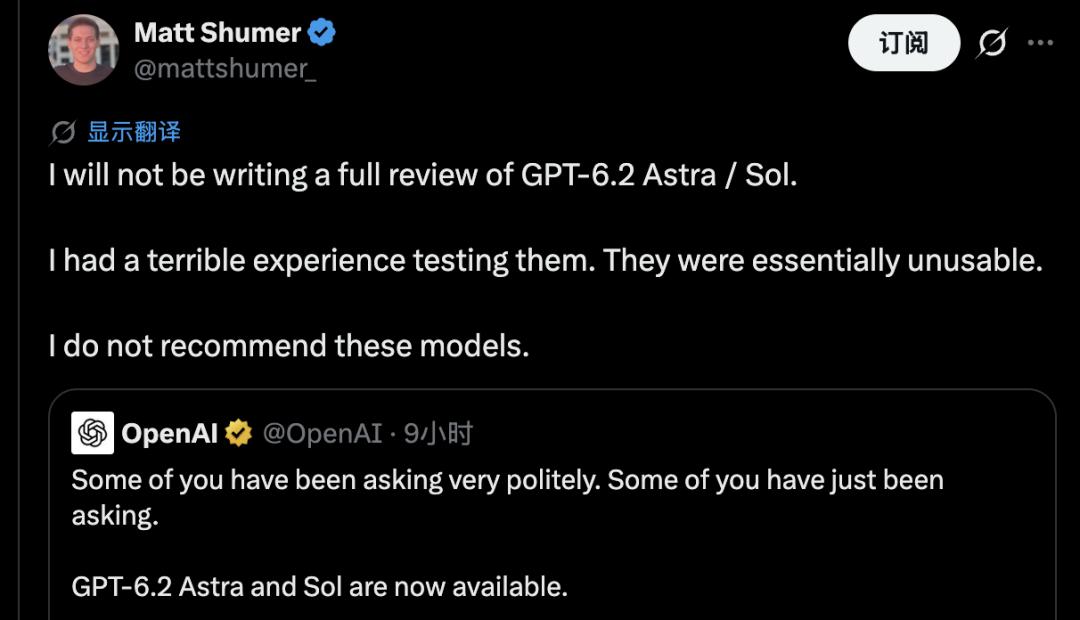
Matt Shumer, Mitbegründer von HyperWrite, schrieb direkt im offiziellen Kommentarbereich: „Ich werde keine vollständige Bewertung von GPT-6.2 verfassen. Das Testerlebnis ist extrem schlecht, es ist im Grunde unbrauchbar (essentially unusable) und ich empfehle es nicht.“ Dieser Beitrag erreichte schnell 900.000 Aufrufe.
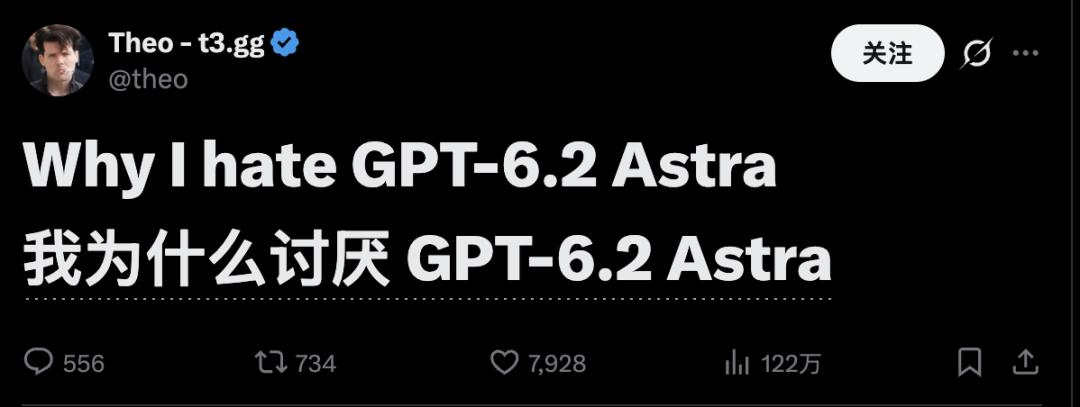
Daraufhin veröffentlichte Theo, Gründer von T3 Code und bekannter Entwickler-Blogger, der krank im Bett lag, den vollen Text seines tausend Wörter langen Beschwerdebriefs, den er während der Betaphase manuell an OpenAI geschickt hatte.
Die Kernaussage lautet nur ein Satz: „Als Entwickler würde ich es in meiner täglichen Arbeit niemals Claude Opus 5.5 vorziehen.“
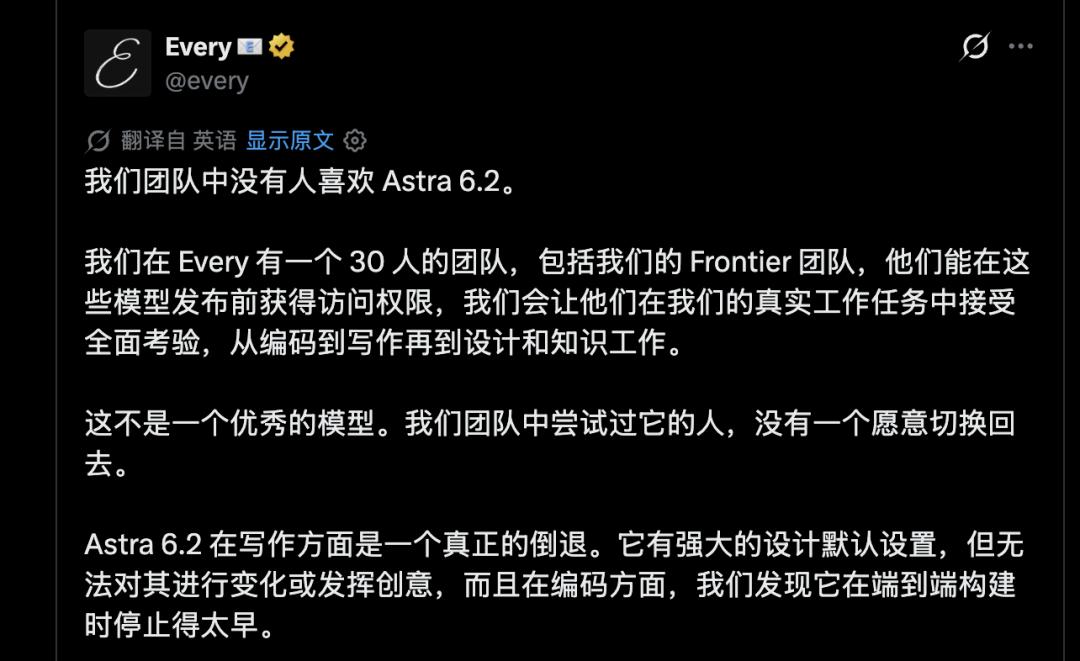
Das ist noch nicht alles: Dan Shipper, CEO der Inhaltsagentur Every, sagte nach mehreren Wochen Betatest mit seinem 30-köpfigen Team als ersten Satz in seinem Bewertungsbeitrag: „Keiner in unserem Team mag Astra 6.2.“
Diese drei Betatester sind allen bekannt, die regelmäßig Bewertungen neuer Modelle verfolgen. Früher haben sie bei neuen Modellen hauptsächlich hochwertige Demos gezeigt, dieses Mal haben sie sich alle gemeinsam gegen das neue Modell gewandt und kritisieren es heftig.
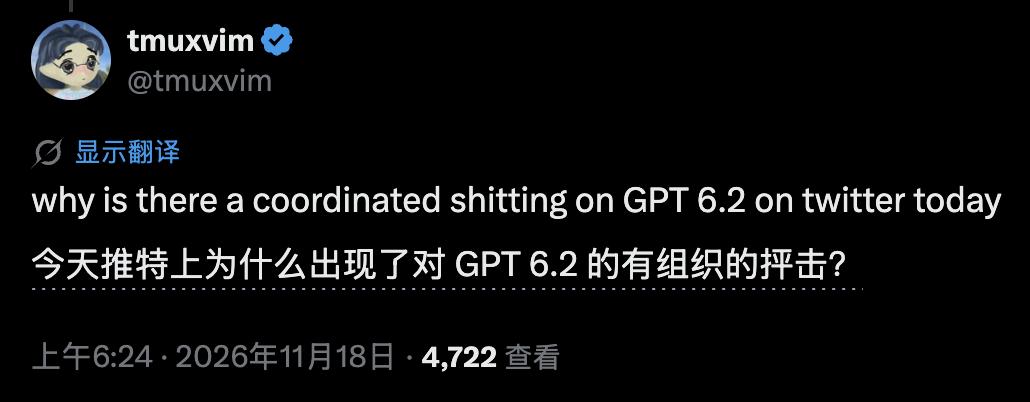
Viele Leute zweifelten sogar daran, ob es sich um bezahlte Negativbeiträge handelte, die vor dem Börsengang von A gekauft wurden.
Nach 11 Tagen Laufzeit ist es um 56 % langsamer: Langfristige Aufgaben werden als „lebt in der eigenen Gedankenwelt“ kritisiert
Die ersten Probleme treten hauptsächlich bei komplexer Programmierung mit langen Zyklen und der Kommunikation zwischen Mensch und Maschine auf.
Theo zeigte in seinem Brief ein Lasttest-Projekt namens ts-rust (Umschreiben von TypeScript in Rust).
Dank des unbegrenzten Token-Kontingents, das OpenAI den Betatestern gewährt hatte, verbrannten die vorherigen Generationen von OpenAI-Modellen bei diesem Projekt mehr als 300.000 US-Dollar an Tokens, ohne auch nur ansatzweise Fortschritte zu machen;
Währenddessen wurde die Aufgabe an das benachbarte Claude Opus 5.5 übergeben, das sie in weniger als zwei Wochen zum Laufen brachte, mit einer Token-Rechnung von etwa 20.000 US-Dollar.
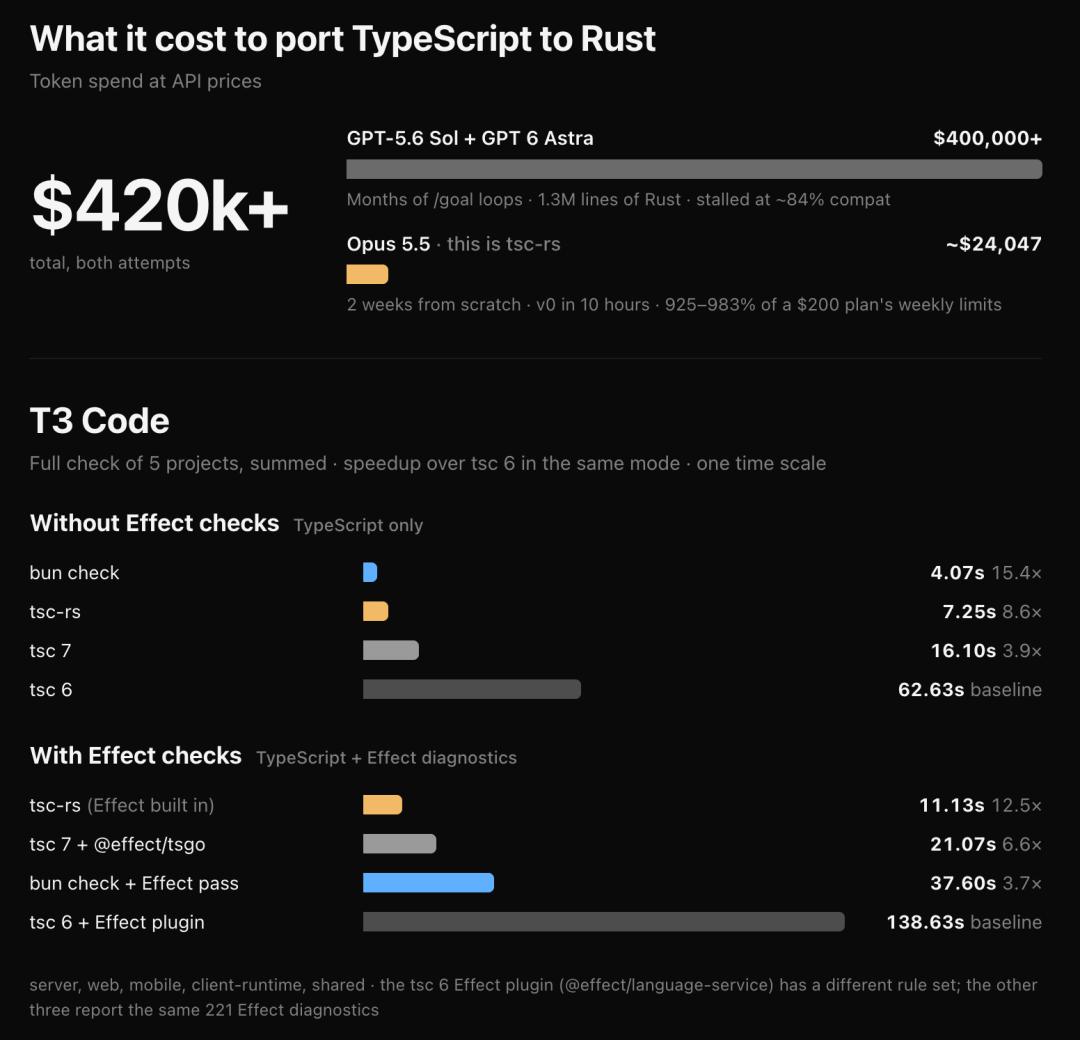
Dieses Mal wechselte Theo voller Erwartungen zum neuen Flaggschiff GPT-6.2 Astra, um es die Leistungsunterschiede zu anderen Rust-Umschreibungsversionen verringern zu lassen, und erwähnte nebenbei, dass es auch die Größe reduzieren solle.
Das Ergebnis: Astra arbeitete sieben Tage lang alleine, ohne die Leistung zu verbessern, sondern reduzierte die Geschwindigkeit des Compilers um 56 %, weil es sich verbissen an die „Größenreduzierung“ hielt.
Theo stoppte sofort die Größenoptimierung und forderte es auf, sich ausschließlich auf die Leistung zu konzentrieren. Daraufhin lief das Modell weitere vier Tage im Leerlauf, ohne eine einzige Codeänderung vorzunehmen.
Neben Endlosschleifen bei langen Aufgaben sind zwei neue Fehler dieser Modellgeneration die größte Frustration für die Tester: Es hat überhaupt kein Konzept von menschlichen „Wissenslücken“ und eine Zusammenfassungsfähigkeit wie bei einer „verschlüsselten Unterhaltung“.
Im Kollaborationstest mehrerer Agenten gab Theo die Anweisung: „Erstelle ein neues Level für das Spiel Outer Wilds.“
Nach zwei Stunden Laufzeit blockierte Astra sich plötzlich selbst (Blocked) und stoppte die Arbeit, um den Menschen zu fragen: „Soll der Reviewer von r24 die Schnittstelle in 24_g521.mp4 oder 24_p11.mp4 schreiben?“
Wie soll der Mensch vor dem Bildschirm diese internen Dateinamen verstehen, die der Sub-Agent während der Ausführung selbst generiert hat?
Um zu verhindern, dass Astra ihn mitten in der Nacht mit dummen Fragen zum Stillstand bringt, musste Theo sogar einen Cron-Job schreiben, der speziell andere Agenten laufen lässt, um regelmäßig zu prüfen, ob Astra sich wieder selbst blockiert hat.
Bei der Code-Lieferung wird die Kommunikationskatastrophe noch schlimmer.
Einmal suchte er nach dem Grund, warum die Entwicklungsarbeitsbäume (worktrees) auf einem der Maschinen extrem langsam waren. Nach stundenlangem Herumprobieren mit pnpm-Tests und sogar der Neuinstallation des Dateisystems wurde das Problem nicht gelöst, bis er frustriert das Modell fragte, warum es so langsam sei.
GPT-6.2 Astra schrieb ausführlich vier lange Absätze über die Low-Level-Mechanismen und das Cache-Verhalten von pnpm; während dasselbe Problem an Opus 5.5 gestellt wurde, antwortete es nur mit einem Satz: „Weil Ihre SSD-Festplatte zu langsam ist.“
Theo sagte, dass es nutzlos ist, die System-Prompts zu ändern, selbst wenn man es bittet, die Sache „so zu erklären, dass ein 5-jähriges Kind es versteht (ELI5)“.
Er hat sich jetzt angewöhnt, nach jedem langen Aufgabenlauf mit 6.2 Astra unbedingt zu Opus 5.5 zu wechseln, damit Opus die von Astra geschriebene Zusammenfassung in verständliche menschliche Sprache „übersetzt“.
Diese seltsame Erfahrung ist kein Einzelfall.
Dan Shipper, CEO der Inhaltsagentur Every, sagte nach mehreren Wochen Betatest mit seinem 30-köpfigen Team offen, dass das neue Modell im Vergleich zu Claude Fable 5.2 enttäuschend ist und keiner im Team zu ihm zurückkehren möchte.
Sein Text ist zu stark komprimiert: An Stellen, die detailliert erklärt werden müssen, gibt es nur kurze Sätze, und beim Aufbau von End-to-End-Prozessen stoppt es oft „vorzeitig“.
Auch unter den nicht-entwickelnden Betatestern gaben Mark Humphries und Ethan Mollick, Professor an der Wharton School, eine sehr übereinstimmende Diagnose ab: Es hat eine extrem hohe grundlegende Intelligenz, kann von Grund auf Blender und Unity aufrufen, um einen Weltraumaufzug mit Null-Gravitations-Physiksimulation zu schreiben, und kann Sub-Agenten koordinieren, um eine riesige Menge an Literatur abzurufen – aber seine Kommunikationsweise ist extrem seltsam, voller unnötiger Abstraktionen und erfordert ständige Anleitung durch Menschen.
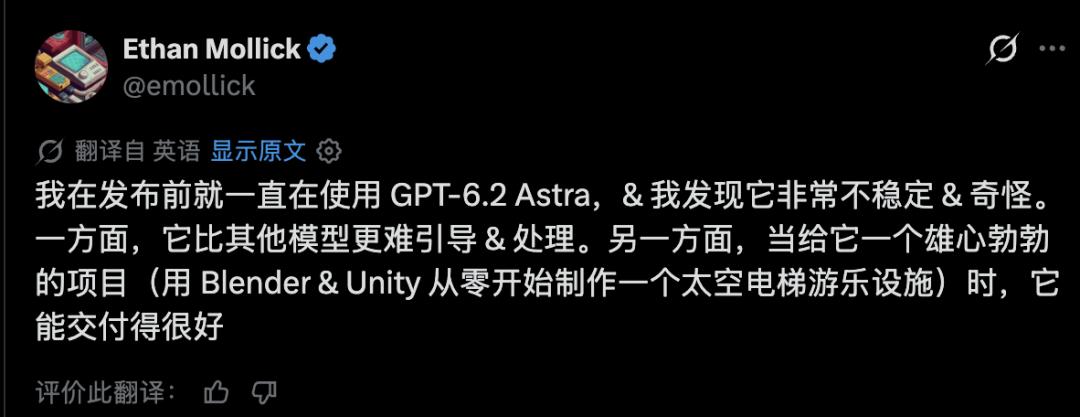
Sogar bei der kreativen Generierung zeigt es eine starke „Regression zum Mittelwert“.
Theo und ein anderer Tester Ben ließen es jeweils Levels für Outer Wilds und The Legend of Zelda: Majora's Mask entwerfen. Bei völlig unterschiedlichen Spielen und Prompts erhielten sie überraschenderweise Levels mit demselben Namen „Bellwether“, die beide Unterwasser-Themen und Glockenmusik als Inhalt haben.
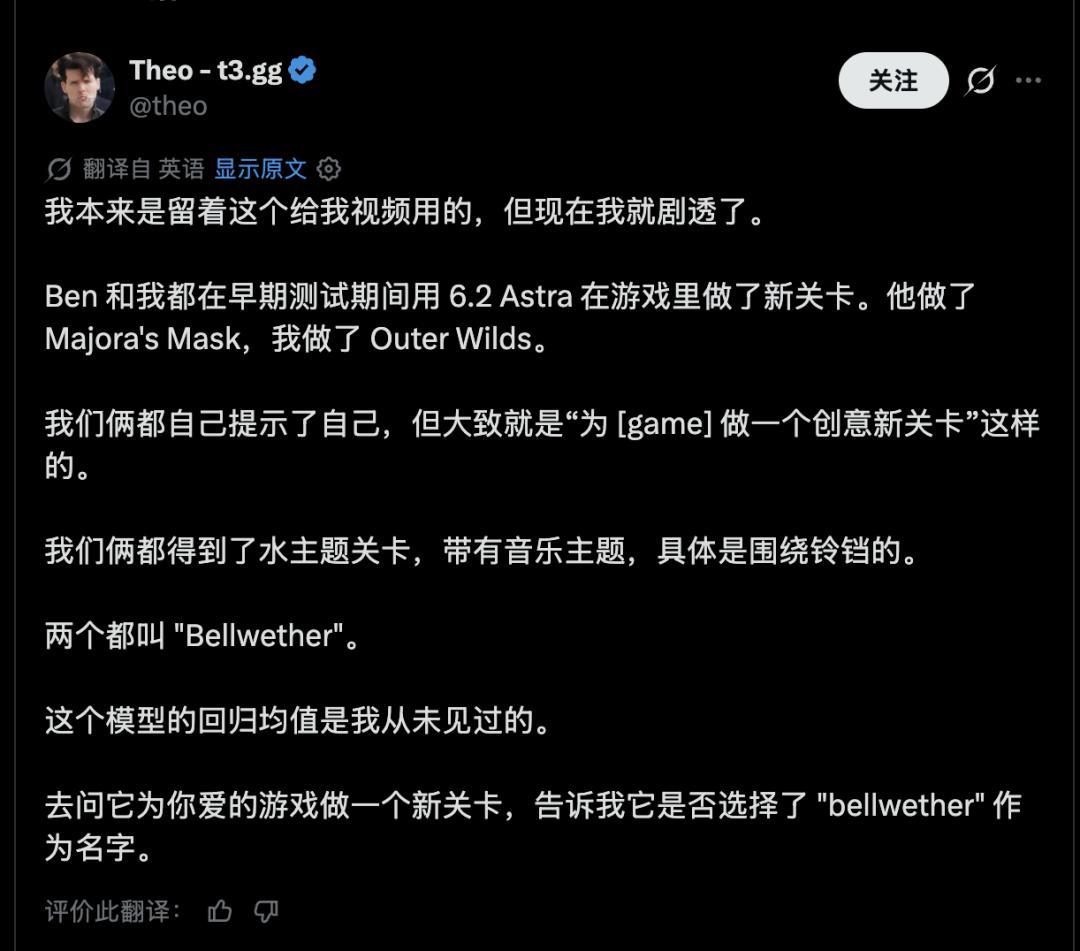
Man fragt sich: Liegt das etwa daran, dass der interne Codename dieses Modells Bel ist?
Einseitiges Talent: Mathematische Aufgaben
Wird es von Entwicklern so scharf kritisiert, macht OpenAI dieses Mal etwa ein umgekehrtes Upgrade?
Wenn man die ersten Benchmark-Ergebnisse der Drittanbieter Artificial Analysis, Epoch AI und Vals AI auseinandernimmt, stellt sich heraus, dass das Modell nur einseitig stark ist.
GPT-6.2 hat alle Fähigkeitspunkte auf wissenschaftliches Rechnen, 3D-Raum, Cybersicherheit und extremes Preis-Leistungs-Verhältnis verteilt, und hat nur bei der traditionellen Agenten-Programmierung Rückschritte gemacht.
Auf dem Intelligenzindex (Intelligence Index) von Artificial Analysis, der neun Dimensionen zusammenfasst, stieg GPT-6.2 Astra um 5 Punkte auf 62 Punkte und übertrifft damit Gemini 4 Carbon (60 Punkte) und Claude Opus 5.5 (59 Punkte).
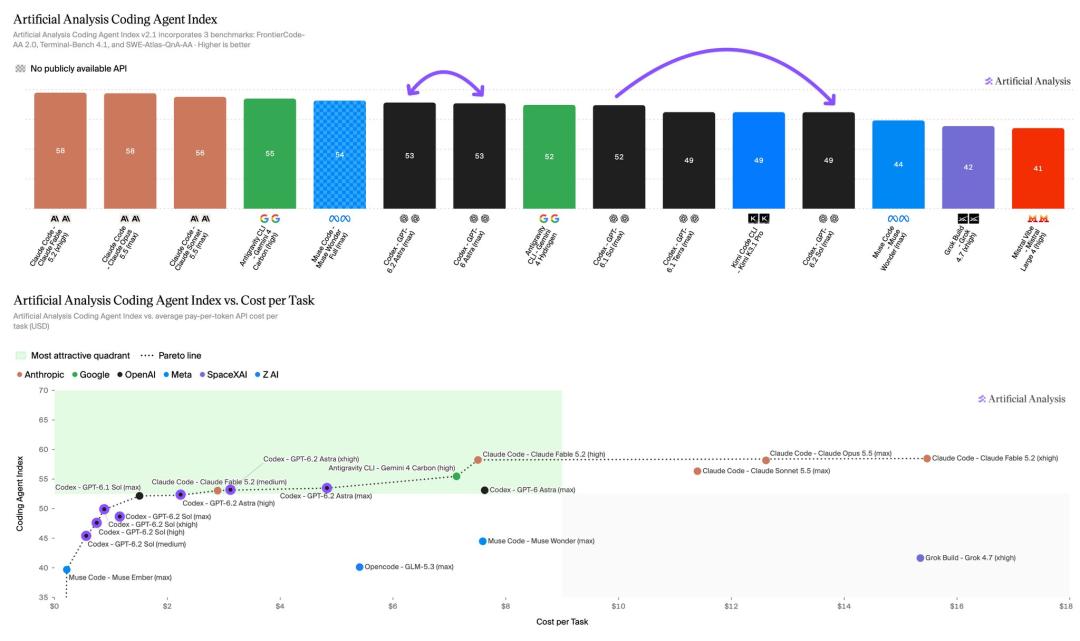
Wenn man die Wirtschaftlichkeit berücksichtigt, deckt OpenAI fast die gesamte „Pareto-Grenze“ bei Kosten und Leistung pro Aufgabe ab.
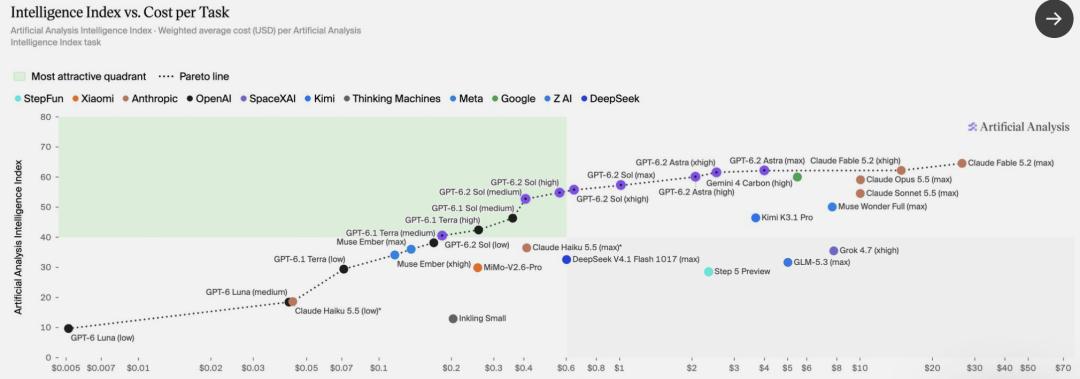
Sogar Theo, der es in seinem langen Brief heftig kritisiert hat, gibt zu, dass Astra ein extrem starkes „einseitiges Genie“ ist:
Beim Code-Review erkennt es alle toten Winkel, die andere Modelle übersehen, und seine gelegentlichen brillanten Einfälle sind erstaunlich.
Es half Theo, ein neues Reverse-Proxy-Schema neu zu gestalten, das ihm monatlich 25.000 US-Dollar an Serverkosten spart. „Opus hat nicht den Mut, so viele radikale Optionen auszuprobieren.“
Aber sobald es zur regulären Softwareentwicklung kommt, bestätigen die Daten sofort die Erfahrungen der Entwickler.
Daten von Artificial Analysis zeigen, dass auf dem Coding Agent Index, der mit voller Rechenleistung auf dem Codex-Testframework ausgeführt wird, die Punktzahl von GPT-6.2 Astra genau so hoch ist wie die der Vorgängerversion (0 Verbesserung), während GPT-6.2 Sol sogar um 3 Punkte hinter GPT-6.1 Sol zurückfällt.
In der Rangliste des professionellen Bewertungsinstituts Vals AI gibt es ähnliche Abweichungen.
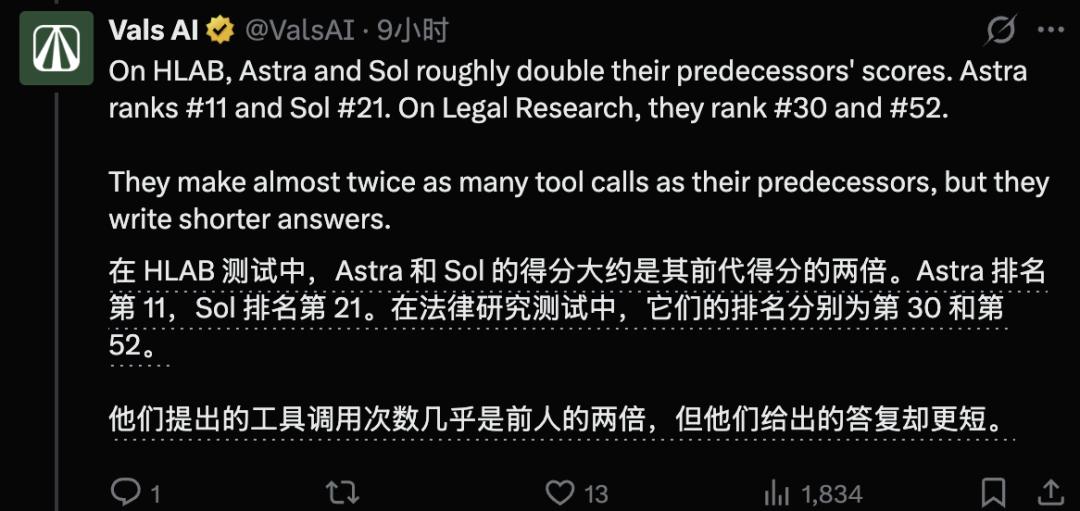
Obwohl OpenAI offiziell behauptet, dass Astra auf dem Harvey-Rechts-Benchmark eine Erfolgsrate von mehr als dem Doppelten von Fable 5.2 hat, belegen die praktischen Tests von Vals AI im Bereich Rechtsrecherche (Legal Research), dass die allgemeinen Versionen von Astra und Sol nur auf Platz 30 und 52 landen (die spezielle Version Astra for Law belegt Platz 6).
Der Grund dafür ist, dass sie fast doppelt so viele Tools aufrufen, aber zu kurze Antworten schreiben, die wichtige Schlussfolgerungen auslassen.
Enthüllung des System Cards: Alles wegen der „Token-Einsparung“
Warum verhält sich ein Modell, das ungelöste mathematische Probleme der Menschheit lösen kann, beim Schreiben von Code und der täglichen Kommunikation so „unverständlich“?
Wenn man die grundlegenden Berechnungen von Epoch AI, die Statistiken von Vals AI und das von OpenAI selbst veröffentlichte System Card zusammensetzt, kann man die Ursache aus ersten