Jason Wei, der Vater der Chain-of-Thought, verlässt Meta und schließt sich dem mit 20 Milliarden US-Dollar bewerteten KI-Einhorn an.
Aus dem Super-Intelligenz-Labor von Meta ist ein weiterer hochkarätiger Forscher abgewandert.
Diesmal handelt es sich um Jason Wei, der als „Vater der Gedankenkette“ bekannt ist.
Am 18. November gab Brendan Foody, Mitbegründer und CEO des KI-Startups Mercor, auf der Plattform X bekannt, dass Jason Wei offiziell zu Mercor stößt und die Position des Chefwissenschaftlers (Chief Scientist) übernimmt.
Jason Wei bestätigte die Nachricht im Anschluss ebenfalls. Er erklärte, dass er sich nach einem großartigen Jahr im Meta TBD Lab sehr freue, zu Mercor zu stoßen. Er wies besonders darauf hin, dass Daten die nächste Entwicklungsstufe der KI prägen werden, da immer mehr Unternehmen damit beginnen, KI-Modelle zu trainieren.
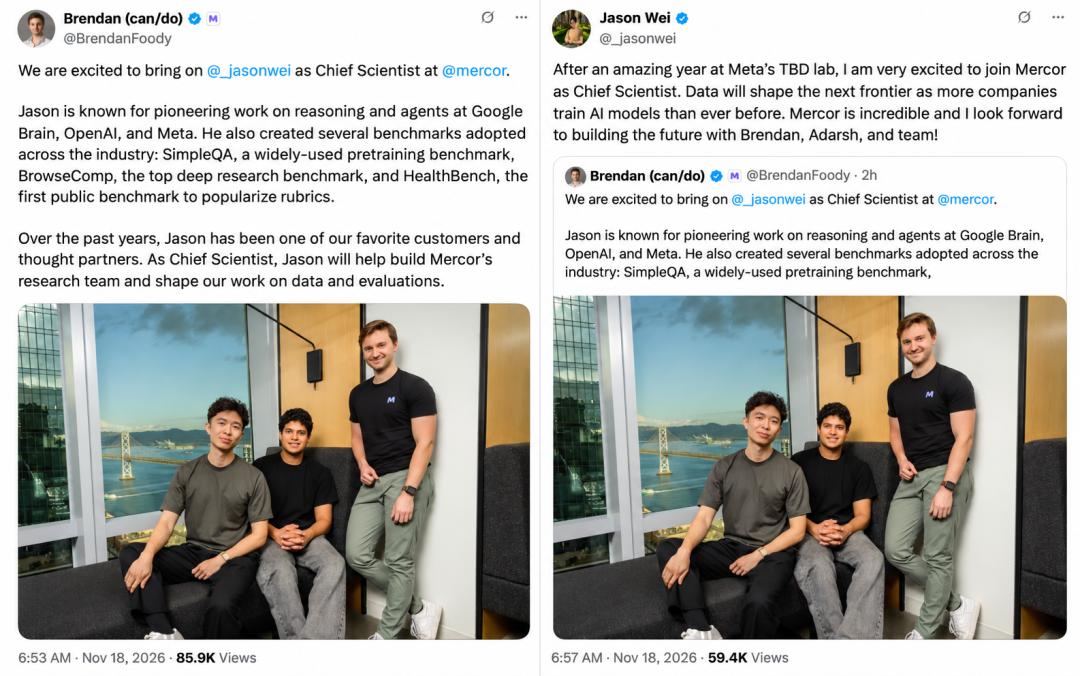
Es ist bemerkenswert, dass Jason Weis neuer Arbeitgeber nicht Google DeepMind, OpenAI oder ein anderes Spitzenlabor für große Modelle ist, sondern Mercor – ein Startup, das ursprünglich mit KI-gestützter Personalbeschaffung und Expertendatendiensten gestartet ist.
Erst vor einer Woche gab Mercor den Abschluss einer D-Finanzierungsrunde über 750 Millionen US-Dollar bekannt, wodurch das Unternehmen eine Bewertung von 20 Milliarden US-Dollar erreicht.
Von Google Brain über OpenAI bis hin zum Super-Intelligenz-Labor von Meta hat Jason Wei nun Mercor ausgewählt. Warum entscheidet sich dieser renommierte Forscher auf dem Gebiet der Schlussfolgerung großer Modelle für ein KI-Datenunternehmen als nächste Station?
Von Google Brain über OpenAI bis Meta: Der Forschungsweg des Vaters der Gedankenkette
Auf dem Gebiet der Forschung an großen Modellen ist Jason Wei ein Name, der nicht ignoriert werden kann.
Jason Wei arbeitete nacheinander bei Google Brain, OpenAI und Meta, wobei seine Forschungsschwerpunkte die Schlussfolgerung großer Sprachmodelle, intelligente Agenten sowie die Modellbewertung umfassen.
Berühmt wurde er durch das 2022 veröffentlichte Paper mit dem Titel „Chain-of-Thought Prompting Elicits Reasoning in Large Language Models“.
Als Erstautor dieses Papers entwickelten Jason Wei gemeinsam mit Forschern von Google Brain die Methode des Chain-of-Thought-Promptings (Gedankenketten-Prompting, CoT).
Damals konnten große Sprachmodelle bereits viele Aufgaben der natürlichen Sprache bewältigen, zeigten aber bei mathematischen Problemen, die mehrstufige Schlussfolgerungen erfordern, oft schlechte Leistungen.
Das Forschungsteam stellte fest, dass es besser ist, Beispiele mit zwischengeschalteten Schlussfolgerungsschritten in die Prompt aufzunehmen, um das Modell anzuleiten, Berechnungen Schritt für Schritt durchzuführen, statt das Modell direkt nach der Antwort zu fragen.
Bei einer mathematischen Anwendungsaufgabe beispielsweise würde eine gewöhnliche Prompt das Modell nur auffordern, die endgültige Zahl auszugeben, während ein Gedankenketten-Prompt zeigt, wie man Bedingungen analysiert, Berechnungsschritte auflistet und schließlich die Antwort erhält.
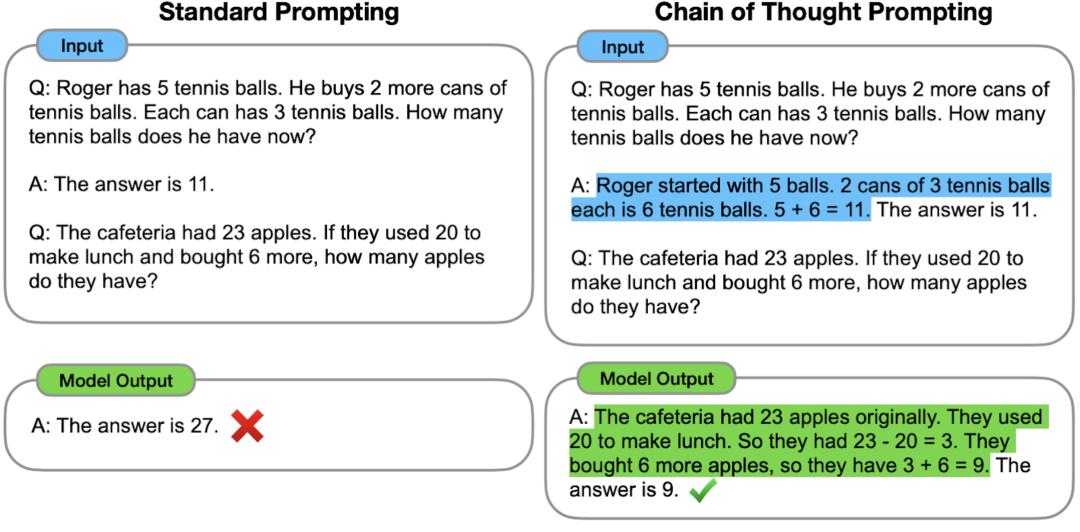
Diese Methode erfordert keine Änderung der Modellparameter. Durch die einfache Anpassung der an das Modell übermittelten Prompt-Beispiele lässt sich die Leistung großer Sprachmodelle bei mehrstufigen Schlussfolgerungen deutlich verbessern.
Im Anschluss daran wurde CoT zu einer der einflussreichsten Methoden in der Forschung zur Schlussfolgerung großer Modelle, und es entstanden weitere Forschungen zur Selbstkonsistenz von Gedankenketten, zur Suche nach Schlussfolgerungspfaden und mehr.
2023 wechselte Jason Wei zu OpenAI, beteiligte sich an Projekten wie OpenAI o1 und Deep Research und wirkte an der Entwicklung mehrerer Modellbewertungs-Benchmarks mit.
Das 2024 veröffentlichte SimpleQA dient hauptsächlich dazu, die Genauigkeit großer Sprachmodelle bei der Beantwortung faktischer Fragen zu messen. Es umfasst 4326 Fragen mit eindeutigen Antworten, um zu prüfen, ob das Modell Fragen korrekt beantworten kann und weiß, wenn es eine bestimmte Frage nicht beantworten kann.
Das 2025 veröffentlichte BrowseComp bewertet hauptsächlich die komplexe Websuchfähigkeit von KI-Agenten. Im Vergleich zu gewöhnlichen Faktabfragen erfordern die Fragen in BrowseComp oft mehrere Suchläufe, Informationsfilterung und Kreuzvalidierung, um die Antwort zu finden.
HealthBench hingegen ist für den medizinischen Bereich konzipiert und bewertet die Leistung von Modellen in echten medizinischen Dialogen anhand detaillierter, von Ärzten festgelegter Bewertungsstandards in mehreren Dimensionen wie Genauigkeit, Kommunikationsqualität und Einhaltung von Anweisungen.
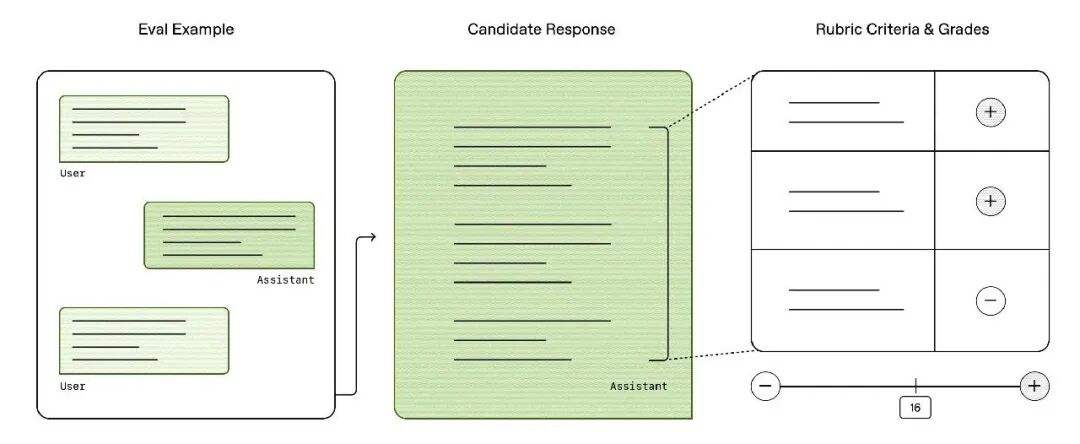
Von CoT über SimpleQA und BrowseComp bis hin zu HealthBench erstreckt sich Jason Weis Forschungserfahrung über die Verbesserung der Schlussfolgerungsfähigkeiten großer Modelle und die Methoden zur Bewertung dieser Fähigkeiten.
Im Juli 2025 wechselte er von OpenAI zu dem neu gegründeten Super-Intelligenz-Labor von Meta und wurde einer der bekannten KI-Forscher, die Meta zu diesem Zeitpunkt von Konkurrenten abgeworben hatte.
Nun, nach mehr als einem Jahr Arbeit bei Meta, hat er erneut eine neue Richtung gewählt.
Gerade 750 Millionen US-Dollar eingesammelt: Was ist Mercor für ein Unternehmen?
Im Vergleich zu den großen KI-Konzernen, bei denen Jason Wei früher tätig war, ist der Name Mercor vielleicht noch nicht so weit verbreitet. Aber auf dem Markt für KI-Trainingsdaten und Modellbewertungen ist dieses Unternehmen zu einem Einhorn mit einer Bewertung von 20 Milliarden US-Dollar herangewachsen.
Mercor wurde 2023 von Brendan Foody, Adarsh Hiremath und Surya Midha gemeinsam gegründet.
Das Unternehmen startete ursprünglich mit dem KI-gestützten Geschäft der Personalbeschaffung, um Unternehmen bei der Suche und Zuordnung passender Fachkräfte zu unterstützen. Mit der rasanten Entwicklung der generativen KI verlagerte Mercor seinen Geschäftsfokus allmählich darauf, Spitzenmodell-Unternehmen mit Fachkräften, Trainingsdaten und Bewertungsdiensten zu versorgen.
Wenn beispielsweise ein KI-Labor die Fähigkeit seines Modells zur Finanzanalyse verbessern möchte, reichen allgemeine Internet-Texte allein möglicherweise nicht aus. Es braucht Fachkräfte, die mit Finanzarbeitsabläufen vertraut sind, um reale Aufgaben zu entwerfen, die Ausgaben des Modells zu bewerten und hochwertige Trainingsbeispiele bereitzustellen.
Mercor organisiert Fachkräfte aus verschiedenen Bereichen, um Daten und Feedback für das Training und die Bewertung von KI-Modellen bereitzustellen. Derzeit umfasst sein Expertennetzwerk mehr als 5 Millionen Menschen und ist zu einem wichtigen Dienstleister für Spitzenmodell-Labore geworden.
Am 10. November gab Mercor den Abschluss einer D-Finanzierungsrunde über 750 Millionen US-Dollar bekannt, bei einer Bewertung von 20 Milliarden US-Dollar. Zu den investierenden Einrichtungen gehören Benchmark, General Catalyst sowie Nvidia, Salesforce und andere.
Das Ziel von Mercor geht aber inzwischen über die Bereitstellung von Expertendaten für KI-Labore hinaus.
In der Mitteilung zur Finanzierung gab das Unternehmen klar an, dass die neuen Mittel für weitere Investitionen in Modellbewertung, Infrastruktur für das Nachtraining und den Aufbau von Umgebungen verwendet werden, in denen KI-Agenten komplexe Arbeitsabläufe erlernen können.
Gleichzeitig erweitert Mercor die Fähigkeiten, die ursprünglich für Spitzenlabore entwickelt wurden, nun auch auf Unternehmenskunden.
Verschiedene Unternehmen verfügen über eigene Geschäftssysteme, interne Regeln und Qualitätsstandards. Selbst wenn ein allgemeines Modell gute Ergebnisse an öffentlichen Benchmarks erzielt, kann es nicht unbedingt direkt die spezifischen Arbeitsaufgaben eines bestimmten Unternehmens erledigen.
Daher müssen Unternehmen Bewertungssysteme entwickeln, die auf ihre eigenen Aufgaben zugeschnitten sind, und anschließend mithilfe von Expertenfeedback und spezialisierten Daten die Leistung des Modells verbessern.
Für Mercor bedeutet dies, dass das Geschäft sich von der Organisation von Experten für das Modelltraining weiter erstreckt, um Kunden bei der Bewertung, Verbesserung und Anpassung von KI-Modellen zu unterstützen.
Und der Eintritt von Jason Wei fällt genau in die Phase, in der das Unternehmen seine Forschungsinvestitionen erhöht.
Der Vater der Gedankenkette und der Autor von LoRA treffen sich bei Mercor
Tatsächlich hatte Mercor bereits vor dem Eintritt von Jason Wei damit begonnen, sein eigenes KI-Forschungsteam aufzubauen.
Am 8. Oktober veröffentlichte Mercor einen Artikel mit dem Titel „Why Mercor Is Building a Research Team“, in dem es seine Forschungspläne offiziell vorstellte.
Der Kerngedanke lautet: Zuerst werden reale Arbeitsaufgaben identifiziert, die das Modell nicht bewältigen kann, mithilfe von Fachexperten die Gründe für das Scheitern verstanden und Trainingsdaten erstellt, dann die Modellfähigkeiten durch Nachtraining verbessert und schließlich die Verbesserungswirkung neu bewertet.
Aus diesem Grund forscht Mercor an Themen wie der Bewertung realer Arbeitsaufgaben, der Qualität von Trainingsdaten, dem Nachtraining von Modellen und der Frage, wie menschliches Fachwissen die Verbesserung der KI-Fähigkeiten vorantreiben kann.
Auf dem Gebiet der Bewertung realer Arbeiten hat Mercor bereits die APEX-Benchmark-Reihe eingeführt, die Berufsfelder wie Managementberatung, Investmentbanking, Unternehmensrecht, Rechnungswesen und Softwareentwicklung abdeckt. Diese Bewertungen unterscheiden sich von herkömmlichen Wissensabfragen, da sie vor allem prüfen, ob die KI Aufgaben mit praktischen Arbeitsanforderungen bewältigen kann.
Auf dem Gebiet des Modelltrainings hat Mercor zudem bereits konkrete experimentelle Ergebnisse veröffentlicht. In Nachtraining-Experimenten nutzte Mercor das Qwen3.5-397B-Modell und konnte dessen Pass@1-Ergebnis auf der APEX-Agents-Benchmark von 16 % auf 27 % steigern.
Noch interessanter ist, dass Mercor bereits eine Gruppe von Forschern mit repräsentativen Forschungsergebnissen auf dem Gebiet großer Modelle versammelt hat.
Dazu gehört unter anderem Edward J. Hu.
Edward J. Hu ist Erstautor des bekannten Papers „LoRA: Low-Rank Adaptation of Large Language Models“ und arbeitete zuvor ebenfalls bei OpenAI.
LoRA führt eine parametereffiziente Feinabstimmung großer Modelle durch niedrigrangige Matrizen durch und reduziert die Anzahl der Parameter, die für die Anpassung des Modells trainiert werden müssen, erheblich. Es ist inzwischen zu einer der weitverbreiteten Technologien auf dem Gebiet der Feinabstimmung großer Modelle geworden.
Neben Edward J. Hu umfasst das Forschungsteam von Mercor auch Minyang Tian, Erstautor von SciCode und CritPt, Victor Barres, Erstautor von tau²-bench, sowie weitere Forscher von Einrichtungen wie Anthropic und Ai2.
Nun, mit dem Eintritt von Jason Wei, hat dieses Unternehmen, das ursprünglich mit KI-Personal- und Datendiensten gestartet ist, einen weiteren Forscher mit bedeutendem Einfluss auf dem Gebiet der Schlussfolgerung und Modellbewertung gewonnen.
Erwähnenswert ist, dass Brendan Foody, Gründer von Mercor, in der offiziellen Mitteilung verriet, dass Jason Wei in den letzten Jahren nicht nur Kunde von Mercor, sondern auch einer der wichtigen Gesprächspartner des Unternehmens war.
Brendan Foody erklärte in der Mitteilung, dass Jason Wei Mercor beim Aufbau des Forschungsteams unterstützen und den Forschungsschwerpunkt auf Daten und Bewertung vorantreiben wird.
Diese Richtung weist viele Überschneidungen mit Jason Weis früherer Arbeit bei OpenAI auf. Er war an der Entwicklung von Bewertungs-Benchmarks wie SimpleQA, BrowseComp und HealthBench beteiligt, während Mercor die Modellbewertung nun auf reale Arbeitsbereiche wie Finanzen, Recht und Softwareentwicklung ausweitet und versucht, die Modelle anhand der Bewertungsergebnisse zu verbessern.
Jason Wei sprach in seiner persönlichen Mitteilung ebenfalls über die Bedeutung von Daten. Er ist der Ansicht, dass Daten die nächste Entwicklungsstufe der KI prägen werden, da immer mehr Unternehmen damit beginnen, KI-Modelle zu trainieren.
Für ein Unternehmen, das sich von Expertendatendiensten zu Forschung im Bereich KI-Bewertung und Nachtraining weiterentwickelt, ist dies vielleicht genau der Grund für die Zusammenarbeit der beiden Seiten.
Von der Gedankenkette über die Modellbewertung bis hin zu heutigen Forschungen zu realen Arbeitsaufgaben und Daten ist Jason Weis nächste Station weiterhin aufmerksam zu verfolgen.
Referenzlinks:
https://x.com/BrendanFoody/status/2122825607763689873
https://x.com/_jasonwei/status/212282660