GPT-6.2 Astra wurde unmittelbar nach seiner Veröffentlichung mit einer großen Anzahl negativer Bewertungen überhäuft, nach meinen praktischen Tests finde ich, dass es etwas zu Unrecht so schlecht bewertet wurde.
OpenAI hat wahrscheinlich nicht erwartet, dass sein sorgfältig vorbereitetes neues Modell direkt nach der Veröffentlichung eine recht lebhafte öffentliche Debatte auslösen würde.
In den frühen Morgenstunden heute hat OpenAI offiziell GPT-6.2 Astra und GPT-6.2 Sol vorgestellt, die auf stärkere professionelle Arbeitsfähigkeit, höhere Token-Effizienz und weiter gesenkte Nutzungskosten setzen.
Nach den offiziell veröffentlichten Ergebnissen zeichnen sich die neuen Modelle in Bereichen wie Programmierung, wissenschaftliche Forschung, professionelle Büroarbeit und 3D-Design aus, wobei die Abschlusskosten einiger Aufgaben sogar unter einem Drittel der Vorgängergeneration liegen.
In den ersten praktischen Tests von Entwicklern zeigen die Bewertungen von GPT-6.2 jedoch eine deutliche Polarisierung. Wir haben es sofort ausprobiert, um zu sehen, wie sich die GPT-6.2-Modellreihe tatsächlich verhält?
GPT-6.2 tritt auf: Bessere Benchmark-Ergebnisse, intelligenter und günstiger
Die beiden diesmal vorgestellten Modelle haben unterschiedliche Positionierungen: GPT-6.2 Astra ist für komplexe professionelle Aufgaben ausgelegt, während GPT-6.2 Sol mehr Wert auf Effizienz und Kosten legt und alltägliche Büroarbeit, Programmierung und mehrstufige Agent-Arbeitsabläufe abdeckt.
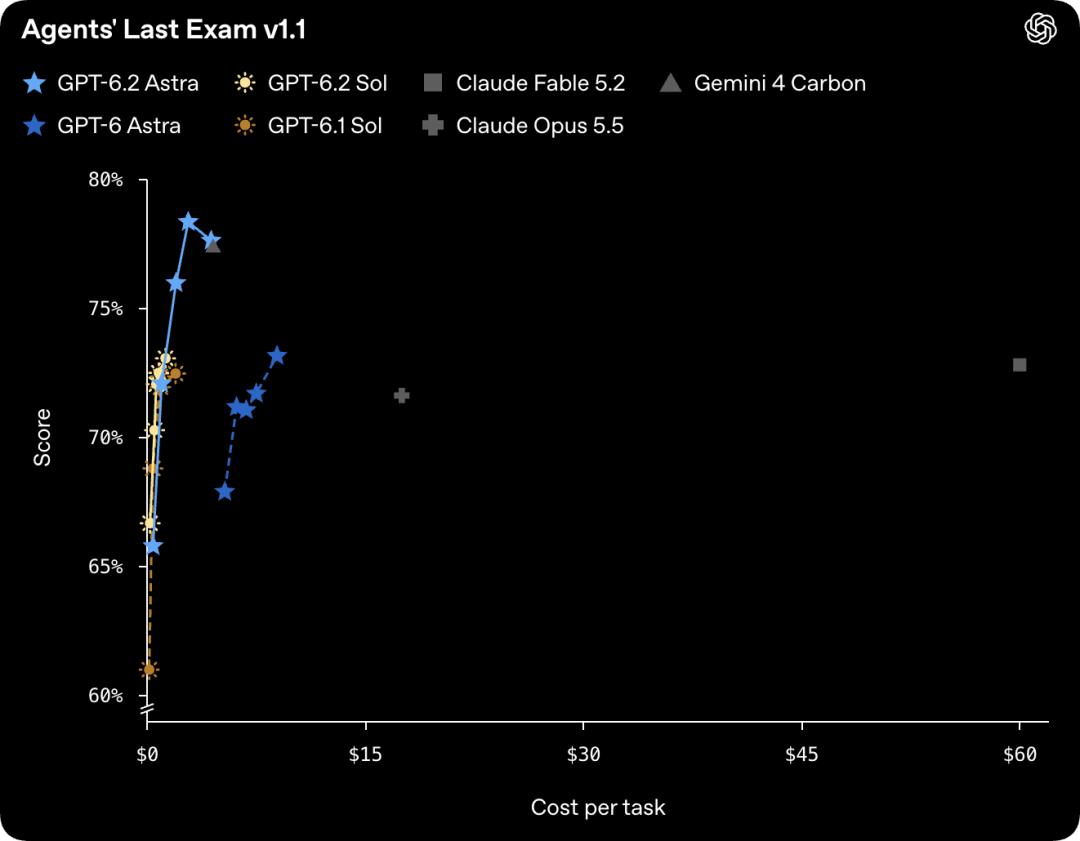
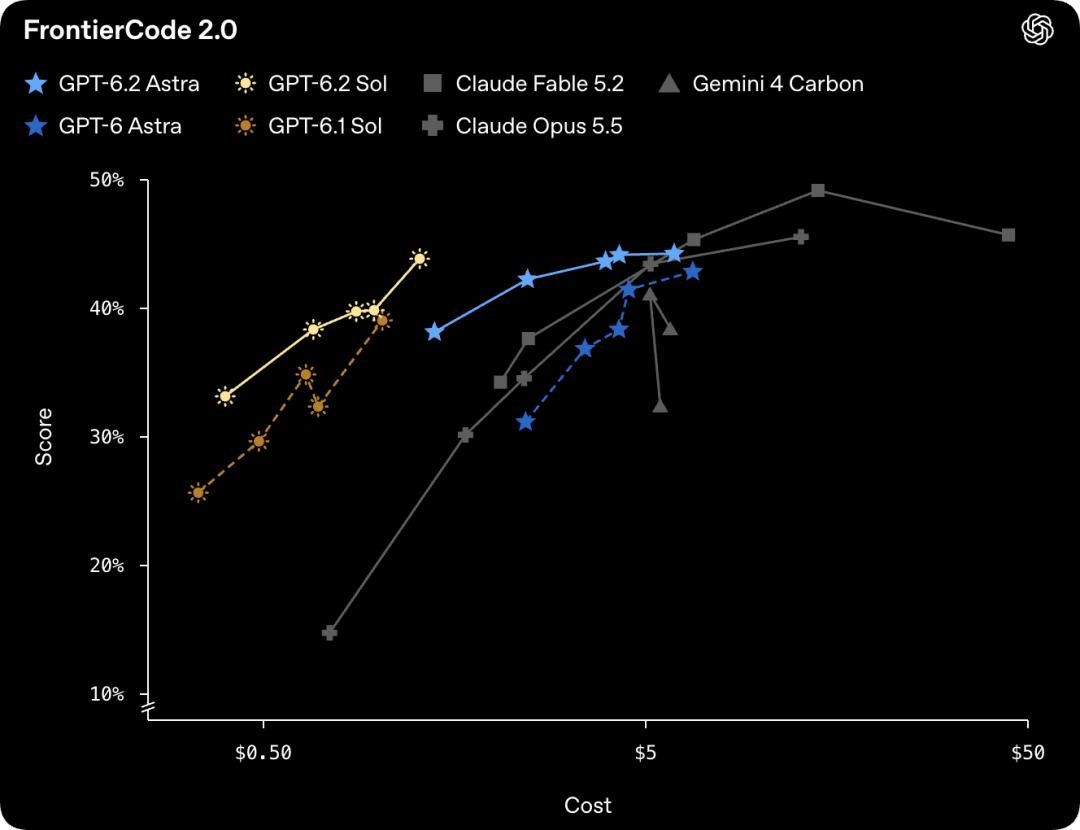
Im Agents' Last Exam-Test, der langfristige, mehrstufige professionelle Aufgaben misst, liegt GPT-6.2 Astra 5,2 Punkte über der Vorgängergeneration, wobei die Kosten für die Aufgabenerfüllung weniger als ein Drittel des Letzteren betragen; im Vergleich zu Claude Fable 5.2 liegt es um 5,5 Punkte vorne, die Aufgabekosten betragen nur 5 % des Gegenübers.
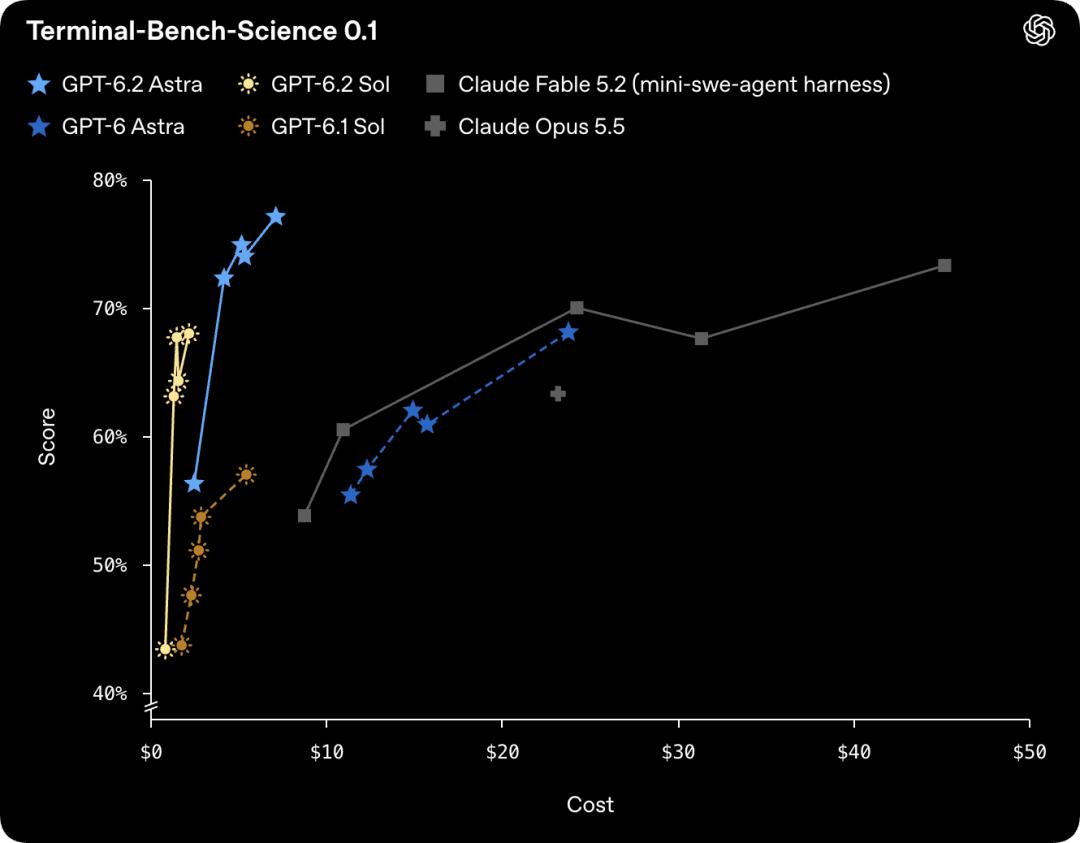
Die Fähigkeit zur wissenschaftlichen Forschung wurde ebenfalls verbessert. Im Terminal-Bench-Science 0.1-Test erzielte Astra ein um 9 Prozentpunkte besseres Ergebnis als die Vorgängergeneration, OpenAI behauptet sogar, dass dies derzeit das am besten geeignete Modell für Wissenschaftler ist.
Die Ergebnisse des Drittprüfungsinstituts Artificial Analysis liefern ebenfalls einen Referenzwert: GPT-6.2 Astra belegt im Gesamtintelligenzindex den zweiten Platz, direkt hinter Claude Fable 5.2, liegt aber im Coding-Agent-Index auf dem Niveau der Vorgängergeneration, GPT-6.2 Sol ist stattdessen um 3 Punkte gefallen.
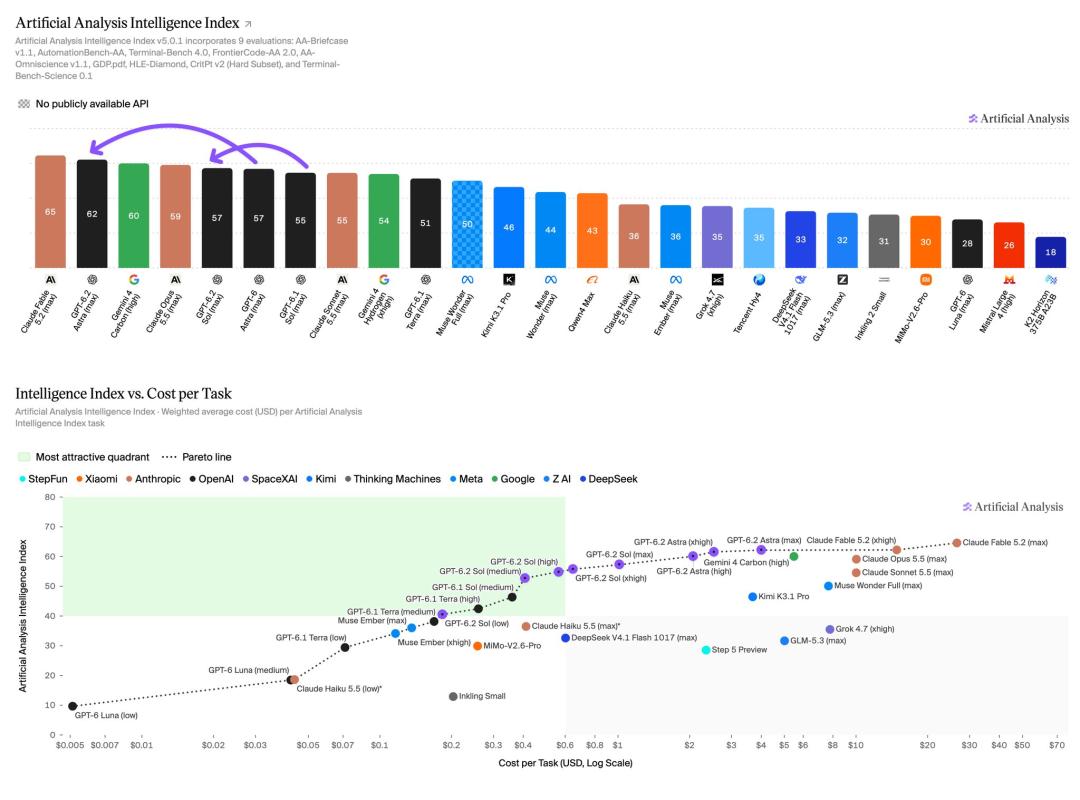
Verglichen mit dem bloßen Aktualisieren von Benchmarks ist die bemerkenswertere Änderung dieser Veröffentlichung, dass OpenAI beginnt, schwerpunktmäßig zu zeigen, wie das Modell echte Arbeit erledigt.
Wenn man Astra beispielsweise einen Screenshot einer PPT gibt, kann es neue Seiten erstellen, die das ursprüngliche Layout, die Schriftart und die Farbgebung nachahmen; wenn man ihm einen Finanzbericht übergibt, kann es auch eine Excel-Arbeitsmappe mit Umsatzprognosen und Bewertungsanalysen generieren.
Im internen GDPval v2-Test von OpenAI erzielte Astra ein um 6,2 Prozentpunkte besseres Ergebnis als die Vorgängergeneration, wobei die ausgegebenen Token um 22 % reduziert wurden; im juristischen Arbeitstest Harvey LAB-AA überstieg seine Aufgabenbestehungsrate das Doppelte von Claude Fable 5.2, und die Kosten betragen etwa ein Sechstel des Letzteren.
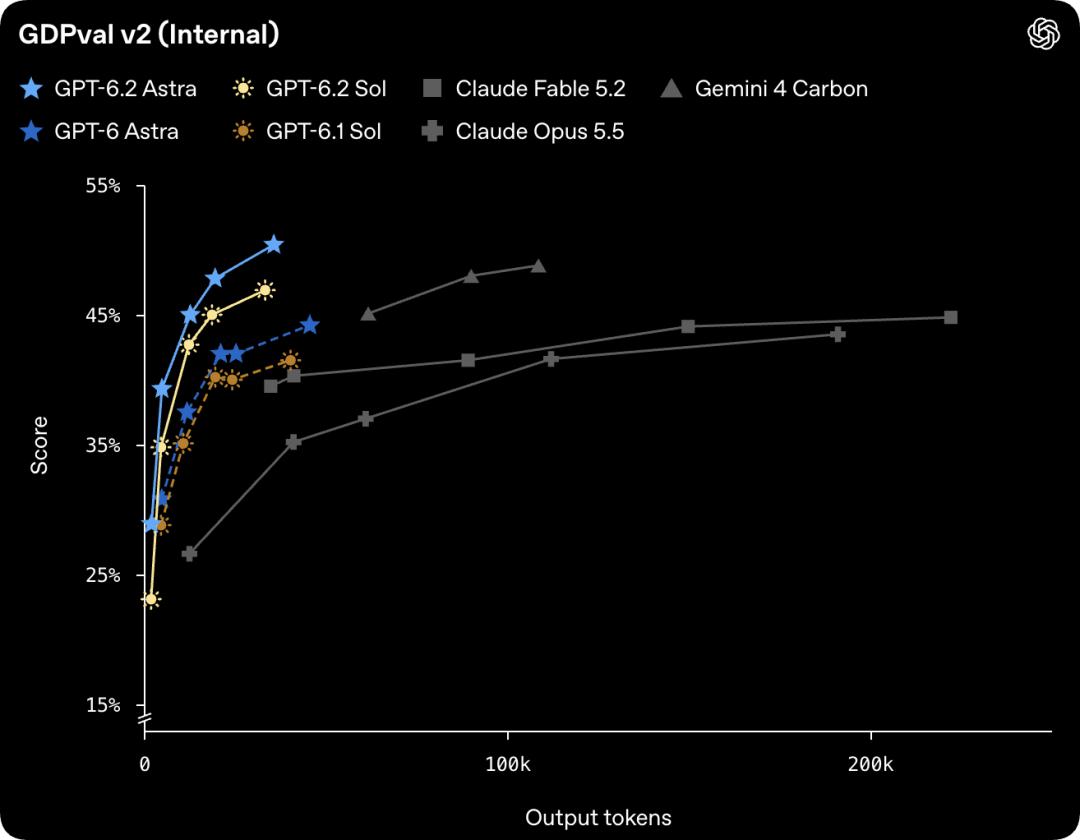
Noch überraschender ist der Fortschritt von GPT-6.2 in den Bereichen 3D-Design und Maschinenbau.
OpenAI zeigte Fälle, in denen Astra die Bewegung von Automobilaufhängungen in Blender simuliert, Montageanimationen für ferngesteuerte Rennwagen erstellt und physische Papierlampen nach den Balkonen des Marina City-Gebäudes in Chicago entwirft.
Im AA-3D-Test von Artificial Analysis belegte Astra mit 1318 Elo den ersten Platz, was 150 Elo-Punkte mehr als die Vorgängergeneration ist und die 1271 Elo von Claude Fable 5.2 übertrifft.
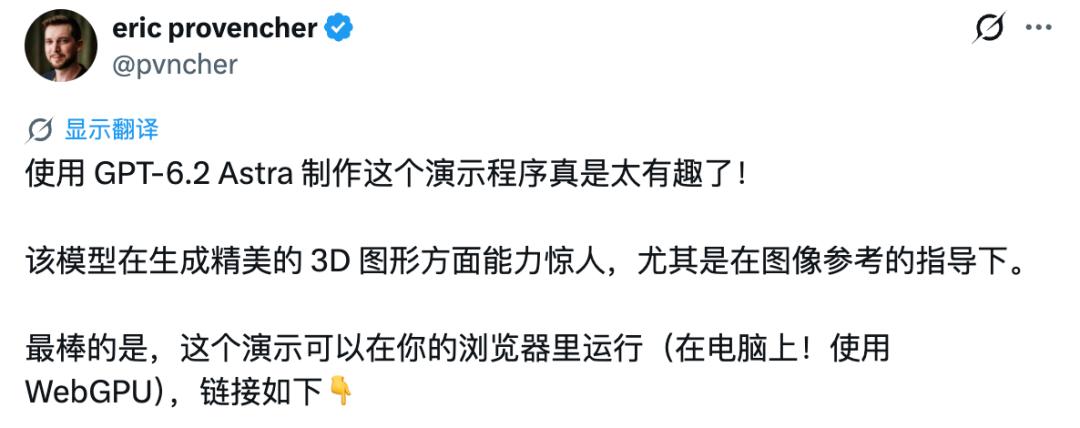
LuminaBench stellte im Test mit denselben Prompts fest, dass die von GPT-6.2 Sol generierte 3D-Wasserflugzeugszene im Vergleich zu 6.1 Sol deutlich verbessert ist. Der Entwickler eric provencher zeigte ein feines 3D-Demonstrationsprogramm, das Astra nach Referenzbildern erstellt hat und das direkt über WebGPU im Browser ausgeführt werden kann;
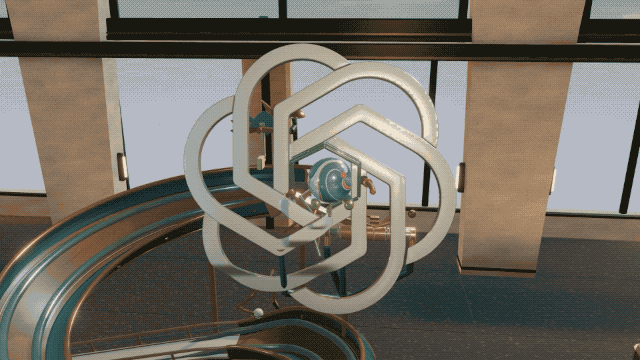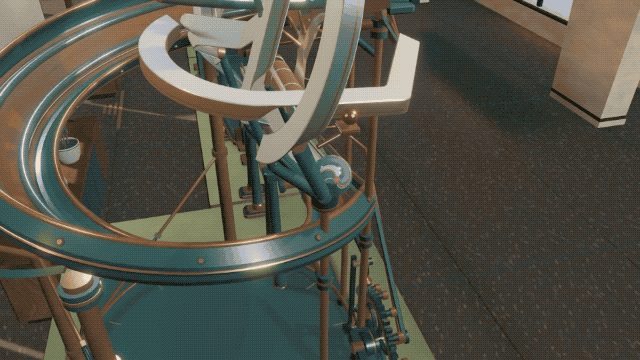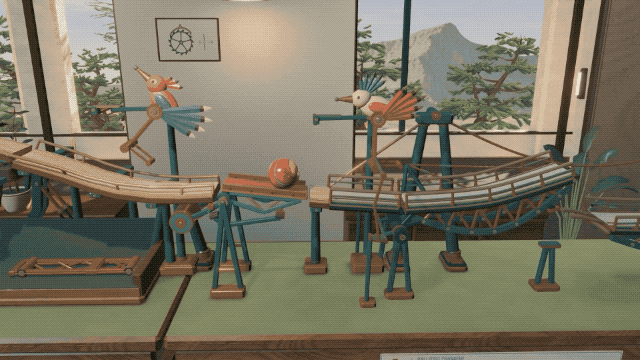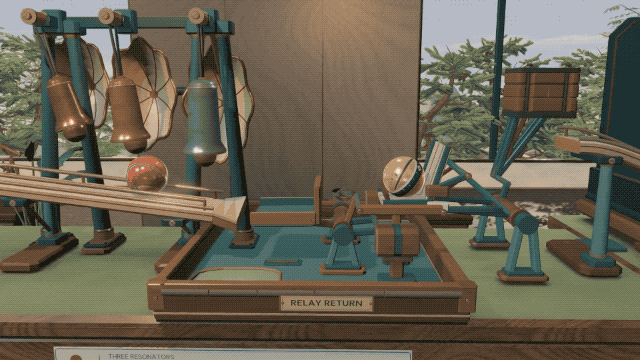
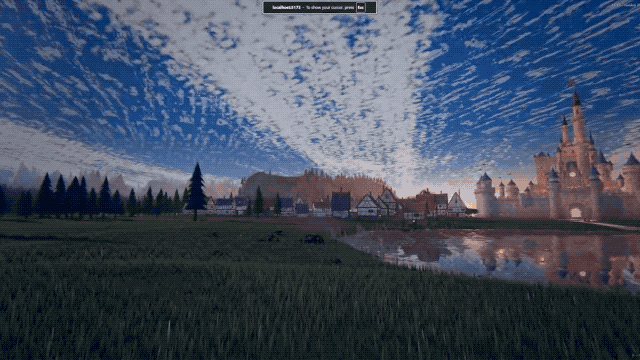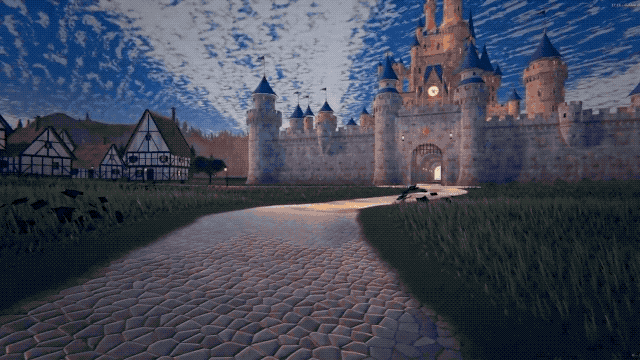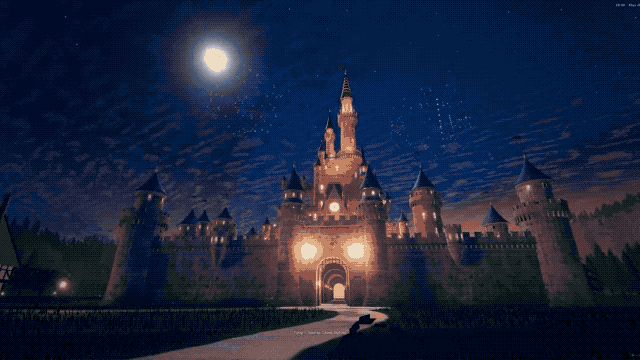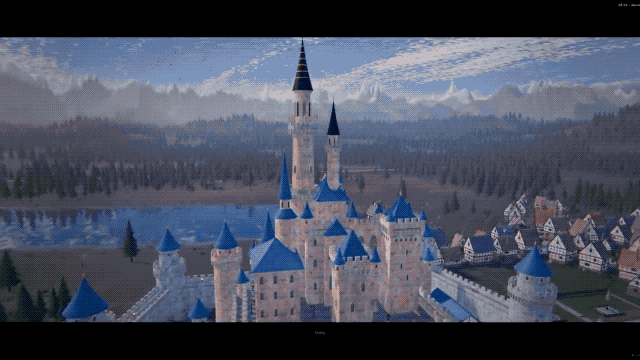
Synopsis nutzte es dann, um ein nahezu reales, begehbares Aschenputtel-Schloss von Disney zu bauen, selbst die Szenen von Feuerwerk, Wasseroberflächentexturen und Schiffen sind recht realistisch.
Nachdem AmirMušić getestet hat, wie Astra zusammen mit Blender Roboterhandmodelle und Animationen erstellt, meint er, dass das tatsächliche Ergebnis akzeptabel ist, aber noch eine große Lücke zu einem beeindruckenden Effekt besteht.
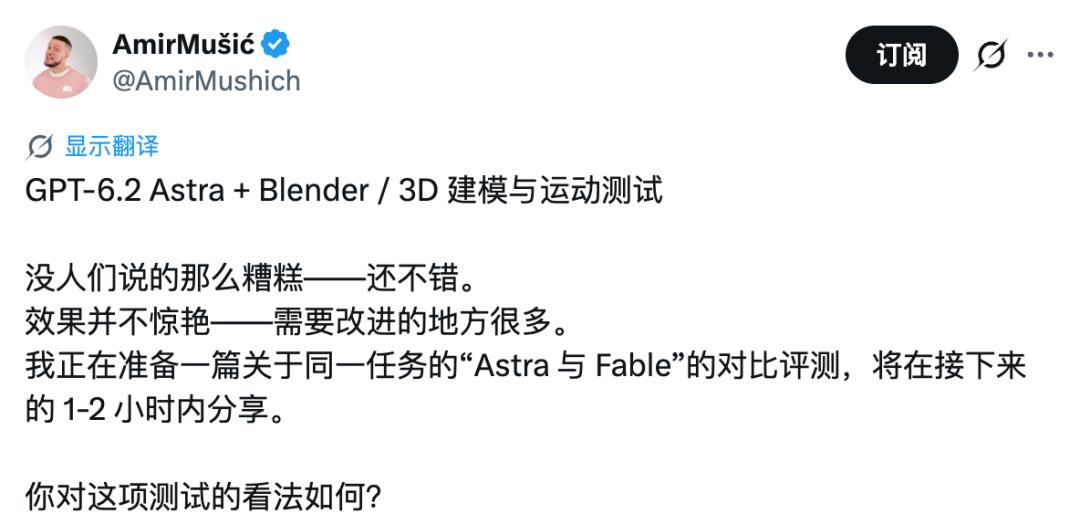
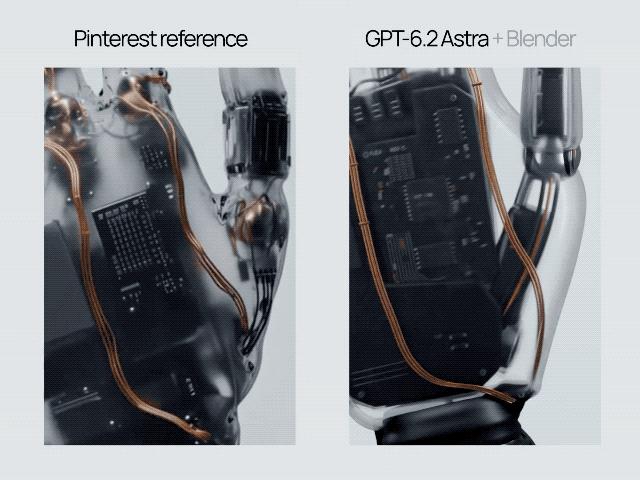
Was das auf Effizienz ausgerichtete GPT-6.2 Sol betrifft, so unterscheidet es sich im FrontierCode 2.0-Programmiertest nur um 0,5 Punkte von Astra, die Kosten betragen jedoch nur etwa ein Fünftel.
Was den Preis betrifft, so sind die API-Eingabe- und Ausgabepreise von GPT-6.2 Astra um 20 % niedriger als bei der Vorgängergeneration, die Cache-Eingabe ist um 60 % gesunken, und die Preise für Eingabe, Cache-Eingabe und Ausgabe pro Million Token betragen 8 USD, 0,4 USD bzw. 40 USD.
GPT-6.2 Sol behält den Preis der Vorgängergeneration bei: 2 USD pro Million Token für die Eingabe, 0,1 USD für die Cache-Eingabe und 10 USD für die Ausgabe.
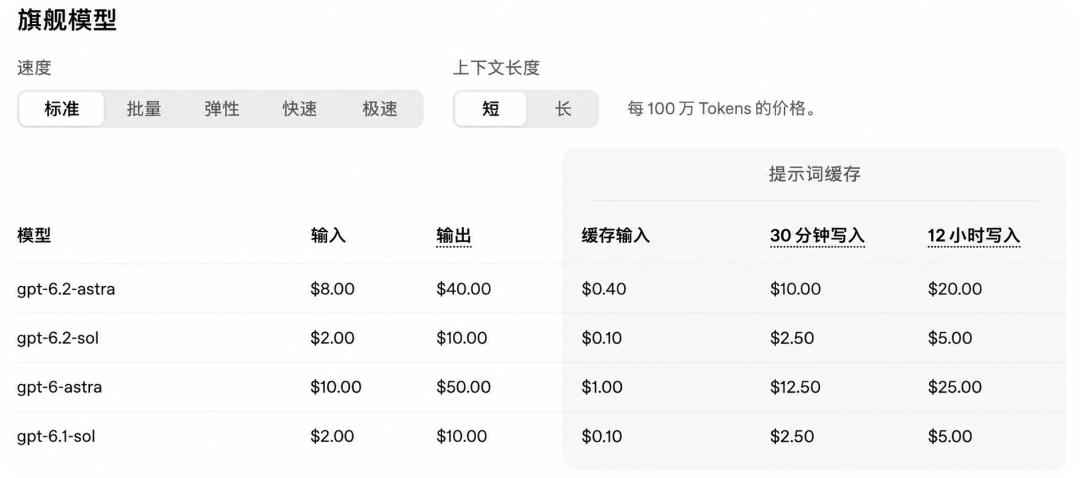
Abbildung |🔗 https://developers.openai.com/api/docs/pricing
Derzeit sind die beiden Modelle für Plus-, Pro-, Enterprise- und Edu-Benutzer von ChatGPT Work und Codex geöffnet, gleichzeitig ist die API online gegangen, und der Ultrafast-Modus wurde erstmals für Pro-200-Benutzer freigegeben.
Die Kostenunterschiede in praktischen Tests sind ebenfalls deutlich.
Bei demselben Prompt für ein Hochgebirgs-Wasserflugzeug benötigte der Entwickler Tony mit GPT-6.2 Sol etwa 31 Minuten und gab 2,07 USD aus, während Claude Opus 5.5 etwa 2 Stunden und 46 Minuten benötigte und 31,85 USD kostete.

In einer anderen Szene mit einem Gletscher-Fischereiboot erledigte Astra die Aufgabe für 8,20 USD in etwa 41 Minuten, während Claude Fable 5.2 81,10 USD und fast zwei Stunden benötigte.
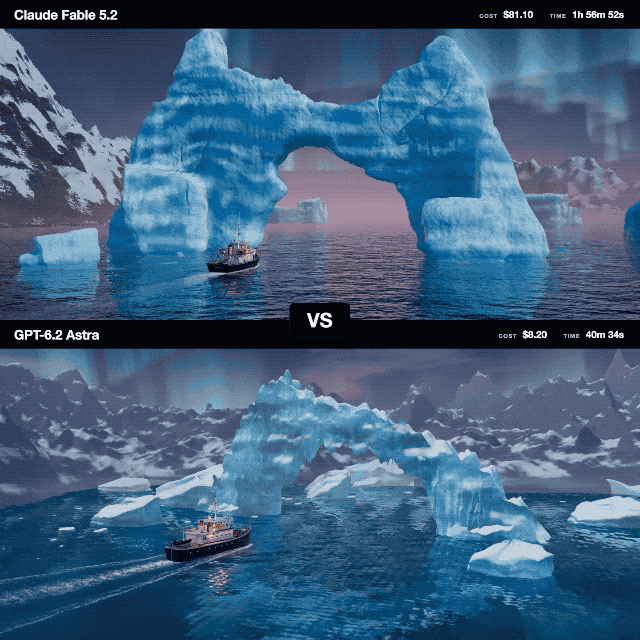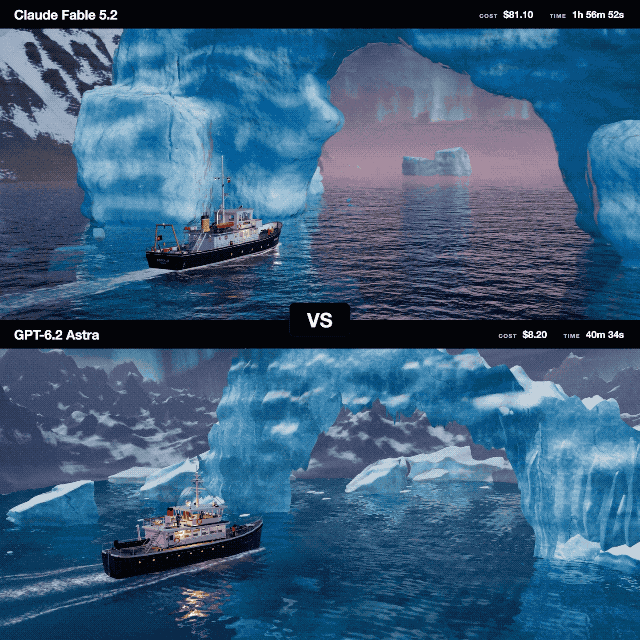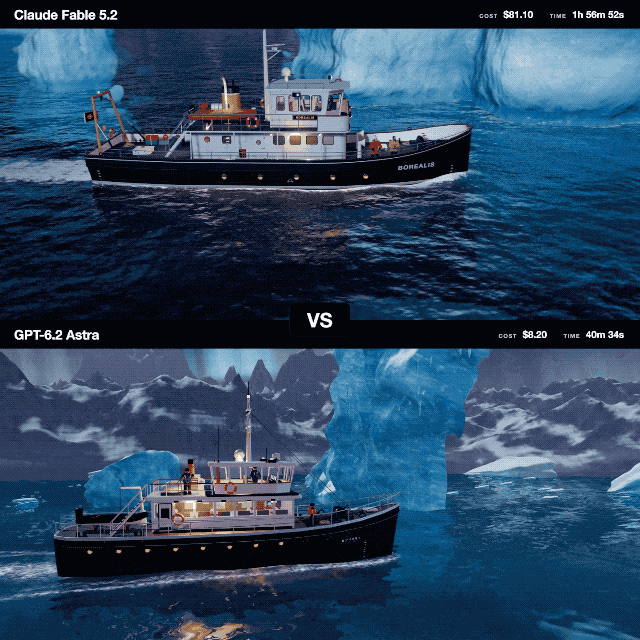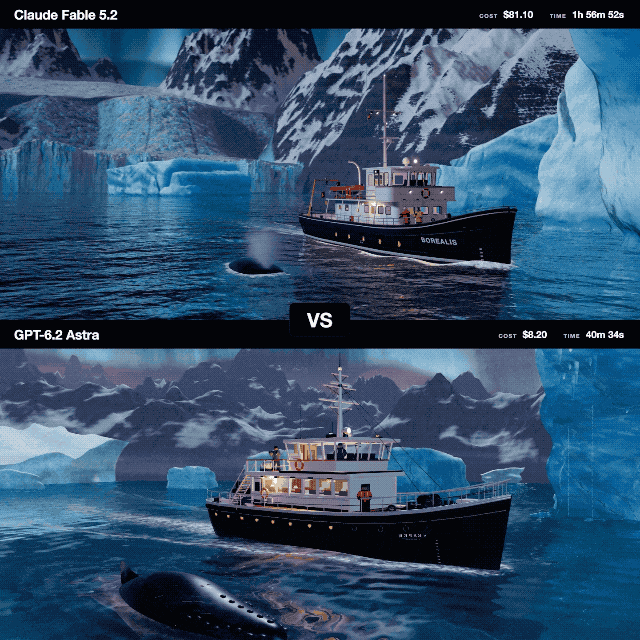
Von der professionellen Arbeit über das 3D-Design bis zum Preis hat OpenAI eine recht beeindruckende Ergebnisliste vorgelegt, aber die tatsächliche Nutzungserfahrung der Entwickler ist weitaus komplexer als das, was die Benchmark-Werte zeigen.
Das klügste KI ist nicht unbedingt die praktischste KI
Nach der Veröffentlichung von GPT-6.2 haben mehrere bekannte Entwickler, die vorzeitig Zugang zur Testversion erhalten haben, nacheinander ihre Enttäuschung ausgedrückt.
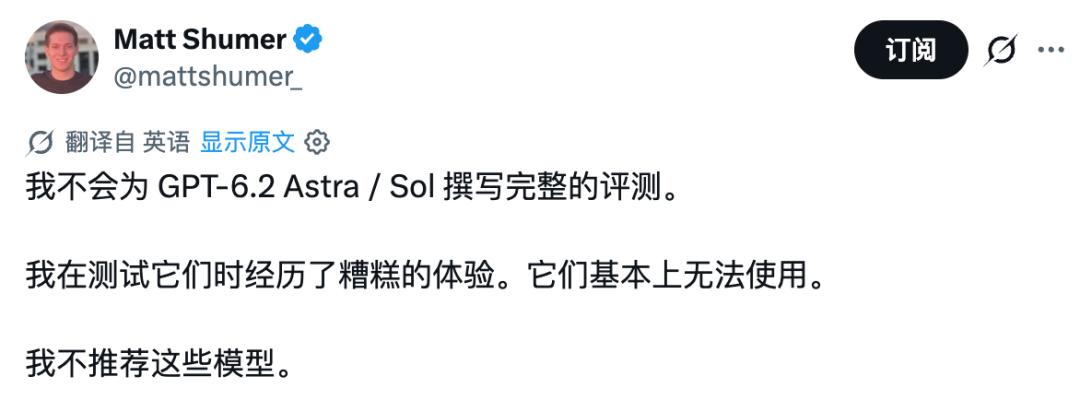
Der KI-Entwickler Matt Shumer hat auf der Plattform X offen gesagt, dass er keine vollständige Bewertung von GPT-6.2 Astra und Sol durchführen wird, da die vorherige Testerfahrung so schlecht war, dass die beiden Modelle praktisch nicht nutzbar sind.
Das Team von Dan Shipper, Mitbegründer von Every, hat ebenfalls mehrere Wochen lang vorab getestet und meint, dass die Gesamtleistung von GPT-6.2 enttäuschend ist.
Nach seinen Beobachtungen ist Astra im Schreibbereich sogar schlechter als die Vorgängergeneration: Es strebt übermäßig nach Kürze, was dazu führt, dass Fragen, die detaillierte Erklärungen erfordern, häufig mit zu kurzen Antworten beantwortet werden; seine Programmierleistung liegt nahe an der der Vorgängergeneration, aber es beendet die Arbeit in echten Projekten häufig vorzeitig; im Designbereich hat es zwar eine gute Ästhetik, neigt aber dazu, sehr ähnliche Werke zu generieren.
Der heftigste Kritiker ist der bekannte Entwickler Theo.
Er enthüllte, dass er wegen der zu schlechten