Yang Zhexuan spricht über Datenkompilierung, Modellfähigkeiten und wie Roboter wieder in die reale Welt eintreten.
▲ Von einer Porzellantasse zu wiederverwendbaren Datenvermögen – die Kompilierung erfolgt nach jeder einzelnen Operation.
Auf dem Tisch stehen mehrere Teetassen. Der Erfasser zieht das Headset an, nimmt die Tassen nacheinander auf, verschiebt sie und legt sie wieder an ihren Platz zurück. Das Gerät zeichnet fortlaufende Videos und Daten des Inertialmessgeräts (IMU) auf. Es scheint, dass die Bewegungen vollständig gespeichert wurden. Sobald die Aufgabe jedoch abgeschlossen ist, endet diese Erfahrung in der Regel auch. Sie wird nicht auf natürliche Weise zu einer Fähigkeit, die beim nächsten Mal aufgerufen werden kann.
Aus Sicht von Yang Zhexuan liegt das Problem genau hier: Die Aufzeichnung der Bewegungen ist erst der Anfang. Das Video zeigt uns, was passiert ist, sagt dem Modell aber nicht, was es als Nächstes tun soll. Es fehlen ihm Dynamik, Absichten, räumliche Beziehungen und auch die Erfahrung, wie man nach einem Misserfolg wiederherstellen kann. Damit die Bewegung beim Ordnen der Teetassen zu wiederverwendbarer Intelligenz wird, muss das System die Aufgabe in Schritte unterteilen, sie mit einer strukturierten Sprache ausrichten und anschließend Handhaltungen, Bewegungstrajektorien und Handlungsabsichten ergänzen.
Yang Zhexuans Urteil ist eindeutig: „Meiner Einschätzung nach ist die Sprache, genauer gesagt die strukturierte Sprache, das Einzige, was ausgerichtet werden kann.“ Seiner Ansicht nach können die Bewegungen in der physischen Welt erst dann von einmaligen Erfahrungen zu abrufbarer Intelligenz werden, wenn die Aufgabe zunächst in eine Struktur umgewandelt wird, die das Modell verstehen, abrufen und wiederverwenden kann.
▲ Auf dem Tisch stehen mehrere Teetassen. Die Aufzeichnung von Bewegungen ist erst der Anfang.
Aus branchenweiter Sicht ist nach dem Eintritt der Embodied Intelligence in die Phase der Datenskalierung die Erfassungsmenge schnell gewachsen, während die Lücke an qualitativ hochwertigen Daten nach wie vor groß ist. 36Kr zitierte im Mai dieses Jahres einen branchenweiten Konsens, dass das Training eines Embodied-Modells mit allgemeiner Generalisierungsfähigkeit mindestens Daten im Umfang von mehreren zehn Millionen Stunden erfordert. Bis Anfang 2026 betrug die Gesamtmenge an hochwertigen Daten aus echten physischen Interaktionen weltweit nur etwa 500.000 Stunden, was weniger als ein Zweitausendstel der Trainingsdaten großer Sprachmodelle entspricht.
Ein von Yang Zhexuan vor Ort gemachtes Gleichnis ist noch direkter: Wenn man 1000 Stunden an Daten extern einkauft, bleiben nach der Filterung möglicherweise nur etwa 100 Stunden nutzbar. Zwischen dem Erfassungsumfang und dem effektiven Angebot klafft eine Lücke, die durch Ingenieurskapazitäten geschlossen werden muss.
Genau diese Struktur zu ergänzen, ist das Ziel von Zhiyu Foundation. Das Unternehmen positioniert sich zwischen Datenerfassung und Modelltraining und nutzt Physical AI DBMS sowie physische Kausalmodelle, um die multimodalen Beobachtungen aus echten Aufgaben zu trainierbaren, bewertbaren, abfragbaren und wiederverwendbaren operativen Datenvermögen zu kompilieren. Das größere Ziel ist es, jede Bewegung in der physischen Welt zu wiederverwendbarer Intelligenz zu machen, sodass Embodied Intelligence wieder in Fabriken, Einkaufszentren, Haushalte und andere reale Szenarien einzieht und zu einer Arbeitskraft wird, die konkrete Aufgaben übernehmen kann.
Die dreifache Fehlausrichtung zwischen Daten und den Anforderungen des Modelllernens
Aus Sicht von Yang Zhexuan verlieren Daten nicht ihren Wert, nur weil sie „ausreichend erfasst“ wurden. Mit jedem Fortschritt des Modells treten neue Schwachstellen zutage, und der Datenbedarf ändert sich entsprechend. Genau wie bei Prüfungen ständig neue Fragen auftauchen, stellt das Modell nach dem Eintritt in die echte Arbeitsumgebung auch ständig neue Anforderungen.
Das eigentliche Problem besteht darin, dass zwischen den vorhandenen Daten und dem Modell noch viele Fehlausrichtungen bestehen.
Die direkteste Fehlausrichtung betrifft das Lernobjekt. Videos zeichnen auf, wo sich Objekte befinden und was die Hand tut, enthalten aber nicht unbedingt die vom Modell zu verstehenden Zustandsänderungen von Objekten, Folgen von Handlungen, Abläufe von Operationen, Wiederherstellung nach Misserfolgen und Kontaktbeziehungen. Intern fasst Zhiyu Foundation die Fähigkeiten, die das Modell auf operativer Ebene beherrschen muss, in zehn Kategorien zusammen. Yang Zhexuan ist der Ansicht, dass das Modell in diesen Aspekten allgemein Mängel aufweist, und Videos, die nur Bilder aufzeichnen, liefern nicht automatisch die Antworten.
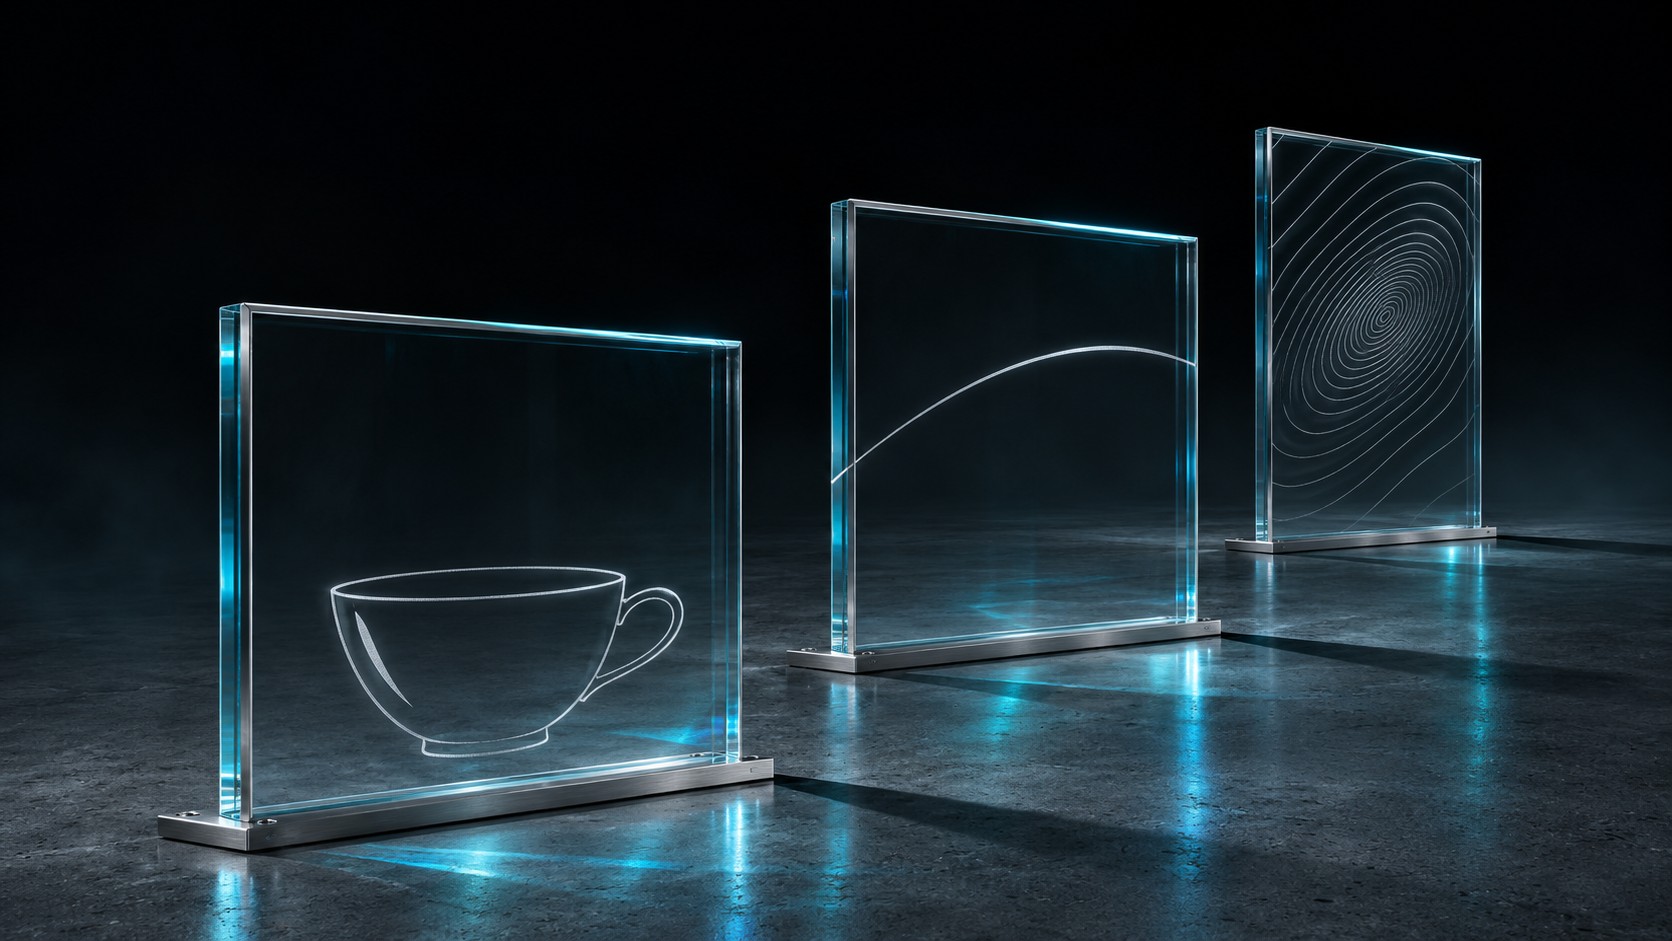
▲ Dieselbe Erfahrung wird in Bilder, Trajektorien und Kontaktbeziehungen unterteilt, wobei die drei Aufzeichnungen oft nicht übereinstimmen.
Die zweite Fehlausrichtung tritt bei der Aufgabenverteilung auf. Standardisierte Erfassungsstandorte lassen sich am einfachsten skalieren: Auf einem 2000 Quadratmeter großen Gelände können bei einer Größe von etwa 10 Quadratmetern pro Arbeitsplatz rund 200 Personen eingesetzt werden. Aber selbst wenn das Modell hier lernt, „wie man ein Objekt aufhebt“, weiß es möglicherweise in einem Einkaufszentrum, einer Küche oder einer Fabrik immer noch nicht, was zu tun ist. Yang Zhexuan sagt, dass solche Standorte zwar leicht große Mengen an Daten liefern, aber kaum Szenariogeneralisierung ermöglichen.
Die dritte Fehlausrichtung ergibt sich aus Unterschieden der Körper. Menschen und Roboter sowie verschiedene Roboter unterscheiden sich in ihrer Körperstruktur, ihrem Bewegungsraum und ihren Steuerungsverfahren. Damit menschliche Daten auf Roboter angewendet werden können, sind Kamerakalibrierung, Definition von Aufgaben-Schemata, Aktionsabbildung und Körperanpassung erforderlich. Eine Studie von Physical Intelligence vom vergangenen Dezember ergab auch, dass die Fähigkeit zur Übertragung von menschlichen Videos auf Roboter nur dann zum Vorschein kommt, wenn die vortrainierten Daten in Bezug auf Szenarien, Aufgaben und Körper ausreichend vielfältig sind.
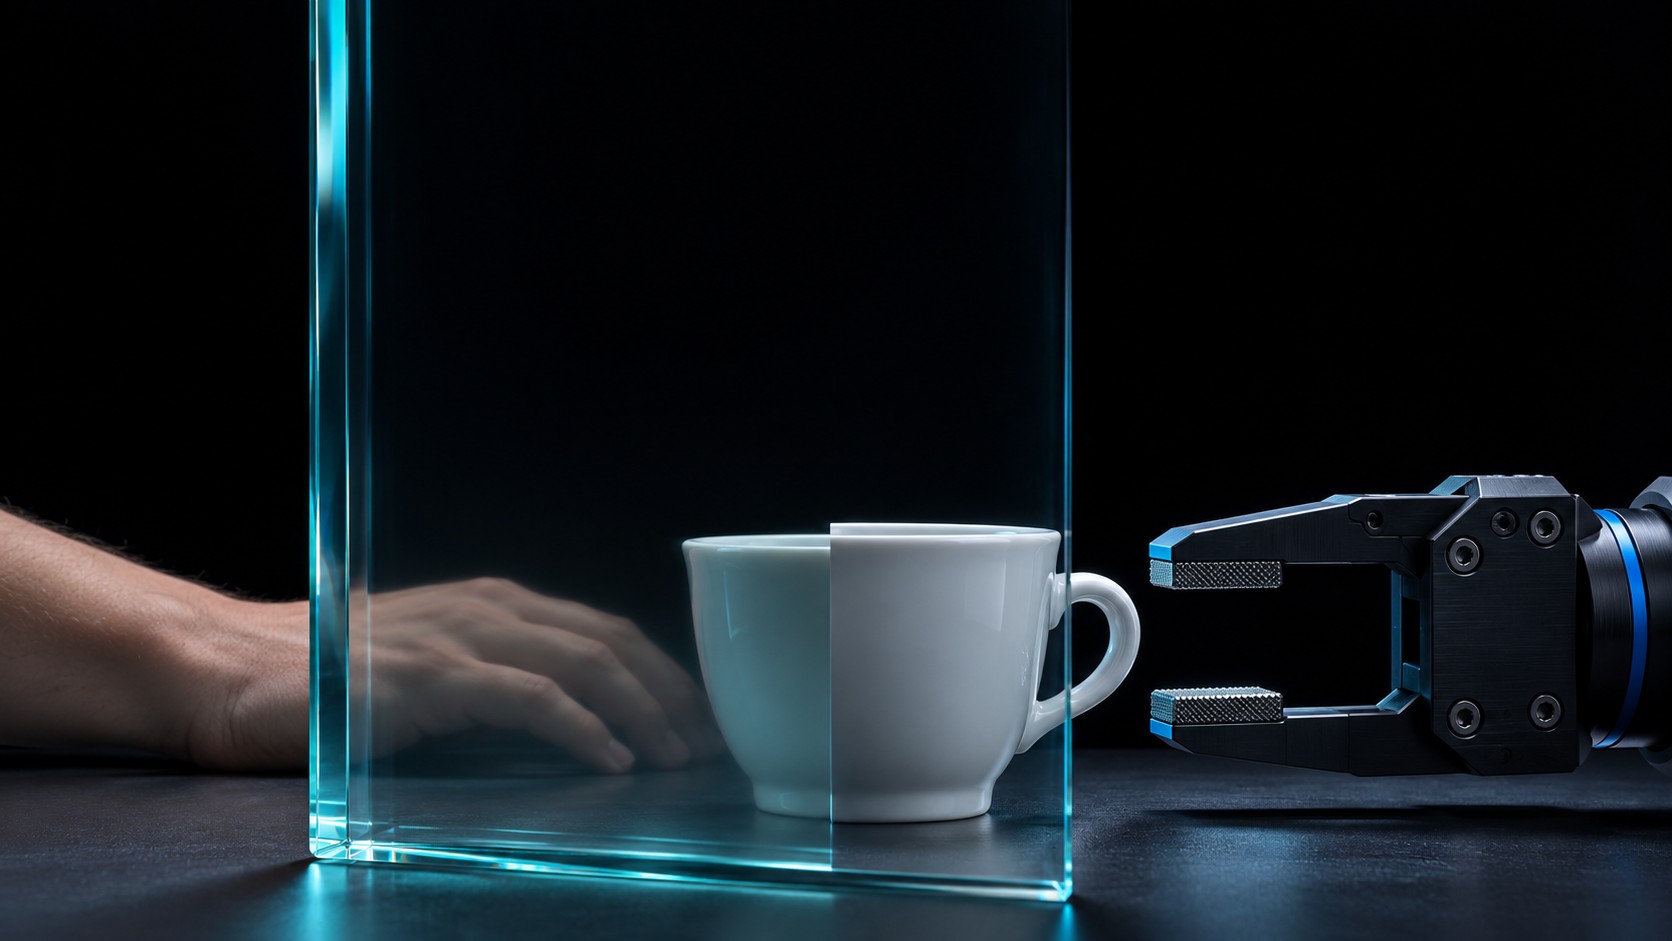
▲ Bei derselben Tasse sehen Mensch und Maschine nicht dieselbe Position.
Dies ist auch der Bereich, auf den Zhiyu Foundation derzeit besonderes Augenmerk legt und aktiv erforscht: Wie man die Embodiment-Lücke zwischen Mensch und Roboter verkleinern kann, sodass die von Menschen angesammelten Handlungserfahrungen von verschiedenen Robotern verstanden, abgebildet und wiederverwendet werden können. Wenn diese Lücke verkleinert werden kann, wirkt sich das nicht nur auf eine einzelne Aufgabe oder eine bestimmte Art von Roboter aus, sondern verändert auch die Effizienz, mit der Embodied Intelligence Datenumfang in praktische Fähigkeiten umwandelt.
Yang Zhexuans Urteil lautet, dass bis heute eines relativ sicher ist: Das Scaling wird weitergehen. Bei der weiteren Verfeinerung liegt der Schlüssel darin, einen steileren Scaling-Steigungswinkel zu finden, sodass die Fähigkeiten des Modells mit geringeren Kosten wachsen.
Daher ist die Aufgabenteilung der beiden Datentypen unterschiedlich. Daten aus der ersten Person des Menschen lassen sich leicht skalieren und dienen hauptsächlich der Generalisierung in Szenarien, Aufgaben und Handlungen in der Vortrainingsphase. Daten von echten Geräten sind näher an dem spezifischen Körper und den Ausführungsrückmeldungen und eignen sich für das Nachtraining bestimmter Aufgaben. Yang Zhexuan gibt ein Beispiel: Wenn die Erfolgsrate einer bestimmten Aufgabe weiter gesteigert werden soll, müssen unbedingt Daten von echten Geräten erfasst werden, um das Nachtraining durchzuführen.
Über die nachfolgenden Änderungen bei der zweiten Neugründung des Roboter-Modell-Forschungsteams von OpenAI, die Veröffentlichung von Fable 5.2 durch Anthropic und andere Nachrichten wurde noch nicht öffentlich berichtet. Was Yang Zhexuan damals besprach, bezog sich nicht mehr nur auf ein bestimmtes Modell oder eine einzelne Veröffentlichung, sondern darauf, wie Sprache und Datenstrukturen zur Grundlage der Embodied Intelligence werden. Später traten nacheinander öffentliche Maßnahmen der Branche auf – rückblickend war das eher eine vorweggenommene Branchenprognose.
Aus branchenweiter Sicht heißt es in einem im August veröffentlichten Bericht von Institutionen wie der China Academy of Information and Communications Technology, dass bis Ende Juni dieses Jahres landesweit mehr als 70 in Betrieb genommene Trainingsplätze für Embodied Intelligence existieren. Der im Oktober gemeinsam von der China Academy of Information and Communications Technology und dem Department of Electronic Engineering der Tsinghua-Universität und anderen Einheiten veröffentlichte „Entwicklungsbericht zur Embodied Intelligence (2026)“ weist jedoch auch darauf hin, dass sich Embodied Intelligence noch in der Übergangsphase zu Pilotanwendungen befindet.
Ob Daten gültig sind, hängt davon ab, ob sie die Fähigkeiten abdecken, die das Modell erlernen soll; die Erfassungsdauer allein stellt kein Kriterium dar. Der Wettbewerb in der Branche hat sich von „mehr erfassen“ zu „den Teil mit höherem Trainingswert behalten“ verschoben.
Datenkompilierung: Von Beobachtungsaufzeichnungen zu operativen Vermögenswerten
Aus Sicht von Yang Zhexuan besteht der Kernunterschied zwischen Beobachtungsdaten und operativen Daten darin, ob es ein strukturiertes System gibt, das die Daten ausrichtet. Was fehlt, sind nicht mehr Labels, sondern eine Sprache, die verschiedene Signale in dasselbe Koordinatensystem einordnen kann. Mit seinen Worten: „Meiner Einschätzung nach ist die Sprache, genauer gesagt die strukturierte Sprache, das Einzige, was ausgerichtet werden kann.“ Daher wählt Zhiyu Foundation, Aufgaben mit strukturierter Sprache zu organisieren, ergänzt gleichzeitig Informationen wie Dynamik, räumliche Position und Bewegungsabsicht und hat darauf basierend eine fünfstufige Datenkompilierungspipeline aufgebaut und angewendet.
Nehmen wir als Beispiel noch das Ordnen von Teetassen. Nachdem das Video in die Pipeline gelangt ist, wird es zuerst einer Datenqualitätsprüfung unterzogen. Abschnitte mit verlorenen Bildern, IMU-Drift, verdeckten Schlüsselbewegungen oder nicht konformen Operationen werden herausgefiltert; auch Daten, die von externen Dienstleistern erstellt werden, durchlaufen diesen Schritt. Anschließend erfolgt die Rekonstruktion des Datenfundaments: Das System wandelt die zur Aufzeichnung geeigneten Daten in ein selbstentwickeltes Zwischenformat (IR) mit ausgewogenem Lese- und Schreibzugriff um und vereinheitlicht die Zeitbasis und Raumkoordinaten der multimodalen Daten.
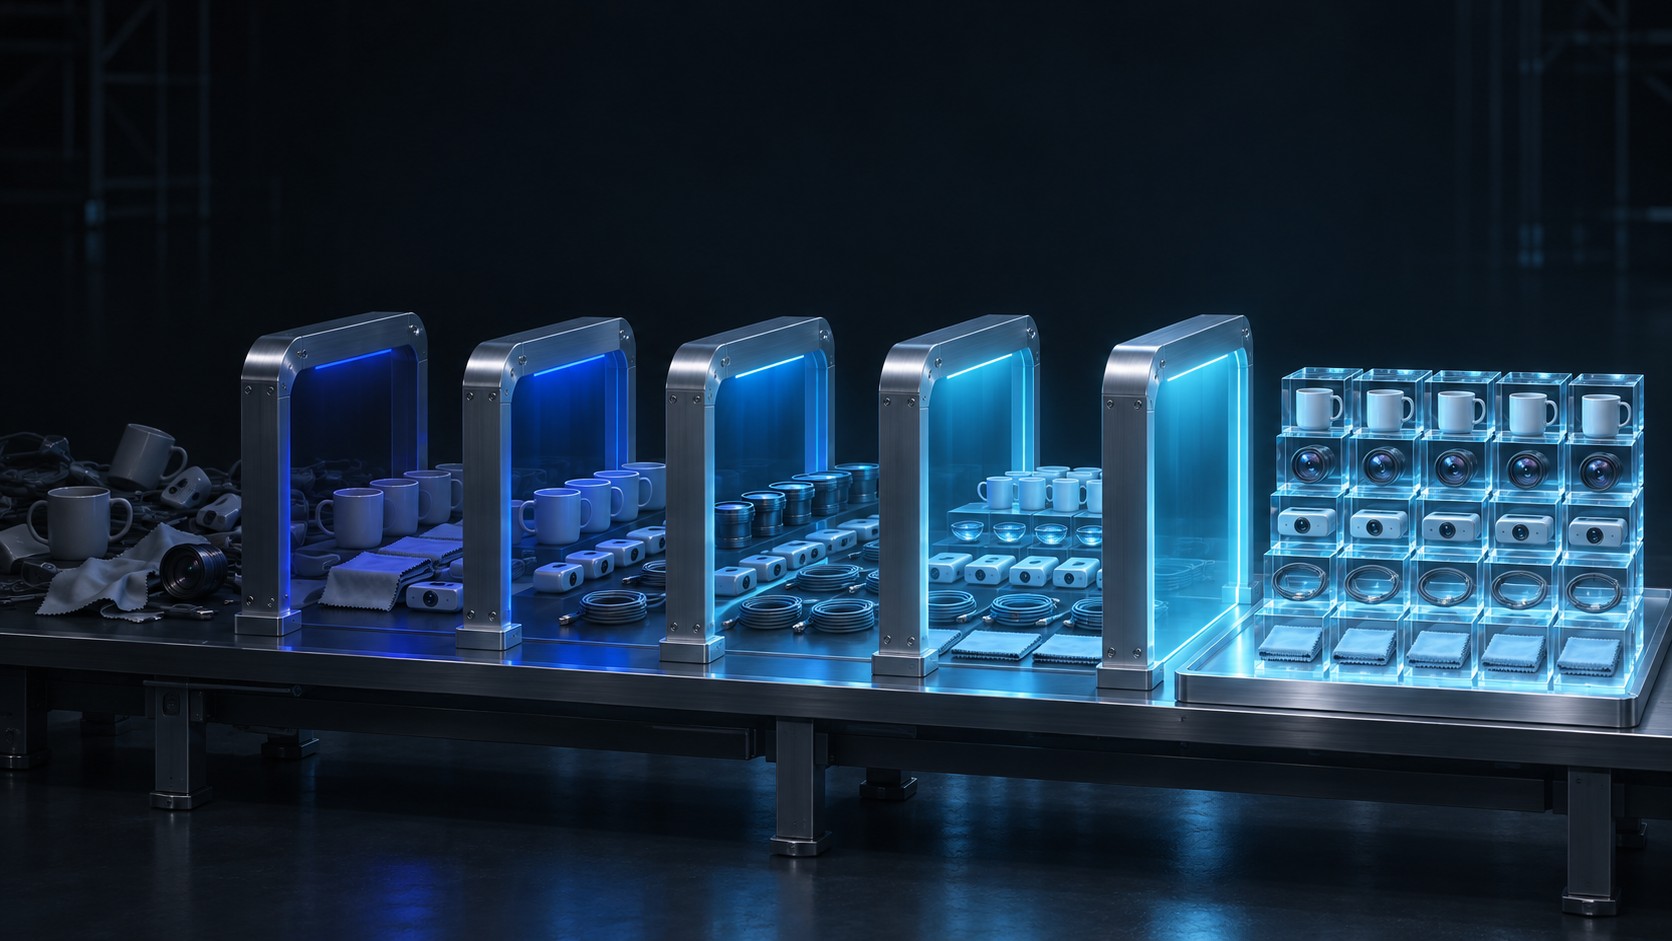
▲ Kompilierungspipeline: Links liegen die ungeordneten Beobachtungen, rechts stehen abrufbare und lieferbare Datenvermögen.
Auf der anderen Seite des verarbeitenden Gewerbes steht die Qualitätsprüfung. Produkte werden vor der Auslieferung geprüft, und Daten müssen vor der Auslieferung ebenfalls die Prüfung bestehen. Yang Zhexuan sagt: „Automatisierung kann keinen vollständig unbemannten Ablauf erreichen.“ Daher integriert Zhiyu Foundation modellbasierte Automatisierung, mehrstufige Qualitätsprüfung mit menschlicher Beteiligung und statistische Stichprobenprüfung in dieselbe Produktionslinie.
Als Nächstes folgt der zentrale Schritt der Datenkompilierung. Die Aufgabe wird in mehrere Schritte unterteilt und mit der Sprache ausgerichtet, Handhaltungen, 6DoF-Posen, räumliche Trajektorien, Tiefe und Bewegungsabsichten werden wiederhergestellt und in die Daten eingebracht. Nach Angaben von Zhiyu Foundation können die kompilierten Daten intelligent nach Bedingungen wie Szenarien, Objekten und Fähigkeiten abgerufen und zusammengestellt werden, bevor sie schließlich in dem von Kunden gewünschten Format standardisiert verpackt und ausgeliefert werden.
Diese Pipeline wird von einer vierstufigen Architektur gestützt, die aus Eingabe von Beobachtungsdaten, Physical AI DBMS, physischem Kausalmodell und Ausgabe operativer Daten besteht.
Physical AI DBMS ist das interne Datenfundament des Unternehmens, das für Organisation, Indizierung und Versionsnachverfolgung heterogener Daten zuständig ist. Aus der Perspektive von Yang Zhexuan, der einen Hintergrund im Datenbankbereich hat, hängen der Betrieb von automatischen Qualitätsprüfungen, Annotierungsalgorithmen und physischen Kausalmodellen alle von diesem Fundament ab – sonst kann das System die Arbeitslast nicht bewältigen. Das physische Kausalmodell wiederum ist dafür zuständig, die Aufgabe selbst zu verstehen, einschließlich Phaseneinteilung, Zustandsänderungen, physischer Kontakte, Gründe für Misserfolge und Wiederherstellungspfade, und gibt schließlich Trainingsdatensätze, Benchmarks, Szenariopakete, Bewertungsvermögen und wiederverwendbare Aufgabenvorlagen aus.
Die Öffentlichkeit betrachtet das Datengeschäft oft als arbeitsintensive Branche, aber Yang Zhexuans Urteil lautet: „Daten sind eigentlich ein verarbeitendes Gewerbe mit hohem Technologieanteil.“ Seiner Ansicht nach ist Arbeitsintensität ein Merkmal dieses Geschäfts, bedeutet aber nicht, dass es keine Barrieren gibt. Der hohe Technologieanteil zeigt sich bei der Generierung von Handhaltungen und der Extraktion von Trajektorien. Wenn die Hand wichtige Bereiche der Arbeit verdeckt, wird die Informationsextraktion behindert und kann nur durch das Modell wiederhergestellt werden. Dies erfordert eine große Menge an unverdeckten Daten für das Training und anschließende Validierung mit Ground-Truth-Werten. „Diese Aufgabe lässt sich nicht lösen, indem man einfach eine große Anzahl von Menschen einsetzt – man braucht GPUs, Daten und Fachkräfte für Algorithmen.“
Der Charakter als verarbeitendes Gewerbe zeigt sich bei der Qualitätsprüfung. Produkte werden vor der Auslieferung geprüft, und Daten müssen vor der Auslieferung ebenfalls geprüft werden – Automatisierung kann keinen vollständig geschlossenen Kre