An die Spitze der globalen Rangliste aufgestiegen, hat das Team der Tsinghua-Universität vier aufeinanderfolgende Finanzierungsrunden abgeschlossen.
Wie aus Investorenkreisen bekannt wurde, hat das Datenbasismodell-Unternehmen Wenzhun Intelligent nacheinander die Serie-A- und Serie-A+-Finanzierungen im Wert von mehreren hundert Millionen Yuan abgeschlossen. Zu den Investoren der Serie-A+-Runde gehören erstklassige Institutionen wie CDH Investments, Shanghai Guotou Pilot und Xuhui Kechuang Investment; die Serie-A-Runde wurde gemeinsam von Sinovent Capital und Yu Capital angeführt, während Gao Hu Capital als exklusiver Finanzberater fungierte. Damit hat Wenzhun Intelligent seit seiner Gründung nacheinander vier Finanzierungsrunden abgeschlossen und zuvor auch kontinuierliche Kapitalzuführungen von renommierten Institutionen wie dem Xiong'an Fonds und Oriental Fortune Capital erhalten.
Obwohl die Finanzierung im Primärmarkt an Dynamik verloren hat, sind die Anteile von Wenzhun Intelligent nach wie vor sehr gefragt. Aus Investorenkreisen erfuhr man, dass einige Institutionen in der letzten Runde keine Anteile erwerben konnten und sich diese Runde frühzeitig reserviert haben; ein führender Fonds, der selten investiert, hat sich diesmal sogar einen großen Anteil gesichert.
Über diese gegen den Markttrend verlaufene Finanzierung hat Cui Peng, Chefwissenschaftler von Wenzhun Intelligent, sehr tiefe Eindrücke. Dies ist nicht nur eine kollektive Investition der führenden Fonds in eine technische Route, die von einem chinesischen Team selbst definiert wurde, sondern markiert auch, dass LDM (Large Data Model, großes Datenmodell) aus der bisherigen "Abseitsposition" ins Rampenlicht tritt.
Im Gegensatz zum weltweit verfolgten LLM-Segment zielt LDM auf die massiven strukturierten Industrie- und Wissenschaftsdaten der Realwirtschaft ab und beschreitet einen originellen technischen Pfad, der sich von den allgemeinen großen Sprachmodellen unterscheidet.
Als Pionier des inländischen LDM-Segments tritt Wenzhun Intelligent nun in den Vordergrund. Außerhalb des Technikkreises ist es möglicherweise unbekannt, dass sein neues großes Datenmodell "Jishu" LimiX-2 bei der umfassenden Bewertung der drei strukturierten Daten-Benchmarks TabArena, TALENT und BCCO jeweils den ersten Platz unter allen teilnehmenden Modellen erreicht hat. Sogar NVIDIA hat LimiX-2 von Wenzhun Intelligent direkt in die Leistungsvergleiche in seinen offiziellen technischen Artikeln aufgenommen und nutzt es als Referenz, um die Inferenzeffizienz des neuen Modells vorzustellen.
Das Profil dieses Teams aus Lehrkräften und Studenten der Tsinghua-Universität wird in den Augen der Investoren immer klarer: Neben LLM haben sie die technische Route von LDM eröffnet, um das Fähigkeitssystem der chinesischen Basismodelle für wissenschaftliche Entdeckungen und komplexe industrielle Entscheidungen zu stärken. Heute ist dieses Team auf wichtigen akademischen Konferenzen und wissenschaftlichen Foren im Bereich des kausalen Lernens eine nicht zu umgehende repräsentative Kraft. Der von ihnen beschrittene originelle technische Pfad wird auch zunehmend zum Fokus, auf den sich industrielle Investoren konzentrieren und den sie ausbauen.
Lehrkräfte und Studenten der Tsinghua-Universität gemeinsam mit dem staatlichen Vermögensverwalter von Xiong'an stellen das erste Kapital bereit
In den Köpfen der meisten Investoren hat Wenzhun Intelligent eine Teamfarbe ähnlich der von Zhipu AI – es handelt sich um ein Startup von Lehrkräften und Studenten, das aus der Fakultät für Informatik der Tsinghua-Universität hervorgegangen ist.
Beginnen wir zuerst mit Chefwissenschaftler Cui Peng. 2005 wurde Cui Peng an der Fakultät für Informatik und Technologie der Tsinghua-Universität aufgenommen, um seinen Doktorgrad zu absolvieren. Er konzentrierte seine Forschung auf künstliche Intelligenz und Big-Data-Analysen und blieb nach seinem Doktorabschluss 2010 als Dozent an der Universität. Im Laufe von mehr als zehn Jahren wurde Cui Peng nacheinander zum Preisträger des National Natural Science Fund für herausragende junge Wissenschaftler, zum herausragenden Wissenschaftler der Association for Computing Machinery (ACM) und zum IEEE Fellow gewählt. Er erhielt 2018 und 2024 zweimal den zweiten Preis des Nationalen Naturwissenschaftspreises, veröffentlichte mehr als 200 Arbeiten auf führenden internationalen Konferenzen und in Zeitschriften, gewann zahlreiche führende Preise im In- und Ausland und verzeichnete mehr als 34.000 akademische Zitationen.
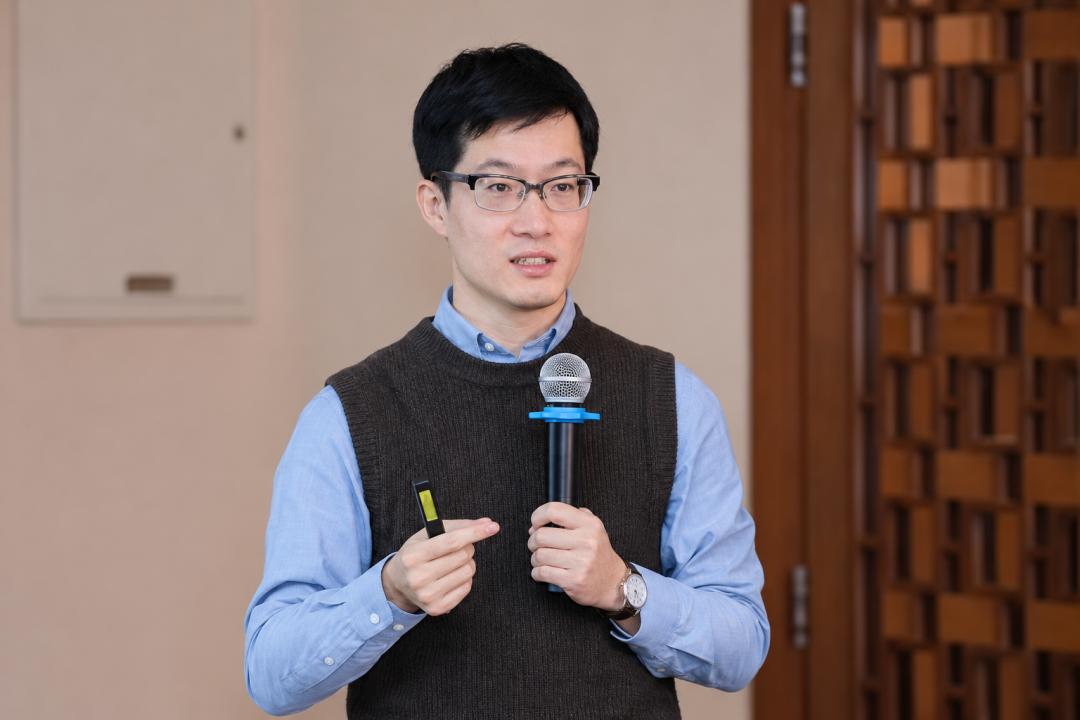
Cui Peng, Chefwissenschaftler von Wenzhun Intelligent
Bei der Forschung bevorzugt er Richtungen, auf die Unternehmen besonders achten, die aber in der akademischen Welt kaum Beachtung finden. An der Tsinghua-Universität rät Cui Peng seinen Studenten in der Arbeitsgruppe, sich von Hype-Themen fernzuhalten: "Wenn sich viele Menschen auf eine Richtung stürzen, kann man höchstwahrscheinlich nur kleinteilige inkrementelle Fortschritte erzielen und hat keine Möglichkeit, über grundlegende, disruptive Probleme nachzudenken." Die kausale Forschung war einst genau so eine "Abseitsposition".
Ab 2016 begann die von Cui Peng geleitete Forschungsgruppe, sich auf die Integration von Kausalität und künstlicher Intelligenz zu konzentrieren. Sie hat international erstmals das theoretische und methodische System des kausal inspirierten stabilen Lernens vorgeschlagen und weiterentwickelt, das sich schwerpunktmäßig mit dem Generalisierungsproblem von Modellen in unbekannten Umgebungen befasst – mehr als ein Jahrzehnt tiefer Forschung hat die technische und theoretische Grundlage für die Gründung von Wenzhun Intelligent gelegt.
Ab 2022 beschleunigte sich die KI-Forschung in allen Bereichen, und die einstige Abseitsposition wurde allmählich populär, sodass immer mehr Menschen darauf aufmerksam wurden. 2022 veröffentlichten Cui Peng und Susan Athey, renommierte Mitglied der National Academy of Sciences der USA und Professorin an der Stanford-Universität, eine Meinungsarbeit in *Nature Machine Intelligence*, in der sie systematisch darstellten, wie stabiles Lernen kausale Inferenz und maschinelles Lernen verbindet. 2024 arbeitete das Team mit Forschern des Nationalen Zentrums für Proteinwissenschaften (Peking) zusammen und veröffentlichte eine Studie zur stabilen Überlebensanalyse in derselben Zeitschrift, um das kausal inspirierte stabile Lernen weiter für die lebenswissenschaftliche Forschung einzusetzen und Grundlagen für die Modellierungsarbeit des Teams für wissenschaftliche Daten zu schaffen.
Als die akademischen Etappenziele nacheinander erreicht wurden, stellte Cui Peng, der sich ständig mit der Lösung von Schmerzpunkten der Realwirtschaft befasst, fest, dass eine Lücke in der KI-Landschaft immer offensichtlicher wurde –
Wenn große Sprachmodelle dem semantischen Raum entsprechen und verkörperte Intelligenz der physischen Welt entspricht, dann gibt es für den größten strukturierten Datenraum in der Realwirtschaft noch immer kein allgemeines Basismodell, um die darin enthaltenen Gesetze und kausalen Zusammenhänge darzustellen. Dies führt dazu, dass für zahlreiche Tabellen, Sensor-Zeitreihen, Prozessbuchhaltungen und andere Daten "ein Algorithmus pro Szenario", "ein Modell pro Tabelle" und "ein Modell pro Projekt" erforderlich sind. Das Hinzufügen oder Löschen einer beliebigen Variable erfordert, dass das Algorithmus-Team den Algorithmus neu entwirft und das Modell trainiert, was Wochen oder sogar länger dauert. Die Auslieferung ist aufwendig, die Wiederverwendbarkeit schlecht und das Kosten-Nutzen-Verhältnis hoch.
Diese Angelegenheit ist für Unternehmen sehr wichtig, aber in der akademischen Welt zu wenig populär, sodass nur wenige Menschen Zeit und Energie dafür aufwenden.
Cui Peng beschloss, selbst aktiv zu werden.
Ab der zweiten Jahreshälfte 2024 bereitete er mit seinen Studenten offiziell die Gründung des Unternehmens vor. Cui Peng stellte das Gründerteam in vier Dimensionen zusammen: vision, depth, execution, distribution, die jeweils der Unternehmensvision (strategische Richtung), der technischen Tiefe, der Auslieferung von Leistungen und der kommerziellen Expansion entsprechen.
Cui Peng ist selbst für vision verantwortlich; der Postdoktorand Zhang Xingxuan mit herausragenden technischen Fähigkeiten übernimmt die Position des CTO; ein weiterer Postdoktorand, He Yue, wird COO. Am schwierigsten aus dem Labor zu entwickeln war der Bereich distribution, der erfordert, mit Menschen umzugehen und ein Marketinggespür zu haben. Deshalb holte er sich Zhang Tianyang, seinen 2018 promovierten Doktoranden, der zuvor gemeinsam Power Law Intelligence mitgegründet hatte, als CEO an Bord.
Im Oktober 2024 wurde Wenzhun Intelligent offiziell im Neuen Gebiet Xiong'an registriert. Als Hauptstandort für die Verlagerung von Zentral- und Staatsunternehmen sammelt Xiong'an derzeit zahlreiche Hauptsitze großer Unternehmen aus den Bereichen Petrochemie, Energie und Metallurgie an. Mit der Ansiedlung in Xiong'an steht das Unternehmen von Anfang an auf demselben Boden wie die wichtigsten Vermögenswerte der chinesischen Realwirtschaft.
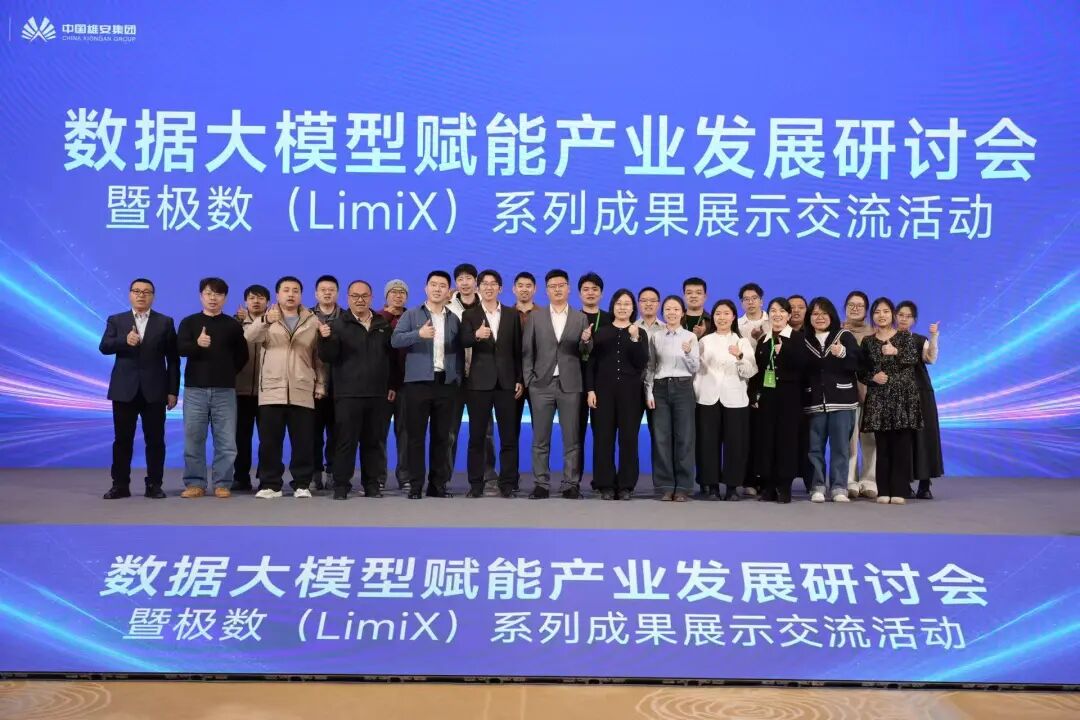
Der Xiong'an Technologie-Innovations-Angelfonds (Xiong'an Kechuang Fonds) wurde der erste investierende Partner – die beiden Seiten nahmen ab Herbst 2024 Kontakt auf, und von der Due-Diligence-Prüfung über die Verhandlung der Bewertung bis zur endgültigen Abwicklung und Zahlung vergingen nur zwei Monate. Damit wurde Wenzhun Intelligent auch das erste Projekt, in das der Xiong'an Kechuang Fonds investiert hat. Diese Angel-Finanzierung in Höhe von 20 Millionen Yuan wurde das erste Kapital, das das Team in der Gründungsphase für den Start der Forschung und Entwicklung nutzte.
Danach eröffnete sich die Finanzierungssituation: Wenzhun Intelligent erhielt nacheinander Pre-A- und Serie-A-Finanzierungen im Wert von über 100 Millionen Yuan, mit Investoren wie Oriental Fortune Capital, Sinovent Capital und Yu Capital. Bis vor kurzem wurde die Serie-A+-Finanzierung im Wert von mehreren hundert Millionen Yuan abgeschlossen, und die Bewertung von Wenzhun Intelligent hat sich innerhalb von zwei Jahren mehrfach vervielfacht.
Sinovent Capital, das frühzeitig in die Serie-A-Runde investiert hat, konzentriert sich auf Bereiche wie künstliche Intelligenz und intelligente Fertigung. "Wir erwarten sehr, dass LimiX zu einem der zentralen großen Basismodelle im inländischen Industrie- und Wissenschaftsbereich wird und eine wichtige Stütze für die nationale Strategie 'Künstliche Intelligenz +' darstellt", erklärte Sinovent Capital. "Wir haben früh in dieses Team investiert, weil wir vor allem die weltweit führenden Forschungsergebnisse und Erfahrungen des Teams im Bereich der kausalen Theorie schätzen, sowie die Fähigkeit des Teams, die kausale Theorie kreativ mit den allgemeinen Trainingsmethoden für große Modelle zu verbinden und die Generalisierungsfähigkeit des Modells durch ständiges Scaling-Up zu verbessern."
Yu Capital, das seit langem in zukunftsweisende Technologien investiert, ist einer der gemeinsamen Anführer der Serie-A-Runde. In einem Interview erklärte es: "Was uns bei Wenzhun Intelligent am meisten beeindruckt hat, ist die Wahl eines schwierigeren, aber besser an die chinesischen industriellen Gegebenheiten angepassten originellen Pfades. Die mehr als zehnjährige Erfahrung dieses Teams im Bereich des kausalen Lernens, kombiniert mit der Kombination von technischer Tiefe, technischer Umsetzung und kommerzieller Kompetenz der Lehrkräfte und Studenten der Tsinghua-Universität, macht es möglich, dass das 'große Datenmodell' in den industriellen Vordergrund tritt. Sie haben die Chance, der Definierer des LDM-Segments und eine repräsentative chinesische Kraft im globalen Wettbewerb zu werden."
Chinesisches originelles Basismodell bricht Rekorde und erreicht die internationale Spitze
Cui Peng sprach von einem entscheidenden Moment: 2025 stellte Wenzhun Intelligent offiziell das LDM-Konzept vor und brachte das Basismodell "Jishu LimiX" auf den Markt.
Was ist der Unterschied zwischen LDM und dem bekannten LLM als zwei allgemeine Modelle?
Der wesentlichste Unterschied liegt in der Quelle der Allgemeingültigkeit. Er erläuterte: Die Allgemeingültigkeit von LLM stammt daraus, dass es ein erfahrungsbasiertes Modell mit umfassendem Wissen ist, das das gesamte Weltwissen in sich trägt; die Allgemeingültigkeit von LDM stammt hingegen daraus, dass es ein fähigkeitsbasiertes Modell ist, das Kausalzusammenhänge durchschaut – solange das Modell in der Vor-Trainingsphase die Fähigkeit erhält, die kausalen Zusammenhänge hinter den Daten zu erfassen, kann es in jedem Szenario allgemein eingesetzt werden und Vorhersagen und Entscheidungen treffen.
Dahinter verbirgt sich ein völlig anderes Trainingsparadigma.
In der Vor-Trainingsphase nutzt das Wenzhun-Team strukturierte kausale Modelle, um synthetische Daten zu generieren, die verschiedene Variablenbeziehungen, Generierungsmechanismen und Beobachtungsbedingungen abdecken. Das Modell lernt kausale Zusammenhänge, indem es verdeckte Daten wiederherstellt, und schließt aus vorhandenen Informationen auf unbekannte Größen. Die für strukturierte Daten entworfene Architektur modelliert gleichzeitig die Beziehungen zwischen Variablen und zwischen Stichproben.
Diese Trainingsmethode zielt darauf ab, dem Modell eine übertragbare Datenmodellierungsfähigkeit zu verleihen. Bei neuen Forschungsaufgaben gibt das Modell die aktuellen Daten als Kontext ein und führt entsprechende Vorhersagen durch, ohne dass ein neues auf die spezielle Aufgabe zugeschnittenes Modell neu trainiert werden muss. Dies schafft die Voraussetzungen, um dasselbe Basismodell in verschiedenen Bereichen wiederzuverwenden. In der Ära des Mangels an Modellen und Daten ist dies ein struktureller Vorteil.
Er verglich es mit einem Beispiel: Die Sensibilität von Menschen für Zahlen stammt aus verschiedenen Mathematikaufgaben in der Kindheit. Die Aufgaben sind keine echten Daten, aber sie ermöglichen es den Menschen, die Fähigkeit zur Erfassung von Gesetzen zu entwickeln. "Fähigkeitsmodelle brauchen keine echten Erfahrungen, Erfahrungsmodelle schon", sagte er. Von einfachen zu schwierigen Aufgaben wird das Modell selbst stärkere Fähigkeiten entwickeln. "Wir trainieren das Modell mit Olympiade-Mathematik, und am Ende nimmt es an der Hochschulaufnahmeprüfung teil."
Im August 2025 wurde LimiX offiziell als Open-Source-Software veröffentlicht. Viele große Unternehmen haben es heruntergeladen und praktisch getestet: In Szenarien wie der Diagnose kritischer Fehler, der Entwicklung neuer Materialien, der Wartung von Geräten und dem Stromhandel übertrifft die Leistung dieses allgemeinen Modells die spezialisierten Modelle, die Kunden mit ihren eigenen, über Jahre gesammelten Geschäftsdaten trainiert haben.
Mit der Open-Source-Veröffentlichung von LimiX ist dieses Segment innerhalb eines Jahres populär geworden.
Im September 2026 wurde das neue Modell LimiX-2 veröffentlicht, das auf den drei internationalen strukturierten Daten-Ranglisten TabArena, TALENT und BCCO eine dominante Spitzenposition einnimmt und jeweils den ersten Platz unter allen teilnehmenden Modellen erreicht: Derselbe vortrainierte Modell kann ohne Aktualisierung von Parametern für spezifische Aufgaben den SOTA-Zustand für Klassifizierung, Regression und Vorhersage erreichen.
Im selben Monat veröffentlichte NVIDIA Kumo Tabular und nahm LimiX-2 direkt in die Leistungsvergleiche in seinen offiziellen technischen Artikeln auf, um die Inferenzeffizienz des neuen Modells anhand von LimiX-2 als Referenz vorzustellen. Das bedeutet, dass die Modellfähigkeit von Wenzhun Intelligent bereits zum