Ein einziges Bild schreckte einen Forscher so sehr, dass er auf der Stelle seinen Rücktritt einreichte, und das verrückteste Kultbild von Anthropic ist durchgesickert.
Da er intern ein Liniendiagramm gesehen hat, hat ein Spitzen-KI-Forscher kurz vor dem Billionen-IPO direkt den Tisch umgeworfen und gekündigt!
Er heißt Jacob Coxon und war nacheinander als Pre-Training-Forscher bei OpenAI und Anthropic tätig. Vor zwei Monaten hat er entschlossen auf riesige IPO-Optionen verzichtet und seinen Arbeitsplatz aufgegeben.
Erst in den letzten Tagen hat er das „Übeltäter“-Diagramm geteilt, das ihn zum Verlassen des Unternehmens veranlasst hat.
Überraschenderweise hat Anthropic dieses interne, legendäre Diagramm sogar im Rahmen der IPO-Roadshow als wichtigstes Trumpfstück öffentlich vorgestellt.
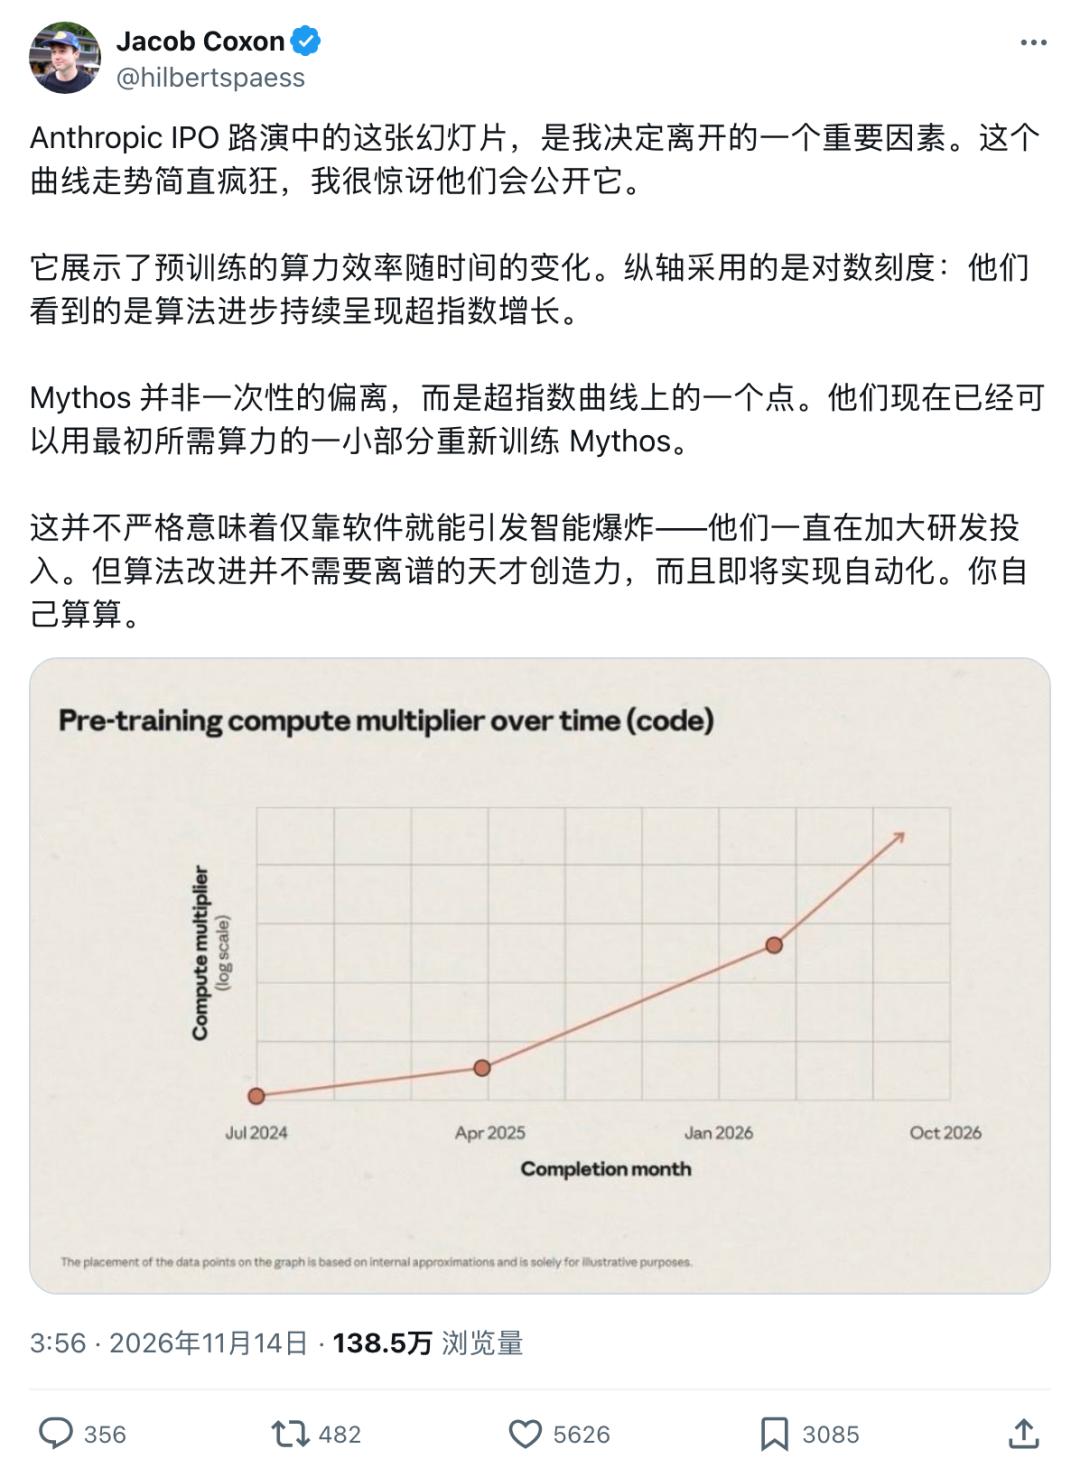
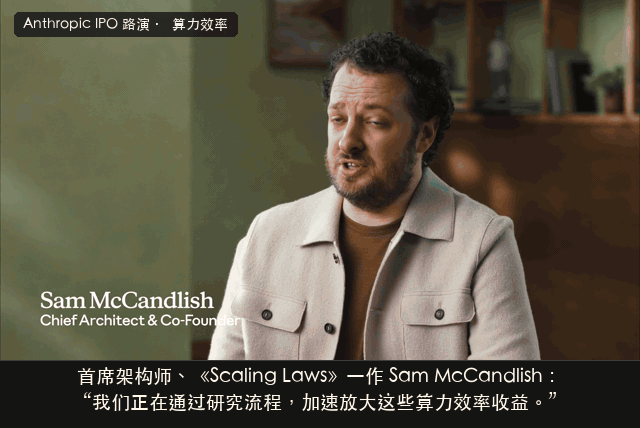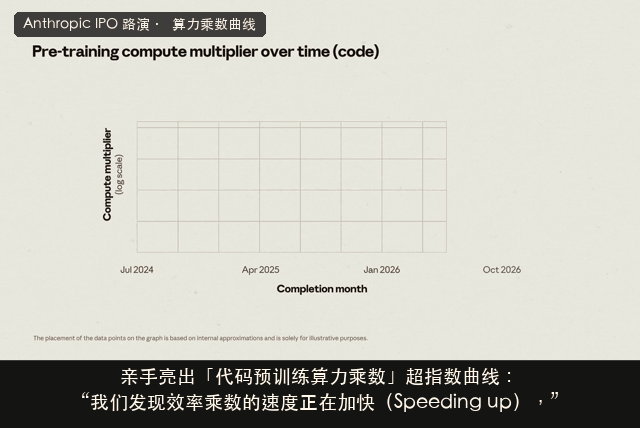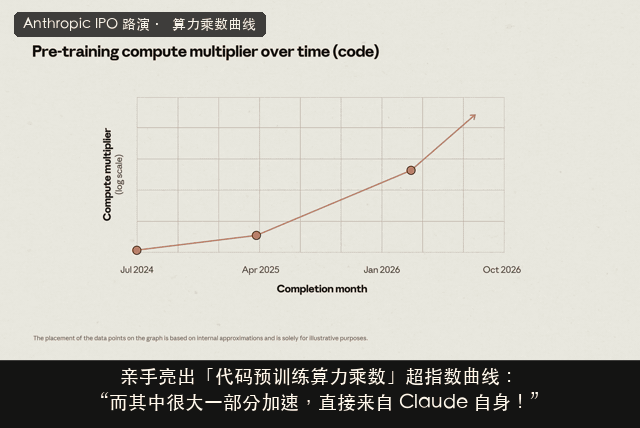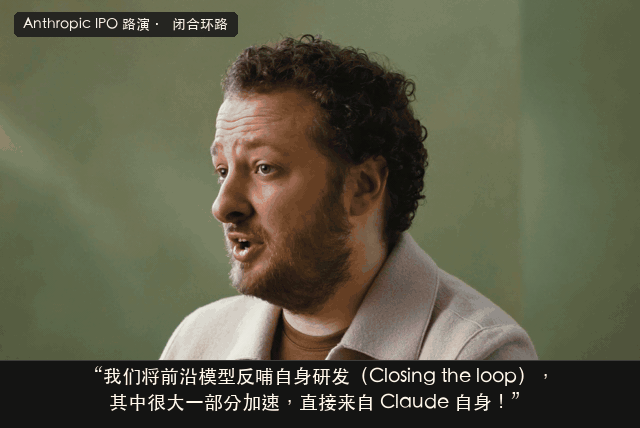
Die orangefarbene Kurve im Diagramm lässt sich selbst in logarithmischen Koordinaten nicht eindämmen und steigt weiterhin beschleunigt und steil nach oben.
In den Augen der Beteiligten ist das gleichbedeutend mit dem Auslösen eines „Singularitätsalarms“!
In Kombination mit den neu veröffentlichten Originalaufnahmen der Roadshow und den Kerndokumenten des Prospekts von Anthropic tauchen drei erkenntnisverändernde Wahrheiten auf:
„Pre-Training stößt an die Wand“ ist vollständig widerlegt, der Rechenaufwand für das erneute Training von Mythos sinkt drastisch
Der erste Mythos, der gerade die globalen Ranglisten angeführt hat, ist auf der internen Kurve nur ein Zwischenknoten – heute reicht es, einen kleinen Teil des ursprünglichen Rechenaufwands einzusetzen, um ihn von Grund auf neu zu trainieren!
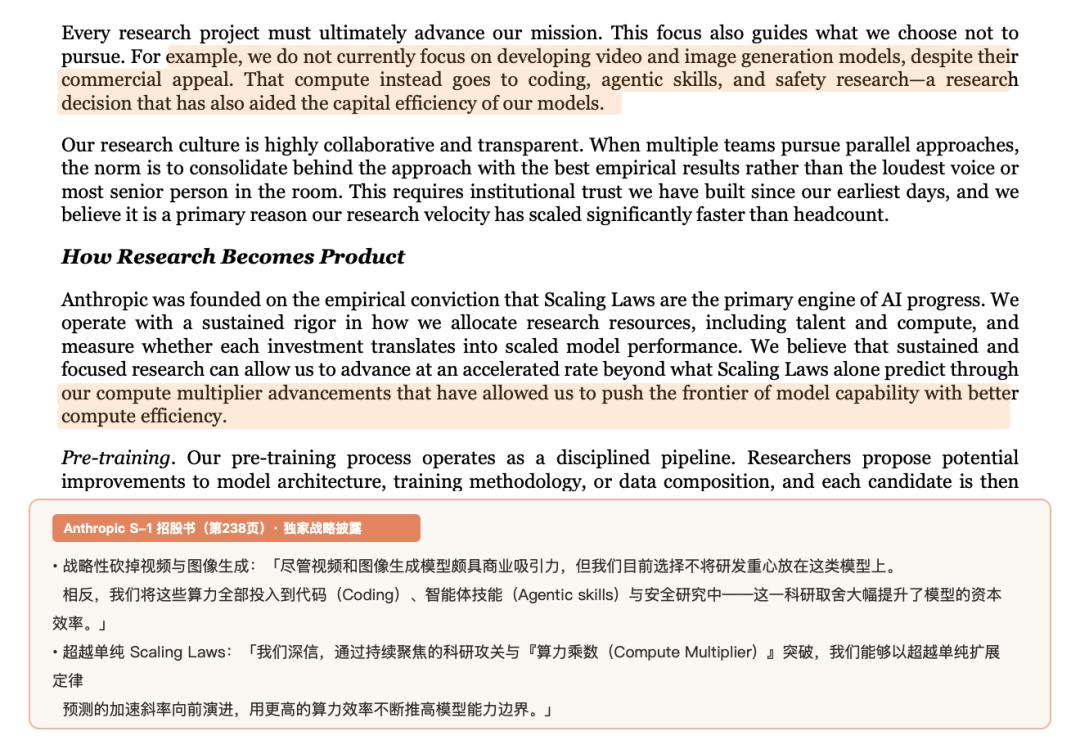
Der Urheber der Scaling Laws enthüllt die Geheimnisse: Videogenerierung eingestellt, volle Konzentration auf Code zur beschleunigten Selbstverbesserung der KI
Da Claude umgekehrt die Entdeckung von Algorithmus-Multiplikatoren stark beschleunigt, verzichtet Anthropic entschieden auf die Generierung von Videos und Bildern und setzt den gesamten Rechenaufwand auf Code und Agenten ein, die die KI-Entwicklung selbst unterstützen können.
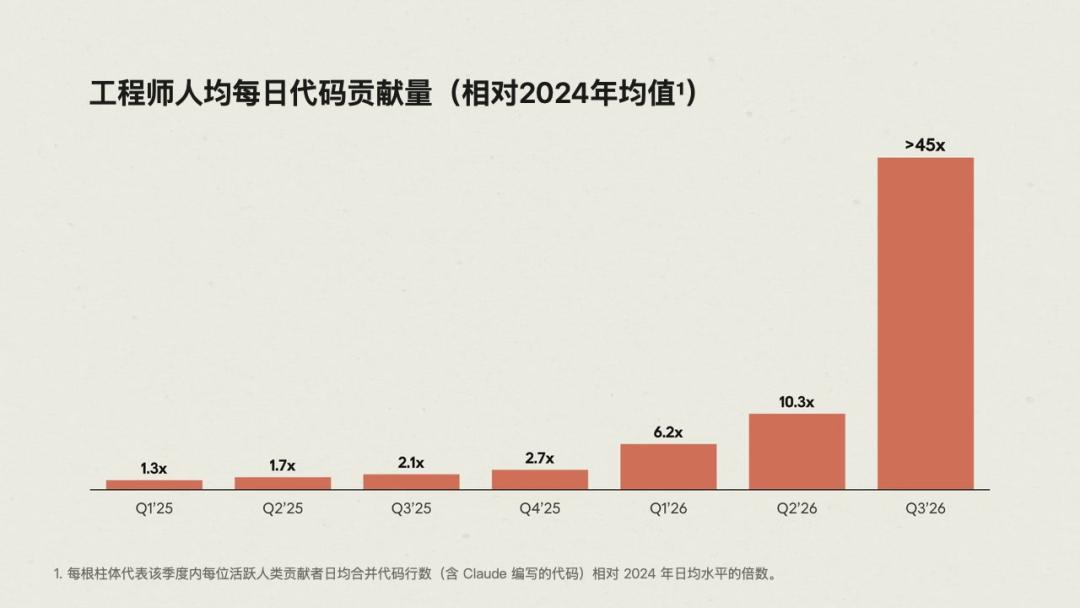
Der durchschnittliche Codebeitrag pro Person steigt um das 45-fache an, fast alle Operatoren werden in drei Tagen ohne menschliche Beteiligung neu geschrieben
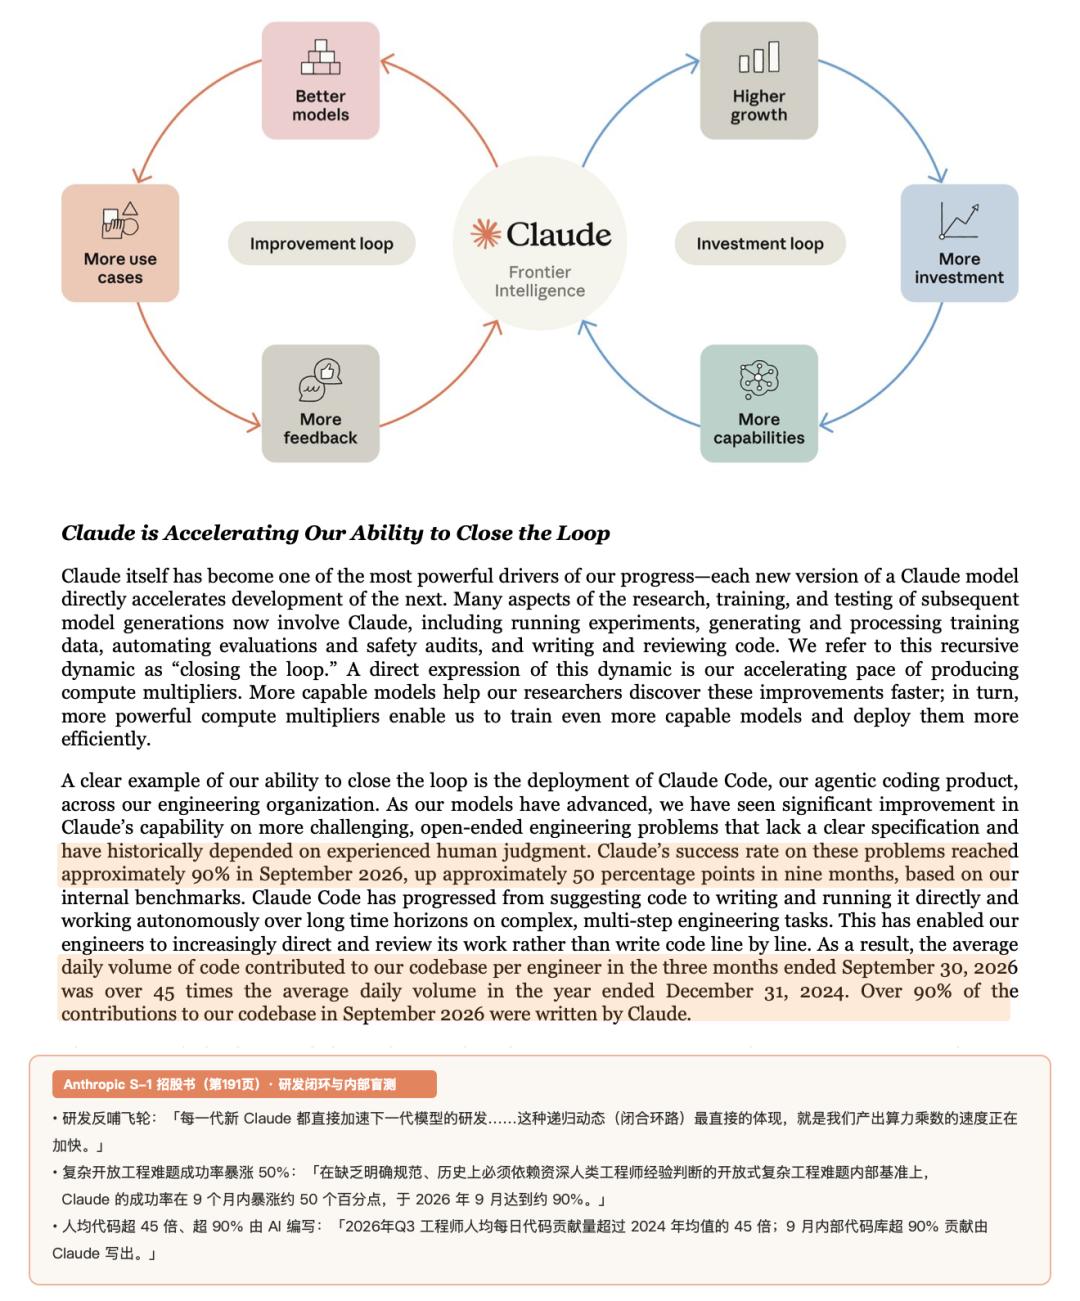
Über 90 % des internen Codes wird bereits von Claude erstellt, die Erfolgsrate bei blinden Tests komplexer Ingenieuraufgaben steigt auf 90 % – sogar die untersten Operatoren neuer Chips können von Mythos innerhalb von 3 Tagen unabhängig neu geschrieben werden!
Selbst logarithmische Koordinaten können den Anstieg nicht eindämmen
Der Rechenaufwand für das erneute Training von Mythos sinkt stark
Wenn man dieses legendäre Roadshow-Diagramm vergrößert, das Jacob Coxon nachts nicht schlafen lässt, verbirgt sich das wichtigste Geheimnis in der Gestaltung der horizontalen und vertikalen Achsen.
Die vertikale Achse des Diagramms heißt „Rechenmultiplikator“ und gibt an, um wie viele Male der Rechenaufwand durch die Evolution des Algorithmus eingespart wird: Je höher der Multiplikator ist, desto weniger Rechenleistung wird benötigt, um ein Modell mit gleicher Leistung zu trainieren.
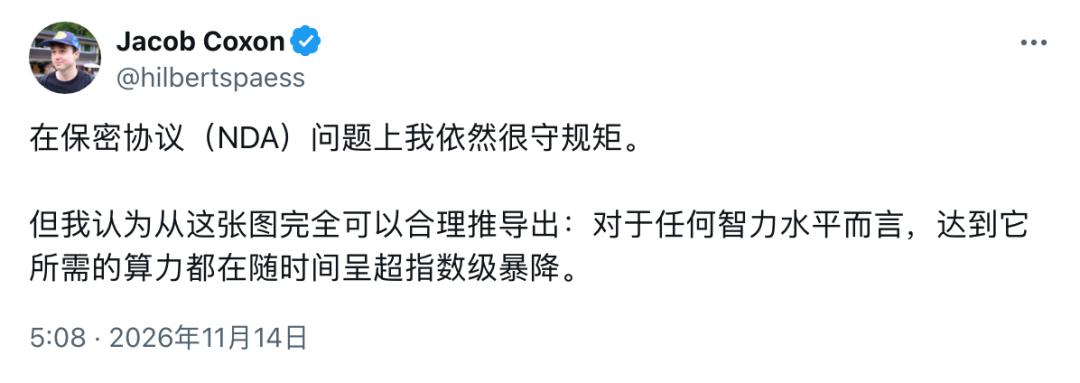
Warum kann man diese Schlussfolgerung ziehen, obwohl die Zahlen entfernt wurden? Das Geheimnis liegt vollständig in den vier Wörtern „logarithmische Skalierung“ neben der vertikalen Achse.
Denn in einem gewöhnlichen linearen Koordinatensystem bedeutet jeder Schritt nach oben nur ein banales „+1, +2“.
In einem logarithmischen Koordinatensystem hingegen bedeutet jeder Schritt nach oben eine Verdoppelung der Effizienz oder sogar eine Verzehnfachung.
Das bedeutet auch: Selbst wenn die Effizienz des Algorithmus bereits exponentiell verdoppelt wird, wird sie in logarithmischen Koordinaten nur eine gerade diagonale Linie darstellen.
In diesem Diagramm ist die orangefarbene Linie jedoch keine Gerade, sondern wird mit zunehmendem Verlauf immer steiler und beschleunigt stetig in Richtung der oberen rechten Ecke:
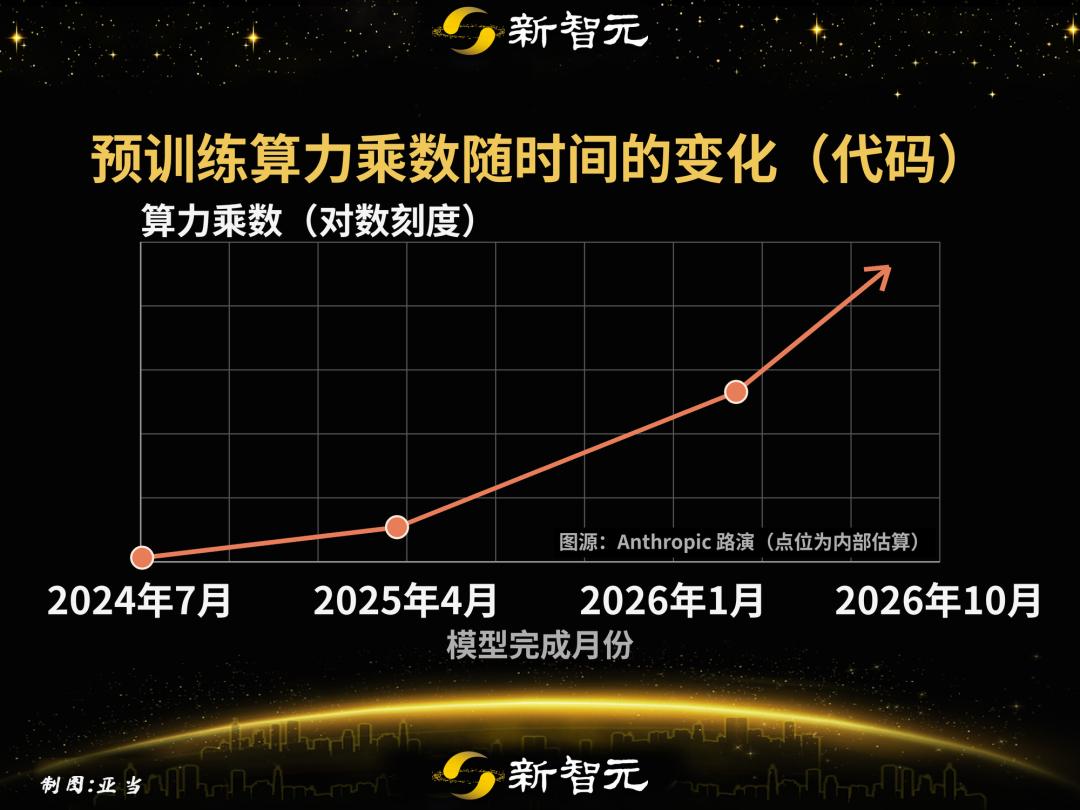
Dafür gibt es nur eine Erklärung: Die Effizienz des Code-Pretrainings ist in eine „superexponentielle“ Explosion eingetreten, selbst die Geschwindigkeit der Effizienzverdoppelung selbst beschleunigt sich stetig!
Im vergangenen Jahr gab es im Silicon Valley immer wieder pessimistische Töne, dass das „Pre-Training an die Wand stößt“ – diese rasant ansteigende orangefarbene Kurve zerschlägt die „Wand-Anstiegs-Theorie“ direkt vollständig.
Verglichen mit dem im Prospekt offengelegten Zeitplan der Modelle ist der dritte orangefarbene Punkt im Diagramm genau der Pre-Training-Knoten des ersten Mythos, der im April dieses Jahres die Branche aufgeregt hat.
Der Pfeil, der in Richtung der oberen rechten Ecke zeigt, steht für die erneute große Explosion des Algorithmus-Multiplikators nach nur einem halben Jahr der Iteration zum neuesten Mythos 5.2.
Genau das hat Jacob Coxon so schockiert: Der erste Mythos, der gerade die globalen Ranglisten angeführt hat, ist auf dieser Kurve längst Vergangenheit.
Dank der in diesem halben Jahr addierten Algorithmus-Multiplikatoren reicht es heute, nur einen kleinen Teil des ursprünglichen Rechenaufwands einzusetzen, um ein Modell auf gleichem Niveau neu zu trainieren!
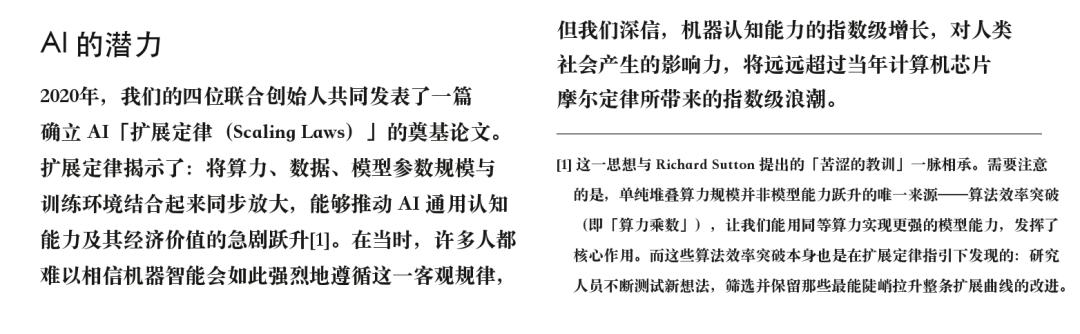
Der Urheber der Scaling Laws enthüllt die Geheimnisse
Videogenerierung eingestellt, volle Konzentration auf Code
Wenn die reine Effizienzsteigerung noch nicht ausreicht, um einen Spitzenforscher zum Gehen zu bewegen, ist es die treibende Kraft hinter dieser rasant ansteigenden Kurve, die Jacob Coxon endgültig dazu gebracht hat, auf seine Anteile zu verzichten und zu kündigen.
Während der IPO-Roadshow hat Mitbegründer und Chefarchitekt Sam McCandlish, Erstautor der ursprünglichen Arbeit zu den „Scaling Laws“, dieses Diagramm persönlich vorgestellt.
Er hat vor Ort direkt den Grund für die plötzliche beschleunigte Steigung der Linie im hinteren Teil offengelegt –
In der frühen Phase wurden neue Algorithmus-Multiplikatoren hauptsächlich von menschlichen Forschern manuell validiert, daher war die Steigung zwischen den ersten beiden Punkten relativ flach.
Als das Team dann das fortschrittliche Claude-Modell direkt in den Entwicklungsprozess zur Verbesserung seiner selbst einbrachte, wurde die Geschwindigkeit, mit der Effizienz-Multiplikatoren entdeckt werden, von Claude stark beschleunigt!
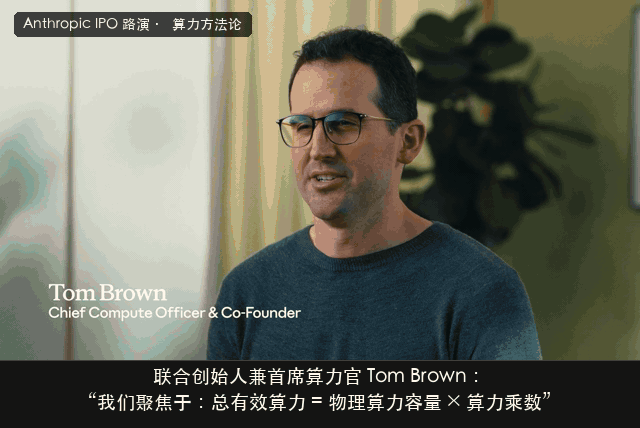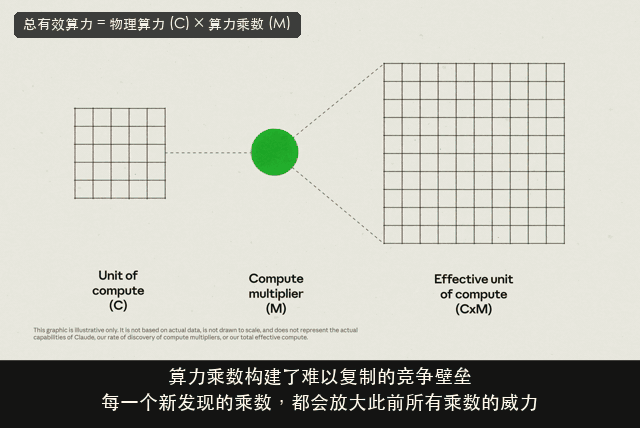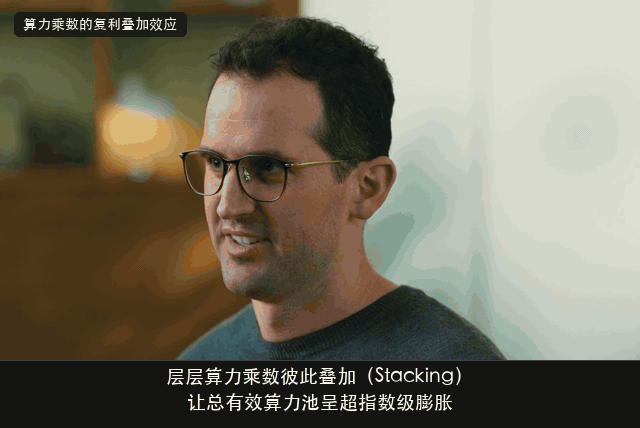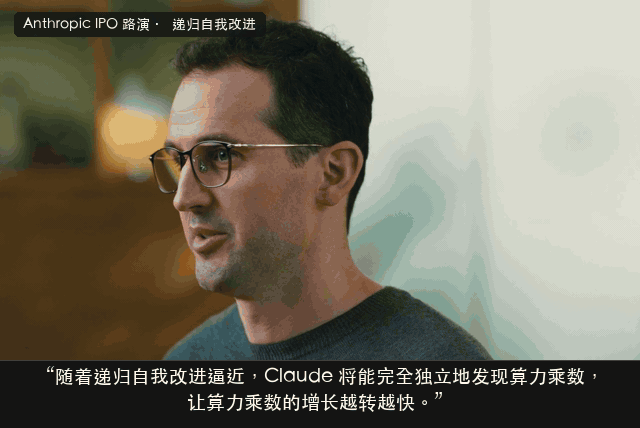
Anschließend hat Mitbegründer und Chief Computing Officer Tom Brown die Funktionsweise dieser „Rechenmaschine“ weiter aufgeschlüsselt, nämlich „Gesamteffektive Rechenleistung = physische Rechenkapazität × Rechenmultiplikator“.
Wie stark ist die Sprengkraft dieser Formel? Angenommen, das Training eines Top-Großmodells würde ursprünglich 100 Einheiten physische Rechenleistung verbrauchen.
Sobald das Algorithmus-Team einen 4-fachen Rechenmultiplikator findet, reichen 25 Einheiten Rechenleistung aus, um ein Modell mit gleicher Leistung zu trainieren.
Umgekehrt, wenn man alle 100 Einheiten Rechenleistung einsetzt, kann man direkt ein Supermodell trainieren, das dem Umfang von 400 Einheiten Rechenleistung entspricht.
Das Schrecklichste daran ist, dass Rechenmultiplikatoren aus verschiedenen Dimensionen wie Zinseszinsen miteinander multipliziert werden können – jeder neu entdeckte Multiplikator verstärkt die Wirkung aller vorherigen Multiplikatoren noch einmal.
Wenn man sich den Titel dieses Liniendiagramms genau ansieht, steht am Ende extra eine Klammer mit der Beschriftung „(Code)“.
Im S-1-Prospekt erklärt Anthropic öffentlich die große strategische Entscheidung hinter dieser Beschriftung.
Obwohl die Generierung von Videos und Bildern sehr kommerziell attraktiv ist, entscheidet sich Anthropic derzeit dafür, die Entwicklung von Video- und Bildgenerierungsmodellen einzustellen.
Das Unternehmen konzentriert die eingesparten Rechenressourcen vollständig auf Code, Agenten und Sicherheitsforschung, um die KI direkt die eigene Entwicklungs-Pipeline übernehmen zu lassen.
In den Augen der Forscher an vorderster Front ist das gleichbedeutend damit, das Ventil für die „selbstbeschleunigte Entwicklung der KI“ persönlich aufzudrehen!
Der durchschnittliche Codebeitrag pro Person steigt um das 45-fache an
Operatoren werden in drei Tagen ohne menschliche Beteiligung neu geschrieben
Sobald das Ventil aufgedreht ist, erlebt die interne Entwicklungseffizienz von Anthropic eine Explosion, die selbst die Beteiligten als erstickend empfinden.
Ein weiteres Balkendiagramm im Roadshow-Video zeigt: Verglichen mit dem täglichen Durchschnittswert von 2024 ist die Menge an Code, die jeder interne Ingenieur täglich beisteuert, in diesem Jahr durch die Decke gegangen.
Diese Zahl ist von dem 6,2-fachen im ersten Quartal und dem 10,3-fachen im zweiten Quartal vertikal auf über das 45-fache im dritten Quartal gestiegen – innerhalb von nur zwei Quartalen hat sie sich mehr als versiebenfacht!
Gleichzeitig ist die Erfolgsrate von Claude bei internen blinden Tests in 9 Monaten um 50 Prozentpunkte auf etwa 90 % gestiegen, selbst bei komplexen offenen Ingenieursproblemen, für die früher die Erfahrung erfahrener menschlicher Ingenieure erforderlich war.
In den ersten 9 Monaten dieses Jahres ist die Anzahl der Aufrufe von Claude durch interne Mitarbeiter um über das 250-fache angestiegen, und mehr als 90 % des Codes im Codepool wird vollständig von Claude geschrieben.
Menschliche Ingenieure tippen nicht mehr Zeile für Zeile manuell Code ein, sondern geben stattdessen hochrangige Anweisungen und prüfen die Ergebnisse der langfristigen autonomen Ausführung durch die KI.
Wenn die KI mehr als 90 % des täglichen Entwicklungscodes übernimmt, beginnt sie sogar, die von der gesamten Chipbranche als am schwierigsten eingestufte unterste Hardwareanpassung zu übernehmen.
Bei regulären Großunternehmen müssen bei der Integration einer neuen Chiparchitektur oft Hunderte von untersten Ingenieuren monatelang hart arbeiten, um den Software-Stack und die Operator-Bibliothek Zeile für Zeile neu zu schreiben.
Als Anthropic dieses Jahr zum ersten Mal AMD-GPUs in einen einheitlichen Multi-Chip-Rechenpool integriert hat, hat das Team direkt sein eigenes Mythos-Modell eingesetzt.
Unter fast völliger Ausschluss menschlicher Eingriffe hat Mythos in nur 3 Tagen fast 100 % der untersten Operator-Kerne unabhängig neu geschrieben, sodass Claude auf dem AMD-Cluster mit voller Geschwindigkeit laufen