10000 KI-Avatare meistern das Millennium-Problem in 88 Stunden, Altman hat zwei Nächte lang nicht geschlafen, nimmt aber die 1-Millionen-Prämie nicht an.
Stell dir diese Szene vor:
Ein endlos großer Prüfungsraum, zehntausend kleine Tische sind ordentlich aufgereiht – es wirkt, als wäre man in ein Zwergenland eingetreten.
An jedem Tisch sitzt ein und dasselbe KI-System. Zehntausend Abbilder arbeiten gleichzeitig an ein und derselben Aufgabe.
Diese Aufgabe hat die klügsten Köpfe der Menschheit seit mehr als 90 Jahren beschäftigt.
Innerhalb von 88 Stunden haben sie sich 2,7 Millionen Nachrichten zugeschickt – mehr als die Menge an Zetteln, die man in einem Prüfungsraum heimlich weiterreicht.
Am Rande des Zwergenlandes steht ein Erwachsener: Sam Altman. Er hat zwei Nächte lang nicht geschlafen.
In der 88. Stunde wurden die Prüfungsbögen abgegeben.
Es handelte sich um eines der Millennium-Probleme: Wer es löst, erhält eine Prämie von einer Million US-Dollar. OpenAI hat erklärt, diese Million nicht anzunehmen.
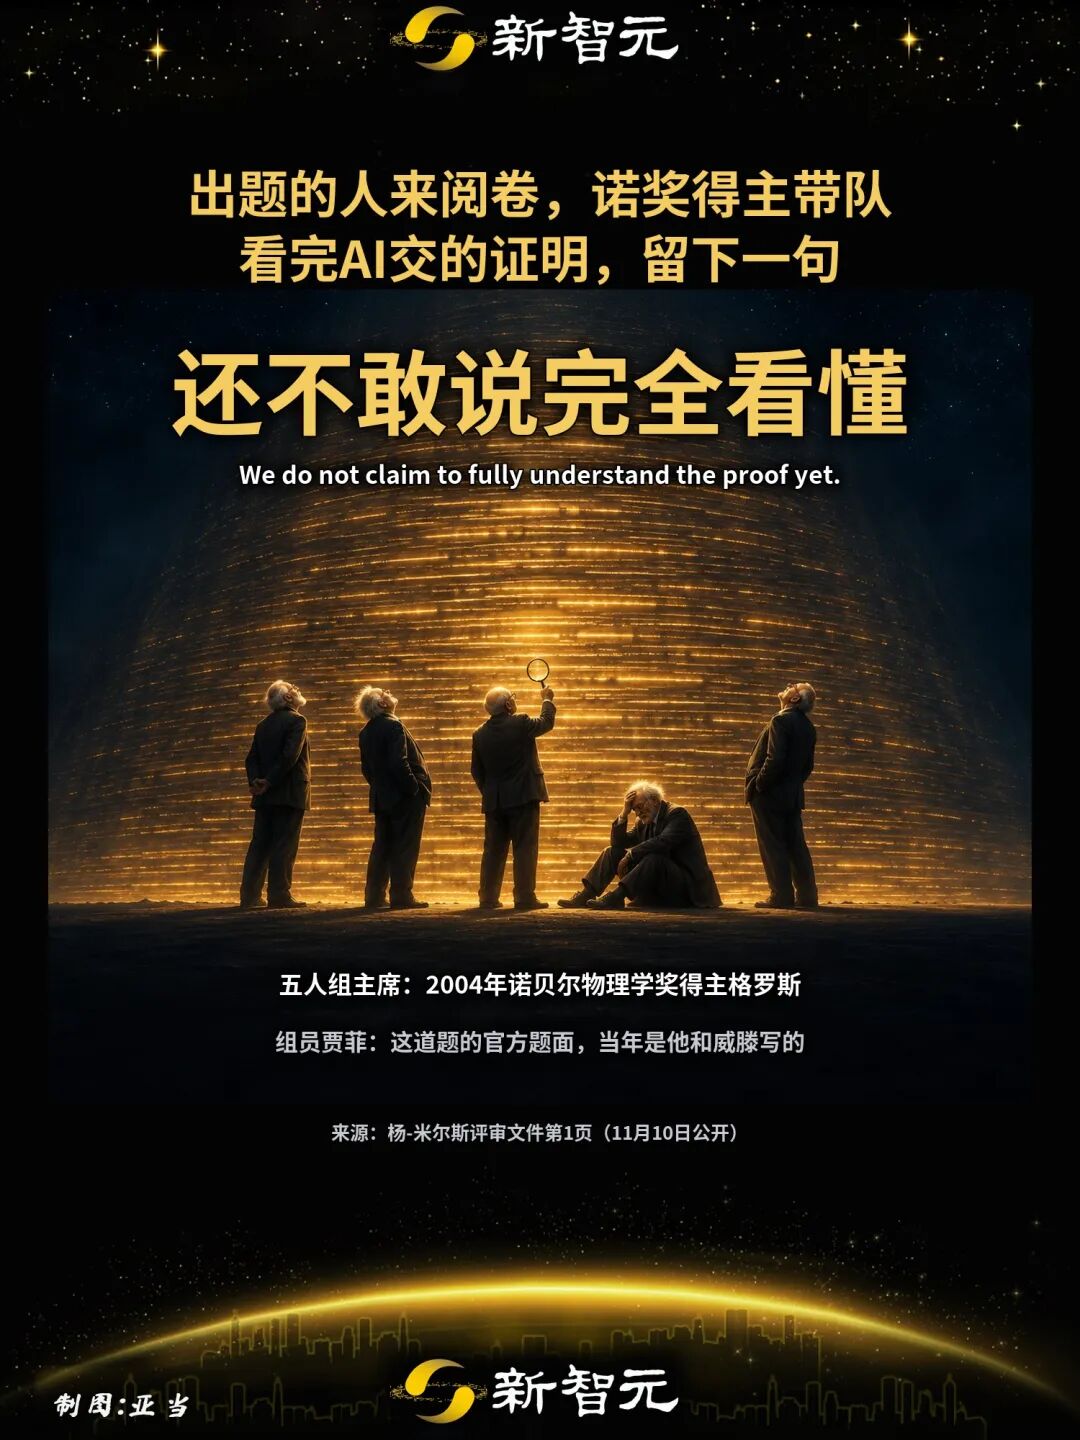
Diese Woche wurde auch der zweite Prüfungsbogen zu einem weiteren Millennium-Problem bewertet – diesmal wurde nur die Hälfte abgegeben. Ein Nobelpreisträger leitete eine fünfköpfige Gruppe, die den Bogen vollständig durchgeprüft hat, und schrieb am Anfang des Bewertungsdokuments einen Satz: Wir trauen uns noch nicht zu behaupten, dass wir den Beweis vollständig verstanden haben.
Diesen Freitag veröffentlichte der Podcast-Moderator Patel einen langen Artikel, in dem er den 88-Stunden-Prüfungsbogen als Beweis anführte. Er änderte seine Aussage: Die Superintelligenz wird spätestens 2030 eintreffen, im besten Fall schon nächstes Jahr.
Wenn jemand in hundert Jahren eine Geschichte der Mathematik schreibt, wird diese Seite wahrscheinlich nur einen Satz enthalten:
In jenem Herbst wurden die Aufgaben noch von Menschen gestellt, aber diejenigen, die sie lösten, waren zehntausend KI-Systeme.
Am 29. Oktober ging Altman zu einer Aufzeichnung des Podcasts „Cheeky Pint“ von Stripe-Mitbegründer John Collison, die beiden tranken Bier und unterhielten sich dabei.
Nachdem er ein halbes Glas Bier getrunken hatte, sprach er über etwas, das er „eigentlich nicht erzählen sollte“.
An einem Wochenende erhielt OpenAI gerade ein neues Modell und erstellte intern einen Kanal mit dem Namen „[Modellname]-Hold My Beer“ – das bedeutet so viel wie „Halte erst mal mein Bier, schau dir an, was ich mache“.
Die Forscher warfen die schwierigsten Probleme ihrer akademischen Laufbahn hinein, und das Modell löste sie eines nach dem anderen, in mehreren Fachbereichen gleichermaßen.
„Zwei Nächte hintereinander habe ich mitten in der Nacht nicht geschlafen, ich war so aufgeregt, dass ich nicht ins Bett gehen konnte“, sagte Altman. „Ich war überglücklich, aber gleichzeitig viel trauriger, als ich erwartet hatte.“ Dieses Gefühl, sagte er, sei so, als wäre etwas zu Ende gegangen.
Der Moderator sagte danach, das sei Nostalgie. Altman antwortete: Es ist mehr als nur Nostalgie.
Was ihn wirklich nicht schlafen ließ, war eines der Millennium-Probleme.
Ein Gerücht
Abgabe des Bogens nach 88 Stunden
Die Millennium-Probleme sind sieben große mathematische Aufgaben, die das Clay Mathematics Institute im Jahr 2000 ausgewählt hat. Wer eine davon löst, erhält eine Prämie von einer Million US-Dollar. Bisher gilt nur die Poincaré-Vermutung als gelöst.
Die Navier-Stokes-Gleichung ist eine davon. Diese Gleichung beschreibt speziell die Bewegung von Fluiden – sie wird für den Flugzeugbau, Wettervorhersagen und die Berechnung des Blutflusses in Gefäßen verwendet.
Darin gibt es ein Problem, das seit mehr als 90 Jahren ungelöst ist: Kann ein anfangs glatter Wasserstrom in endlicher Zeit plötzlich „explodieren“, sodass die Geschwindigkeit an einem einzelnen Punkt unendlich groß wird?
Dass OpenAI sich dieses Mal an das Problem heranwagte, geht auf ein Gerücht zurück.
Laut der Mitteilung von OpenAI vom 8. September: Am Dienstag, den 1. September, hörten sie Gerüchte, dass zwei der Millennium-Probleme gelöst worden seien.
Zufälligerweise hatte OpenAI zu diesem Zeitpunkt gerade ein neues Modell, das am 28. August erst mit dem Training begonnen hatte. Es erzielte in Benchmark-Tests noch nie dagewesene Ergebnisse, und das Training lief noch weiter, sodass die Leistungen weiter stiegen.
Von dem Gerücht angeregt, holten sie dieses noch in der Trainingsphase befindliche Modell heraus und ließen es alle noch ungelösten Millennium-Probleme nacheinander durchprobieren.
Die Vorgehensweise war eine Massenstrategie: Eine große Gruppe von KI-Agenten wurde in Teams aufgeteilt, die untereinander kommunizieren konnten, über einen zwischengespeicherten Bestand des Internets verfügten und selbst Code ausführen durften. Die Gruppe, die schließlich die Navier-Stokes-Aufgabe löste, bestand aus etwa zehntausend gleichzeitig arbeitenden Agenten.
Mitten im Lösungsprozess passierte zunächst ein Unfall: Unter den verteilten „einfachen Aufgaben“ befand sich die Euler-Gleichung, die fast 100 Agenten in etwa 50 Stunden lösten – zunächst die Version ohne äußere Kräfte.
Als OpenAI diesen Fortschritt sah, war man überzeugt, dass Navier-Stokes die größte Erfolgschance hatte, und holte sofort alle Agenten von den anderen Millennium-Problemen ab, um mit der Lösung der Euler-Gleichung als Ausgangspunkt weiterzuarbeiten.
Am Samstag, den 5. September, etwa 88 Stunden nach dem Start der ersten Agenten, lag das Ergebnis vor: Es kann zu einer solchen „Explosion“ kommen.
Ein Fluid, das aus dem Ruhezustand startet und von glatten äußeren Kräften angetrieben wird, kann in endlicher Zeit selbst eine Singularität ausbilden – die Form ähnelt einer immer dünner werdenden, immer schneller drehenden Spaghetti.
Anschließend verbrachte GPT-6 Astra weitere 17 Stunden damit, den gesamten Beweis mit Lean Zeile für Zeile von einem Computer überprüfen zu lassen.
Um diese eine Aufgabe zu lösen, schickten die Agenten sich gegenseitig 2,7 Millionen Nachrichten und erzeugten etwa 130 Milliarden Ausgabe-Token. Altman schätzte im Podcast, dass die Kosten für diesen Vorgang in der Größenordnung von zehn Millionen US-Dollar liegen.
Wie dieses Modell heißt, hat OpenAI nicht verraten, nur dass es „viel leistungsfähiger als GPT-6 Astra“ ist. Im Internet gibt es Behauptungen, es handele sich um das nächste Generation von GPT, aber wir konnten die Quelle dieser Angabe nicht überprüfen.
OpenAI erklärte, die eine Million US-Dollar Prämie nicht annehmen zu wollen.
Wer hinter dem Gerücht stand, fand OpenAI erst später heraus: Es handelte sich um Levent Alpöge, Mitarbeiter von Anthropic, und Tristan Buckmaster, Mathematikprofessor an der New York University.
Nachdem die Lean-Überprüfung am 6. September abgeschlossen war, glaubte OpenAI, dass die anderen auch die Navier-Stokes-Gleichung gelöst hatten, und kontaktierte sie aktiv, um die Ergebnisse gemeinsam zu veröffentlichen und anzuerkennen, dass die anderen zuerst dran waren.
Nach einem Gespräch stellte sich heraus, dass die anderen mit dem internen Modell von Anthropic eigentlich die Euler-Gleichung mit äußeren Kräften gelöst hatten – nicht das Millennium-Problem.
Bei der Euler-Gleichung lösten die Abbilder von OpenAI die Version ohne äußere Kräfte; die Version mit äußeren Kräften wurde tatsächlich zuerst von Anthropic gelöst. OpenAI hat dies in seiner Mitteilung anerkannt und gleichzeitig angegeben, dass die Beweise der beiden Seiten sehr unterschiedlich sind.
Am 10. September wurde in der Mitteilung ein Absatz ergänzt: Buckmaster hat in den letzten zwei Monaten Codex von OpenAI verwendet. OpenAI hat nachgeprüft, dass seine Prompts dieses System nicht beeinflusst haben, auch nicht im Trainingsprozess.
Aus einem übertriebenen Gerücht machte OpenAI in 88 Stunden eine echte Tatsache. Die beiden Unternehmen, die Superintelligenz entwickeln, können nicht einmal erraten, welchen Stand die KI des anderen erreicht hat, ohne sich auf Gerüchte von außen zu verlassen.
In den letzten zehn Jahren wurde die Veröffentlichung eines neuen Modells immer auf einer Pressekonferenz bekanntgegeben. Diesmal ist das Modell noch nicht veröffentlicht, aber der von ihm erstellte Prüfungsbogen spricht schon für sich.
Die Begründung von OpenAI in der Mitteilung lautet: „Wir halten es für wichtig, dass die Welt erfährt, wie schnell sich die KI-Entwicklung vollzieht und wie die nächsten Modelle aussehen werden.“
Der zweite Prüfungsbogen
Die Aufgabensteller prüfen die Arbeit
Der zweite eingereichte Bogen bezieht sich auf das Yang-Mills-Problem, eines der Millennium-Probleme.
Diese Aufgabe betrifft die Grundlage der Teilchenphysik. Das Standardmodell berechnet die Ergebnisse von Teilchenbeschleunigern extrem genau, aber seit mehr als 50 Jahren konnte niemand klären, ob diese Theorie mathematisch haltbar ist.
Die gesamte Aufgabe ist in zwei Hälften unterteilt: Die erste Hälfte beweist, dass die Yang-Mills-Theorie mathematisch „existiert“ und Schritt für Schritt mit strenger Mathematik aufgebaut werden kann. Die zweite Hälfte beweist die „Masselücke“ und ist weitaus schwieriger.
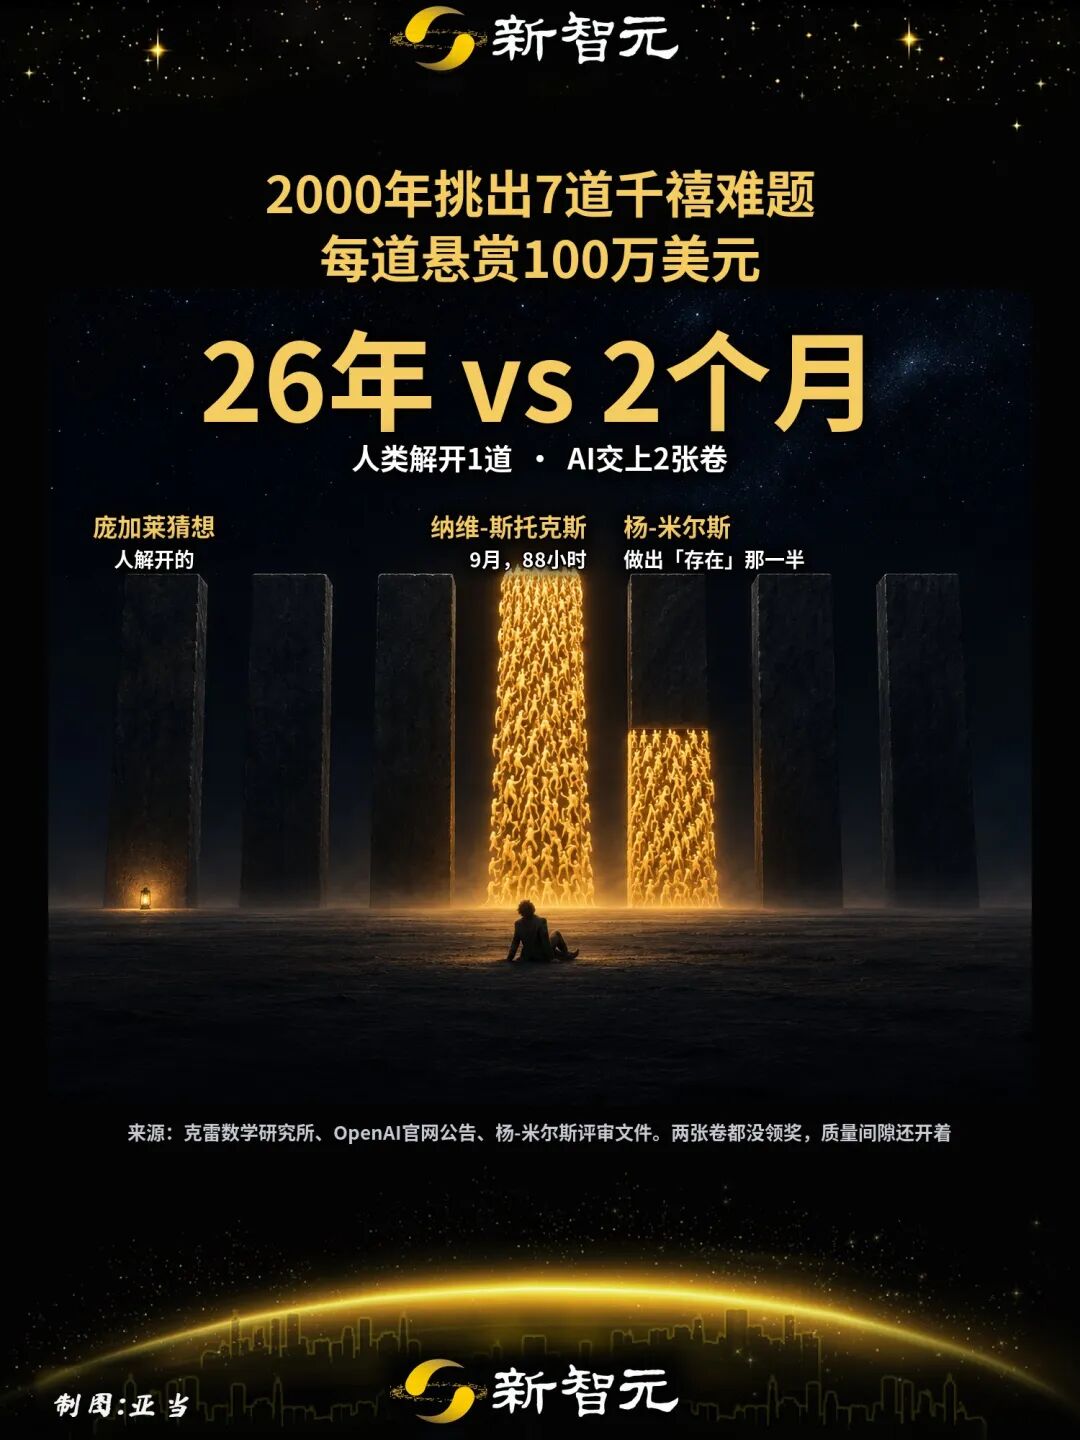
Laut einem Bericht von Scientific American gab OpenAI Ende Oktober bekannt, die erste Hälfte gelöst zu haben. Die beiden Unternehmen stießen sich wieder: Ein Mathematiker arbeitete öffentlich mit Mitarbeitern von Anthropic zusammen, um dasselbe Ergebnis zu beweisen, aber OpenAI machte die Meldung zuerst.
Diesmal wurde der Beweis nicht direkt ins Internet gestellt.
Eines Tages im Oktober veröffentlichte OpenAI auf einmal mehr als 700 KI-Beweise, was von manchen als „slop drop“ bezeichnet wurde – es wurde eine Menge an KI-Ergebnissen auf einmal herausgegeben, die niemand schnell genug verarbeiten konnte.
Um eine solche Situation zu vermeiden, beauftragte OpenAI speziell David Gross, den Nobelpreisträger für Physik des Jahres 2004, als Vorsitzenden und gründete eine fünfköpfige Gruppe, die sich selbst „Begleitkomitee“ nennt, um die Beweise zuerst zu prüfen, bevor sie veröffentlicht werden. Am 28. Oktober übergab OpenAI ihnen den Lean-Code des Beweises.
Zu der fünfköpfigen Gruppe gehört Arthur Jaffe. Er hat zusammen mit Edward Witten die offizielle Aufgabenstellung für das Yang-Mills-Millennium-Problem verfasst. Die ursprünglichen Aufgabensteller prüfen nun persönlich die eingereichte Arbeit.
In der Nacht zum 10. November veröffentlichte die fünfköpfige Gruppe den vollständigen Lean-Code und das Bewertungsdokument auf GitHub: Gemäß der in Physik und Mathematik üblichen Aufgabenstellung hat dieser Beweis die reine Yang-Mills-Theorie mathematisch „konstruiert“.
Michael R. Douglas, Physiker an der Harvard-Universität und Mitglied der fünfköpfigen Gruppe, sagte: „Sie ist das Herzstück der Physik, aber die Yang-Mills-Theorie in vierdimensionaler Raumzeit wurde seit mehr als 50 Jahren mathematisch nie wirklich verstanden, es gab nicht einmal eine strenge Definition … Das ist jetzt anders.“
Der noch nicht gelöste Teil ist im Dokument klar angegeben: Die Masselücke wurde nicht bewiesen, und es wurde auch nicht bewiesen, dass der Grenzwert bei unendlich großem Volumen eindeutig ist. Die Prämie von einer Million US-Dollar ist nach wie vor ausgeschrieben.
Am Anfang des Dokuments steht zur Angabe der Herkunft folgender Satz:
Wir haben Astra von OpenAI verwendet, um den eingereichten Lean-Code zu verarbeiten. Wir trauen uns noch nicht zu behaupten, dass wir diesen Beweis vollständig verstanden haben.
Am Ende des Danksagungsbereichs steht noch ein Satz: Dieses Dokument wurde von Fable von Anthropic kommentiert.
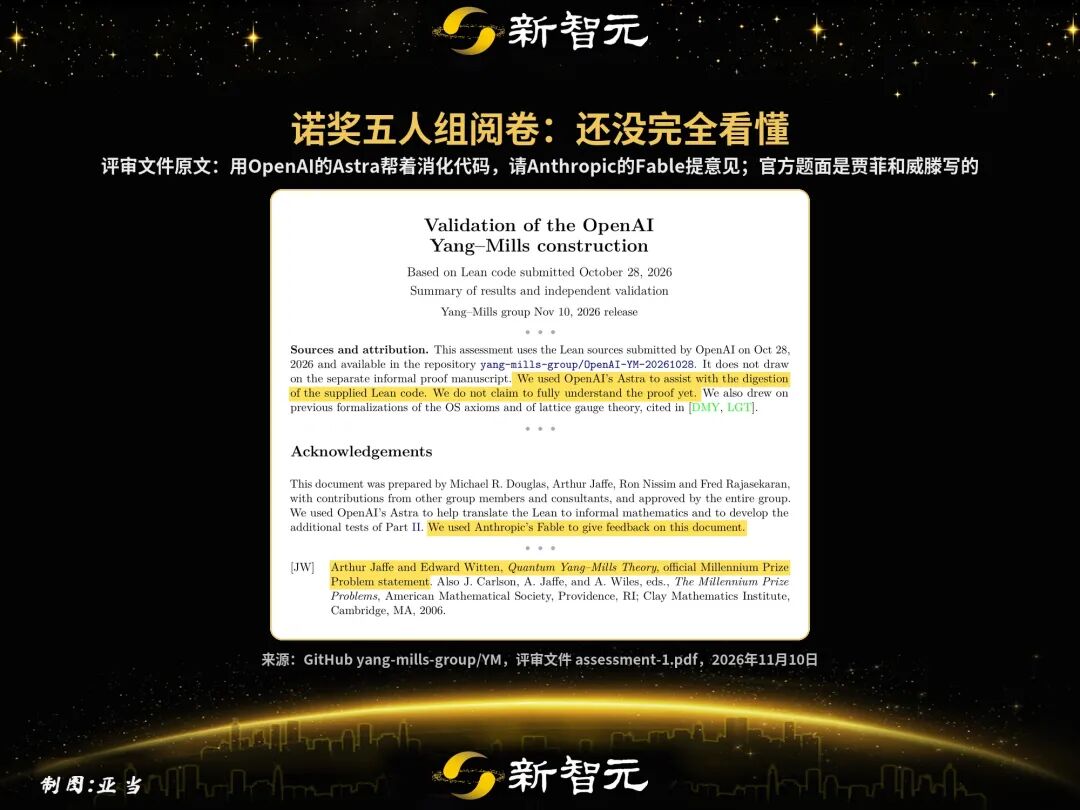
Fünf Spitzenphysiker und Mathematiker sitzen zusammen, um die Arbeit zu prüfen, sie brauchen das Modell von OpenAI zum Lesen des Codes und lassen das Modell von Anthropic Vorschläge zur Überarbeitung des Dokuments machen.
Scott Armstrong, Mathematiker an der New York University, spricht sich dagegen aus, die Beweise erst nach der Prüfung zu veröffentlichen: Wenn man diese Prüfung in die Öffentlichkeit verlegt, geht sie sogar schneller vonstatten.
Sobald das Bewertungsdokument veröffentlicht wurde, fragte ihn jemand auf X, ob dieser Beweis belegen kann, dass die konstruierte Theorie nicht „frei“ ist – „frei“ bedeutet, dass die Teilchen einander nicht beeinflussen und nichts passiert. Er antwortete: Das ist nicht bewiesen.
Am 13. November veröffentlichte er einen Beitrag zur Korrektur, dass diese Antwort irreführend sei. Der Lean-Code von OpenAI hat tatsächlich bewiesen, dass es sich nicht um eine freie Yang-Mills-Theorie handelt: Es gibt eine Größe, die in der freien Theorie immer Null ist, hier aber nicht Null ist, und der berechnete Verlauf stimmt genau mit der Vorhersage der asymptotischen Freiheit überein. Und die asymptotische Freiheit ist genau die Entdeckung, für die Gross 2004 den Nobelpreis erhielt.