Der strengste Nassexperiment-Vorhersage-Benchmark der Geschichte wurde veröffentlicht: Selbst wenn die Inferenz voll ausgeschöpft und die Rechenleistung um das Fünffache gesteigert wird, hilft das überhaupt nichts.
Warte, Benchmarks haben sich inzwischen so weit entwickelt???
Diesmal wird nicht nur auf vorhandene Datensätze trainiert, sondern der KI direkt eine Reihe von Versuchsbedingungen übergeben, damit sie selbst forscht und die Ergebnisse echter Nassversuche im Voraus vorhersagt……
Zum Beispiel: Welche von mehreren Bedingungen für dieselbe Reaktion liefert mehr Zielprodukt? Welche von einer Gruppe von Antikörpervarianten weist eine höhere Expressionsrate auf?
Die Antworten werden zunächst verborgen gehalten, und nachdem die KI ihre Lösung eingereicht hat, werden sie mit den gemessenen Ergebnissen verglichen.
Man muss zugeben, dass sich diese Angelegenheit heute wirklich lohnt, getestet zu werden.
In den letzten zwei Jahren hat sich der Ansatz von AI for Science immer weiter vertieft. KI kann bereits selbstständig Literatur recherchieren, Software verwenden und stundenlang ununterbrochen an einer Analyseaufgabe arbeiten.
Natürlich gehen die Menschen nun zur nächsten Phase über: Welche Forschungskompetenzen wünschen wir uns eigentlich von KI?
Die Vorhersage von Nassversuchsergebnissen ist eine davon mit hohem praktischem Wert.
Dafür muss die KI das Versuchsziel verstehen und relevante Mechanismen aus vorhandenem Wissen extrahieren, um Forscher besser dabei zu unterstützen, Forschungsrichtungen auszuwählen, die eine weitere Erkundung wert sind.
Der neue Benchmark Science Prediction Universe (kurz SPU), der unter der Leitung von UniPat AI eingeführt wurde, hat diesen Punkt scharfsinnig erkannt.
116 Aufgaben, 4207 Nassversuche, die Chemie, Materialwissenschaften, Biologie und Medizin abdecken. Die Benchmark-Berater und Kooperationspartner für Nassversuche stammen ebenfalls von Universitäten wie Stanford, Cornell und Harvard sowie von führenden wissenschaftlichen Forschungseinrichtungen und Biotechnologieunternehmen der Branche.
Das Modell arbeitet bei jedem Durchlauf 8 Stunden lang mit einer H20-Grafikkarte und entscheidet selbstständig, wie es Such- und Rechenressourcen nutzt, um Versuchsvorhersagen zu erstellen.
Das Ergebnis überraschte alle.
Selbst leistungsstarke Modelle wie Opus 5.5 und GPT-6 Astra sind noch weit davon entfernt, eine echte Vorhersage zu treffen…
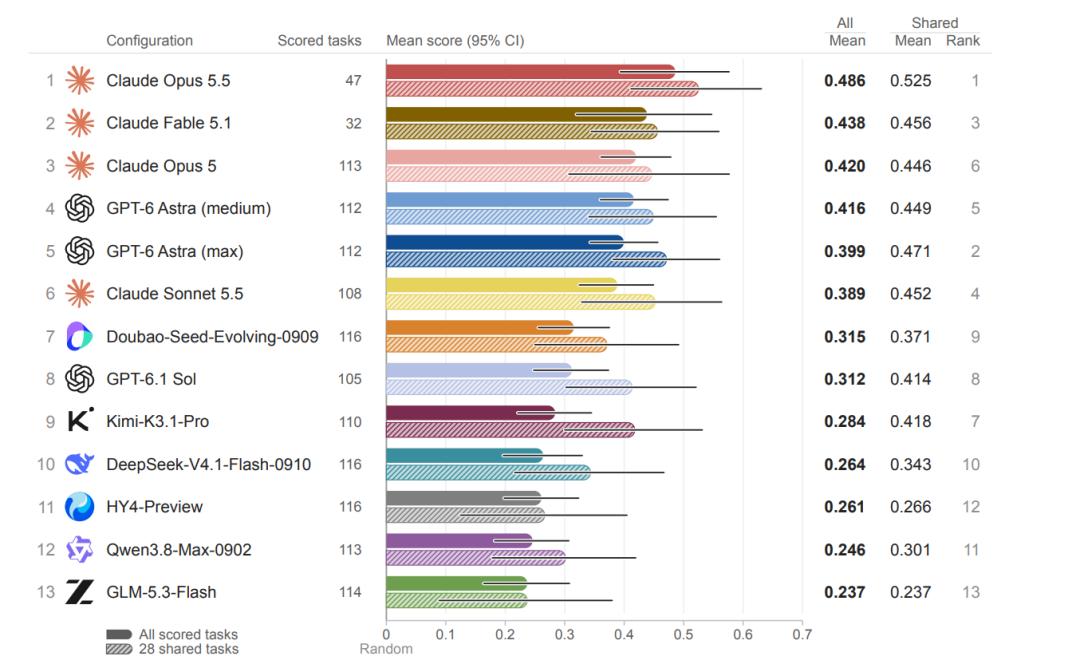
△ Durchschnittliche Punktzahl aller Konfigurationen bei allen bewerteten Aufgaben
Man muss sagen, dass SPU allen wissenschaftlichen Modellen eine echte Herausforderung auferlegt hat.
Früher unsichtbare und ungreifbare Forschungskompetenzen werden nun zu Werten, die einheitlich bewertet und kontinuierlich erforscht werden können.
Für die schrittweise Entwicklung des wissenschaftlichen Urteilsvermögens von KI gibt es nun eine konkretere Diskussionsgrundlage.
Vorhersage von Nassversuchen: Eine eigene Prüfung für Modelle wert
Zurück zur Vorhersage von Nassversuchen: Zunächst ist dies wirklich keine neue Aufgabe.
In der Wissenschaftsgeschichte gab es viele solche Momente, in denen ein Urteil vor dem Experiment abgegeben und dann vom Prozess entschieden wurde – wenn es stimmte, blieb es bestehen, wenn es falsch war, wurde es verworfen.
Die spezifische Urteilslogik bildet den Geschmack des Wissenschaftlers.
Mit gutem Geschmack und genauer Intuition können Wissenschaftler schneller große Ergebnisse erzielen und gleichzeitig wertvolle Versuchsressourcen sparen.
Schon ein einziger Nassversuch kostet viel: In der Chemie muss man Reagenzien zubereiten, Reaktionsbedingungen festlegen und dann das Produkt trennen; in der Biologie muss man einen langwierigen Proteinexpressionsprozess durchlaufen… Die Zeitkosten und Werkzeugkosten sind an sich schon hoch, und wenn das Ergebnis nicht zufriedenstellend ist, muss man mehrere Runden wiederholen.
Deshalb ist die Vorhersage vor Beginn der praktischen Arbeit der Schritt mit dem höchsten Wert im Forschungsprozess.
Der Unterschied liegt nur darin, dass diese Aufgabe früher vollständig von Wissenschaftlern erledigt wurde. Im KI-Zeitalter brauchen Modelle diese Fähigkeit ebenfalls – und es braucht eine Prüfungsarbeit, um sie zu bewerten.
Vorhandene Benchmarks können dies nicht vollständig abdecken: Zum Beispiel lässt BrainBench Modelle Versuchsergebnisse direkt beurteilen, ScienceAgentBench konzentriert sich auf die Analyse auf vorhandenen Daten, und Langzeit-Benchmarks wie Terminal-Bench 4.0 und Long-Horizon-TB verwenden hauptsächlich vordefinierte Tests, um Aufgabenresultate zu prüfen.
SPU unterscheidet sich von allen diesen.
Es legt mehr Wert darauf, den selbstständigen Forschungsprozess der KI und die Vorhersage von Nassversuchsergebnissen gemeinsam zu prüfen – es geht sowohl um die Vorhersageleistung als auch um die Fähigkeit, wissenschaftliche Werkzeuge zu verwenden und Langzeitaufgaben auszuführen.
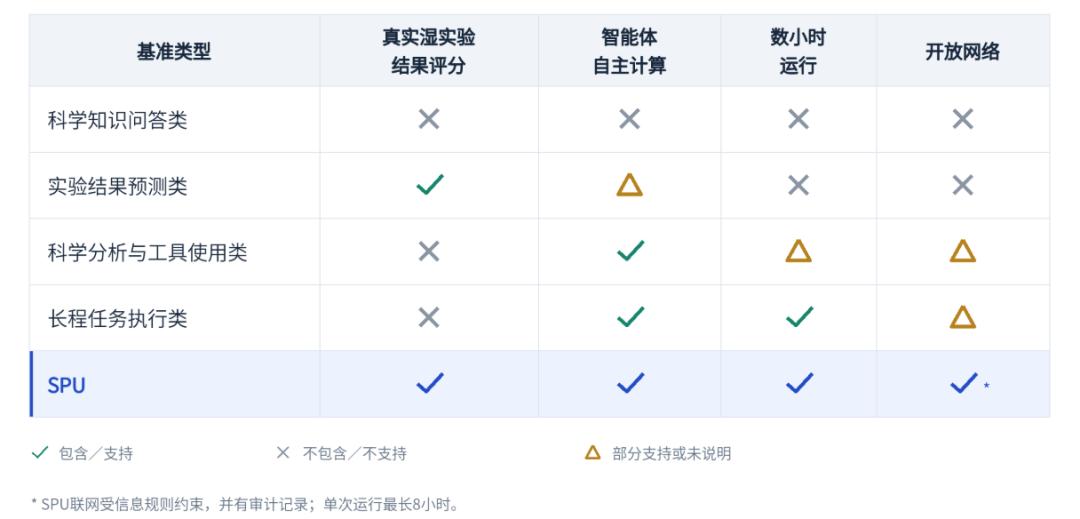
△ Diagramm erstellt von KI
Diese Art von Urteil wurde von SPU in klare Aufgaben organisiert.
100 öffentliche Aufgaben stammen aus 85 kürzlich veröffentlichten Arbeiten. Fachexperten haben Kandidaten, Materialien, Bedingungen und Messverfahren aus den Studien extrahiert und vollständige quantitative Ergebnisse als Bewertungsgrundlage beibehalten.
Weitere 16 private Aufgaben stammen aus vier Gruppen unveröffentlichter kooperativer Nassversuche, die VHH-Nanokörper, Reaktionsbedingungen, Elektrolyte und Magrolimab-Varianten betreffen.
Insgesamt gibt es 32 Teilbereiche und 4207 Experimente. Die öffentlichen Studien liefern interdisziplinäre Aufgabenquellen, die gemessenen Ergebnisse sind für das Modell verborgen, und die unveröffentlichten Experimente fügen eine Prüfung hinzu, die unabhängig von den Antworten in öffentlichen Arbeiten ist.
Dies kann bis zu einem gewissen Grad verhindern, dass das Modell die Aufgaben bereits im Vorfeld gesehen hat.
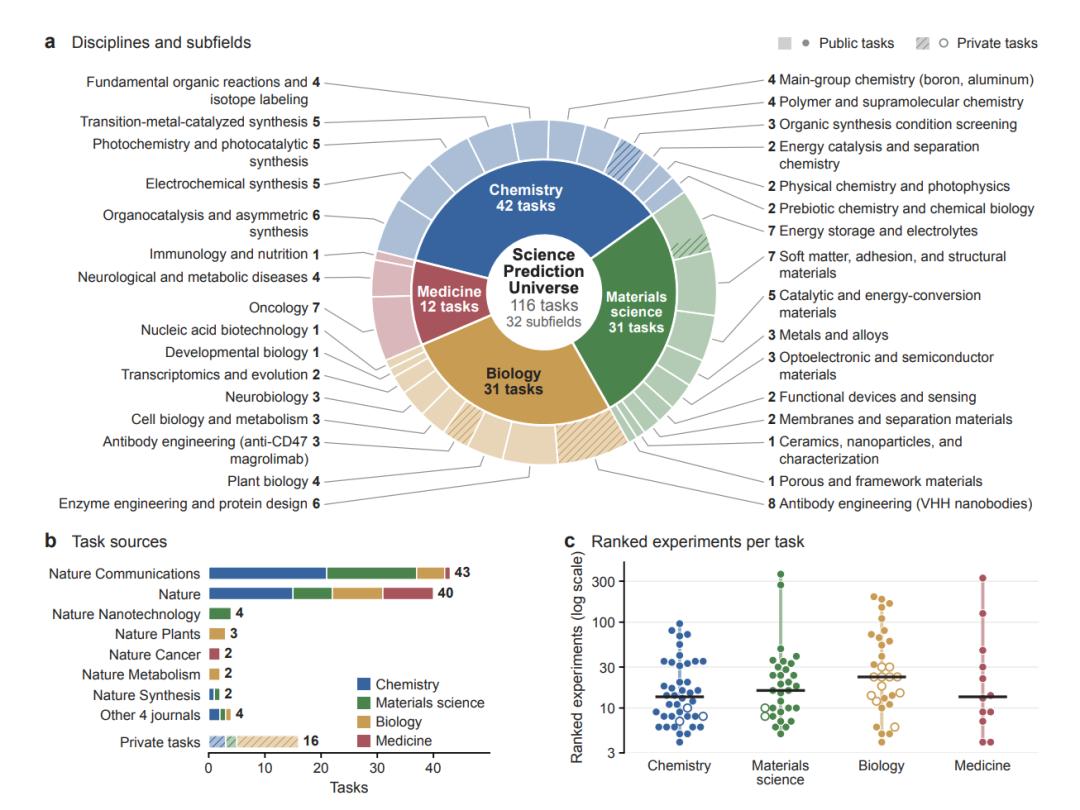
△ Aufgabenabdeckung und Quellen von SPU
Der Auswahlprozess der Aufgaben ist ebenfalls sehr durchdacht.
Experten bevorzugen Studien mit vollständigen Messungen und klaren Bedingungen. Einfache Fragen, die sich nur nach einem einzigen Trend sortieren lassen, werden direkt ausgeschlossen, und Fragen mit zu nahen Werten werden als wenig aussagekräftig eingestuft.
Die verbleibenden Aufgaben sind schwieriger und besser geeignet, um Unterschiede zwischen Modellen zu erkennen.
Während des spezifischen Vorhersageprozesses muss das Modell acht Stunden pro Durchlauf laufen, mit 8-Kern-CPU, 16 GiB Arbeitsspeicher und einer H20-Grafikkarte. Gleichzeitig ist es erlaubt, im Internet zu suchen und wissenschaftliche Software zu installieren.
Das Modell sammelt in dieser Zeit selbstständig Beweise, wählt Berechnungsmethoden aus und reicht schließlich die Vorhersagesortierung der Vergleichsgruppen von niedrig bis hoch ein.
Um Gedächtniskontamination zu vermeiden, läuft der gesamte Bewertungsprozess in einem unabhängigen, vom Netzwerk getrennten Container. Die KI darf nicht auf die ursprünglichen Studienergebnisse zugreifen, und die Ausgaben der Werkzeuge werden automatisch gescannt, um Kennungen wie DOI und Titel der Originalarbeit zu erkennen.
Schließlich vergleicht das System mit dem Spearman-Korrelationskoeffizienten die Vorhersage mit der gemessenen Sortierung.
Je näher der Koeffizient an 1 liegt, desto ähnlicher ist die Sortierung den Versuchsergebnissen.
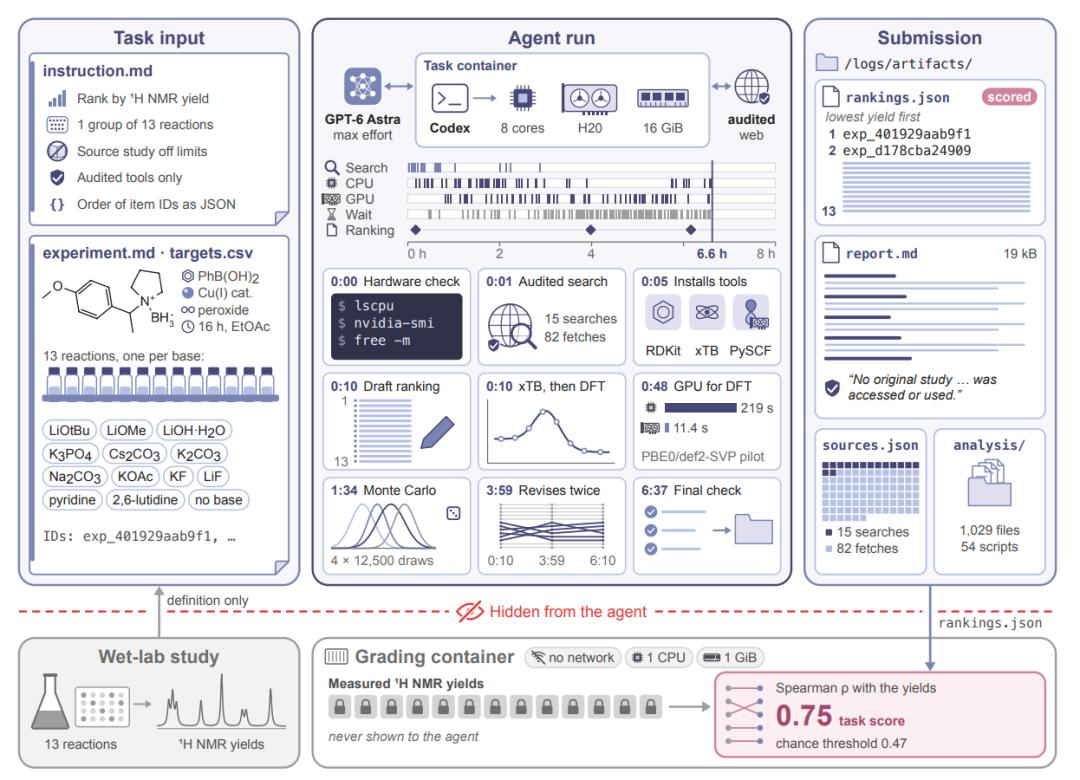
△ Bewertungsverfahren von SPU
Interessanterweise berücksichtigt SPU auch viele Details, die andere Benchmarks nicht beachten.
Zum Beispiel prüft SPU bei der endgültigen Punktzahl, ob das Ergebnis nur Glück sein könnte – was wäre, wenn es zufällig richtig geraten wurde?
Deshalb generiert es zusätzlich 4000 zufällige Sortierungen für jede Aufgabe, nimmt das 95. Perzentil als Schwellenwert für das Zufallsniveau und prüft, ob die Einreichung des Modells deutlich über dieser Referenz liegt. Für verschiedene Aufgaben gibt es entsprechende Referenzgrundlagen.
Das gesamte Design von SPU kann als wissenschaftlich streng bezeichnet werden.
Das Modell muss Schritt für Schritt selbst beurteilen, was es wert ist, berechnet zu werden, und die Lösung für die endgültige Vorhersage einreichen.
Dieses Design hilft nicht nur, die aktuelle Fähigkeit von KI zur Vorhersage von Nassversuchen zu messen, sondern weist auch nachfolgenden Forschungsteams den Weg, um Experimente mit einheitlichen Indikatoren kontinuierlich zu verbessern.
Wie dem auch sei, werfen wir gemeinsam einen Blick auf die Zeugnisse der ersten Spitzenmodelle. Die Details sind es wert, separat vorgestellt zu werden.
Neuer Test bringt Spitzenmodelle an ihre Grenzen
Die erste systematische Bewertung von SPU deckt 12 Spitzenmodelle und 13 Konfigurationen ab. Hier bezieht sich Konfiguration auf das Modell, die Inferenzstärke und das verwendete Modellframework.
Zuerst zu den Gesamtergebnissen.
Kurz gesagt: Keines ist besonders gut.
Bei allen bewerteten Aufgaben erreichte Claude Opus 5.5 die höchste Durchschnittspunktzahl mit 0,486. Aber nur die Hälfte der Aufgaben überschritt das Zufallsniveau.
Bei fast allen 13 Konfigurationen lag der Anteil der Aufgaben, die den Schwellenwert des Zufallsniveaus überschreiten, nur bei 34 % bis 52 %.
Das bedeutet, dass alle vorhandenen Modelle noch einen weiten Weg vor sich haben, bis sie zuverlässige Vorhersagen für Nassversuche treffen können.
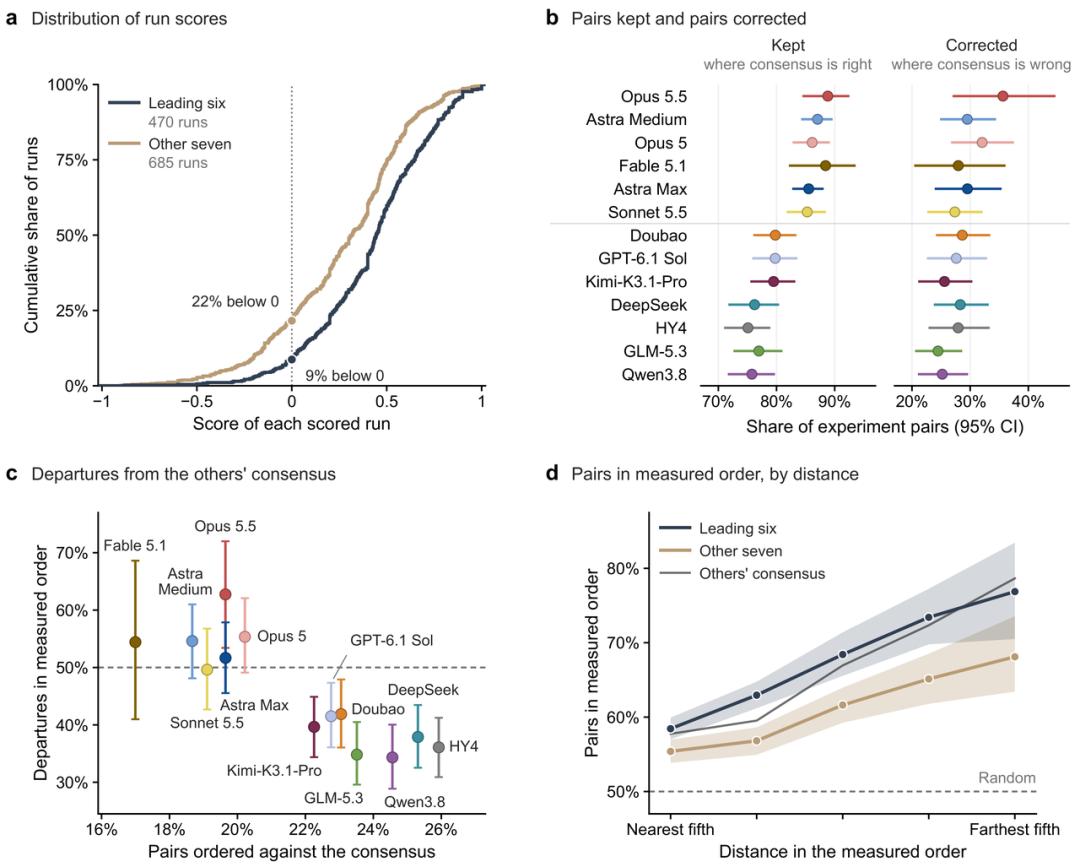
△ Verhaltensvergleichsanalyse zwischen der führenden Gruppe und der zurückliegenden Gruppe
Es gibt jedoch Unterschiede zwischen den Modellen, deren durchschnittliche Leistung in zwei Ebenen unterteilt werden kann: die führende Gruppe (6 Modelle) und die zurückliegende Gruppe (7 Modelle).
Bei Aufgabenvergleichen liegt die durchschnittliche Punktzahl der führenden Gruppe um etwa 0,15 Punkte über der der anderen sieben Modelle.
Ein weiteres Detail ist bemerkenswert: Bei etwa 9 % der Aufgaben der führenden Gruppe liegt die Punktzahl unter 0, während dieser Anteil bei den anderen sieben Konfigurationen bis zu 22 % beträgt.
Hier steht 0 für die durchschnittliche Punktzahl einer gültigen zufälligen Sortierung. Eine negative Punktzahl bedeutet, dass die Vorhersage negativ mit der tatsächlichen Sortierung korreliert.
Woher stammen diese Unterschiede genau? Das Forschungsteam hat weiter nachgeforscht.
Zuerst kombinierten sie die Vorhersagen anderer Modelle bei derselben Aufgabe zu einer Referenzsortierung, paarten dann die Experimente paarweise und prüften anhand der gemessenen Ergebnisse, ob jedes Modell die Sortierung richtig vorgenommen hatte.
Bei Experimentpaaren mit korrekter Referenzsortierung erreichte die führende Gruppe eine korrekte Sortierung von 86 %, die anderen sieben Konfigurationen von 78 %; bei Experimentpaaren mit falscher Referenzsortierung lag der Anteil der unabhängig korrekten Sortierung bei beiden Gruppen bei etwa 30 %.
Ein Teil des Vorteils der führenden Gruppe liegt also genau dort, wo die gemeinsame Vorhersage korrekt ist – hier ist die führende Gruppe immer stabiler.
Warum das Modell von der korrekten Beurteilung abweicht, zeigen die Laufprotok