Wer wird die Embodied Intelligence angesichts der 30-fachen Datenlücke am Leben erhalten?
Die Datenlücke der Embodied Intelligence und die verschiedenen Geschäftsmodelle, die sie schließen.
Im Jahr 2026 hat die Begeisterung der Kapitalgeber für Embodied Intelligence eine neue Stufe erreicht.
Laut den im Oktober aktualisierten Daten von Dealroom haben globale Startups im Bereich Embodied Intelligence in diesem Jahr bereits 11 Milliarden US-Dollar an Risikokapital erhalten, was mehr als dem Doppelten des gesamten Jahres 2025 entspricht.
Im August war der Weltroboterkongress in Yizhuang, Peking, ebenfalls sehr belebt. 373 Unternehmen stellten aus, die Veranstaltung zog innerhalb von fünf Tagen 557.000 Besucher an – die Zahl der Teilnehmer hat sich im Vergleich zum Vorjahr verdoppelt.
Aber so lebhaft es auch ist: Wie weit sind Roboter noch von ihrem echten Einsatz im Arbeitsalltag entfernt?
Laut Statistiken von IDC wurden im Jahr 2025 weltweit mehr als 18.000 humanoide Roboter ausgeliefert, von denen über 85 % für kulturelle und unterhaltsame Aufführungen, Bildung, Forschung, Datenerfassung sowie Führungs- und Beratungsdienste im Einzelhandel eingesetzt wurden. Nur wenige davon sind tatsächlich in Szenarien wie Fabriken und Logistik im Einsatz und übernehmen Produktionsaufgaben.
Sowohl das Kapital als auch die Aufmerksamkeit steigen, aber der tatsächliche Produktionswert, den Roboter erzeugen, ist bei weitem nicht mitgewachsen.
In den letzten zwei Jahren drehte sich die Geschichte der Embodied Intelligence hauptsächlich um die Roboter selbst: Wer hat den flexibleren Roboter, wer hat mehr Freiheitsgrade bei der geschickten Hand, wer kann komplexere Aktionsdemonstrationen durchführen. In diesem Jahr hingegen beginnt eine neue Variable die Wettbewerbsrichtung der Branche zu beeinflussen: Daten.
Mit der fortlaufenden Iteration von Modellen von Unternehmen wie Generalist und Physical Intelligence erkennt die Branche einen Entwicklungspfad, der dem von großen Sprachmodellen ähnelt: Die Erweiterung des Umfangs von Trainingsdaten und Rechenleistung verspricht eine stärkere Generalisierungsfähigkeit und senkt die Kosten für das Erlernen neuer Aufgaben.
Wenn diese Scaling-Kurve weiterhin gültig bleibt, wird der Wettbewerb im Bereich Embodied Intelligence nicht nur auf der Hardware basieren, sondern sich weiter auf Daten verlagern: Wie viele Erfahrungen aus der realen Welt werden benötigt? Woher stammen diese Daten? Welche Daten sind am wertvollsten? Und wer kann damit Geld verdienen?
Aber die Probleme, mit denen Roboter konfrontiert sind, könnten komplexer sein als die von großen Sprachmodellen. Das Internet hat riesige Mengen an Text und Video hinterlassen, aber es gibt kaum Aufzeichnungen über die Kraft, den Kontakt, Misserfolge und Korrekturprozesse von Menschen bei der Ausführung von Aktionen. Eine größere Datenmenge bedeutet nicht unbedingt, dass Roboter Aufgaben besser erledigen können.
Was wirklich beachtet werden sollte, ist nicht nur, wie viele Stunden an Daten Roboter noch fehlen, sondern ob diese Daten in Arbeitsfähigkeiten in der realen Welt umgewandelt werden können. Dies ist auch das technische Problem und die Geschäftsmöglichkeit, die in dieser aktuellen Welle von Embodied-Daten am meisten zu analysieren sind.
Von 270.000 auf 500.000 Stunden: Die Scaling-Kurve von Embodied-Modellen
Im November 2025 veröffentlichte Generalist AI GEN-0, das mit mehr als 270.000 Stunden an echten physischen Interaktionsdaten vortrainiert wurde. Im Vergleich dazu hatte das damals repräsentativste Open-Source-Datensatz Open X-Embodiment nur 6.000 Stunden – die Datenmenge von GEN-0 ist fast fünfzig Mal höher.
Generalist beobachtete in Experimenten, dass mit der Erweiterung der Menge an Vortrainingsdaten und des Rechenumfangs die Leistung des Modells bei mehreren nachgelagerten Aufgaben kontinuierlich verbessert wurde. Dies liefert ein wichtiges Signal: Das Scaling Law, das großen Sprachmodellen eigen ist, könnte auch beim physischen Interaktionslernen von Robotern gelten.
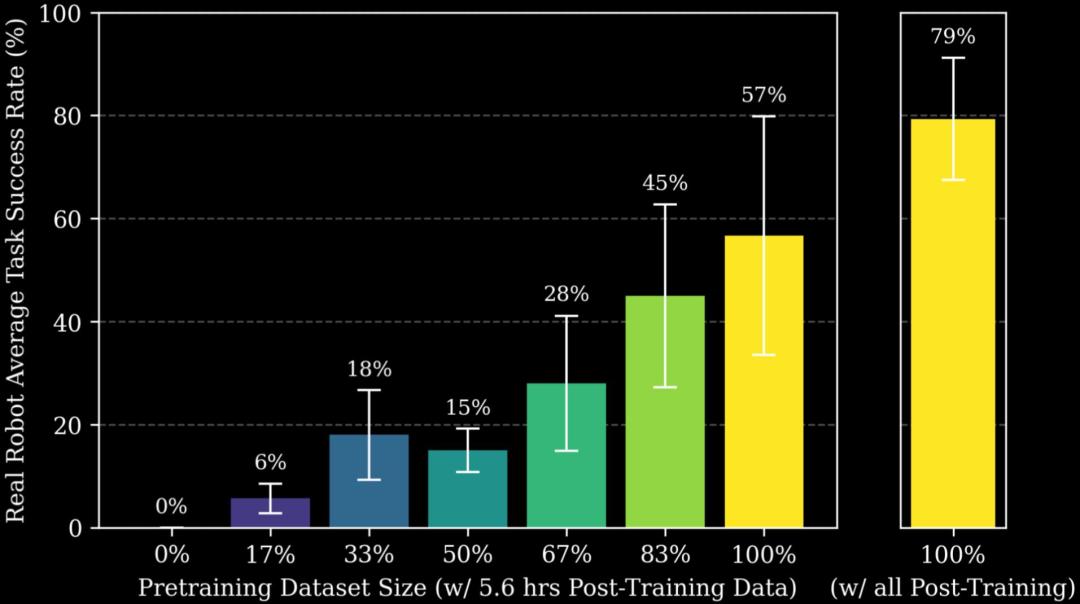
Experimente mit Generalist GEN-0 zeigen, dass die Erhöhung der Vortrainingsdaten die Erfolgsrate von Aufgaben auf echten Geräten verbessern kann. Quelle: Generalist AI
Fünf Monate später hat GEN-1 den Datenumfang auf 500.000 Stunden angehoben, die Aufgabenerfolgsrate stieg von 64 % auf 99 % und die Geschwindigkeit verdreifachte sich. Noch wichtiger ist, dass GEN-1 erste Fähigkeiten zur szenarienübergreifenden Generalisierung und selbstständigen Fehlerkorrektur zeigte.
Im August 2026 stellte Generalist GEN-1.5 vor, das diese Generalisierungsfähigkeit weiter vorantrieb. Nach mehr als acht Monaten fortlaufenden Vortrainings zeigte das Modell Fähigkeiten, die dem In-Context-Learning großer Sprachmodelle ähneln: Es reicht, eine Aktionsdemonstration von 3 bis 12 Sekunden bereitzustellen, um neue Aufgaben auszuführen, ohne die Modellparameter zu aktualisieren. Generalist nennt dies Physical Prompting (physisches Prompt-Lernen).
Die drei Generationen von Modellen von Generalist haben einen beachtenswerten Pfad vorläufig validiert: Größere Mengen an Vortrainingsdaten versprechen stärkere Modellfähigkeiten und niedrigere Kosten für das Erlernen neuer Aufgaben. Dadurch sind Embodied-Daten von einem technischen Problem zu einem neuen Wettbewerbsfeld für Kapitalgeber geworden.
Die nächste Frage lautet: Wie groß muss der Datenumfang für Embodied Intelligence eigentlich sein, und woher sollen diese Daten stammen?
500.000 Stunden: Befindet sich Embodied Intelligence noch im GPT-2-Stadium?
Was bedeutet der Wert von 500.000 Stunden eigentlich? Als Referenz kann die Informationsmenge dienen, die ein Mensch im Laufe seines Lebens aufnimmt.
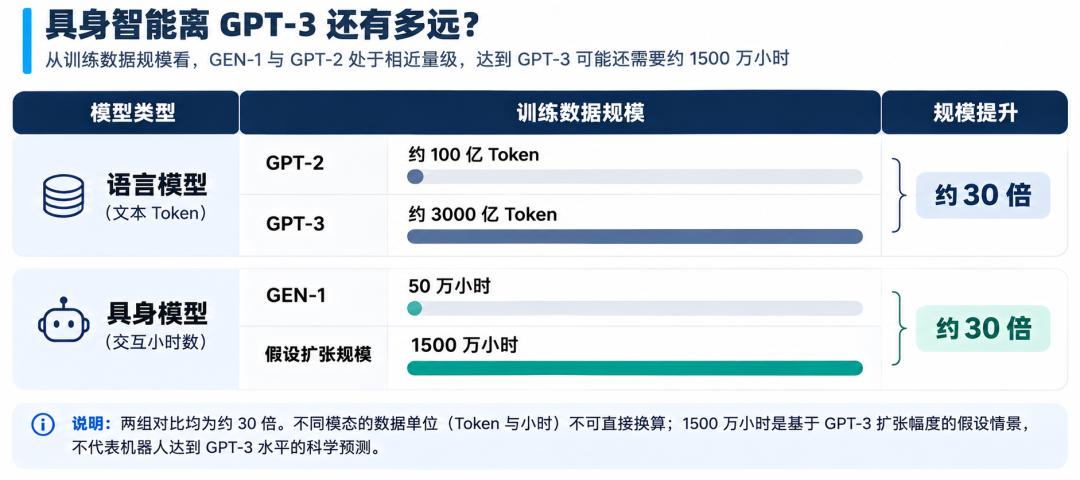
Angenommen, eine Person liest 200 bis 300 englische Wörter pro Minute, 12 Stunden pro Tag, dann liest sie in 80 Jahren insgesamt etwa 6,7 bis 10,1 Milliarden Token. Die Trainingsdaten von GPT-2 betragen etwa 10 Milliarden Token, was der gleichen Größenordnung wie die Lesemenge eines Menschen im Laufe seines Lebens entspricht.
Das Gleiche gilt für Embodied Intelligence. Angenommen, eine Person beobachtet und lernt die reale Welt 12 Stunden pro Tag, dann sind das in 80 Jahren etwa 350.000 Stunden. Die 500.000 Stunden Trainingsdaten von GEN-1 entsprechen dem 1,43-fachen der Beobachtungszeit eines Menschen im Laufe seines Lebens.
Wenn man die Informationsmenge eines menschlichen Lebens als Maßstab nimmt, liegen die Trainingsdaten von GEN-1 und GPT-2 in einer ähnlichen Größenordnung. Dies ist nur ein Analogieschluss bezüglich des Datenumfangs und bedeutet nicht, dass die Fähigkeiten der beiden Modelle vergleichbar sind.
Erstellt von Silicon Rabbit
Aber die Entwicklung großer Sprachmodelle ging weit über GPT-2 hinaus. Die Trainingsdaten von GPT-3 erreichten 300 Milliarden Token, was etwa dem 30-fachen von GPT-2 entspricht. Wenn Embodied-Modelle eine ähnliche Datenexpansion benötigen, dann ausgehend von den 500.000 Stunden von GEN-1, könnte die nächste Stufe 15 Millionen Stunden erfordern.
Außerdem ist die Datenmenge nicht der einzige Engpass. Roboter müssen nicht nur lernen, was sie sehen, sondern auch wie sie bedienen, wie viel Kraft sie einsetzen und welche Ergebnisse die Aktionen hervorrufen.
Nehmen wir als Beispiel das Aufschrauben eines Flaschenverschlusses: In einem Bedienungsvideo verbringt man die meiste Zeit mit Bewegen, Ausrichten und Anpassen der Haltung. Was über Erfolg oder Misserfolg entscheidet, ist möglicherweise die Kraftaufwendung im Moment des Kontakts, die Anpassung bei einem Ausrutschen und der erneute Versuch nach einem Misserfolg. Diese wichtigen Interaktionen machen nur einen kleinen Teil der gesamten Bewegungstrajektorie aus, enthalten aber wichtige Lernsignale.
Daher stehen Embodied-Daten vor zwei Engpässen: Erstens, wie man den Datenumfang kostengünstig erweitern kann, und zweitens, wie man die Dichte der nutzbaren Informationen in den Daten erhöhen kann.
Woher stammen die Daten: Drei Pfade und ein Umwandlungsproblem
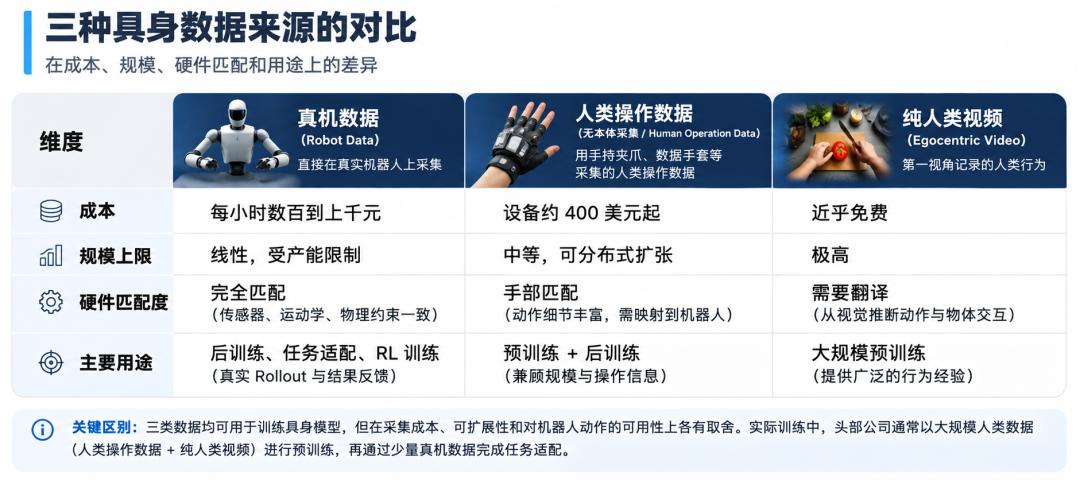
Angesichts des doppelten Engpasses bei Datenumfang und Datenqualität hat die Branche hauptsächlich drei Pfade für die Erfassung echter Daten erforscht. Der Kernunterschied besteht darin: Je direkter die Daten vom Roboter selbst stammen, desto besser passen sie zur Zielhardware, aber desto höher sind auch die Erfassungskosten. Je näher die Daten dem täglichen Verhalten von Menschen kommen, desto leichter lassen sie sich skalieren, aber desto schwieriger ist es, sie in Roboteraktionen umzuwandeln.
Erstellt von Silicon Rabbit
Erster Pfad: Echte Roboter-Daten (Robot Data)
Durch Teleoperation werden Roboter Aufgaben ausführen lassen, während gleichzeitig visuelle Informationen, Gelenkzustände und Bewegungstrajektorien aufgezeichnet werden. Die Daten passen direkt zur Zielhardware und eignen sich für das Training von Aufgaben und feine Bedienvorgänge.
Hersteller von Roboterplattformen wie Tesla, Figure AI und Agibot haben alle die Methode der Erfassung mit echten Geräten angewendet. Aber die Erfassung mit echten Geräten hängt von Robotern, Bedienpersonal und Standorten ab, ist teuer, expandiert langsam und kann den Datenbedarf im Bereich von mehreren zehn Millionen Stunden kaum decken.
Zweiter Pfad: Menschliche Bedienungsdaten (Erfassung ohne Roboterplattform)
Ohne Roboter werden Menschen mit Geräten wie Greifwerkzeugen in der Hand oder Datenhandschuhen Bedienvorgänge ausführen lassen, während gleichzeitig die Ego-Perspektive-Bilder und die Bewegungen von Händen oder Werkzeugen aufgezeichnet werden. Im Jahr 2024 schlugen die Stanford-Universität und andere das UMI-Verfahren vor, bei dem menschliche Bedienungsdaten über einen handgehaltenen Greifer mit Kamera erfasst werden, ohne dass ein echter Roboter an der Erfassung teilnimmt – das senkt die Kosten für die Datenbeschaffung.
Sunday Robotics hat diesen Pfad zur Skalierung gebracht. Das Unternehmen rekrutiert zahlreiche „Memory Developers“, die mit selbst entwickelten Erfassungshandschuhen Haushaltsarbeiten in echten Haushalten erledigen. Nach Angaben des Gründers wurden bereits fast 10 Millionen Aufgaben-Trajektorien gesammelt und das Basismodell ACT-1 für den Haushaltsroboter Memo trainiert. Die 500.000 Stunden an Vortrainingsdaten von Generalist werden hauptsächlich auch durch tragbare Geräte erfasst, die menschliche Bedienvorgänge aufzeichnen.
Dritter Pfad: Reines menschliches Video (Ego Video)
Man lernt direkt menschliches Verhalten aus Ego-Perspektive-Videos, ohne dass genaue Bedienungstrajektorien synchron erfasst werden müssen – das hat das größte Skalierungspotenzial. NVIDIA nutzt für EgoScale mehr als 20.000 Stunden an menschlichen Ego-Perspektive-Videos; im August 2026 veröffentlichte Dyna Robotics Dyna-2, das den Vortrainingsumfang weiter auf mehr als 1 Million Stunden erweiterte.
Die Schwierigkeit bei Videos liegt darin, dass es keine Aktionssignale gibt, die Roboter direkt ausführen können. Das Modell muss menschliche Aktionen aus den Bildern ableiten, die Zustandsänderungen von Objekten verstehen und dann in Steuerbefehle umwandeln, die Roboter ausführen können. Untersuchungen zu Dyna-2 zeigen, dass groß angelegtes Video-Vortraining die Fähigkeit zur Migration zwischen verschiedenen Roboterplattformen verbessern kann, aber dieser Prozess erfordert noch Datenverarbeitung und eine geringfügige Anpassung an echte Roboter.
Die drei Pfade haben jeweils Vor- und Nachteile: Echte Roboter-Daten lösen das Problem der Aktionsanpassung, menschliche Bedienungsdaten verbinden Umfang und Aktionsüberwachung, und reine menschliche Videos liefern noch größere Mengen an Verhaltenserfahrung.
Die Trainingsmethoden der führenden Unternehmen zeigen auch einen gemeinsamen Trend: Sie nutzen groß angelegte menschliche Daten für das Vortraining und schließen dann die Aufgabenanpassung mit einer kleinen Menge an echten Roboter-Daten ab. Allerdings unterscheiden sich die Datenrezepturen verschiedener Unternehmen stark, es gibt noch kein einheitliches optimales Verhältnis.
Das bedeutet, dass der Wettbewerb um Embodied-Daten nicht nur darin besteht, wer mehr Stunden erfassen kann, sondern auch darin, wer zu niedrigeren Kosten Daten aus verschiedenen Quellen in Aktionen und Erfahrungen umwandeln kann, die Roboter wirklich lernen können.
Neue Datenlücke: Von Aktionen zu physischem Kontakt
Die ersten drei Methoden zur Datenerfassung lösen die Probleme des Umfangs und des Aktionslernens, aber es gibt immer noch eine Art von Information, die schwer über visuelle Mittel zu erfassen ist: Kraft und taktiles Feedback während des Kontaktvorgangs. Und bei feinen Bedienvorgängen treten viele Misserfolge gerade bei Kontakt und Kraftsteuerung auf.
Das Internet hat großen Modellen die Sprache beigebracht, aber es hat nicht aufgezeichnet, wie viel Kraft jemand beim Aufschrauben eines Flaschenverschlusses einsetzt, wie Stoffe beim Falten von Handtüchern gleiten und in welchem Winkel ein umkippender Becher verschüttet. Der Gemeinsamkeit liegt darin: Erfolg oder Misserfolg hängen nicht von dem Bild ab, sondern von dem Kontakt. Das ist auch die härteste Obergrenze des Video-Pfades.
Dies wird bereits durch Experimente bestätigt. Im Jahr 2026 hat Panasonic gemeinsam mit Einrichtungen wie Berkeley und NVIDIA T-Rex vorgestellt, das taktile Informationen von Fingerspitzen in das Aktionsmodell von Robotern einbringt. Bei 12 feinen Bedienaufgaben wie dem Einschrauben einer Glühbirne und dem Umblättern von Papieren erreichte das Modell eine durchschnittliche Erfolgsrate von 65 %; ohne taktile Informationen sank die Erfolgsrate auf 42 %.
Aber Kraft- und taktile Daten sind schwerer zu skalieren und zu erfassen als Videos. Für Videos reichen Kameras aus, während Kontaktinformationen oft zusätzliche Sensoren erfordern, und außerdem Probleme wie Datensynchronisation, Kalibrierung und