Generieren von 4K-Bildern in 10 Sekunden: MiniMax stellt erneut ein Open-Source-SOTA vor
„GPT is cooked.“
In den letzten beiden Tagen taucht dieser Satz in der KI-Community immer wieder auf. Was die Menschen nicht stillhalten lässt, ist das gerade von MiniMax veröffentlichte Bildmodell MiniMax H3 Image.
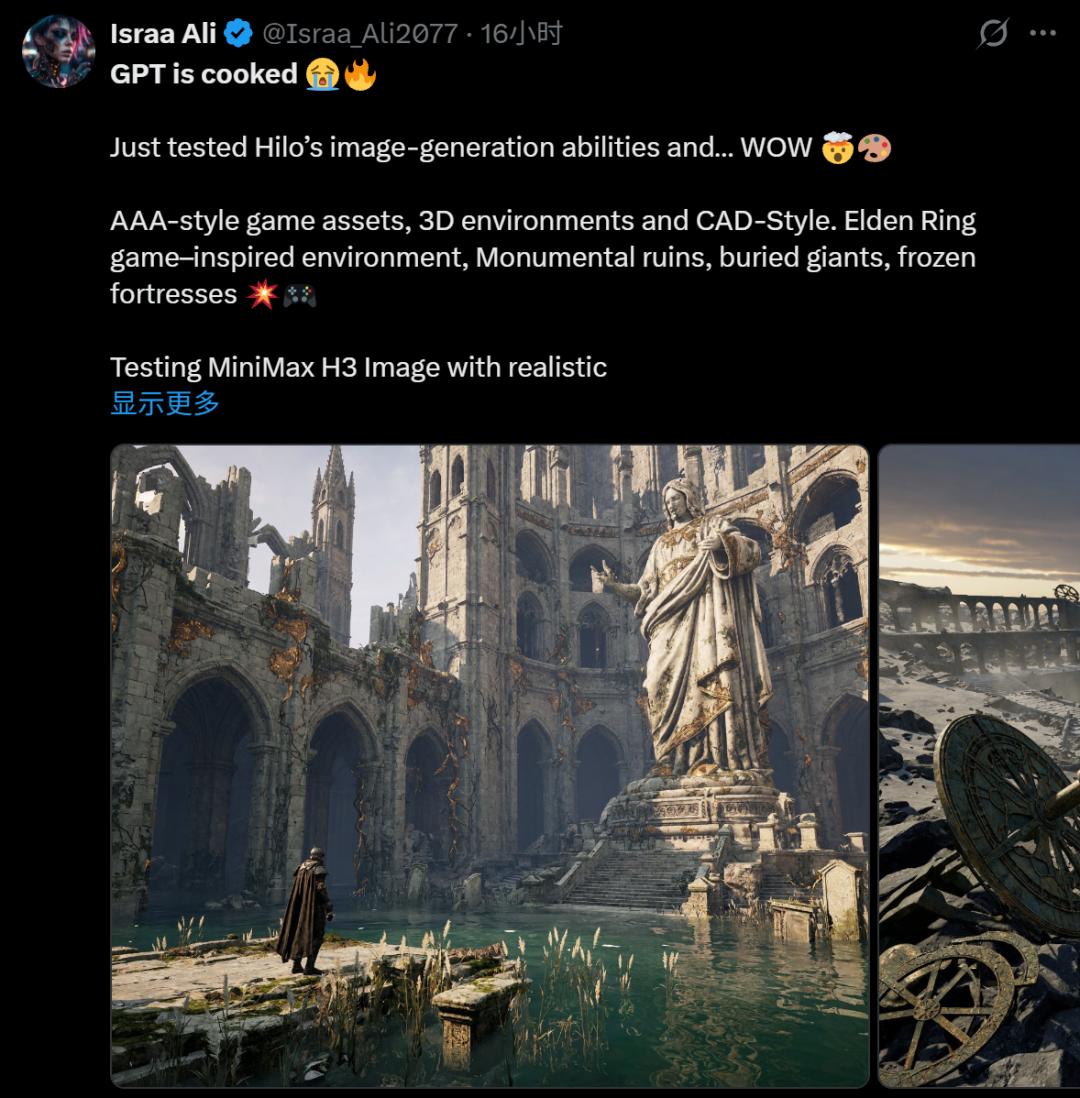
Es handelt sich um ein Modell, das nativ in 4K ausgibt, in Sekundenschnelle generiert und bis zu 16 Referenzbilder unterstützt. Es wurde am Dienstag dieser Woche als Open-Source veröffentlicht und hat den SOTA der Open-Source-Bildmodelle neu definiert. Aus den ersten Reaktionen der Öffentlichkeit geht hervor, dass diese Aussage kaum übertrieben wirkt.
Entwickler, die frühzeitig Zugang zur Betaphase erhalten haben, haben zahlreiche Tests durchgeführt. In den Ausgaben des neuen Modells fehlt die typische „Kunststoffhaut“ von KI-Porträts – Poren, Sommersprossen und Haare sind deutlich sichtbar. Die Nutzer loben seine Fähigkeiten im Bereich Spieldesign, Charaktergestaltung und 3D-Szenenerstellung.
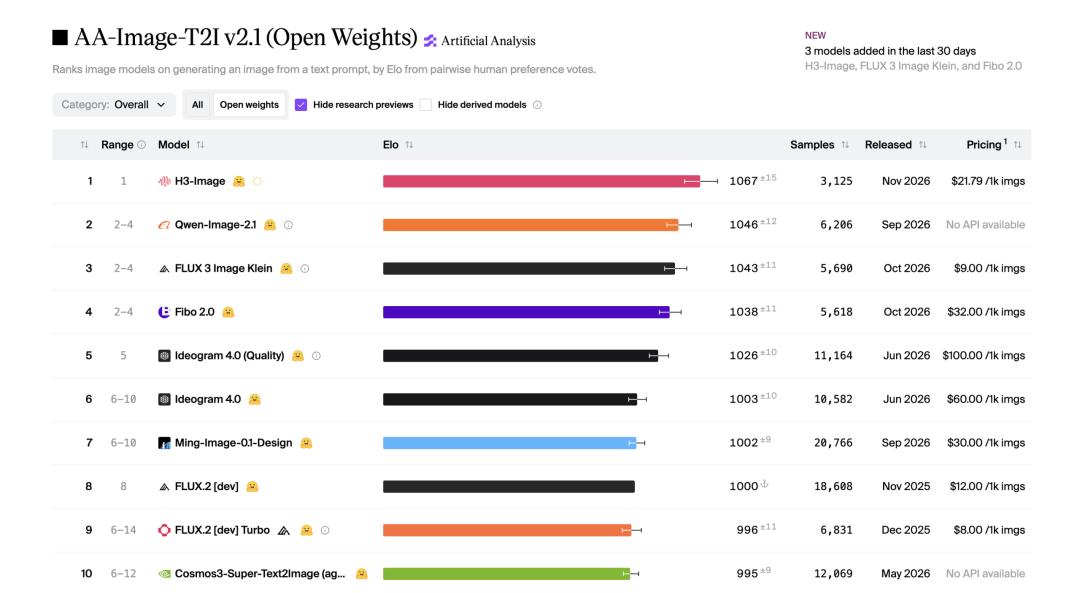
Auf der heute aktualisierten Rangliste von Artificial Analysis belegt MiniMax H3-Image in beiden Kategorien Text-zu-Bild und Bildbearbeitung den ersten Platz unter Modellen mit offenen Gewichten.
MiniMax H3 Image kann direkt im Webbrowser verwendet werden, oder über die API in MiniMax Code oder anderen Harness-Umgebungen, um komplexe Aufgaben zu erledigen. Und da es quelloffen ist, arbeiten einige Nutzer bereits an der lokalen Bereitstellung.
GitHub: https://github.com/MiniMax-AI/MiniMax-H3-Image
HuggingFace: https://huggingface.co/MiniMaxAI/MiniMax-H3-Image
Wir haben sofort Zugang zum neuen Modell erhalten, um Ihnen die praktische Leistungsfähigkeit zu demonstrieren.
Neudefinition von Bildästhetik und „Realismus“
Dieses neue Modell ist bereits in MiniMax Code verfügbar. Es unterstützt bis zu 16 Referenzbilder und die generierten Bilder erreichen eine maximale Auflösung von 4K.
Aus der Perspektive eines normalen Nutzers haben wir die alltäglich verwendeten Szenarien nach vier Fähigkeitsdimensionen nacheinander getestet: Zuerst den Realismus, dann die beiden klassischen Probleme Text und Gesichtserkennung, und zuletzt die Nachbearbeitung von Bild-zu-Bild-Generierung.
Der Realismus ist die erste Hürde. Am leichtesten lassen sich KI-Spuren an Dingen erkennen, die wir täglich sehen, wie zum Beispiel die Chat-Oberfläche von WeChat.
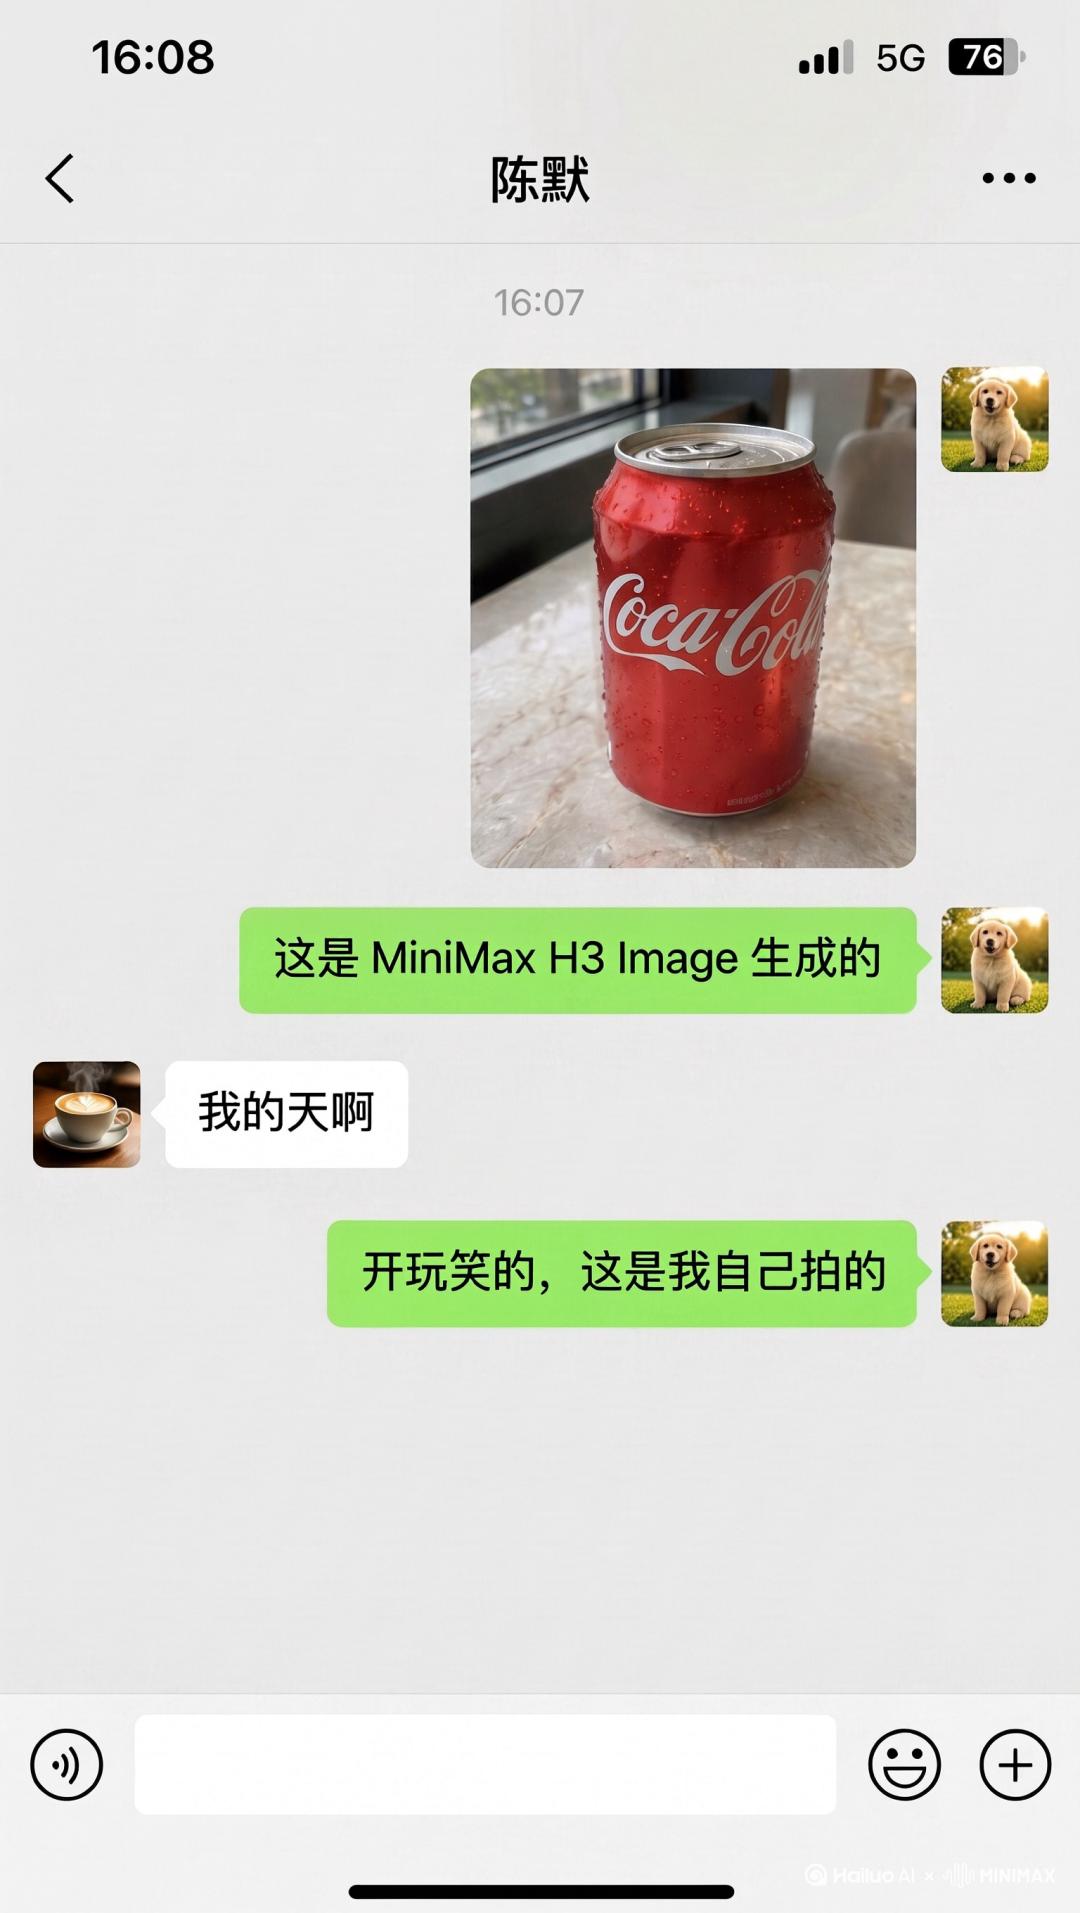
Prompt: Generiere einen Screenshot eines WeChat-Chats: Ich sende zuerst ein sehr realistisches Foto von Coca-Cola an die andere Person und schreibe: „Das wurde von MiniMax H3 Image generiert“. Die andere Person antwortet: „Mein Gott“. Dann schreibe ich zurück: „Ich mache Spaß, das habe ich selbst fotografiert“. Stelle sicher, dass der Screenshot hochgradig realistische Details der iPhone-Statusleiste enthält, einschließlich Uhrzeit, Akkustand und Signalstärke.
Mit nur einem eingegebenen Prompt generiert MiniMax H3 Image einen vollständigen Screenshot des WeChat-Chats.
Solche alltäglichen Oberflächen sind schwer zu erstellen, weil das menschliche Auge eine sehr geringe Toleranz für bekannte Szenarien hat. Die WeChat-Oberfläche hat relativ feste visuelle Regeln: Wenn die Schrift etwas zu fett ist, der Abstand der Chat-Blasen nicht stimmt oder das Verhältnis der Symbole in der Statusleiste nicht korrekt ist, fällt das sofort auf.
Viele Modelle erzeugen bei der Generierung ähnlicher Chat-Screenshots entweder verschobene und verzerrte Oberflächenelemente, oder unnatürliche Glanzlichter auf Produktfotos, wodurch der Realismus stark abnimmt.
Bei MiniMax H3 Image hingegen sind die Details der iPhone-Statusleiste, des WeChat-UI-Layouts, der Chat-Blasen und der Avatare sehr präzise umgesetzt. Das Coca-Cola-Foto ist ebenfalls realistisch genug: Kondenswasser auf der Flasche, Lichtreflexionen und Textur des Tisches wirken natürlich, man erkennt kaum KI-Spuren.
Als Nächstes kommt das größte Problem von Bildgenerierungsmodellen: die Textwiedergabe. Bisherige Modelle erzeugen oft Tippfehler, unleserlichen Text oder zerstörte Schreibweisen. Diesmal lassen wir H3 Image eine komplexe Aufgabe lösen und ein Graffiti generieren:
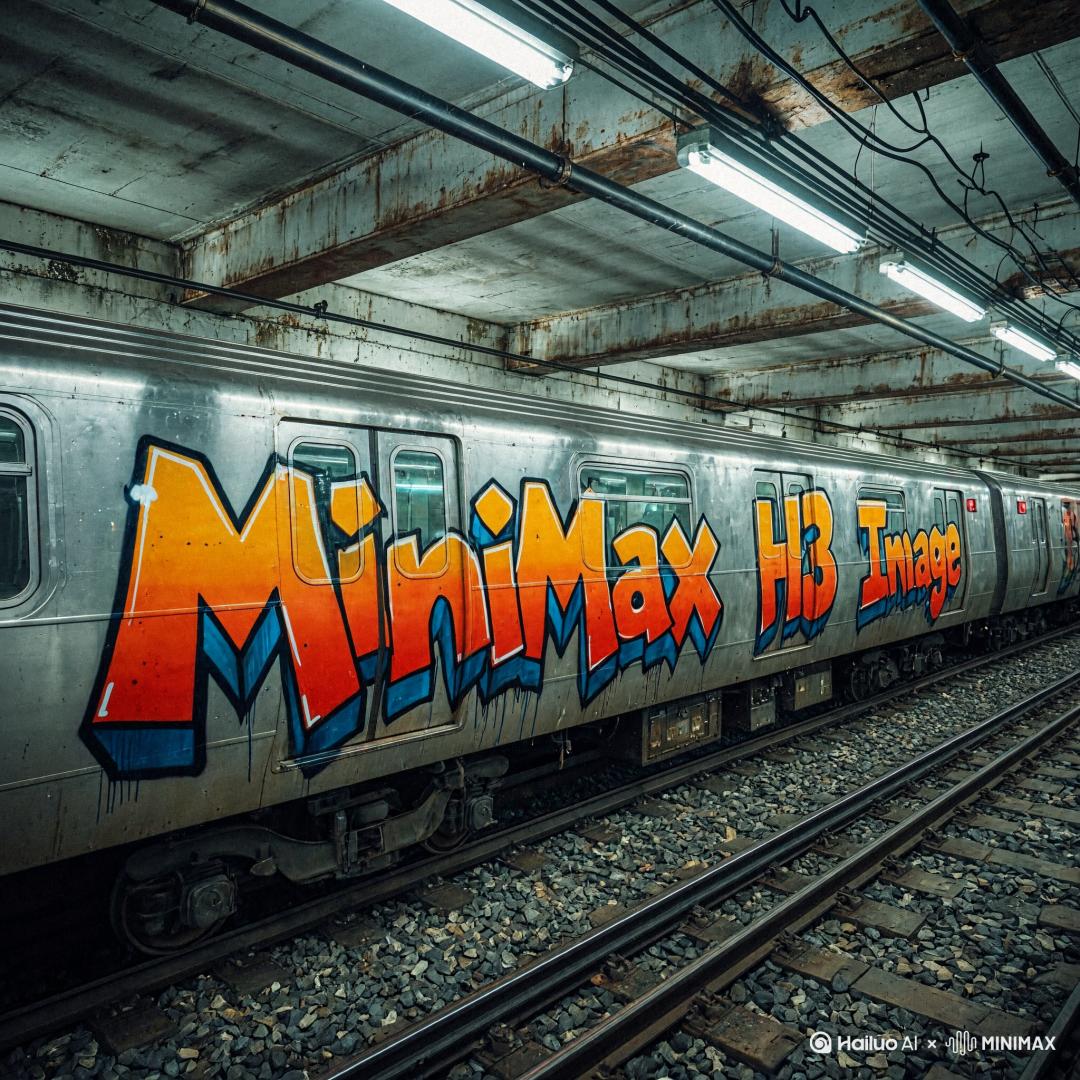
Prompt: Dies ist ein realistisches Foto im Hochformat. Ein silberner Edelstahl-U-Bahn-Waggon mit Altersspuren steht in einer rauen unterirdischen Station. An der Seite des Waggons befindet sich ein großes Wildstyle-Graffiti, das die gesamte Reihe von Fenstern überdeckt. Das Graffiti besteht aus kantigen 3D-Blockbuchstaben, die den Text „MiniMax H3 Image“ bilden. Die Buchstaben sind leuchtend orange mit Verläufen gefüllt, haben dunkelblaue 3D-Schatten, dicke schwarze Umrandungen und dünne weiße Glanzlinien. Man sieht sogar die Spuren von frischer Sprühfarbe, die heruntergelaufen ist. Im Hintergrund ist die industrielle Decke freigelegt, mit rostigen Stahlträgern, Rohren, Kabeln und kalt getönten Leuchtstoffröhren. Die Betonwände sind voller Flecken und Ablagerungen, darunter liegen Schienen und Schotter. Das Bild hat einen kalten Leuchtstofflicht-Effekt und metallische Reflexionen, ist kinematografisch farbkorrigiert, hat feine Filmkörnung und einen leichten Vignetteneffekt, um die typische Atmosphäre der New Yorker U-Bahn zu erzeugen. Das gesamte Foto wirkt wie mit einem 35mm-Objektiv aufgenommen, ist detailreich und zeigt einen rohen, realistischen urbanen Straßenfotografie-Stil.
Die lange Buchstabenfolge „MiniMax H3 Image“ ist nicht nur vollständig geschrieben, sondern hat auch eine dreidimensionale Form, Farbverläufe und Sprühlackeffekte. Auf diesem Niveau der Textfähigkeiten nähert sich das Modell bereits professionellem Grafikdesign.
Um hochwertige Porträts zu erstellen, reicht nicht nur eine schöne Gesichtsform: Gesichtsausdruck, Kleidungsdetails und Lichtstimmung müssen alle stimmen. Wir haben eine Herausforderung mit Backstage-Aufnahmen im Stil von Victoria's Secret gemeistert:
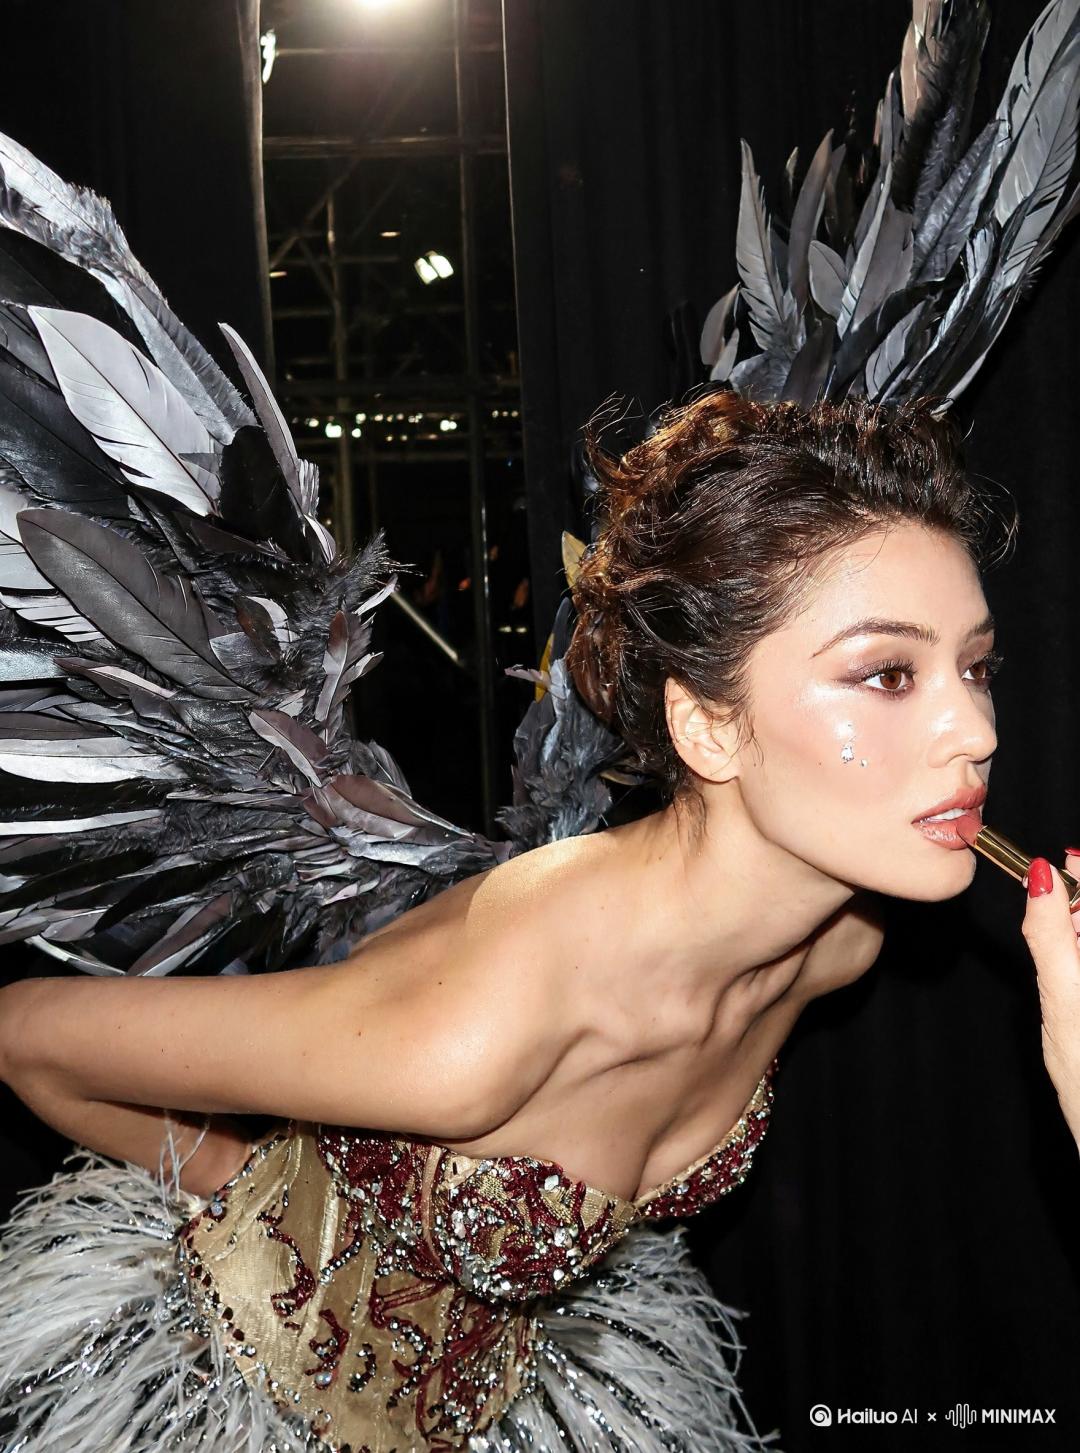
Prompt: Create a glamorous photoshoot in the style of Victoria’s Secret. A young woman attached in the uploaded reference image ( Keep the face of the person 100% accurate from the reference image ) stands almost sideways, slightly bent forward, during the final preparation for the show. Makeup artists apply lipstick to her (only her hands are visible in the frame). She is wearing a corset decorated with beaded embroidery and crystals with a short fluffy skirt, as well as large feather wings. The image has a “backstage” effect.The background is a darkly lit room, probably under the podium. The main emphasis is on the girl’s face and the details of her costume. Emphasize the expressiveness of the gaze and the luxurious look of the outfit. The photo is lit by a flash from the camera, which emphasizes the shine of the beads and crystals on the corset, as well as the girl’s shiny skin. Victoria’s Secret style: sensuality, luxury, glamour. Very detailed. Important: do not change the face.
Komplexe Elemente wie Kristallperlen und Federflügel sind bis ins kleinste Detail umgesetzt. Bei direktem Blitzlicht sind die Glanzstellen der Haut des Models und die Reflexionen der Kleidung klar abgestuft – das Ergebnis sieht aus wie eine Seite aus einem Modemagazin.
Probieren wir einen anderen Stil aus: kinematografische Porträts:
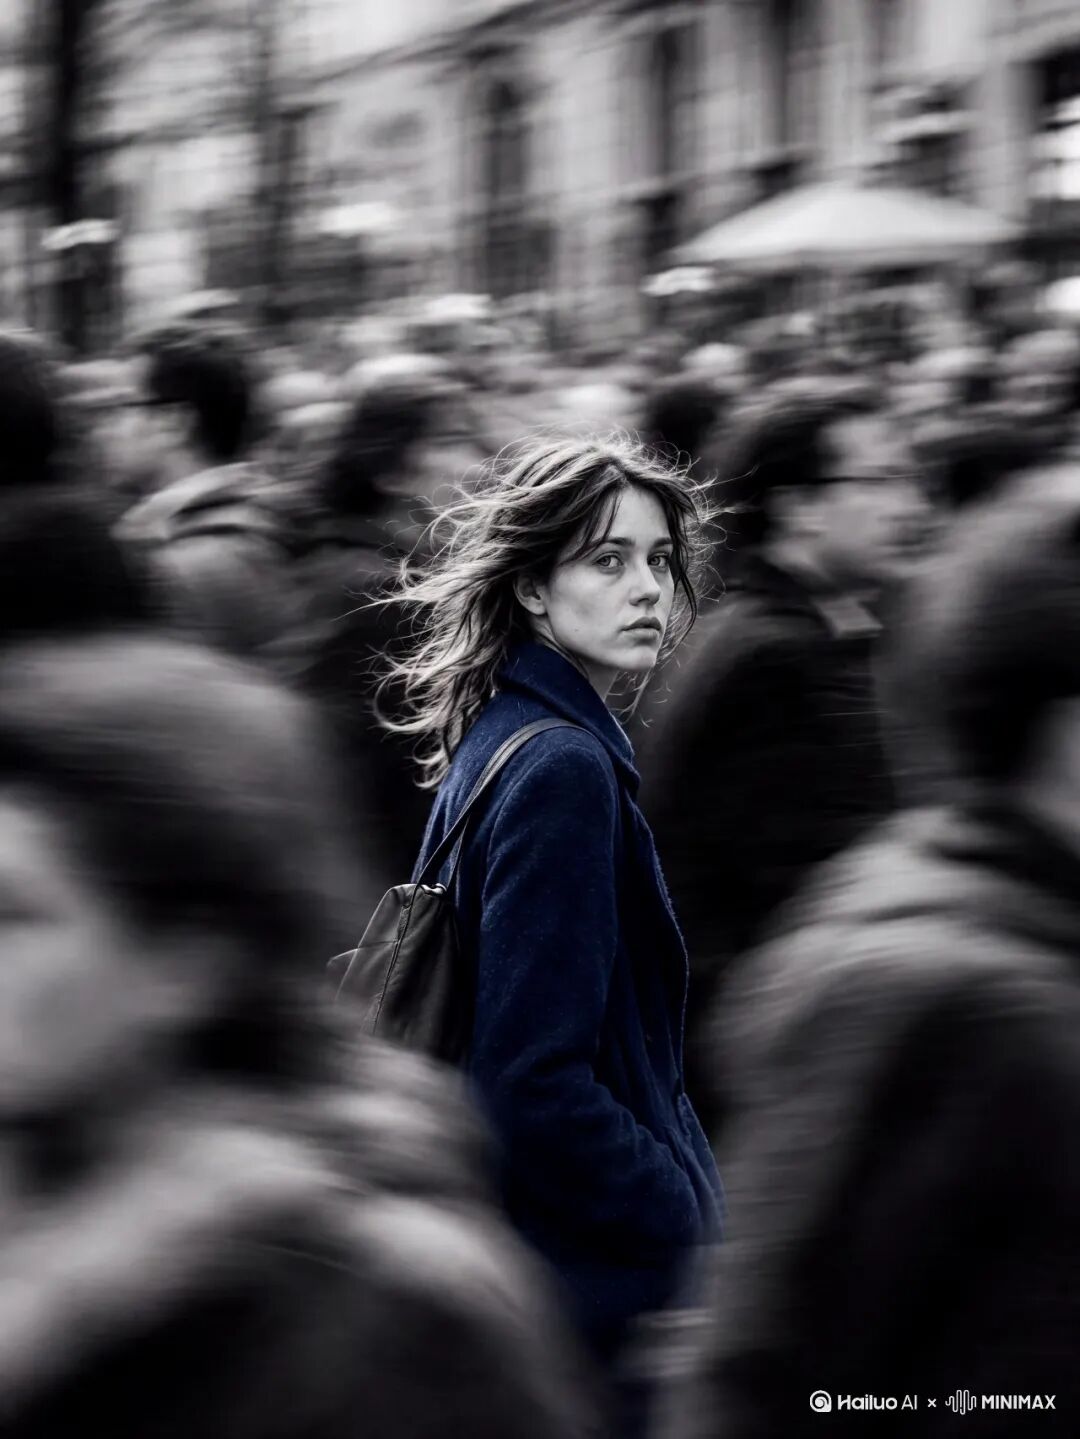
Dieses Straßenporträt wirkt wie ein Schnitt aus einem Film. Der Moment, in dem die Person zurückblickt, ist klar festgehalten, während die umstehenden Fußgänger als starke dynamische Bewegungsunschärfe dargestellt werden. Die Kombination aus Ruhe und Bewegung erzeugt sofort eine starke Bildspannung. Gesamte Atmosphäre, Objektivwirkung und Ausdruck von Emotionen sind überzeugend.
Wir haben außerdem nostalgische Porträts im Stil der Jahrtausendwende ausprobiert.
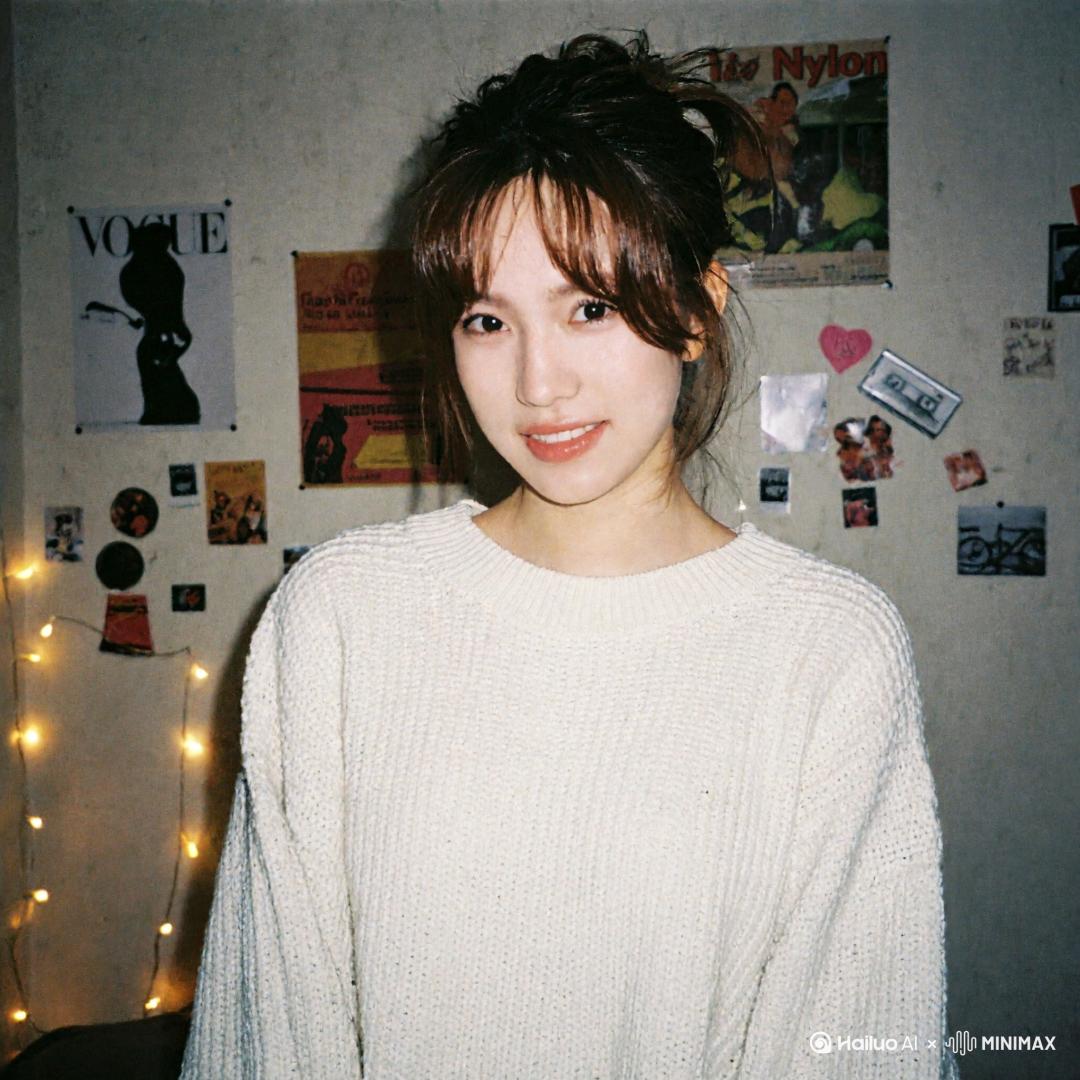
Prompt: Without changing her original face, create a portrait of a beautiful young woman with porcelain-white skin, captured with a 1990s-style camera using a direct front flash. Her messy dark brown hair is tied up, posing with a calm yet playful smile. She wears a modern oversized cream sweater. The background is a dark white wall covered with aesthetic magazine posters and stickers, evoking a cozy bedroom or personal room atmosphere under dim lighting. The 35mm lens flash creates a nostalgic glow.
Die leicht verrauschte Filmtextur, alten Magazinposter an der Wand und warmen gelben Lichterketten versetzen einen direkt zurück in die 2000er-Jahre. Die leichte Überbelichtung erinnert an das Gefühl alter Digitalkameras. Selbst die kleinen atmosphärischen Details aus dem Prompt wurden vollständig wiedergegeben.
Nach der Text-zu-Bild-Generierung probieren wir die Bild-zu-Bild-Funktion aus. In diesem Bereich muss das KI-Modell das Originalbild verstehen und es gemäß den Anweisungen verändern.
Zuerst machen wir ein Spaß mit Elon Musk: Wir laden ein Foto hoch und lassen das Modell daraus ein lustiges, niedlich-hässliches handgezeichnetes WeChat-Emoji machen. Der ursprüngliche Gesichtsausdruck der Person wird übertrieben dargestellt, zusammen mit schief geschriebenen Wörtern „So Dumb“, Schweißtropfen und Fragezeichen – fertig ist ein Emoji, das man direkt in Chats verwenden kann.
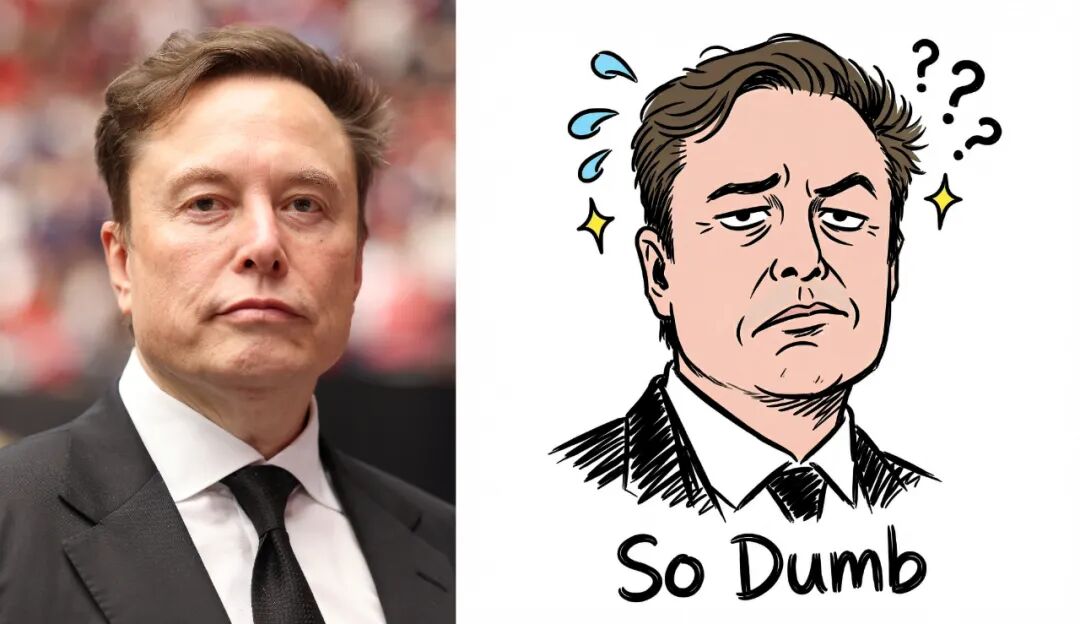
Prompt: Zeichne daraus ein lustiges handgezeichnetes WeChat-Emoji. Verwende einen minimalistischen, niedlich-hässlichen Linienstil, der wie eine zufällige Kritzelei wirkt, mit rein weißem Hintergrund. Übertreibe den Gesichtsausdruck der Person aus dem Originalfoto, um einen schockierten, angewiderten oder faulen Ausdruck darzustellen. Füge um den Kopf herum ein paar niedliche Kritzeleien wie Schweißtropfen, Fragezeichen oder funkelnde kleine Sterne hinzu. Füge unten die handgeschriebene englische Schrift „So Dumb“ hinzu, die schief und unordentlich wirkt, um lustig und ungezwungen zu erscheinen.
Für die nächste Runde erhöhen wir den Schwierigkeitsgrad: Wir laden ein Foto einer Straßenüberwachungskamera hoch und verlangen vom Modell, alle Personen im Bild zu erkennen, um jedes Gesicht einen weißen Rahmen zu zeichnen und eine hochauflösende vergrößerte Nahaufnahme der auffälligsten Person zu generieren.
Das Ergebnis behält die Szenenlayout und die Überwachungsperspektive des Originalbildes bei. Das Hauptbild hat die typische Rauschung und leichte Verzerrung von Überwachungsaufnahmen, während das Gesicht im vergrößerten Rahmen deutlich schärfer ist. Das Ganze wirkt wie eine automatisch generierte Analyseansicht eines Überwachungssystems.
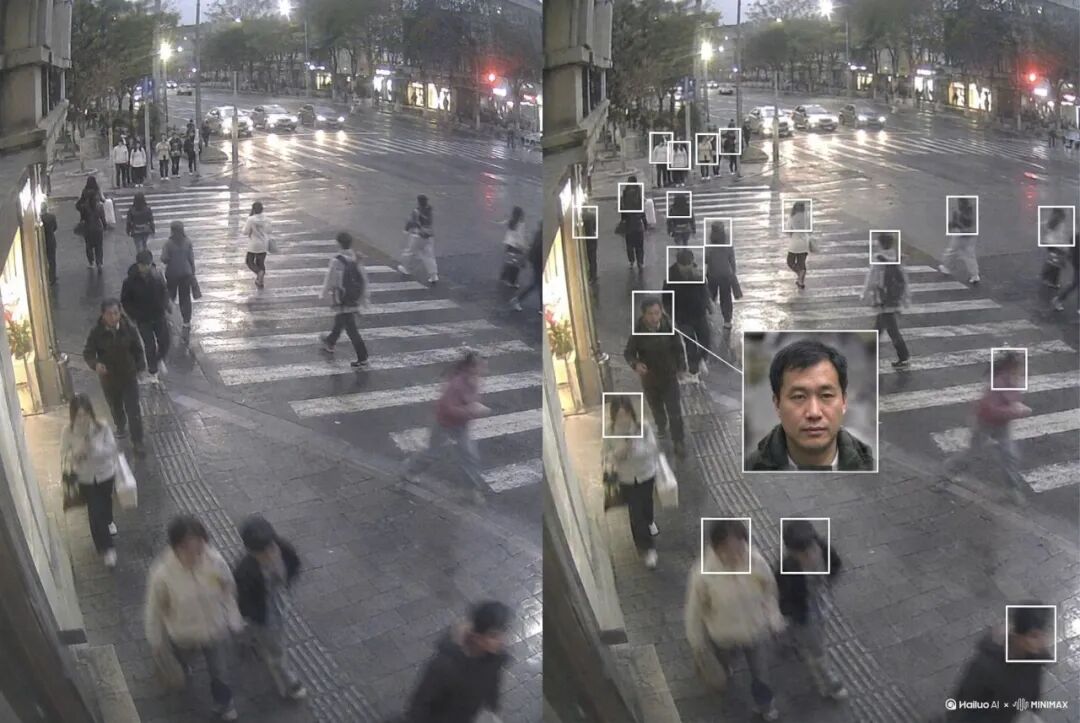
Prompt: Create a high angle CCTV surveillance shot using the uploaded image as the source. Detect every visible person in the image and automatically draw a white rectangular bounding box around each face. For the most prominent person, add