WorkBuddy und Codex treiben den Wettbewerb im Bereich der künstlichen Intelligenz hin zur ergebnisorientierten Aufgabenauslieferung voran, wobei Zuverlässigkeit zu einer unumgänglichen harten Schwelle geworden ist.
Wenn man eine KI auffordert, zu antworten „Wie erstellt man eine Betriebsanalyse“, und wenn man sie eine Verkaufstabelle lesen, Kennzahlen berechnen, Diagramme erzeugen und einen Bericht übergeben lässt, handelt es sich um Produktanforderungen auf zwei verschiedenen Ebenen. Die Praxiserfahrungen von WorkBuddy und Codex zeigen, dass Anwendungen großer Modelle zunehmend mehr praktische Operationen übernehmen, und die Beurteilung der Nutzer für Produkte erstreckt sich nicht mehr nur darauf, ob die Antwort brillant ist, sondern auch darauf, ob die Aufgabe abgeschlossen wurde.
Anwendungen großer Modelle treten in den Wettbewerb um die Aufgabenlieferung ein, und die zuverlässige Ausführung wird zur Schwelle für die praktische Umsetzung. Ein abnahmefähiges Ergebnis erfordert, dass das Modell das Ziel versteht, und zudem die Beteiligung aktueller Informationen, Werkzeugoperationen, Geschäftsregeln und Ergebnisprüfungen. Die Verbesserung der Modellfähigkeiten führt zu einer Neuzuweisung der Zuständigkeiten in diesen Gliedern.
Dies erklärt auch, warum Fine-Tuning, RAG, Workflows und Agenten ständig miteinander verzahnt werden: Sie verbessern jeweils die Modellfähigkeiten, die Aufgabeninformationen und den Ausführungsprozess. Um die Entwicklung dieser Routen zu verstehen, sollte man zuerst betrachten, wie das System eine einzelne Antwort zu einer Aufgabe organisiert, die abgeschlossen, überprüft und übergeben werden kann.
01 WorkBuddy und Codex lassen die KI direkt Dateien verarbeiten und Ergebnisse liefern
WorkBuddy und Codex verdienen es, gemeinsam betrachtet zu werden, da sie die Fähigkeit zur Aufgabenausführung in die echten Arbeitsumgebungen der Nutzer bringen. Die Nutzer übergeben Ziele, Materialien und den Umfang erlaubter Operationen, das System liest Informationen, ruft Werkzeuge auf und erzeugt Dateien, und die Ergebnisse kehren zurück in den ursprünglichen Arbeitsprozess. Die von dem Produkt übernommenen Zuständigkeiten erstrecken sich dadurch von der Bereitstellung von Antworten bis zur Organisation einer tatsächlichen Ausführung.
Auf der Produktseite von Tencents WorkBuddy werden lokale Dateioperationen, autonome Planung und Ergebnislieferung als Kernfähigkeiten hervorgehoben. In spezifischeren offiziellen Praxisdokumenten wird die Betriebsanalyse als Beispiel angeführt: Nutzer liefern Excel- oder CSV-Dateien, legen Kennzahlen und Zeiträume fest, das Produkt liest Daten, führt Statistiken durch und erzeugt Diagramme oder Berichte. Die Fähigkeitsdokumentation erläutert zudem, dass Skripte und Workflows zur Erweiterung der Fähigkeiten für spezifische Aufgaben verwendet werden können. Fachwissen, vorhandene Programme und Modellurteile gelangen dadurch in denselben Aufgabenprozess.
Die Entwicklung von Codex zeigt die Erweiterung von Code-Aufgaben auf breitere Wissensarbeit. Bei der Veröffentlichung im Jahr 2025 hat es bereits das Lesen und Schreiben von Code, die Ausführung von Befehlen und das Durchführen von Tests zu Aufgaben organisiert; im Juni 2026 umfassten die von OpenAI offengelegten Anwendungsfälle für Wissensarbeit weiter Berichte, Tabellen, Präsentationen und Forschungsanalysen. In einem Plattformartikel im August öffnete es den Ausführungszyklus als integrierbares Harness, sodass andere Anwendungen weiterhin ihre eigenen Geschäftsschnittstellen, Kontexte und Werkzeuge behalten können.
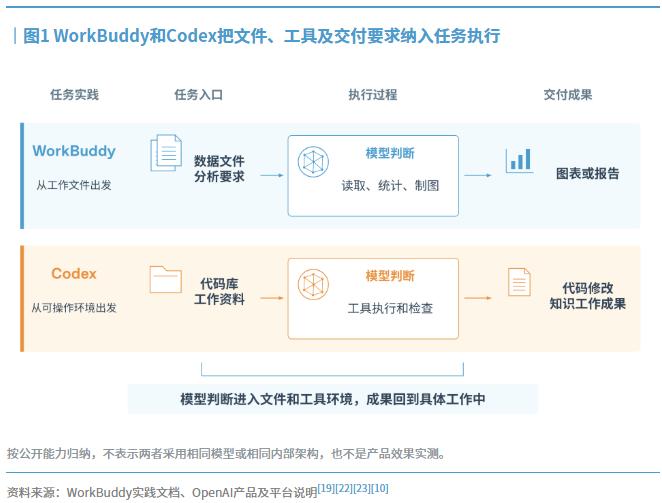
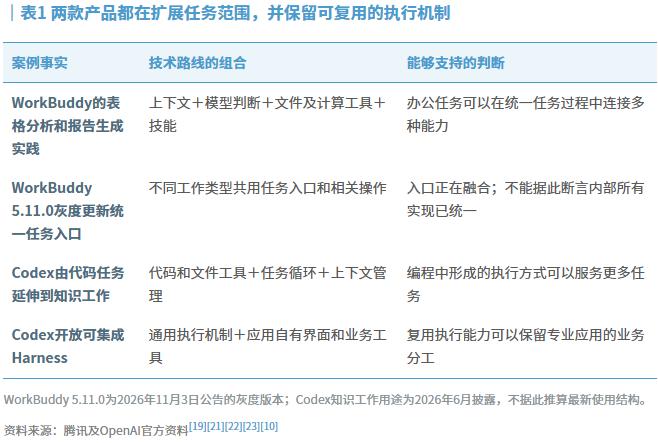
Diese beiden Fälle deuten darauf hin, dass Fachfähigkeiten gemeinsam von generischen Modellen, Aufgabenbeschreibungen, Fachmaterialien, Werkzeugen und Ausführungssteuerung gebildet werden können. Weder der „Fachexperte“ von WorkBuddy noch eine Codex-Aufgabe können allein aufgrund der Bezeichnung als unabhängig trainiertes domänenspezifisches Modell eingestuft werden. Die Anwendungspezialisierung erhält zunehmend mehr Implementierungsmethoden, und die Modellspezialisierung ist nur eine davon.
02 Die Verbesserung generischer Modelle verschiebt den Schwerpunkt der Anwendungsentwicklung auf vollständige Aufgaben
Je besser generische Modelle Anweisungen verstehen, lange Dokumente verarbeiten und Werkzeuge aufrufen können, desto weniger müssen Entwickler separate Verarbeitungslogiken für jede Ausdrucksweise entwerfen. Teilaufgaben, die früher auf das Training mit einer großen Anzahl von Stichproben angewiesen waren, können jetzt durch Anweisungen und Beispiele abgeschlossen werden; Teilschritte, die früher manuell verbunden werden mussten, können jetzt vom Modell basierend auf den Ausführungsergebnissen angepasst werden. Die Anwendungsentwicklung erhält dadurch einen größeren Auswahlraum.
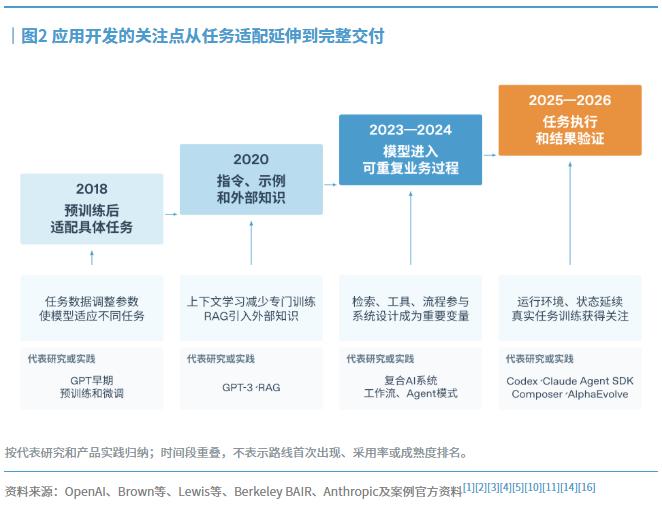
Diese Veränderung hat einen klaren technischen Verlauf. Im Jahr 2018 verwendeten frühe Forschungen zu GPT den Ansatz des Fine-Tunings nach dem Vortraining pro Aufgabe; GPT-3 im Jahr 2020 zeigte die Fähigkeit, verschiedene Arten von Aufgaben durch Aufgabenbeschreibungen und Beispiele im Kontext abzuschließen. Im selben Jahr führte die RAG-Forschung das externe Retrieval in den Generierungsprozess ein. Bis 2024 hat Berkeley BAIR die Praxis, dass Modelle, Retrieval-Systeme und externe Werkzeuge gemeinsam Aufgaben abschließen, als „zusammengesetztes KI-System“ zusammengefasst.
Mehrere Routen waren von Anfang an miteinander verzahnt. RAG ist nicht erst erschienen, nachdem das Fine-Tuning verschwunden ist, und Workflows haben ihren Wert nicht erst mit dem Aufkommen von Agenten erhalten. Wenn man sie als eine Kette von Elimination anordnet, verbirgt man die tatsächliche Veränderung: Die von dem Modell übernommenen generischen Fähigkeiten erweitern sich, und der Inhalt, den das Anwendungssystem ergänzen muss, ändert sich entsprechend.
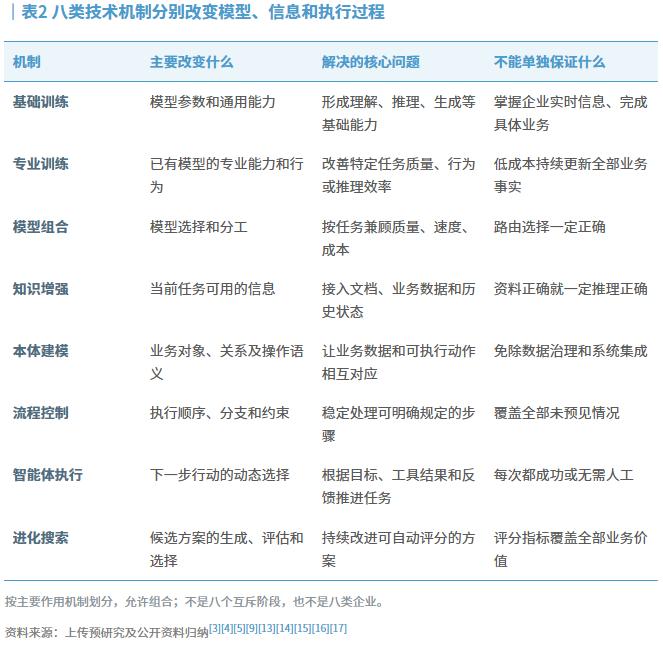
03 Unternehmenswissen muss kontinuierlich eingebunden werden, und domänenspezifische Modelle sind nur eine Methode der Spezialisierung
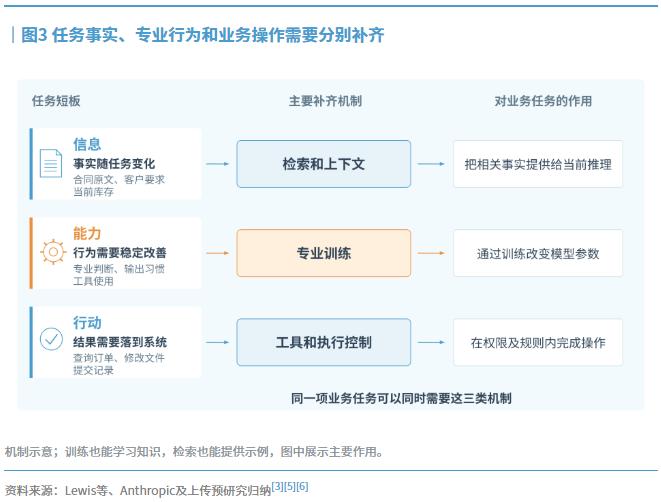
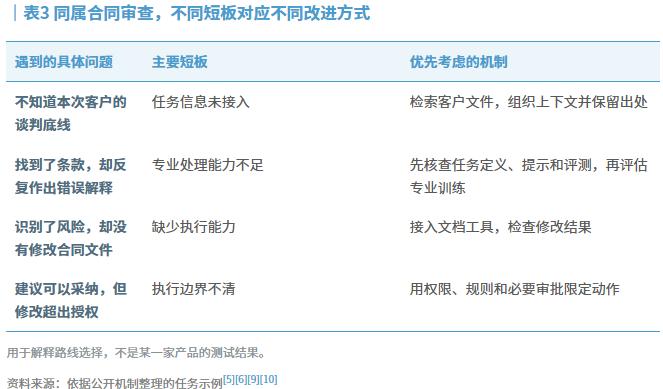
Modellparameter eignen sich zur Speicherung relativ stabiler Fähigkeiten, die auf verschiedene Aufgaben wiederverwendet werden können; die spezifischen Fakten, die eine Aufgabe erfordert, ändern sich jedoch häufig. Verträge, die Kunden gerade hochgeladen haben, der aktuelle Lagerbestand des Tages oder Materialien, auf die ein bestimmter Mitarbeiter zugreifen darf, können nicht alle warten, bis sie nach der nächsten Trainingsrunde verwendet werden. Die Bereitstellung dieser Informationen für das Modell während der Ausführung erleichtert in der Regel die Aktualisierung und die Beibehaltung von Herkunft und Berechtigungen.
RAG löst dadurch eine Kategorie von Problemen bei der Wissensintegration. Unternehmensinformationen existieren jedoch nicht nur in Dokumenten, sondern umfassen auch Datenbankdatensätze, Zustände von Geschäftssystemen und Ergebnisse von Werkzeugrückgaben. Mit zunehmender Länge der Aufgabe muss das System zudem kontinuierlich Materialien filtern, Zwischenschlussfolgerungen behalten und irrelevante Informationen beseitigen. Das Objekt der Kontext-Engineering erweitert sich dadurch auf alle Informationen, die das Modell aktuell benötigt. Anthropic hat in einem Ingenieurartikel im Jahr 2025 die Auswahl und Wartung von Informationen ebenfalls im Rahmen des kontinuierlichen Ausführungsprozesses erörtert.
Das fachliche Training löst eine andere Kategorie von Problemen: Selbst bei vollständigen Materialien kann das Modell wiederholt falsche Verarbeitungsweisen anwenden oder die Anforderungen an professionelle Ergebnisse nicht stabil erfüllen. In diesem Fall kann das Training Verhalten, Schlussfolgerung und Werkzeugverwendung verbessern. Die Wahl zwischen Retrieval oder Training hängt zunächst davon ab, ob das Defizit aus fehlenden Informationen oder aus der Unfähigkeit resultiert, die Aufgabe stabil abzuschließen; wenn beide Defizite gleichzeitig vorliegen, ist eine Kombination erforderlich.
04 Workflows nehmen zunehmend Agenten auf, und kritische Geschäftsregeln erfordern weiterhin die Steuerung durch Programme
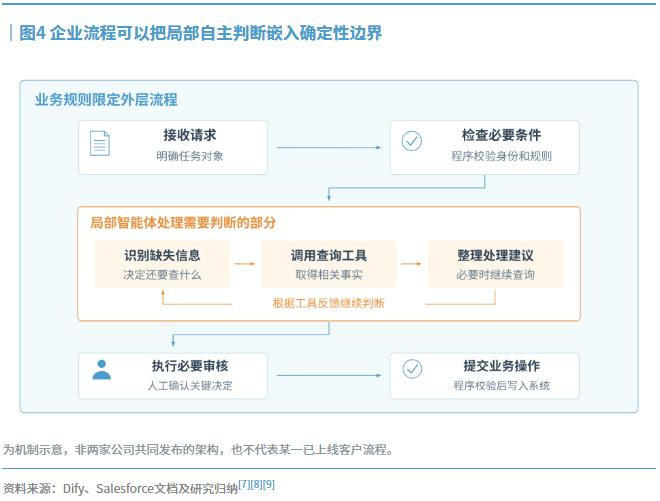
Wenn das Modell selbst Materialien nachschlagen, Werkzeuge auswählen und Schritte anpassen kann, wirken Workflows, die jede einzelne Operation vorschreiben, schwerfällig. In Unternehmensprozessen gibt es jedoch zwei Arten von Schritten: Die eine Art ändert sich je nach Kontext und erfordert Erklärung und Urteil; die andere Art hat klare Regeln und muss jedes Mal vorschriftsgemäß ausgeführt werden. Ersteres eignet sich zur Erhöhung des Modellurteils, Letzteres eignet sich weiterhin zur Steuerung durch Programme.
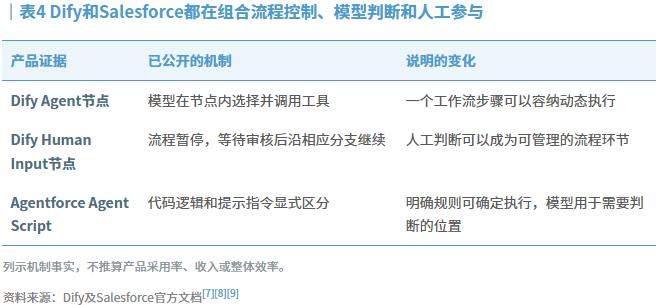
Dify platziert Agenten in Workflow-Knoten und erlaubt dem Modell, Werkzeuge innerhalb des Knotens iterativ aufzurufen; im März 2026 machte es durch den Human-Input-Knoten das Anhalten, die manuelle Überprüfung und die Fortsetzung der Ausführung zu nativen Gliedern des Workflows. Autonome Urteile und menschliche Beteiligung gelangen dadurch in dieselbe Orchestrierung.
Salesforce erläutert dasselbe Problem von einer anderen Seite. Seine technische Dokumentation zu Agentforce trennt deterministische Logik und Modellschlussfolgerung klar voneinander: Bedingungsurteile, Aktionsreihenfolgen und Ähnliches können als Code ausgeführt werden, und das Modell wird nur an Stellen aufgerufen, an denen tatsächlich Verständnis oder Urteil erforderlich ist. Die Entwicklungsrichtung von Unternehmensagenten besteht darin, die Grenzen der Arbeitsteilung genauer festzulegen; der Grad der Autonomie allein ist kein ausreichender Indikator für die Produktfähigkeit.
05 Die Skalierung von KI-Büroarbeit erfordert stabile Ausführung und überprüfbare Lieferergebnisse
Ein Modell in einen Zyklus zu versetzen und es kontinuierlich Werkzeuge aufrufen zu lassen, reicht nicht aus, um ein zuverlässiges Aufgabenausführungsprodukt zu bilden. Eine Aufgabe kann Dutzende von Minuten andauern und mehrere Dateiänderungen, Werkzeugfehler und Kontextaktualisierungen durchlaufen. Das System muss wissen, was bereits abgeschlossen ist, worauf der nächste Schritt basiert, wo es nach einem Fehler wiederhergestellt werden kann und ob das Endergebnis den Anforderungen entspricht.
In dem Plattformartikel zu Codex bezeichnet OpenAI das Ausführungssystem, das für Kontext, Werkzeuginteraktion, Zustands- und Grenzverwaltung um das Modell herum zuständig ist, als Harness. Die Ingenieurpraxis von Anthropic für lang andauernde Aufgaben ermöglicht durch anfängliche Umgebungseinstellungen, Fortschrittsdateien und Versionsaufzeichnungen, dass nachfolgende Ausführungen an vorherige Arbeiten anknüpfen. Diese Mechanismen verdeutlichen gemeinsam: Die Fähigkeit des Modells, den nächsten Schritt zu bestimmen, erfordert ein Ausführungssystem, das sie in eine kontinuierliche, überprüfbare Arbeit umwandelt.
Wenn Produkte beginnen, Dateien, Code und Geschäftsdatensätze zu liefern, wird die Laufzeitumgebung ebenfalls Teil der Produktfähigkeit. Wo die Dateien gespeichert werden, ob die Ausführung isoliert werden kann, ob die Aufgabe wiederhergestellt werden kann und wie die Operationsergebnisse überprüft werden, beeinflussen alle die Ergebnisse, die die Nutzer tatsächlich erhalten. Ein Vergleich nur der Qualität der Modellantworten lässt diese Unterschiede außer Acht.
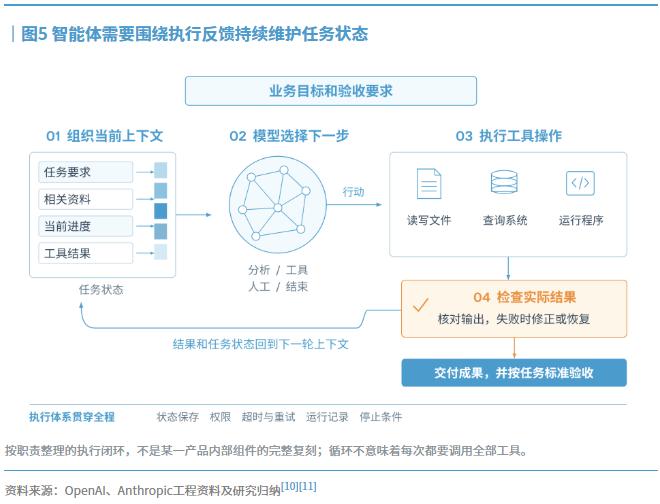
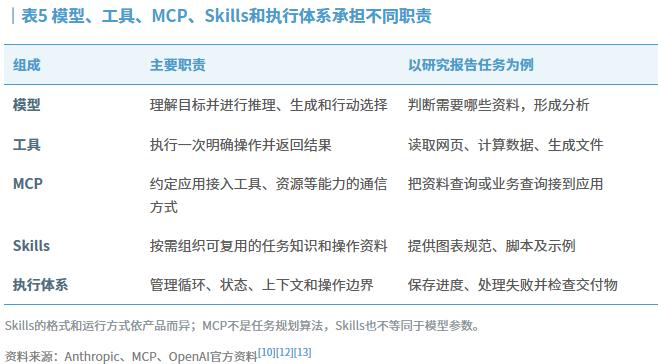
Neue Komponenten müssen ebenfalls an ihre jeweiligen Stellen zurückgebracht werden. Werkzeuge liefern spezifische Operationen, MCP liefert ein Protokoll zur Verbindung von Werkzeugen und Ressourcen, Skills organisieren wiederverwendbare Beschreibungen, Skripte und Referenzmaterialien; das Ausführungssystem ist dafür verantwortlich, sie in der Aufgabe zu verwenden. Die Komponenten werden immer vielfältiger, aber die Bezeichnung allein beweist nicht die Fähigkeit zum Abschluss von Aufgaben.