Fable und Astra begeben sich in die physische Welt, während Ant Lingbo sich dafür entscheidet, von den Fingerspitzen aus Wurzeln zu schlagen.
In den letzten zwei Tagen haben Sie alle die Nachrichten über Claude Fable 5.2 gesehen: Die Live-Demonstration am echten Gerät zeigte Aufgaben wie das Aufdrehen von Flaschenverschlüssen, das Lösen von Zauberwürfeln und das Malen in einem durchgehenden Ablauf, wodurch die generalisierte Erfolgsrate für zwearmige Roboter direkt auf 64,9 % angehoben wurde – mehr als das Doppelte von Astra.
Gleichzeitig hat Ant Lingbo Technology das taktile Grundmodell LingBot-Touch als Open-Source veröffentlicht. Es vereinheitlicht drei völlig unterschiedliche Sensorsignale aus magnetischer Taktilität, visueller Taktilität und piezoresistiver Taktilität in einheitlichen „Taktile-Tokens“, die von verschiedenen geschickten Händen und Bewegungsmodellen verwendet werden können. Dadurch wird der Roboter nicht nur in die Lage versetzt, „klar zu sehen und vernünftig zu denken“, sondern erhält zusätzlich die taktile Wahrnehmung, die für präzise Manipulationen erforderlich ist.
Können allgemeine große Modelle die Embodied Intelligence durch „Dimensionsreduzierung“ übertreffen? Die Beziehung zwischen diesen beiden technischen Wegen steht derzeit im Mittelpunkt der Diskussion in der gesamten Embodied-Intelligence-Branche. Nach Ansicht von Ant Lingbo besteht zwischen allgemeinen großen Modellen und embodied Grundmodellen eher eine synergetische Beziehung, die 1+1>2 ergibt: Erstere verbessern das Verständnis und die Schlussfolgerung für Aufgaben und Umgebungen, Letztere ergänzen die Fähigkeiten zur physischen Wahrnehmung und geschlossenen Steuerung. Nur wenn beide Seiten gemeinsam voranschreiten, kann die Reife der Embodied-Intelligence-Industrie beschleunigt werden.
Die Ansicht von Shen Yujun, Chefwissenschaftler von Ant Lingbo, zu den jüngsten Marktschwankungen ist recht pointiert: Er sagte offen: „Ein nutzbares Werkzeug ist nicht unbedingt das am besten geeignete Werkzeug.“ Er wünscht sich, dass dieses Werkzeug „weder zu groß noch zu klein“ ist: Es weist keine Mängel bei den Schlüsselfähigkeiten auf und verschwendet so wenig wie möglich Ressourcen für nicht notwendige Funktionen. Die hier genannte „Größe“ bezieht sich nicht auf den Parameterumfang, sondern auf die Fähigkeitskonfiguration. Beispielsweise sollte ein embodied Modell nicht das Ziel verfolgen, Programmierfähigkeiten auf dem Niveau von Fable oder Astra zu erreichen, da umfassende Softwareentwicklungsfähigkeiten keine zwingende Anforderung für Roboterarbeiten darstellen. Umgekehrt ist die Wahrnehmung und das Verständnis physischer Modalitäten wie Entfernung und Taktilität eine Fähigkeit, die Modelle der digitalen Welt von Natur aus nicht besitzen, die aber für Roboter zur Durchführung hochpräziser komplexer Manipulationen unverzichtbar ist.
Die Entwicklung der Taktilität ist keine Wahlmöglichkeit, sondern eine zwingende Aufgabe
In den letzten drei Jahren wurde die Embodied Intelligence hauptsächlich von visuellen und sprachlichen Modalitäten vorangetrieben, und die Branche hat eine Reihe beeindruckender Demonstrationen hervorgebracht. Sobald Roboter jedoch in die reale Welt eintreten, scheitern sie häufig an der Hürde der präzisen Manipulation.
Aus umfangreichen Praxiseinsätzen hat die Branche erkannt, dass visuelle und sprachliche Modalitäten das Denken „vor dem Kontakt“ lösen, während die Taktilität den Zustand „nach dem Kontakt“ abdeckt. Da die Kluft zwischen „Wissen“ und „Handeln“ in der Embodied Intelligence so offensichtlich ist, ist die Taktilität keine Wahlmöglichkeit mehr, sondern eine zwingende Aufgabe.
Ob ein Roboter ein Objekt fest halten kann, zeigt sich oft erst, wenn seine Finger es berühren.
Diese völlig neue Modalität der Taktilität tritt allmählich in den Vordergrund der Branche – allerdings hat sie in den vergangenen Jahren auch Umwege durchlaufen. Beispielsweise gab es früher die weit verbreitete Annahme: Führt das Hinzufügen von Taktilität nicht zu Rauschen im Modell und verschlechtert die Qualität? Sollte man mit der taktilen Modalität warten, bis der Sensortechnikpfad vollständig geklärt ist?
In den letzten Monaten hat sich der Konsens über die taktile Modalität jedoch schnell umgekehrt. Dennoch bedeutet die Einigkeit über die Notwendigkeit der taktilen Modalität nicht, dass die Branche bereits eine einheitliche Lösung gefunden hat. Derzeit gibt es drei verschiedene Entwicklungswege für taktile Sensoren: visuelle Taktilität, magnetische Taktilität und piezoresistive Taktilität.
Jede der drei Varianten hat ihre eigenen Vor- und Nachteile: Die visuelle Taktilität erfasst Kontaktinformationen, indem sie die Verformung einer flexiblen Oberfläche beobachtet, und kann relativ umfangreiche Kontaktformen erfassen, wird aber unweigerlich durch die Bildrate eingeschränkt. Die magnetische Taktilität erfasst Kräfte anhand von Magnetfeldänderungen, hat die Vorteile geringer Dicke und hoher Geschwindigkeit, ist aber anfällig für Störungen durch ferromagnetische Materialien. Die piezoresistive Taktilität misst den Druck anhand von Widerstandsänderungen, zeichnet sich durch niedrige Kosten und einfache großflächige Implementierung aus, weist aber eine niedrige Auflösung auf und neigt nach längerem Gebrauch zu Drift.
Die fehlende Konvergenz der technischen Wege hat auch zahlreiche Probleme in der Branche verursacht. Da es an einer taktilen Basis fehlt, die die drei heterogenen taktilen Signale einheitlich modelliert, lassen sich keine allgemeingültigen Repräsentationen erzeugen, was die Effizienz der Branchenforschung extrem senkt.
Ein anschauliches Beispiel: Ein Roboter lernt heute, „wie man erkennt, dass ein Finger rutscht“, aber wenn er morgen auf eine andere geschickte Hand oder einen anderen taktilen Sensor umgestellt wird, ist diese Erfahrung direkt nutzlos. Ein Ingenieur scherzte dazu: Jeder taktile Sensor hat sozusagen seine eigene „Dialekt“, die die anderen nicht verstehen.
Das von Lingbo veröffentlichte LingBot-Touch zielt genau darauf ab, dieses Problem zu lösen. Sein wichtigstes Merkmal ist Allgemeingültigkeit und Kompatibilität.
Lingbo hat uns den Trainingsablauf des gesamten taktilen Modells grob vorgestellt.
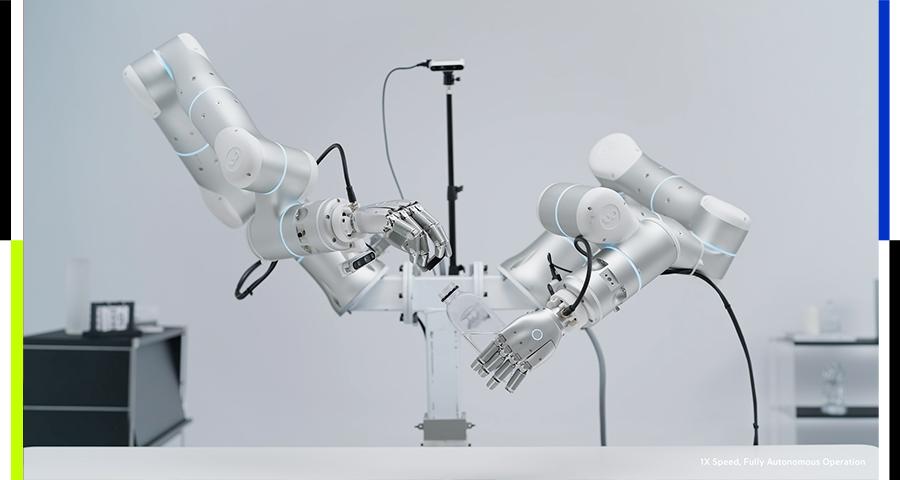
Zunächst stammen die Daten von LingBot-Touch hauptsächlich aus zwei Arten realer Operationen: Zum einen wurden 2197 Stunden piezoresistive taktile Daten und 1136 Stunden magnetische taktile Daten erfasst, wobei Personen taktile Handschuhe trugen und Operationen durchführten. Zum anderen wurden 1650 Stunden visuelle taktile Daten erfasst, indem der zwearmige Roboter Sharpa Wave ferngesteuert betrieben wurde.
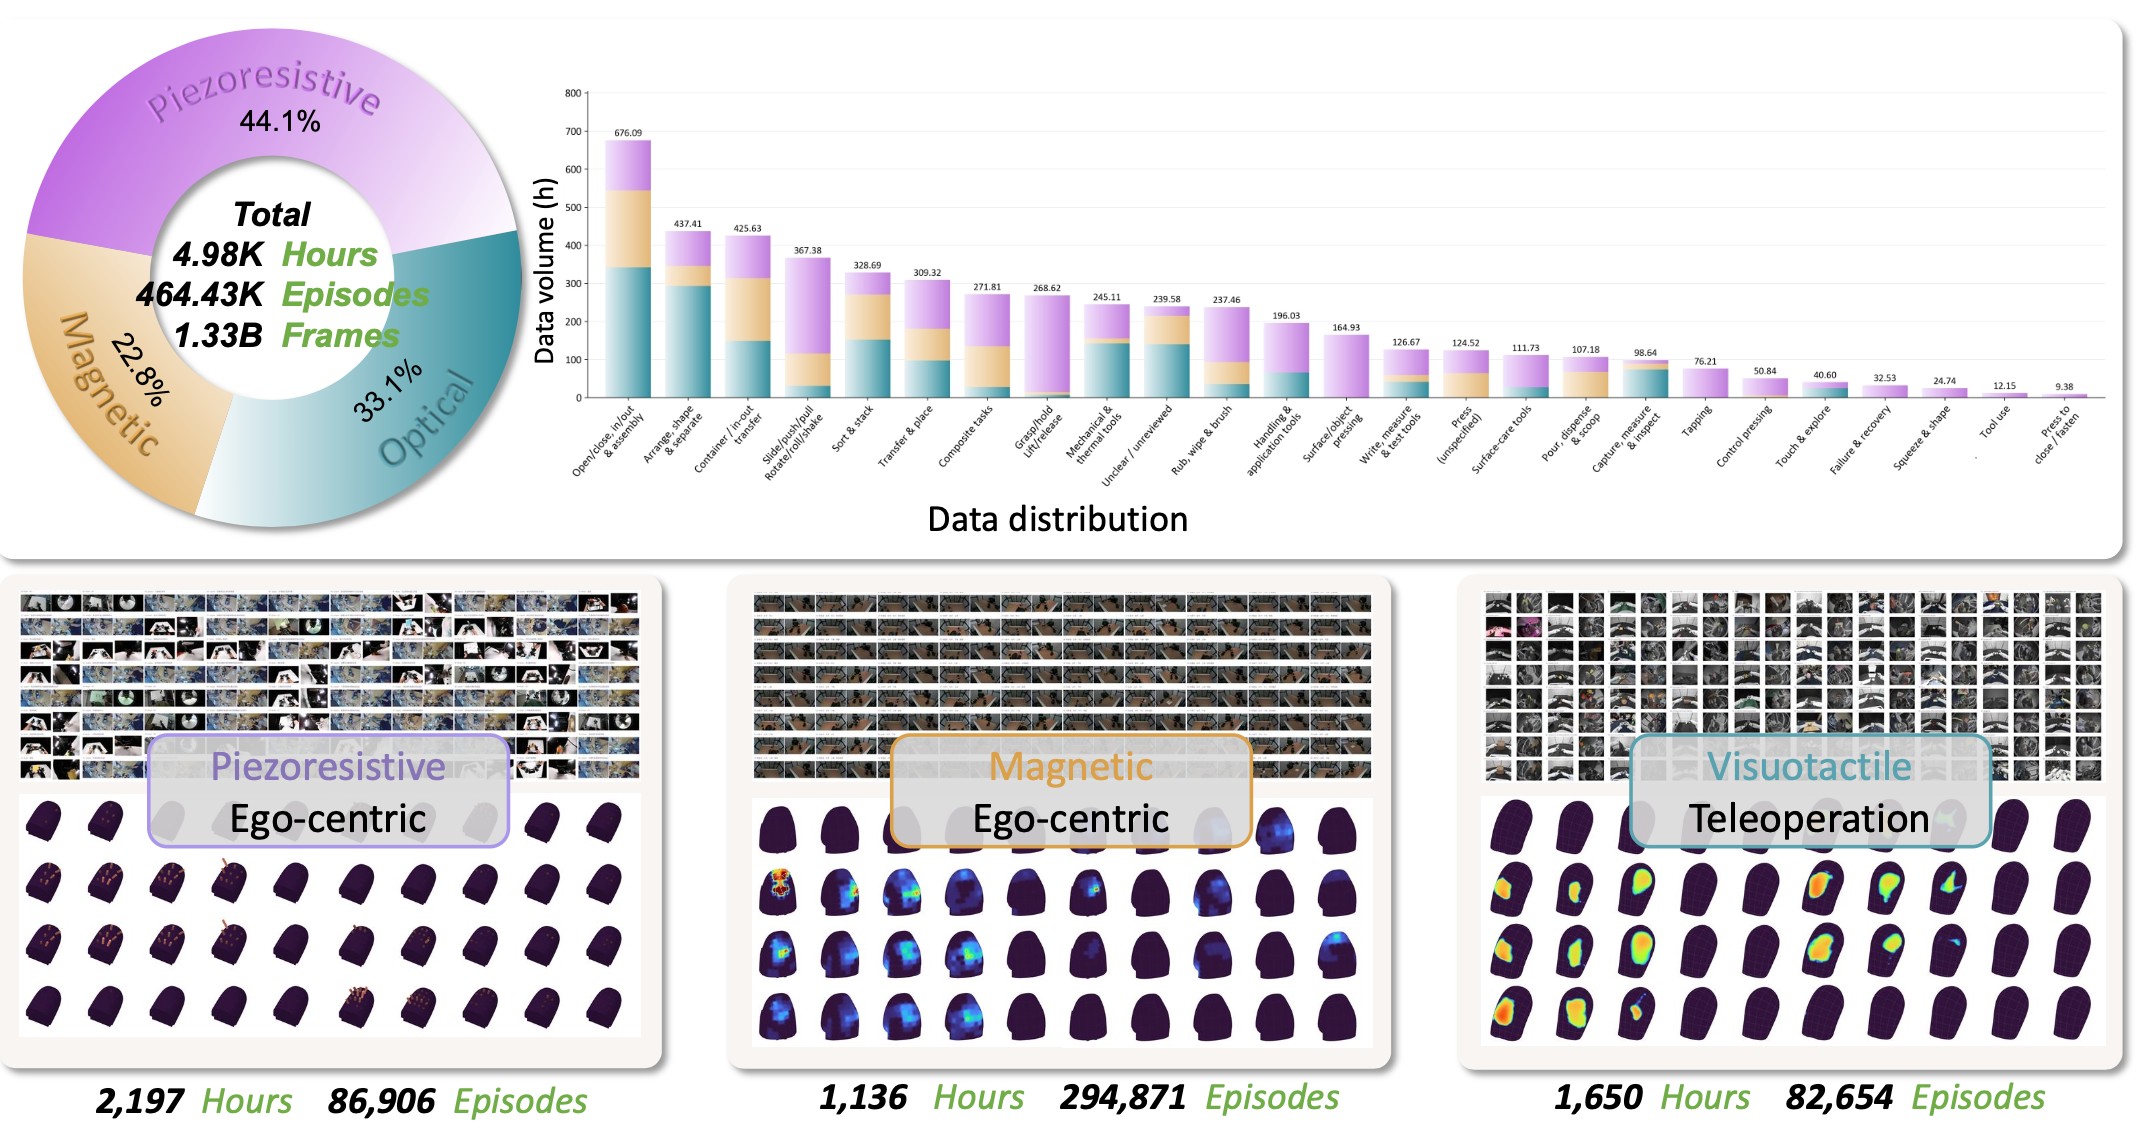
Der anschließende Trainingsablauf lässt sich kurz in drei Schritte zusammenfassen:
Erstens: Damit das Modell die von verschiedenen Sensoren erzeugten taktilen Signale einheitlich verstehen kann, ordnet das Forschungsteam zuerst alle Kontaktpunkte einem einheitlichen Standard-Koordinatensystem für die Fingerspitzen zu. Zweitens werden für unterschiedliche Sensorprinzipien wie piezoresistive, magnetische und visuelle Taktilität spezielle Tokenizer (Encoder) entworfen. Drittens werden die Rohsignale in Tokens umgewandelt, die das Modell verarbeiten kann, und schließlich in denselben Transformer eingespeist, um das Training durchzuführen.
Der gesamte Trainingsgedanke ähnelt dem, das Modell eine „Lückentextaufgabe“ lösen zu lassen: Ein Teil der taktilen Informationen der Fingerspitzen wird zufällig verdeckt, und das Modell soll anhand der Kontaktänderungen an anderen Positionen ableiten, was an der verdeckten Stelle passiert ist. Es wird jedoch nicht verlangt, dass das Modell die von den Sensoren aufgezeichneten Rohdaten exakt wiedergibt, sondern dass es aussagekräftigere Merkmale vorhersagt – beispielsweise welche Kontaktzustände und physischen Änderungen sich hinter diesen Werten verbergen.
Das Endergebnis ist, dass LingBot-Touch die bisherigen Hindernisse zwischen Sensoren, geschickten Händen, Aufgaben und Bewegungsmodellen direkt beseitigt.
Beispielsweise muss ein neues Modell desselben Prinzips nicht neu trainiert werden, wenn man zu einem anderen taktilen Sensor wechselt. Wenn man die geschickte Hand austauschen muss, kann auch dann eine direkte Verbindung hergestellt werden, wenn der Sensor an der neuen Hand in der Vor-Trainingsphase noch nicht bekannt war.
Darüber hinaus muss man auch dann nicht ein neues taktiles Modell trainieren, wenn man die Handaufgabe ändert – egal ob es sich um das Umblättern von Seiten oder das Aufdrehen von Flaschenverschlüssen handelt. Mit nur wenigen Demonstrationen kann das Bewegungsmodell die neue Betriebsweise erlernen. Sogar wenn das zugrundeliegende Bewegungsmodell ausgetauscht werden muss, kann dieselbe taktile Informationsbasis weiterverwendet werden.
Tests am echten Gerät haben dies bestätigt.
Am Beispiel des Aufdrehens von Flaschenverschlüssen: Ohne taktiles Modell lag die Erfolgsrate von Sharpa Wave nur bei 56,25 %. Nach der Integration von LingBot-Touch kann der Roboter erkennen, dass der Flaschenverschluss kurz vor dem Rutschen steht, und die Kraft rechtzeitig anpassen, sodass die Erfolgsrate auf 90 % steigt.
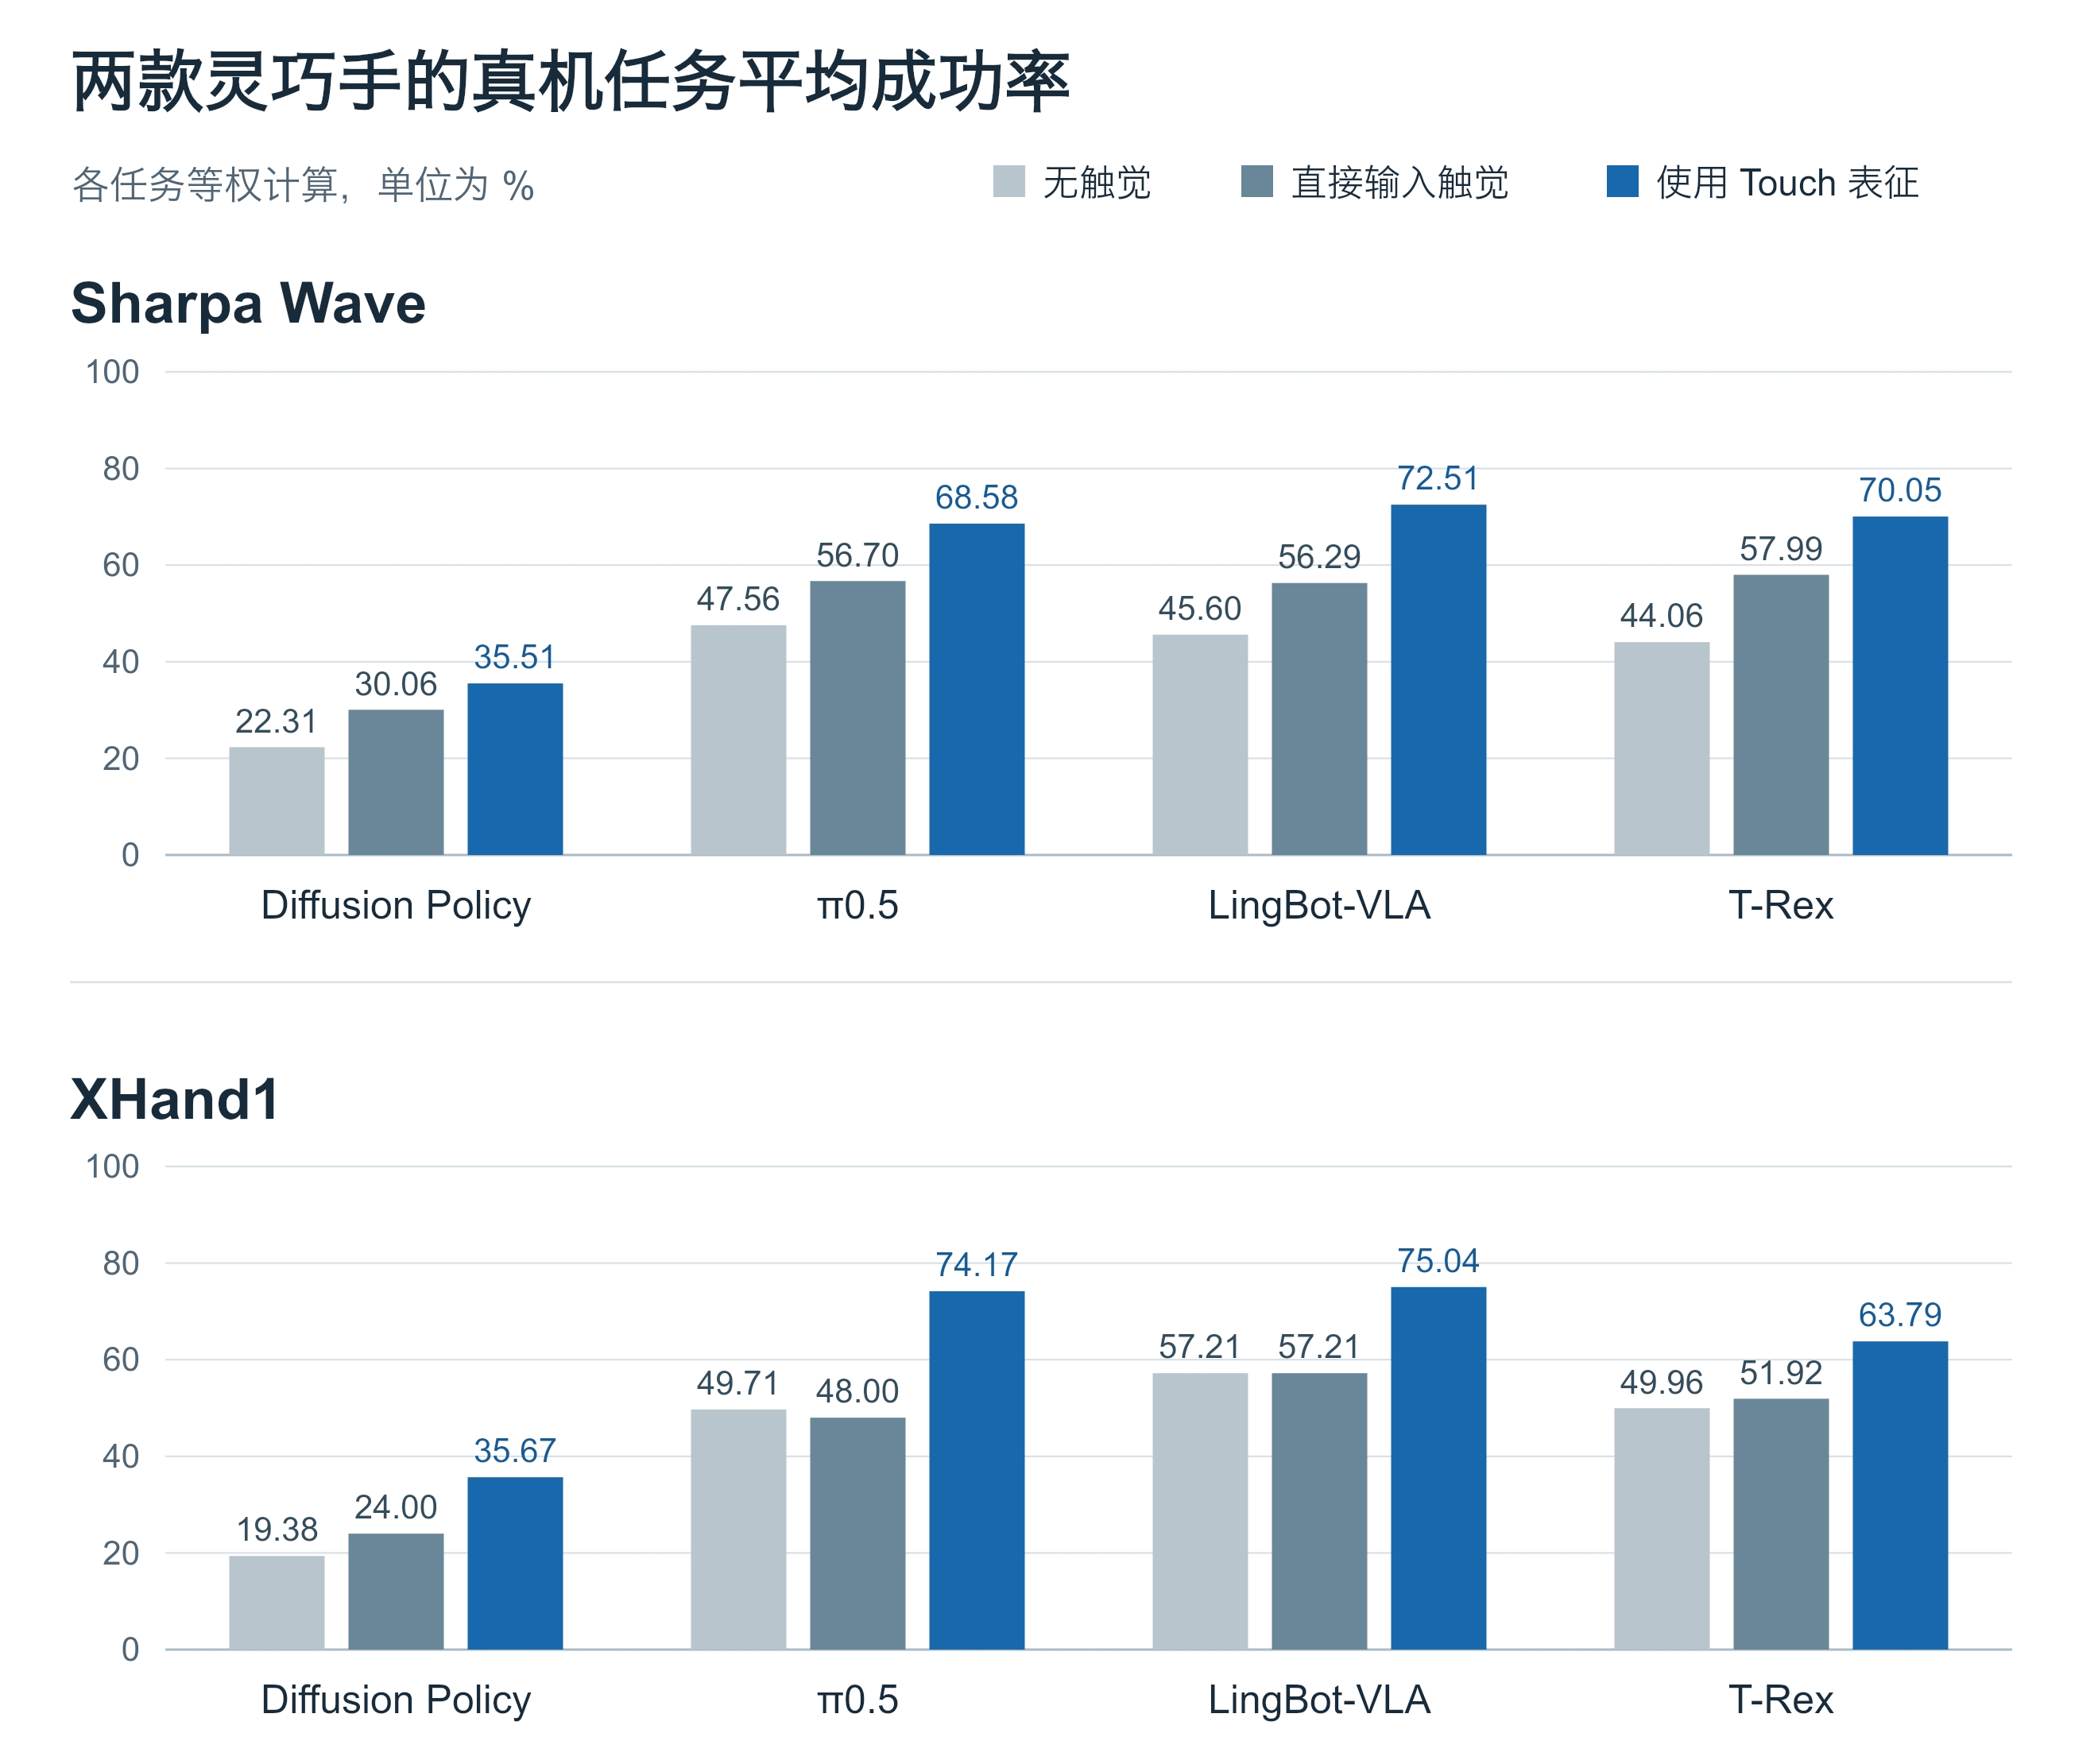
Das heißt: Während die Branche noch darüber streitet, wie Taktilität umzusetzen ist und ob es sich lohnt, hat Lingbo sie bereits von einem „Problem der Sensorauswahl“ zu einem „Problem der Basiskapazität“ gemacht. Nach diesem Schritt geht es nicht mehr um die Frage, ob Taktilität benötigt wird, sondern darum, ob das „Gehirn“ nach der Integration der Taktilität ausreichend leistungsfähig ist.
Warum hält Lingbo an dem „embodied-nativen“ Konzept fest, während Grundmodelle mit voller Kraft voranschreiten?
Nachdem die Bedeutung der Taktilität bekannt ist, könnte man meinen: Wenn man dem Grundmodell einfach taktile Informationen zuführt, ist die erfolgreiche Implementierung von Robotern bereits sichergestellt. Das ist ein großer Irrtum.
Beispielsweise gibt es Akteure, die allgemeine große Modelle direkt als fertiges „Gehirn“ verwenden, dann Bewegungsdaten und taktile Informationen hinzufügen, um schnell Ergebnisse zu erzielen. Diese Akteure verfolgen eine sehr praktische Strategie: Anstatt viel Geld in die Eigenentwicklung eines eigenen Gehirns zu investieren, schließen sie sich direkt an bestehende Lösungen an. Andere gehen einen etwas vorsichtigeren Weg: Sie nutzen die Stärke des Grundmodells für semantische Aufgaben, übernehmen aber die physische Intelligenz nicht blind von außen.
Im Gegensatz zu all diesen Ansätzen hat Lingbo einen längeren, nachhaltigeren und gründlicheren Weg gewählt: Es hält an der Entwicklung von embodied-nativen Modellen fest. Das oben erwähnte taktile Modell ist lediglich einer der Sinneskomponenten in Lingbos Matrix von Gehirnmodellen.
In den vergangenen Jahren hat die LingBot-Familie von Lingbo bereits einen umfassenden embodied-nativen Entwicklungsfaden aufgebaut, der neben der Taktilität auch räumliche Wahrnehmung, Weltenvorhersage, Befehlsverständnis und Bewegungserzeugung abdeckt.
Nach Ansicht von Shen Yujun, Chefwissenschaftler von Lingbo, bestehen mindestens drei Kluften zwischen Grundmodellen und der realen Welt.
Erstens die Datenkluft. Genau wie ein Mensch nicht dadurch, dass er Zehntausende Male Federer beim Tennisspielen zuschaut, selbst zu Federer werden kann. Die Daten im Internet sind reichlich und kostengünstig, aber die Daten der realen Welt sind viel vielschichtiger: Wie viele Newton Kraft man beim Greifen eines Tennisballs aufwenden muss, wie sich Handgelenk und Fingerkuppe je nach Flugbahn des Balls anpassen. Diese Daten existieren nur in realen Kontakten und praktischen Erfahrungen.
Zweitens pausiert die physische Welt nicht. Bei genauer Beobachtung stellt man fest, dass Fable 5.2 zwar über starke Fähigkeiten zum Denken und zur Aufgabenzerlegung in simulierten Umgebungen verfügt, aber die tatsächliche Ausführungsgeschwindigkeit sehr gering ist. Das Originalvideo von GPT-6 Astra dauerte zuvor sogar ganze drei Stunden. Echte Roboter erfordern Reaktionen im Millisekundenbereich, während große Cloud-Modelle mehrere Minuten für die Planung einer einzigen Bewegung benötigen – das führt in der Praxis längst zu Problemen.
Drittens führt das einfache, unkontrollierte Hinzufügen der neuen taktilen Modalität zum Grundmodell nicht unbedingt zu 1+1>2. Ein Beispiel aus internen Tests von Lingbo: Beim Reißverschlussziehen mit Sharpa Wave lag die Erfolgsrate ohne Eingabe von taktilen Modalitäten bei 39 %. Wenn man die taktilen Informationen unkontrolliert hinzufügte, sank die Erfolgsrate direkt auf 15 % – die Taktilität wurde zu „verunreinigten Daten“, die das Modell störten.
Daher schlägt Lingbo entgegen dem gängigen Konsens die Strategie der „Embodied-Nativität“ vor: Ein idealer Roboter ist nicht „ein intelligentes großes Grundmodell, das mit taktiler Modalität und Roboterarmen kombiniert wird“, sondern muss bis ins Detail durchdacht sein: Die semantische Intelligenz verwurzelt in der digitalen Welt, und die physische Intelligenz hat ebenfalls ihre eigenen Wurzeln – sie beherrscht Daten aus der realen Welt, verfügt über eigene Sinnesorgane und eigene Vor-Trainingsverfahren.
In den vergangenen Jahren der stillen Entwicklung hat Lingbo mit Lingbo Brain 2.0 einen vollständigen nativen Technologie-Stack aufgebaut. Der Begriff „nativ“ bedeutet hier, dass die Fähigkeiten für Sprache und Bild allgemeiner großer Grundmodelle nicht einfach auf Roboter übertragen werden, sondern dass ein vollständiges System von embodied-nativen Modellen aufgebaut wird, das sich auf Wahrnehmung, Verständnis und Handeln in der physischen Welt konzentriert.
Laut Lingbo besteht die räumliche Wahrnehmungsschicht in Lingbo Brain 2.0 aus LingBot-Vision und Depth 2.0. Dadurch kann der Roboter nicht nur erkennen,