Eine weitere Kette von „Codes“ von Lisa Su für AMD
Anfang November hat AMD einen beeindruckenden Bericht für das dritte Quartal vorgelegt: Das Umsatzvolumen des Rechenzentrumsgeschäfts erreichte in einem einzelnen Quartal 8,546 Milliarden US-Dollar, was einem Anstieg von 97 % im Vergleich zum Vorjahr entspricht und einen Umsatzanteil von 64 % ausmacht – AMD ist damit offiziell in die „Rechenzentrums-Ära“ eingetreten.
Die beiden zentralen Geschäftslinien, die die „Rechenzentrums-Ära“ von AMD stützen, sind die Instinct-GPU-Serie und die EPYC-Prozessoren.
Dr. Lisa Su, Vorsitzende des Vorstands und Chief Executive Officer von AMD, erklärte in der Leistungserklärung, dass die Nachfrage nach Instinct-GPUs und EPYC-Prozessoren weiterhin stark ist. Mit der Ausweitung der Produktion von Helios-Ganzschrank-Systemen und „Venice“ (der sechsten Generation von EPYC) wird sich das Wachstum im vierten Quartal noch beschleunigen.
Auf dem Techniktag „AMD In Depth“ am 4. November nach lokaler US-Zeit haben die Verantwortlichen von Geschäftslinien wie EPYC detailliert die neuen Funktionen der EPYC-Produktlinie in diesem Jahr vorgestellt, sowie den gesamten Verlauf des Server-CPU-Chipgeschäfts in den letzten acht Jahren – von null auf eins, mit schrittweiser Leistungssteigerung, bis hin zum endgültigen Eintritt von AMD in die „Rechenzentrums-Ära“.
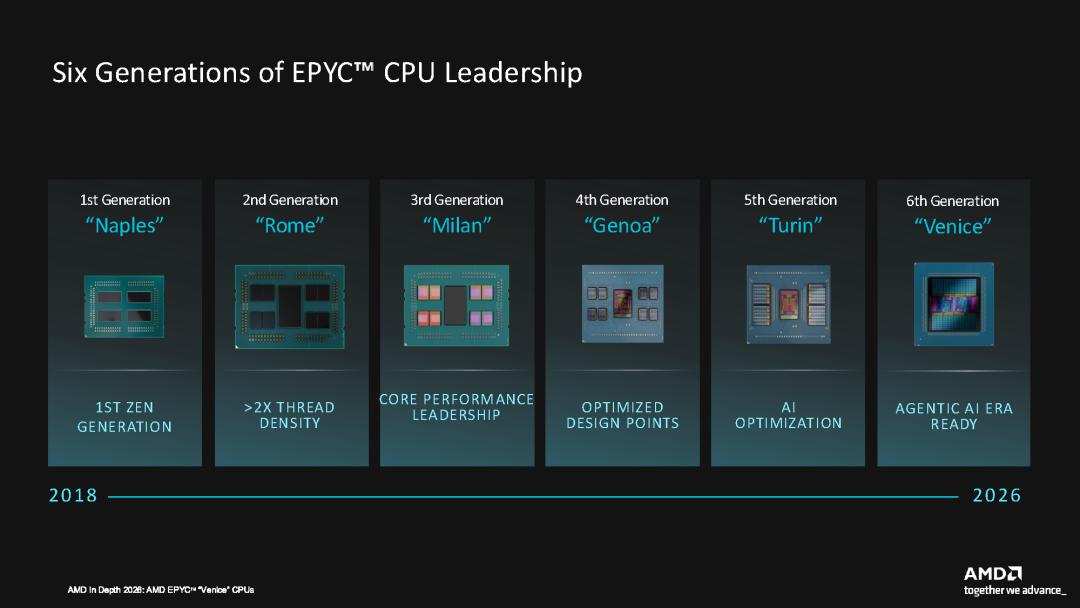
Entwicklungsdiagramm der sechsten Generation von EPYC aus offiziellen AMD-Materialien: Von Naples im Jahr 2018 bis Venice im Jahr 2026.
Nach den von AMD veröffentlichten Daten hat sich der Durchsatz pro einzelnem SoC von Naples im Jahr 2018 bis zu Venice in diesem Jahr um etwa das 20-fache erhöht.
Die sprunghafte Leistungssteigerung hat zu einem starken Anstieg der Einnahmen aus dem Rechenzentrumsgeschäft geführt. „Zu Beginn des Jahres lag der Marktanteil von Server-CPUs noch etwas über 40 %, jetzt liegt er im mittleren Bereich von 40 %, und jede Woche wechseln neue Kunden zu EPYC“, eröffnete Madhu Rangarajan, Vice President of Server Products bei AMD.
Dan McNamara, Senior Vice President von AMD und General Manager der Abteilung für Computing und Enterprise-KI, erklärte, dass die Einnahmen aus dem Unternehmens- und Cloud-Bereich sich im Vergleich zum Vorjahr verdoppelt haben: „Die fünfte Generation Turin ist die Generation von EPYC mit der schnellsten Produktionssteigerung in der Geschichte von EPYC.“
In der Analyse nach der Veröffentlichung der Finanzergebnisse durch CNBC wird darauf hingewiesen, dass AMD durch die Erfahrung im Ganzschrank-Design und bei Server-CPUs zu einer „zweiten Bezugsquelle“ in der KI-Rechenleistungslieferkette großer Technologieunternehmen wird.
In der Vergangenheit haben GPUs den Großteil der Aufmerksamkeit für den Bedarf an Rechenleistung auf sich gezogen. Jetzt möchte AMD an einem Techniktag detailliert die Rolle erläutern, die CPUs in KI-Rechenzentren im Zeitalter von Modellen und Agenten spielen, und warum sie ebenfalls der Motor sind, der AMD in die „Rechenzentrums-Ära“ treibt.
01 Eine CPU, aufgeteilt in vier Plattformen
Die sechste Generation von EPYC mit dem Codenamen Venice, Modellreihe 9006, teilt sich die Zen 6-Architektur. Sie wird nach Stromverbrauch, Arbeitsspeicher, IO und Cache in Venice 9006 SP7, Venice 9006 SP8, Venice-X 9006X SP7 und Verano 9006 LP unterteilt, die unterschiedlichen Plattformen für Leistung, Unternehmen, HPC usw. entsprechen.
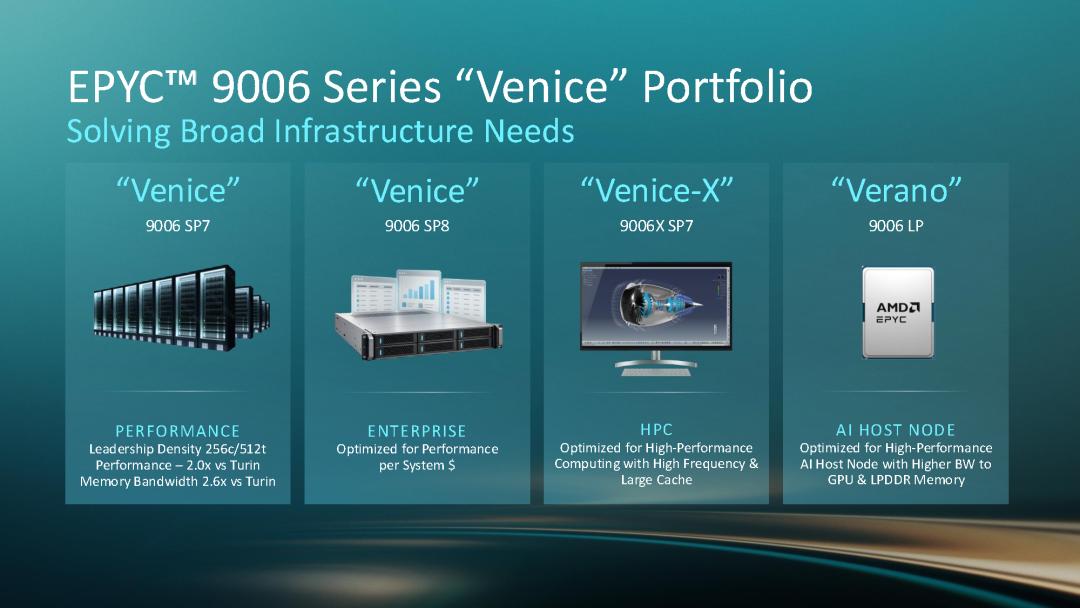
In offiziellen Materialien wird die sechste Generation von EPYC in vier Plattformen unterteilt, die den Bereichen Leistung, Unternehmen, HPC und KI-Head-Knoten entsprechen.
Das erste ausgelieferte Produkt ist Venice SP7, das auch das Flaggschiff dieser Generation ist. Bei Verwendung von Zen 6c-Kernen sind maximal 256 Kerne und 512 Threads möglich, bei Verwendung von hochfrequenten Zen 6-Kernen maximal 96 Kerne und 192 Threads. Es unterstützt 16 Kanäle DDR5 und MRDIMM 12,8 GT/s, die vom Hersteller angegebene Spitzenbandbreite des Arbeitsspeichers beträgt 1,6 TB/s, was etwa dem 2,6-fachen der 614 GB/s der fünften Generation entspricht. Es gibt 96 PCIe-Gen-6-Kanäle bei Ein-Sockel-Systemen und maximal 128 Kanäle bei Zwei-Sockel-Systemen, die alle CXL 3.1 unterstützen. Der Sockel misst 76 × 80 Millimeter, die Leistungsaufnahme reicht von 400 W bis 600 W.
SP8 ist auf Unternehmen, Speicherung, Edge und Telekommunikation ausgerichtet, die Anzahl der Kerne reicht von 8 bis 128. Die Anzahl der Speicherkanäle wird auf 8 halbiert, aber pro Kanal können zwei DIMMs eingesetzt werden. Die Anzahl der PCIe-Gen-6-Kanäle ist sogar noch höher (128 Kanäle bei Ein-Sockel-Systemen, maximal 192 Kanäle bei Zwei-Sockel-Systemen). Der Sockel wird auf 62,5 × 80 Millimeter verkleinert, die maximale Leistungsaufnahme beträgt 400 W, die Auslieferung ist für die erste Hälfte des Jahres 2027 geplant.
AMD gab bekannt, dass für SP7 und SP8 zwei unterschiedliche IO-Dies verwendet werden, die den Anforderungen der beiden Märkte an Rechenleistung und IO entsprechen. Diese differenzierte Aufteilung ergibt sich aus den unterschiedlichen Anforderungen der Kunden: Die Kunden wünschen sich ein Gleichgewicht zwischen Leistung pro System-Dollar, nicht Spitzenrechenleistung.
Zwei weitere Produkte folgen in der zweiten Hälfte des Jahres 2027: Venice-X 9006X SP7 und Verano 9006 LP.
Venice-X unterstützt 3D V-Cache – ein zusätzlicher SRAM-Cache-Die wird vertikal über dem CPU-Rechen-Die gestapelt, die beiden Schichten werden verbunden und gekapselt. Es unterstützt maximal 96 Kerne und 1152 MB L3-Cache, die Frequenz erreicht weiterhin 5,3 GHz, es ist kompatibel mit dem SP7-Sockel und zielt auf rechenintensive technische Berechnungen wie EDA und CFD ab, die viel Cache benötigen. Verano ist ein dedizierter KI-Head-Knoten, der auf 24 Kanäle LPDDR5X und vor Ort austauschbare SOCAMM-Module umgestellt wird, unterstützt maximal 192 Kerne und hat das Kernziel, die Verbindungsbandbreite zwischen CPU und der eigenen GPU zu erhöhen.
„Man kann nicht ein, zwei oder drei SKUs verwenden, um KI zu unterstützen, das würde den Kunden nicht das bieten, was sie wirklich brauchen“, erklärte Dan McNamara zur Erklärung der Aufteilung der SKUs vor dem Hintergrund unterschiedlicher Kundenanforderungen.
Nach Ansicht von Ravi Kuppuswamy, Senior Vice President of Computing and Enterprise AI bei AMD, kann die Agenten-Pipeline in verschiedene Phasen unterteilt werden, viele Abschnitte erfordern CPU-Unterstützung, und die Abhängigkeit von der CPU ist unterschiedlich: „Agenten-KI ist keine einzelne Last, und keine einzelne CPU kann diese Last alleine bedienen.“
Diese Differenzierung der Nachfrage wird am OEM-Partnertisch noch deutlicher.
Am zweiten Tag des Techniktags erwähnte der OEM-Runde, die von Derek Dicker, Vice President of AMD und Leiter der Enterprise Business Unit, moderiert wurde, nicht nur die Unterschiede zwischen KI-Budgets und herkömmlichen Datenbanklasten, sondern betonte auch, dass die beiden nicht in getrennten Infrastrukturpools aufgeteilt werden sollten.
„Nicht jeder braucht einen Ferrari. Wenn ich einen Schulbus brauche, brauche ich einen Schulbus. Man muss einen Weg finden, damit Ferrari und Schulbus gut zusammenarbeiten“, sagte John Carter, Vice President of Mainstream Computing bei HPE.
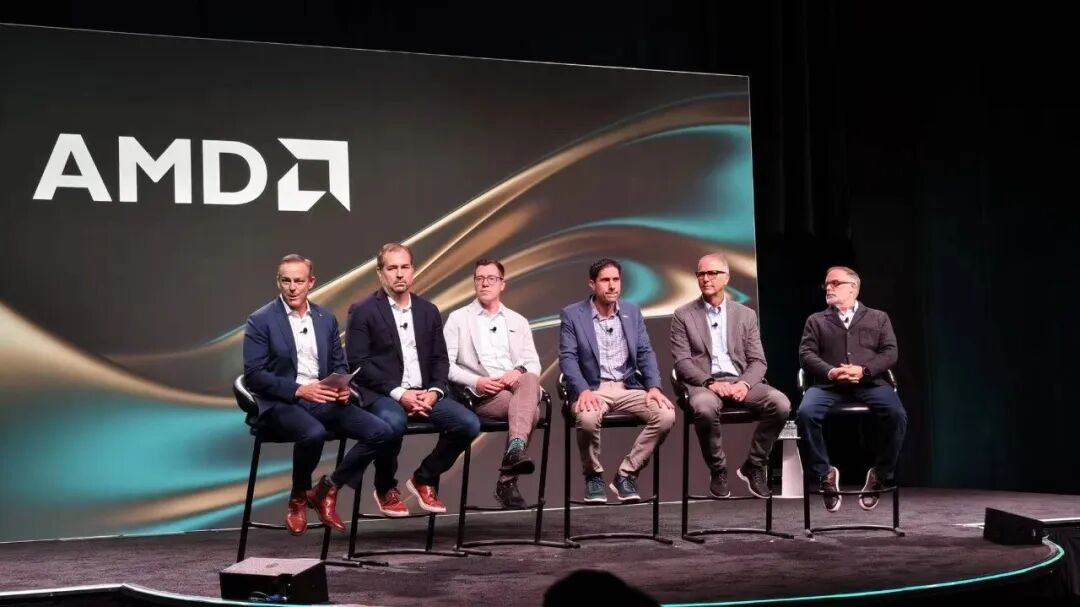
Von links nach rechts: Derek Dicker, Vice President of AMD und Leiter der Enterprise Business Unit, David Schmidt, Vice President of Computing Infrastructure bei Dell, John Carter, Vice President of Mainstream Computing bei HPE, Scott Patty, Leiter des Produktmanagements der Lenovo Infrastructure Solutions Group (ISG), Mike McNerney, Vice President of Marketing und Cybersicherheit bei Supermicro, Todd Brennan, Leiter des Datenzentrumsproduktmanagements bei Cisco
Mike McNerney, Vice President of Marketing und Cybersicherheit bei Supermicro, gab bekannt: Basierend auf der vorhandenen Plattform plant das Unternehmen 20 SKUs. Einige Kunden benötigen mehr IO zum Anschluss von GPUs und sind bereit, Arbeitsspeicher einzusparen, andere wünschen sich dagegen den Arbeitsspeicher mit maximaler Kapazität. Scott Patty von Lenovo erklärte ebenfalls, dass derselbe SP7 sowohl zu einem hochwertigen HPC-Modell mit 100 % Flüssigkühlung ohne Lüfter als auch zu einem standardmäßigen 2U-Ein-Sockel-Server umgestaltet werden kann.
02 Was wurde bei Zen 6 geändert
„Ich werde nicht so tun, als hätte ich schon früh gewusst, dass Agenten-Rechenleistung kommen würde, aber wir haben immer daran geglaubt, dass CPUs im Software-Stack immer einen Platz haben werden“, erwähnte Mike Clark, Senior Vice President, Enterprise Fellow und Chief Architect von AMD, zu Beginn seiner Rede zu den Wetten von AMD auf dem Weg der Server-CPU-Entwicklung.
Die gesamte EPYC-Produktlinie dieser Generation basiert auf derselben Zen 6-Architektur.
Mike Clark wies darauf hin, dass die Designbeschränkungen der neuen Generation darin bestehen, dass Frequenz, IPC (Anzahl der Befehle pro Taktzyklus), Fläche und Leistungsaufnahme miteinander in Konflikt stehen: Eine Erhöhung der Frequenz reduziert die Anzahl der Vorgänge pro Zyklus und verbraucht zusätzlich Fläche und Leistung. Bei dieser Generation wird auf der neuen Grundlage von Zen 5 weiter verbreitert: 8 breite Befehlsausgabe, 6 ALUs, 4 Speichervorgänge pro Zyklus. Die Anzahl der zu verarbeitenden Befehle im Puffer wird von 6.000 auf 6.750 erweitert, der Umordnungs-Puffer von 448 auf 640, der Rückgabestapel der Verzweigungsvorhersage von 52 auf 64.
Man kann es so verstehen: Der Ansatz von AMD besteht darin, bei aufrechterhaltener Frequenz mehr Befehle zu ermöglichen, die im selben Taktzyklus gleichzeitig ausgeführt werden. Dies ist einer der Vorteile, die die Erhöhung der Transistoranzahl im 2-nm-Verfahren mit sich bringt.
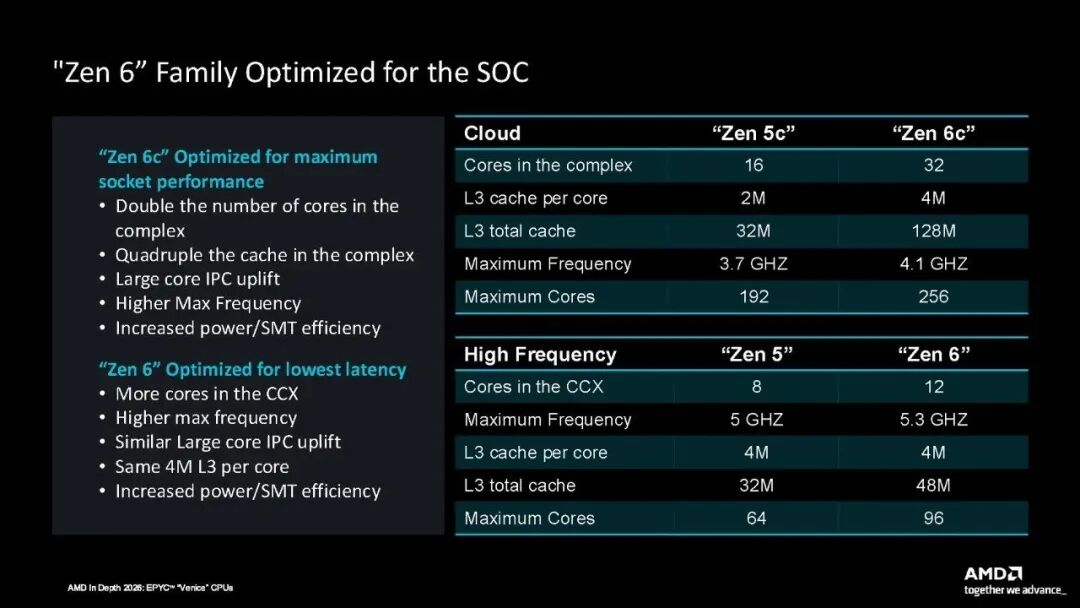
Offizieller Vergleich: Zen 6c ist für den Durchsatz pro Pfad optimiert, Zen 6 für die minimalste Latenz.
Ein CCD von Zen 6c wird von 16 Kernen der vorherigen Generation auf 32 Kerne verdoppelt, der L3-Cache von 32 MB auf 128 MB. Das CCD von Zen 6, das auf hohe Frequenzen ausgelegt ist, wird von 8 Kernen auf 12 Kerne erweitert, mit 48 MB L3-Cache. Beide CCD-Typen werden mit dem N2-Verfahren von TSMC hergestellt. Wie bereits erwähnt, verfügt Venice-X über 1152 MB L3-Cache, weil 8 CCDs jeweils auf 144 MB erweitert und summiert werden.
Bei der Frequenz wird Zen 6c von 3,7 GHz auf über 4,1 GHz angehoben, Zen 6 von 5,0 GHz auf 5,3 GHz. Bei Tests mit fester Frequenz steigt die IPC für Unternehmens- und Cloud-Lasten um etwa 20 %, für KI-Lasten um etwa 31 %.
Mike Clark betonte jedoch selbst, dass keine einzelne Zahl alle Lasten abdecken kann.
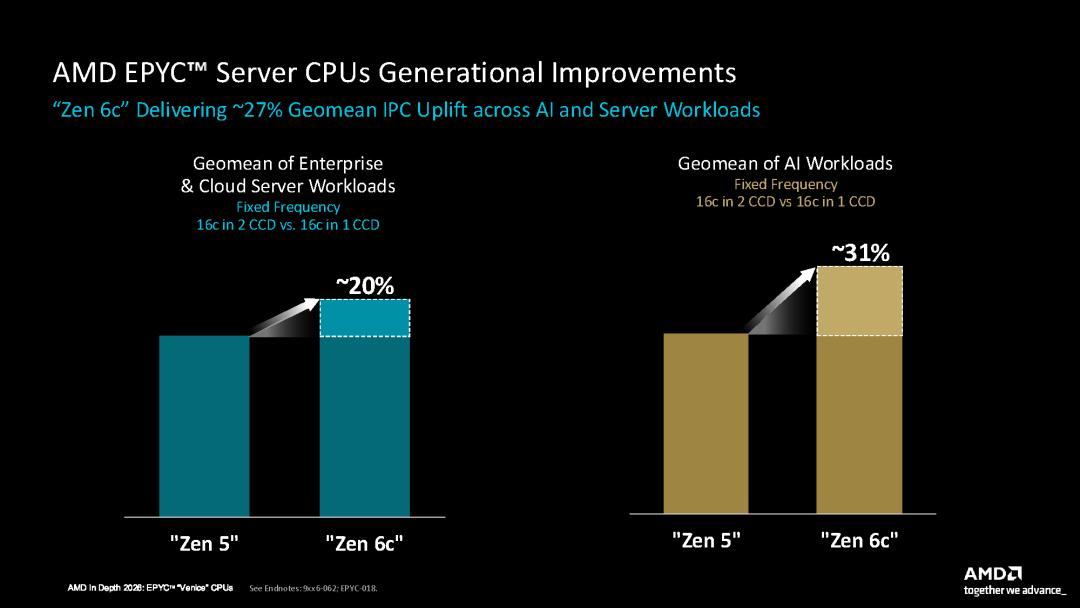
Offizieller Test mit fester Frequenz: Die IPC für Unternehmens- und Cloud-Lasten steigt um etwa 20 %, für KI-Lasten um etwa 31 %.
Die Anzahl der Kerne auf 256 zu bringen ist nicht der schwierigste Teil.
Mahesh Subramony, Senior Fellow und Corporate Vice President für Serverarchitektur bei AMD, erklärte, dass sie nicht möchten, dass Kunden alle 256 Kerne vollständig auslasten müssen, um eine anständige Leistung zu erzielen. Bei realen Lasten laufen diese Kerne selten gleichzeitig voll aus, daher muss das Leistungsbudget zwischen voller Auslastung und teilweiser Leerlaufzeit verteilt werden.
Gleichzeitig wird die gesamte Energie des Chips nicht vollständig an die Kerne verteilt: Ein Teil wird zuerst vom IO-Die, dem Speichercontroller und der Verbindung zwischen den Chips übernommen, der verbleibende Teil wird dann an die Kerne verteilt.
Zu Beginn der Architekturentwicklung erwartete AMD, dass bei vollständiger Aktivierung von 256 Kernen bei 600 W jeder Kern etwa 1,7 W erhält. Die meisten auf der Veranstaltung veröffentlichten Leistungswerte wurden unter diesen Bedingungen gemessen. Bei realen Lasten laufen jedoch oft nur 30 % der Kerne, bei unverändertem Gesamtbudget erhalten die ruhenden Kerne keine Energie, und jeder laufende Kern kann etwa 3,5 W erhalten. Die zusätzliche Energie muss sofort in eine höhere Frequenz umgewandelt werden können, daher muss Zen 6c, obwohl es sich um einen Dichtekern handelt, eine Frequenz von über 4,1 GHz erreichen.
Bei der 400-W-Klasse