AMD Zen 6, offiziell veröffentlicht, die nächste Architekturgeneration ist durchgesickert
In den ersten Jahren konzentrierte sich der Aufbau von KI-Datenzentren fast ausschließlich auf GPUs. Von der Training großer Modelle bis zur Inferenz wurden GPUs zu den am meisten beachteten Rechenchips in der gesamten Infrastruktur, während CPUs hauptsächlich Aufgaben wie Datenvorbereitung, Aufgabenplanung und Systemverwaltung übernahmen. Unter dieser Aufgabenteilung schienen Server-CPUs zeitweise nicht mehr so wichtig zu sein.
Doch mit der schrittweisen Entwicklung der KI von der Training und Inferenz großer Modelle hin zu Agentic AI ändert sich die Situation. Ein Agent empfängt nicht mehr nur Fragen und generiert Antworten, sondern muss ständig Datenbanken abfragen, APIs aufrufen, Kontext abrufen, Code ausführen, externe Tools verwenden und zwischen verschiedenen Aufgaben koordinieren. Eine große Anzahl von Vorgängen läuft nicht direkt auf der GPU ab, erfordert aber eine kontinuierliche Beteiligung der CPU.
AMD ist der Ansicht, dass dies die Rechenanforderungen von Datenzentren neu verändern wird.
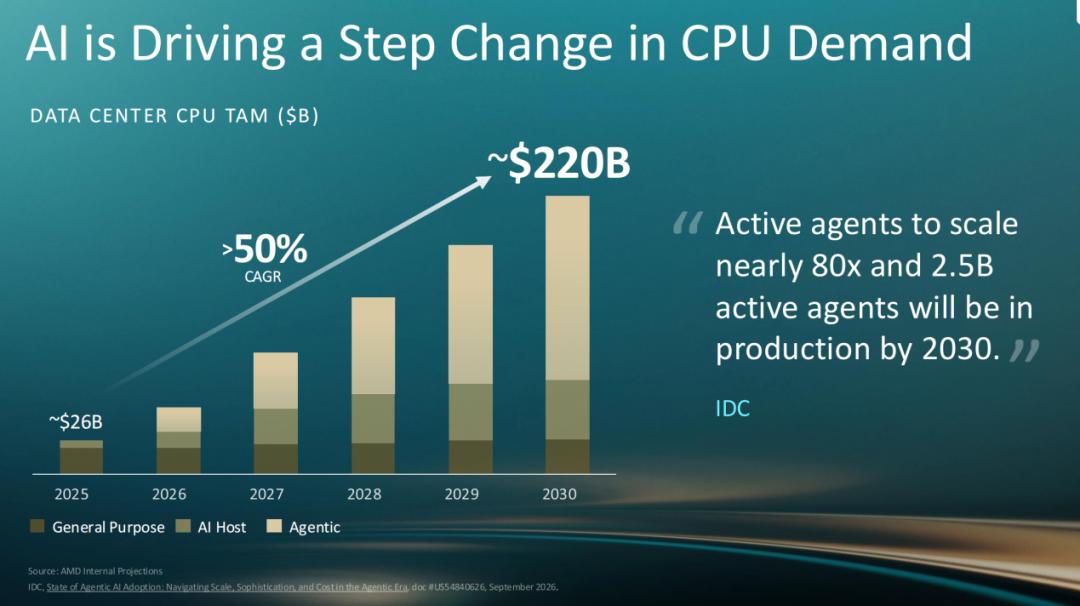
Auf der kürzlich in Las Vegas, USA, veranstalteten Veranstaltung AMD In Depth stufte AMD Agentic AI als wichtigen Treiber für das nächste Wachstum des Server-CPU-Marktes ein und prognostiziert, dass der Markt für Datenzentrums-CPUs künftig mit einer durchschnittlichen jährlichen Wachstumsrate von über 50 % wachsen wird, wobei das Marktvolumen bis 2030 voraussichtlich etwa 220 Milliarden US-Dollar erreichen wird. Die von AMD zitierten Datenprognosen zeigen zudem, dass die Anzahl der in Produktivumgebungen eingesetzten aktiven Agenten bis 2030 2,5 Milliarden erreichen wird, was einem Anstieg von fast dem 80-fachen gegenüber dem aktuellen Stand entspricht.
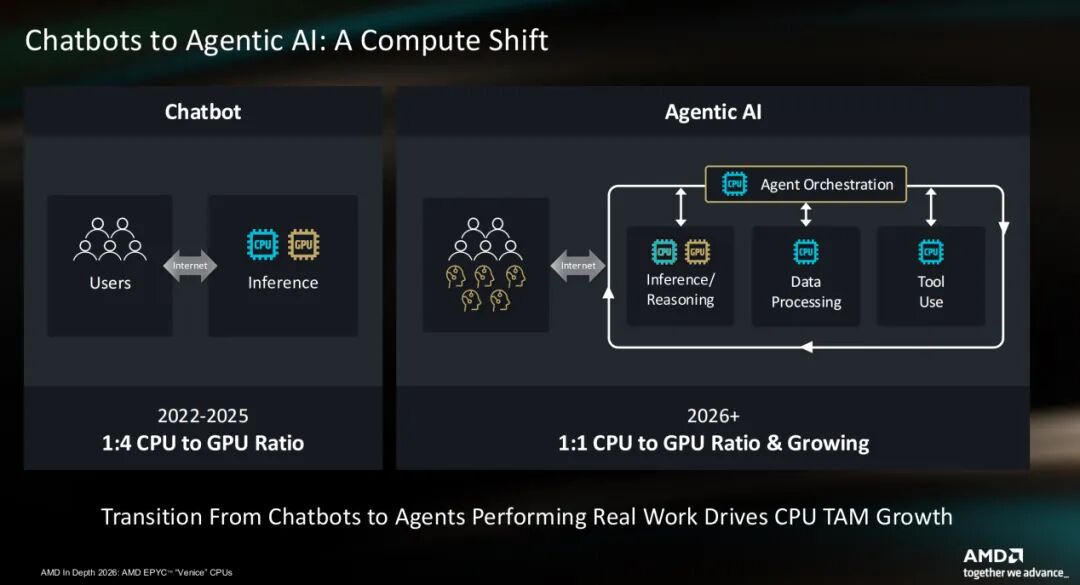
Die von AMD dargestellten Veränderungen der Rechenarchitektur sind sehr anschaulich: In der Phase, in der Chatbots im Vordergrund standen, lag das Konfigurationsverhältnis von CPU zu GPU bei etwa 1:4; nach dem Eintritt in die Agentic AI-Phase kann sich dieses Verhältnis 1:1 annähern und es gibt noch Raum für weiteres Wachstum. Mit anderen Worten: KI-Datenzentren benötigen nicht nur mehr GPUs, sondern auch mehr CPUs, um den Betrieb von Agenten zu unterstützen.
Angesichts dieses Wandels entwickelt AMD brandneue CPUs, um dieses bevorstehende Zeitalter des tiefgreifenden Wandels zu begrüßen. Die jetzt vorgestellte Zen 6-Architektur und der sechste EPYC-Prozessor mit dem Codenamen Venice sind genau die Produktausrichtung, die auf diese Veränderung abzielt.
AMD Zen 6, zwei Versionen
Wie zu Beginn des Artikels erwähnt, ist Agentic AI aus Sicht von AMD keine einzelne Rechenaufgabe. In verschiedenen Phasen können auch unterschiedliche Rechenanforderungen entstehen. Dazu gehören sowohl CPU-intensive Aufgaben als auch Anforderungen an Speicher, E/A, Sicherheit und beschleunigtes Rechnen. Dies erklärt, warum AMD wiederholt die Rolle von CPUs in der Agentic AI-Infrastruktur betont – GPUs sind für Modellinferenz und beschleunigtes Rechnen zuständig, aber damit Agenten Aufgaben wirklich erledigen können, müssen CPUs für Planung, Verwaltung von Laufzeitumgebungen, Datenzugriff und Toolaufrufe sorgen. Insbesondere wenn die Anzahl der Agenten stetig steigt, nimmt die Anzahl der gleichzeitigen Aufgaben, die die CPU verarbeiten muss, entsprechend zu.
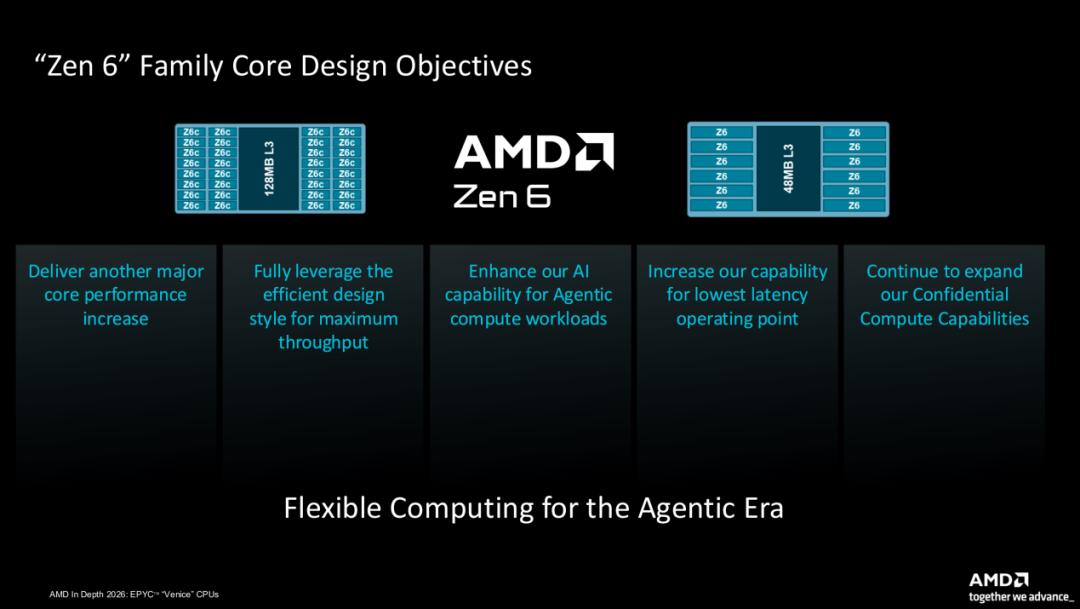
Daher hat AMD für unterschiedliche Anforderungen diesmal zwei Kerndesigns vorgestellt: Zen 6 und Zen 6c.
Wie erläutert wird, handelt es sich bei diesen beiden Kerndesigns nicht einfach um eine Abwägung zwischen Kernanzahl und Taktfrequenz, sondern sie dienen dazu, unterschiedliche Rechenanforderungen abzudecken. Aus Sicht von Agent Sandbox werden möglichst viele Kerne und Threads benötigt, um mehr Agenten gleichzeitig auszuführen; GPU-Host-Knoten legen dagegen mehr Wert auf hohe Taktfrequenz und geringe Latenz, sodass die CPU der GPU rechtzeitig Daten liefern muss, um zu vermeiden, dass teure Beschleuniger durch das Warten auf Daten ungenutzt bleiben.
Auf der Grundlage dieser Erkenntnisse positioniert AMD Zen 6 als Architektur, die hauptsächlich für Arbeitslasten ausgelegt ist, die besonders empfindlich auf Single-Core-Leistung, Taktfrequenz und Antwortlatenz reagieren. In der Vorstellung bezeichnet AMD sie als „Optimized for lowest latency“. Im Vergleich zur Vorgängergeneration Zen 5 ist die Anzahl der CCX-Kerne von 8 auf 12 gestiegen, ein einzelnes CCD integriert maximal 12 Kerne, die gesamte L3-Cache-Kapazität ist von 32 MB auf 48 MB gestiegen, wobei weiterhin 4 MB L3-Cache pro Kern beibehalten werden. Was die Taktfrequenz betrifft, hat AMD die maximale Taktfrequenz von 5,0 GHz bei Zen 5 auf 5,3 GHz angehoben. Gleichzeitig bringt Zen 6 eine deutliche Steigerung der IPC sowie Verbesserungen bei der Energieeffizienz und der SMT-Effizienz.
Dank dieses Designs eignet sich AMD Zen 6 besser für Szenarien mit hohen Anforderungen an hohe Taktfrequenz und geringe Latenz, beispielsweise GPU-Host-Knoten. Die CPU muss Aufgabenplanung und Datenvorbereitung rechtzeitig abschließen und der GPU Daten liefern, um zu vermeiden, dass die GPU aufgrund des Wartens auf die CPU ungenutzte Rechenressourcen aufweist.
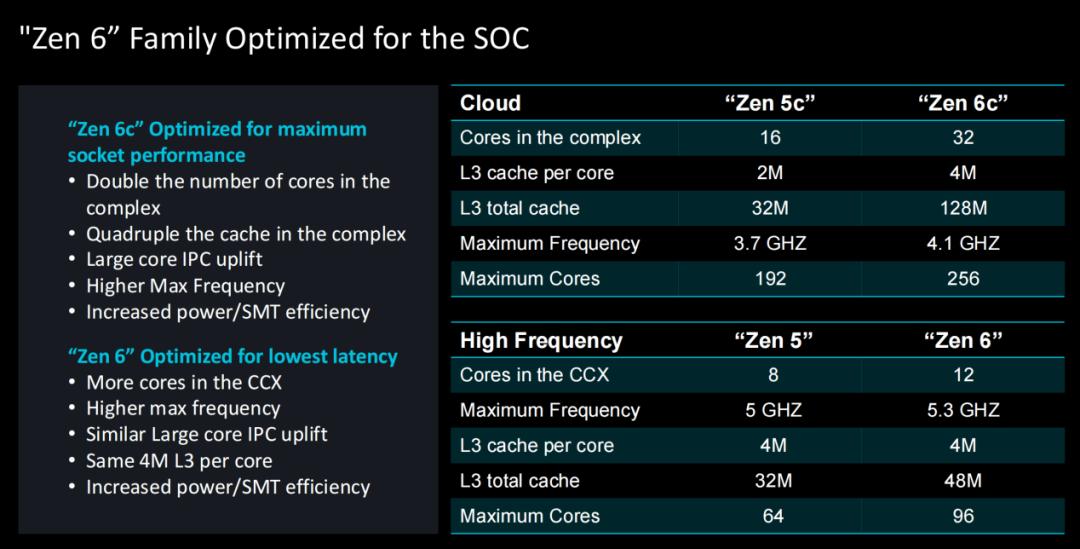
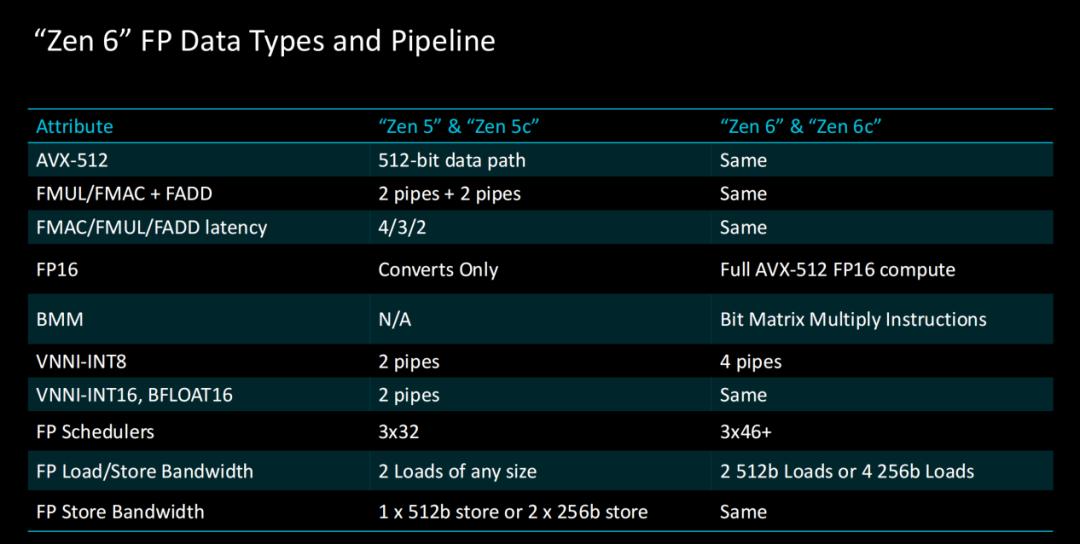
Zen 6c hingegen zielt hauptsächlich auf Cloud-Computing-Szenarien und groß angelegte Parallelrechenszenarien ab, AMD positioniert sie als „Optimized for maximum socket performance“. Wie in der Abbildung dargestellt, hat Zen 6c im Vergleich zur Vorgängergeneration Zen 5c die Anzahl der Kerne pro einzelnem CCX von 16 auf 32 angehoben, sodass sich die Kernanzahl verdoppelt; die gesamte L3-Cache-Kapazität ist von 32 MB auf 128 MB gestiegen, was dem Vierfachen der Vorgängergeneration entspricht. Gemäß den von AMD veröffentlichten Daten verfügt Zen 6c über 4 MB L3-Cache pro Kern, während Zen 5c nur 2 MB aufweist. Bei der Taktfrequenz wurde die maximale Taktfrequenz von Zen 6c von 3,7 GHz bei Zen 5c auf 4,1 GHz angehoben. AMD betont zudem die gesteigerte IPC-Leistung großer Kerne sowie Verbesserungen bei Energieeffizienz und SMT-Effizienz.
AMD gibt an, dass der Vorteil von Zen 6c darin besteht, mehr Kerne in einem einzigen Prozessor zu integrieren, wodurch die Parallelverarbeitungskapazität von Ein-Socket-Servern verbessert wird. Für Agent Sandbox, Cloud-Computing und groß angelegte gleichzeitige Aufgaben bedeutet dies, dass ein Server mehr Arbeitslasten tragen kann, sodass die Anzahl der Server und die entsprechenden Bereitstellungskosten reduziert werden.
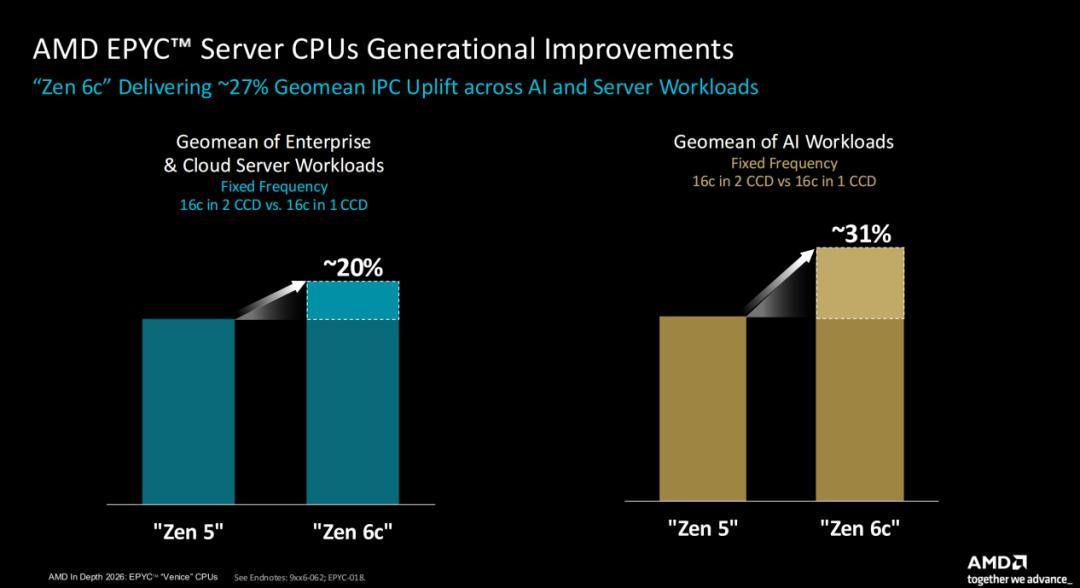
Während der Präsentation zeigte AMD die Steigerung der IPC-Leistung der Zen 6c-Architektur im Vergleich zu Zen 5. Wie in der folgenden Abbildung dargestellt, führte AMD Tests mit fester Taktfrequenz durch, wobei 16 Kerne als Bezugspunkt dienten und der Vergleich zwischen Zen 5 mit zwei CCDs für 16 Kerne und Zen 6c mit einem einzelnen CCD für 16 Kerne erfolgte. Bei Arbeitslasten von Enterprise- und Cloud-Servern liegt die geometrische durchschnittliche IPC-Steigerung von Zen 6c bei etwa 20 %. Bei KI-Arbeitslasten liegt die geometrische durchschnittliche IPC-Steigerung von Zen 6c im Vergleich zu Zen 5 bei etwa 31 %, wobei ebenfalls eine feste Taktfrequenz und 16 Kerne als Vergleichsbasis verwendet wurden.
In Kombination mit KI- und Server-Arbeitslasten liegt die von AMD angegebene geometrische durchschnittliche IPC-Steigerung von Zen 6c bei etwa 27 %. Diese Daten verdeutlichen eine wichtige Positionierung von AMD für Zen 6c: Bei der Erhöhung der Kerndichte wurde die Single-Core-Leistung nicht geopfert, sondern es wurde eine deutliche IPC-Steigerung bei verschiedenen Arten von Server-Arbeitslasten erreicht.
Der neue EPYC läutet eine neue Ära ein
Zusammen mit der Vorstellung von Zen 6 enthüllte AMD auch detailliert den sechsten EPYC-Prozessor (Codename: Venice), der mit dem 2-nm-Verfahren von TSMC hergestellt wird.
Was das Design betrifft, verwendet AMD wie gewohnt das Chiplet-Design bei Venice, aber das gesamte SoC besteht aus maximal 8 Rechen-Chiplets (CCD) und 2 E/A-Chiplets (IOD). Im Vergleich zur Vorgängerplattform hat AMD die Verbindungsart zwischen den Chiplets und das E/A-Layout weiter angepasst, um den höheren Anforderungen an Datenübertragung, Speicherbandbreite und externe Verbindungsfähigkeit nach der Erhöhung der Kernanzahl gerecht zu werden. Dabei ist das CCD für das Rechnen zuständig, während das IOD Funktionen wie Fabric, Speichercontroller, PHY, E/A-Steuerung und Sicherheit übernimmt.
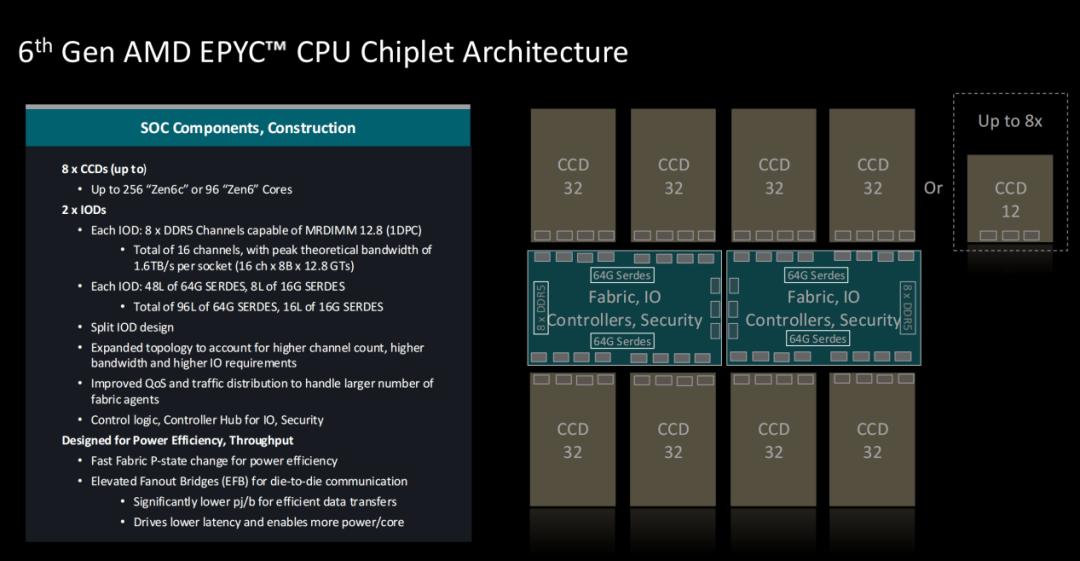
Zuerst zum CCD: Wie erläutert wird, wird diese Produktgeneration mit dem 2-nm-Verfahren von TSMC hergestellt. Wie oben erwähnt, hat AMD bei dieser Produktgeneration die erste Aktualisierung seit Zen 3 durchgeführt – ein Standard-Zen 6-CCD kann jetzt auf maximal 12 Kerne skaliert werden, während Zen 6c über 32 Kerne verfügt. Im Vergleich dazu liegt die Obergrenze der CCD-Kernanzahl bei Zen 5 und Zen 5c bei 8 bzw. 16. Darüber hinaus hat AMD die gemeinsam genutzte L3-Cache-Kapazität pro Kern für das CCD von Zen 6c verdoppelt. Da sich die Kernanzahl verdoppelt hat, ist die L3-Cache-Kapazität im Vergleich zu Zen 5c tatsächlich um das Vierfache gestiegen.
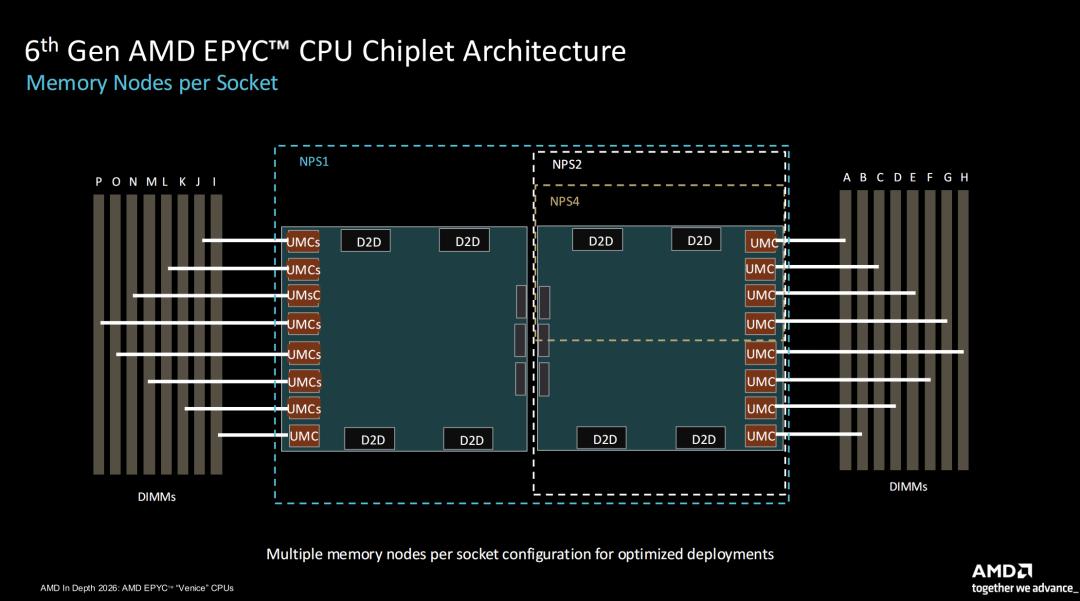
Beim E/A-Die, das im 6-nm-Verfahren hergestellt wird, verwendet AMD bei Venice ein getrenntes Design mit zwei IODs. Jedes IOD integriert 8 DDR5-Speicherkanäle, die beiden IODs bieten zusammen 16 Kanäle und unterstützen MRDIMM mit bis zu 12,8 GT/s, sodass die theoretische maximale Speicherbandbreite eines Ein-Socket-Prozessors 1,6 TB/s erreicht. Jedes IOD ist zudem mit 48 64G-SerDes und 8 16G-SerDes ausgestattet, die beiden IODs bieten zusammen 96 64G-SerDes und 16 16G-SerDes. AMD gibt an, dass die Verwendung des Zwei-IOD-Layouts hauptsächlich dazu dient, der höheren Anzahl an Speicherkanälen, größeren Bandbreiten und komplexeren E/A-Anforderungen gerecht zu werden und gleichzeitig die QoS sowie die Datenverkehrsverteilung zu verbessern.
Die Interkonnektion zwischen den Chiplets ist ebenfalls ein Schwerpunkt des Upgrades von Venice. AMD hat den Datenpfad von CCD zu IOD verbessert, um die Verarbeitungsfähigkeit für Datenantworten und schreibintensiven Datenverkehr zu erhöhen, und gleichzeitig die Anzahl der Ports erhöht, um die Bandbreite und die Datenfreigabefähigkeit zu verbessern. Darüber hinaus verwendet Venice Elevated Fanout Bridges (EFB) für die Die-zu-Die-Kommunikation. AMD gibt an, dass diese Methode den Energieverbrauch pro Einheit bei der Datenübertragung zwischen Chiplets senken und die Latenz weiter reduzieren kann, sodass mehr Leistungsspielraum für die Prozessorkerne frei wird. Die Plattform verwendet gleichzeitig die fünfte Generation von Infinity Fabric und unterstützt schnellere Fabric-P-State-Umschaltungen, um die Energieeffizienz zu verbessern.
Neben den architektonischen Innovationen gibt es bei der AMD Venice-Serie eine weitere bedeutende Veränderung: Statt einer einzigen Plattformstrategie werden zwei Plattformen SP7 und SP8 mit unterschiedlichen physischen Schnittstellen eingeführt, und es werden die beiden untergeordneten Produktreihen 9006X (Venice-X) und 9006 LP (Verano) weiter ausgebaut, um unterschiedliche Anforderungen zu erfüllen.
