Google wird verklagt, der Gerichtshof der Europäischen Union zieht erstmals eine klare Trennlinie: Die „Eingabe“ im Rahmen von KI ist rechtmäßig, die „Ausgabe“ kann eine Urheberrechtsverletzung darstellen.
In den letzten zwei Jahren drehten sich fast alle Urheberrechtsstreitigkeiten um generative KI ausschließlich um die „Trainingsphase“. Verleger, Schriftsteller, Fotografen und Musiker fordern wiederholt von der KI eine Klärung: Wurden meine Werke heimlich in das Training der großen KI-Modelle aufgenommen? Diese Debatte prägte die grundlegende Erzählung von wegweisenden Fällen wie Bartz gegen Anthropropic, Thomson Reuters gegen ROSS und New York Times gegen OpenAI und brachte eine ganze Reihe von Gegenmaßnahmen hervor, darunter Lizenzverhandlungen, kollektive Verwaltungsmechanismen und maschinenlesbare Opt-out-Vereinbarungen.
Aber mit dem Eintritt in das Jahr 2026 sind hochwertige öffentliche Textkorpora von KI-Modellen praktisch vollständig durchsucht worden, und der Nutzen der weiteren Anhäufung von Korpora nimmt ab, Die Berührungspunkte zwischen KI und Urheberrecht verlagern sich auf den „Ausgabeprozess“. Wenn Nutzer Fragen an generative KI stellen, durchsucht das System Echtzeit-Internetinhalte, fügt Fragmente des Originaltexts in den Kontext ein und generiert die Antwort nach einer Neukombination. Dieser Vorgang wird als „Retrieval-Augmented Generation“ (RAG) bezeichnet. Die Nutzer erhalten eine „Zusammenfassung“, die ihre aktuellen Anforderungen bestmöglich erfüllt, während die Verleger einen Klick, eine Werbeeinblendung und die Beziehung zum Leser verlieren, die ihnen eigentlich zustünden.
Am 3. November 2026 veröffentlichte Maciej Szpunar, Generalanwalt des Gerichtshofs der Europäischen Union (EuGH), eine unverbindliche Stellungnahme zu dem ersten generativen KI-Urheberrechtsfall, der diesem Gericht vorgelegt wurde – dem Fall Like Company gegen Google. Die zentrale Feststellung lautet:
Das KI-Training mag rechtmäßig sein, die Ausgabe kann aber urheberrechtsverletzend sein.
I. Der Fall LikeCompany: Das System des EuGH trennt zum ersten Mal konsequent zwischen „Eingabe“ und „Ausgabe“
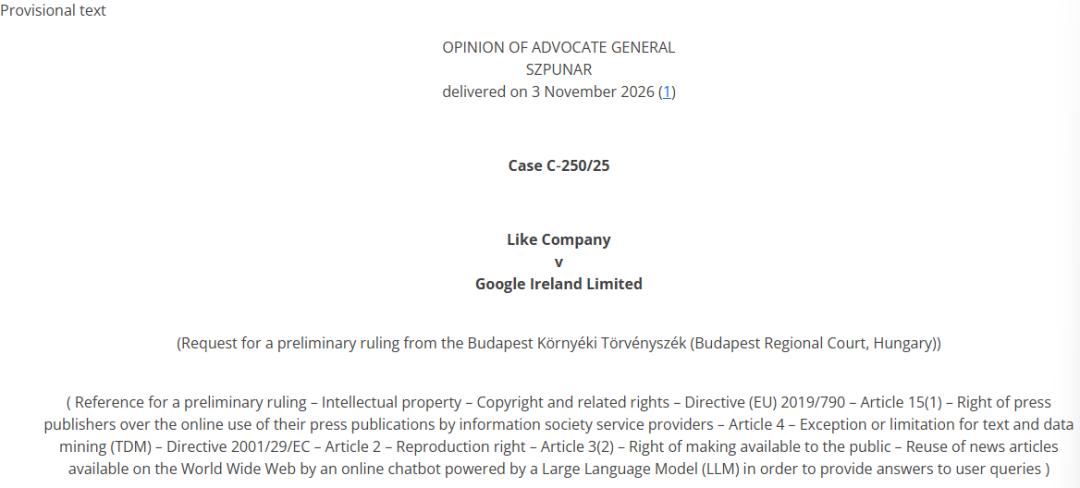
Der Fall selbst ist nicht besonders kompliziert. Der ungarische Verleger LikeCompany wirft Googles Gemini vor, bei der Beantwortung von Nutzerfragen in Echtzeit auf seine Nachrichtenartikel zuzugreifen und Zusammenfassungen zu erstellen, die dem Originaltext sehr ähnlich sind, sodass die Notwendigkeit für Nutzer entfällt, die ursprüngliche Website zu besuchen. Die Verteidigung von Google folgt der üblichen Argumentation: Das Modell lernt lediglich Sprachregeln, die Ausgabe ist ein originärer Ausdruck; die Verleger haben bereits über Kontrollmechanismen ein Wahl- und Opt-out-Recht.
Szpunar zerlegt den Fall in zwei Ebenen und sorgt bewusst dafür, dass sich die beiden Ebenen nicht gegenseitig überdecken.
Zuerst geht es um die Trainingsphase: Die Empfehlung lautet, die Angelegenheit nicht anzunehmen, statt sie direkt zuzulassen.
Die erste Ebene betrifft das Training. Szpunar ist der Ansicht, dass in diesem Fall die sachliche Grundlage fehlt, um nachzuweisen, dass die betreffenden Artikel tatsächlich in den Trainingsdatensatz aufgenommen wurden, sodass die mit dem Training verbundenen Fragen nicht zur Entscheidung angenommen werden. Gleichzeitig gibt er eine begleitende Feststellung ab: Im Rahmen der Ausnahmeregelungen für Text- und Data-Mining (TDM) ist die Verwendung urheberrechtlich geschützter Inhalte zum Trainieren von Modellen grundsätzlich zulässig – unter der Voraussetzung, dass die Inhalte rechtmäßig zugänglich sind, die Rechteinhaber keinen wirksamen Vorbehalt gemacht haben und die Entwickler technische Maßnahmen ergreifen, um ein wörtliches Abrufen zu verhindern.
Diese Ebene ist für große Technologieunternehmen tatsächlich sehr vorteilhaft. Sie entspricht der Anerkennung, dass das bloße Zuführen öffentlicher Werke an ein Modell nicht automatisch eine Urheberrechtsverletzung darstellt.
Der eigentliche Schwerpunkt liegt auf der Inferenzseite, wo Szpunar zwei Prüfkriterien aufstellt:
1. Ist die Zugriffsmethode rechtmäßig? Wenn Gemini Paywalls oder andere technische Schutzmaßnahmen umgeht, um Artikel zu lesen, entsteht auch dann keine stillschweigende Lizenz, wenn der Originaltext „öffentlich durchsuchbar“ ist. Der Generalanwalt weist ausdrücklich die Logik zurück, dass „keine Barrieren gleichbedeutend mit Zustimmung sind“ – dies ist eine direkte Ablehnung einer gängigen Branchenpraxis.
2. Stellt die Ausgabe einen „ausdrucksbezogenen Ersatz“ dar? Hier ist keine wörtliche Vervielfältigung erforderlich. Solange durch einen indirekten Vergleich die Ausdrucksform des Originalwerks erkannt werden kann und die Nutzer nach dem Lesen der KI-Antwort nicht mehr das Original öffnen müssen, kann das Recht des Nachrichtenverlegers verletzt werden. Mit anderen Worten: Das Urheberrecht schützt den konkreten Ausdruck. Sobald die KI den „konkreten Ausdruck“ neu verpackt und den Markt des Originalwerks übernimmt, wird das ausschließliche Recht des Rechteinhabers ausgehöhlt. Umgekehrt stellt die bloße Übermittlung gleicher Fakten in anderer Ausdrucksform keine automatische Verletzung dar; einzelne Wörter und extrem kurze Fragmente fallen ebenfalls nicht unter den Schutz.
Es ist hervorzuheben, dass diese rote Linie eine „Fallprüfung“ ist und keine Schlussfolgerung für diesen speziellen Fall. Szpunars Stellungnahme legt den Standard fest, aber die Tatsachen dieses Falls müssen noch vom ungarischen Gericht unter Berücksichtigung der Sachverhalte festgestellt werden.
Die Bedeutung dieser Stellungnahme liegt darin, dass sie zum ersten Mal auf der Ebene des Unionsrechts bestätigt: Die Vervielfältigung während des Trainings und die Vervielfältigung während der Inferenz sind zwei Nutzungen unterschiedlicher Art; erstere kann grundsätzlich unter die Ausnahmeregelungen für „Text- und Data-Mining“ (TDM) in der EU-Urheberrechtsrichtlinie für den digitalen Binnenmarkt (DSM) fallen, während letztere separat einer Bewertung nach dem Ausdrucksrecht unterzogen werden muss.
II. Die „Trainings-Opt-out-Token“ der vier großen US-Unternehmen
Genau eine Woche vor der Veröffentlichung der Stellungnahme zum Fall LikeCompany, am 30. Oktober 2026, kündigten OpenAI, Google, Microsoft und Anthropropic gemeinsam an, einen neuen Mechanismus für „Richtlinien-Token“ (policy token) zu unterstützen. Websites müssen lediglich eine Zeile mit der Angabe __usage_ai-training in ihre robots.txt einfügen, um alle gängigen KI-Crawler auf einmal zu verbieten, ihre Inhalte für das Training zu verwenden, ohne mehr einzeln GPTBot, ClaudeBot und Google-Extended konfigurieren zu müssen.
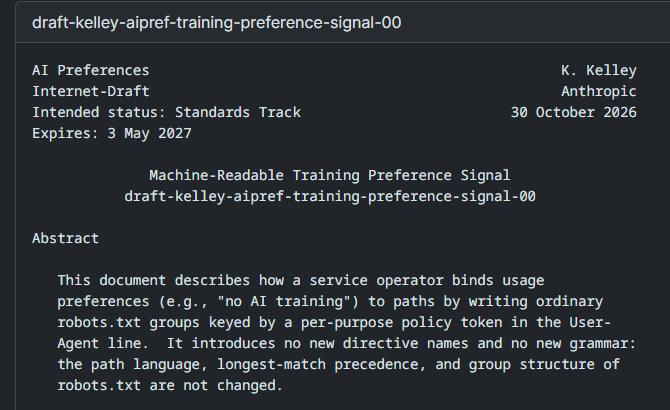
Aus Sicht der technischen Governance ist dies tatsächlich ein Fortschritt. Es integriert die verteilten Opt-out-Mechanismen zwischen den vier Unternehmen zu einem einheitlichen, maschinenlesbaren und crawlerübergreifend wirksamen Mechanismus, wodurch die Governance-Schnittstelle von „bilateralen“ Verträgen auf die Ebene öffentlicher Protokolle vorverlagert wird.
Aber der entscheidende Punkt ist, dass dieser Mechanismus nur das Training abdeckt, nicht die Suche und noch weniger den Aufruf während der Inferenz. Das heißt, die vier großen Unternehmen tauschen „Zugeständnisse auf der Trainingsseite“ gegen „Freiheit auf der Inferenzseite“ ein. Das Geschäftsmodell der KI-Branche verlagert sich derzeit von „Trainieren von Modellen“ zu „Inferenzdiensten“. Der eigentliche Wert der KI liegt darin, Inhalte von Verlegern in Echtzeit in die Antworten einzubinden. Zumindest vorerst ist die Geste des Trainings-Opt-outs kostengünstig, während KI-Unternehmen den wertvollsten Teil der Inferenz aktiv behalten.
Bemerkenswert ist, dass das EU-KI-Gesetz selbst auch ein zweigleisiges System für die urheberrechtlichen Pflichten von KI-Unternehmen vorsieht.
Gemäß Artikel 53 des KI-Gesetzes und dem „Verhaltenskodex für allgemeine künstliche Intelligenz“ (GPAI Code of Practice) müssen die Unterzeichner fünf zentrale urheberrechtliche Pflichten erfüllen. Die vierte Pflicht lautet, „die Wahrscheinlichkeit der Generierung urheberrechtlich geschützter Inhalte zu verringern“, wodurch die urheberrechtlichen Risiken auf der Inferenz- und Ausgabeseite bereits in zwingende Pflichten aufgenommen wurden. Allerdings wurde noch nicht detailliert festgelegt, wie dies im Fall von RAG umzusetzen ist.
Zusammengenommen mit dem Signal aus der Stellungnahme zum Fall LikeCompany wird die EU sich nicht mit der Einhaltung der Vorschriften auf der „Trainingsseite“ zufriedengeben, sondern als Nächstes unweigerlich prüfen, ob die ausgegebenen Inhalte urheberrechtsverletzend sind. Die Abrufprotokolle, Zählbücher für Zitate und Herkunftsverfolgungen von Ausgaben der generativen KI werden sich nach und nach von technischen Betriebsdaten zu Compliance-Beweismitteln entwickeln.
III. Der Wendepunkt bei der Urheberrechts-Compliance chinesischer Technologieunternehmen: Vom Training zur Inferenz
Die Stellungnahme zum Fall LikeCompany und die Trainings-Opt-out-Token der vier großen Unternehmen scheinen oberflächlich betrachtet juristische Auseinandersetzungen innerhalb der westlichen Märkte zu sein. Für chinesische KI-Unternehmen, die ihre internationale Expansion beschleunigen, weisen diese beiden Ereignisse gemeinsam auf einen unumgänglichen Trend hin: Der Schwerpunkt der KI-Urheberrechts-Compliance verlagert sich von der „Trainingsseite“ zur „Inferenzseite“ – diese Veränderung stellt einen direkten Compliance-Faktor dar.
In den letzten zwei Jahren konzentrierte sich die Urheberrechts-Compliance der Unternehmen größtenteils auf die Trainingsphase: Klassifizierung der Datenquellen, Aufarbeitung der Lizenzketten, Offenlegung von Trainingszusammenfassungen usw. Chinesische Modelle, die auf internationalen Märkten tätig sind, haben bei der Compliance auf der Trainingsseite bereits konkrete Fortschritte erzielt. Einige Modelle beginnen bereits, Zusammenfassungen der Trainingsinhalte gemäß dem EU-GPAI-Vorlage offenzulegen, Crawler-Kennzeichnungen zu veröffentlichen und Datenverwaltungsabläufe einzurichten. Diese Maßnahmen sind nach wie vor notwendig, da sie die grundlegende Eintrittsschwelle für den EU-Markt bilden.
Aber wenn man sich ausschließlich auf die Trainingsseite konzentriert, könnte man die kommende nächste Welle der Regulierung verpassen.
Der wichtigste Beitrag von Szpunars Stellungnahme liegt nicht darin, dass er eine endgültige Entscheidung in einem bestimmten Fall getroffen hat, sondern darin, dass er auf der Ebene des Unionsrechts zum ersten Mal die „Vervielfältigung während des Trainings“ und die „Vervielfältigung während der Inferenz“ in zwei unabhängige rechtliche Handlungen unterteilt und für letztere einen überprüfbaren Weg zur Haftungszuweisung aufzeigt. Die zugrundeliegende Logik dieses Weges lautet: Modelle können Wissen lernen, aber nicht als Ersatz für den Ausdruck fungieren; sie können Informationen abrufen, aber nicht den Markt übernehmen. Wenn die Ausgabe der KI beginnt, die Funktion des Originalwerks systematisch zu ersetzen – egal ob es sich um Nachrichtenberichte, wissenschaftliche Aufsätze oder literarische Werke handelt – werden die traditionellen Instrumente des Urheberrechts wieder aktiviert.
Gleichzeitig weichen die gemeinsam von den vier großen US-Unternehmen eingeführten Trainings-Opt-out-Token, obwohl sie ein positives Signal für die technische Governance sind, bewusst das Problem des Aufrufs auf der Inferenzseite aus. Nachdem Verleger das Training optiert haben, können ihre Inhalte weiterhin in Echtzeit abgerufen, extrahiert und in Antworten neu kombiniert werden. Diese strukturelle Asymmetrie, bei der „das Training optiert werden kann, die Inferenz aber nicht kontrollierbar ist“, wird früher oder später zum Schwerpunkt der nächsten Streitwelle werden.
Für chinesische Unternehmen bedeutet dies, dass der Compliance-Schwerpunkt ausgeweitet oder sogar verlagert werden muss. Transparenz auf der Trainingsseite ist die Eintrittskarte, aber der eigentliche Wettbewerbsvorteil könnte in der „Prüfbarkeit des Inferenzprozesses“ liegen – also in der Fähigkeit nachzuweisen, dass das Modell bei jeder Antwort genau weiß, wessen Inhalte es verwendet hat, wie viel davon und ob es dabei Grenzen überschritten hat.
Bevor detaillierte Standards für die Inferenz-Compliance eingeführt werden, sollten Unternehmen aktiv versuchen, die Forderungen der Verleger zu verstehen und darauf zu reagieren. Dies ist auch ein strategisches Fenster, das es ernst zu nehmen gilt.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Internet Law Review“, Autor: ZHANG Ying, veröffentlicht mit Genehmigung von 36Kr.