"Quasselstrippe" Fable 5.2: Anthropic hat die Preissenkung angekündigt, ich habe dem keineswegs zugestimmt.
Noch vor dem Börsengang veröffentlichte Anthropic Claude Fable 5.2 und Mythos 5.2.
Beide nutzen dasselbe Grundmodell, der zentrale Unterschied liegt in den Sicherheitsberechtigungen: Fable 5.2 richtet sich an allgemeine Nutzer und unterliegt Sicherheitsbeschränkungen im Bereich Cybersicherheit und Biowissenschaften; Mythos 5.2 steht nur geprüften Einrichtungen offen, die entsprechenden Beschränkungen sind aufgehoben, um konforme Cybersicherheits- und Lebenswissenschaftsforschungen zu unterstützen.
Die größte Verbesserung der neuen Version liegt bei langwierigen Aufgaben, insbesondere im Zusammenhang mit dem Robotertraining. Gleichzeitig ist der Token-Preis von Fable 5.2 um 20 % niedriger als der von Fable 5.1.
Zudem hat Fable 5.2 im Vergleich zu Fable 5.1 auch im Bereich Ästhetik und Design erhebliche Verbesserungen erzielt.
Innerhalb einer halben Stunde nach der Veröffentlichung von Fable 5.2 entwickelte jemand mit diesem Modell ein FPS-Spiel mit sehr detaillierter Grafik.
Dennoch veröffentlichte die unabhängige Bewertungsinstitution Artificial Analysis einen langen kritischen Text, in dem es heißt: Das Intelligenzniveau von Fable 5.2 ist tatsächlich gestiegen, der Token-Preis ist tatsächlich günstiger, aber die durchschnittlichen Kosten pro Aufgabe sind gestiegen. Am wenigsten akzeptabel für Artificial Analysis ist, dass Fable 5.2 viel „gesprächiger“ ist als frühere Versionen.
Wo genau liegt die Leistungssteigerung?
Sehen wir uns zuerst die Bewertungsergebnisse an.
RoboDojo Sim für die Robotersteuerung stieg von 27,6 % auf 64,9 %, was einem direkten Anstieg um das 2,35-fache entspricht; die Diagrammerkennung stieg von 44,8 % auf 73,4 %; die Fernberufsaufgaben stiegen von 17,9 % auf 41,3 %; das Wissenschaftsterminal stieg von 52,6 % auf 74,6 %; FrontierCode 2.0 stieg von 32,4 % auf 49,1 %; HLE mit Werkzeugen stieg von 65,6 % auf 74,2 %.
Bei der Computerbedienung (Computer Use) stieg OSWorld 2.1 nur von 83,5 % auf 89,3 %, die Verbesserung ist gering; der Wissensarbeitsindex AA-Briefcase stieg nur von 61,5 % (ELO 1669) auf 66,1 % (ELO 1785).
Mit anderen Worten: Bei langwierigen Aufgaben, die mehr Zeit in Anspruch nehmen und mehr Werkzeuge erfordern, verzeichnet Fable 5.2 einen starken Anstieg. Bei Aufgaben, die in einer einzigen Runde beantwortet werden können, gibt es fast keine Verbesserung.
Wie lang ist diese langwierige Aufgabe eigentlich?
Anthropic veröffentlichte eine Gruppe von Vergleichsexperimenten: Mit 1000 Agenten von Fable 5.2 wurde die formale Beweisaufstellung des Großen Fermatschen Satzes in fast 30 Stunden abgeschlossen. Eine unveröffentlichte frühere Version benötigte zusammen mit einem speziellen „Zusatztool“ (einem maßgeschneiderten Werkzeugplanungsframework, purpose-built harness) und der durchgehenden Anleitung durch Forscher noch 11 Tage, um die gleiche Arbeit zu erledigen.
Zudem verbrauchte Fable 5.2 nur ein Drittel der Action-Tokens dieser unveröffentlichten Version.
Bei Einsatz von 1000 Agenten von Opus 5.5 zeigte sich: Nach 18 Stunden waren 26 % erledigt, nach 30 Stunden 27 %, danach blieb die Aufgabe stecken.
Neben offensichtlichen langwierigen Aufgaben wie dem mathematischen Schlussfolgern ist RoboDojo Sim unter allen langwierigen Aufgaben-Benchmarks in der Leistungstabelle von Anthropic der Punkt mit dem größten Anstieg. Der Blogger @himanshu veröffentlichte extra einen Beitrag, um darauf hinzuweisen, dass bei Fable 5.2 insbesondere die beiden Bereiche Robotik und Proteindesign besondere Aufmerksamkeit verdienen.
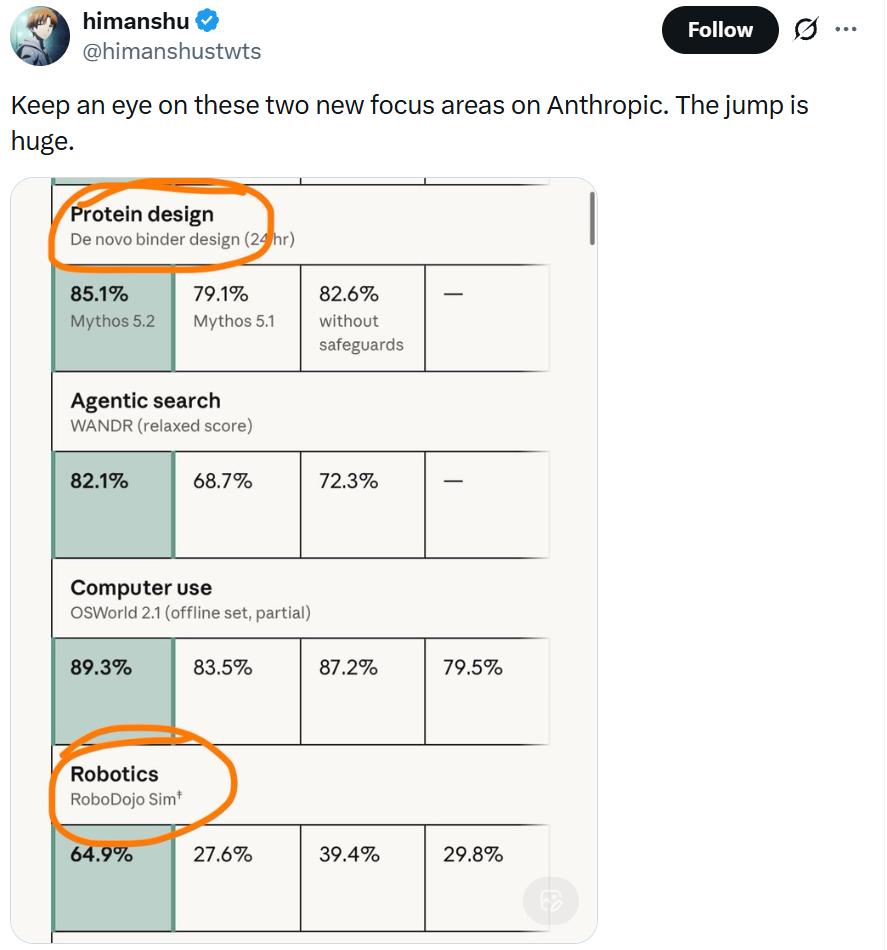
Dieser öffentliche Benchmark umfasst 42 Simulationsaufgaben und 18 Aufgaben mit echten Geräten, mit zwearmigen Robotern, wobei das Modell die Umgebung nur aus Kamerabildern auslesen kann. Die fünf Bewertungsdimensionen sind Generalisierung, Gedächtnis, Genauigkeit, langfristige Ausführung und Anweisungen mit offenem Vokabular.
Es prüft die Fähigkeit, das Bild zu beobachten, vorherige Inhalte zu merken und eine Reihe von Aktionen nacheinander auszuführen. Wenn der Roboter im Prozess „abweicht“, muss er sich selbst korrigieren.
Laut offiziellen Angaben von Anthropic übertrifft Fable 5.2 die „meisten KI-Systeme, die speziell für die Steuerung von Robotern entwickelt wurden“, da diese Aufgaben Szenarien sind, die die Roboter in der realen Welt noch nie gesehen haben.
Bisher war die allgemeine Auffassung, dass Roboter speziell trainierte Embodied-Intelligence-Modelle benötigen, um Probleme wie räumliches Verständnis und Aktionsplanung zu lösen. Fable 5.2 hingegen ist ein allgemeines Modell, jedes Unternehmen kann es direkt für das Robotertraining einsetzen. Das senkt die Trainingsschwelle für Unternehmen im Bereich Embodied Intelligence erheblich.
Auf dem Gebiet der Programmierung, auf dem Anthropic am stärksten ist, veröffentlichte der offizielle Blog ein Diagramm mit den Bewertungsergebnissen mehrerer aktuell starker großer Modelle im Benchmark FrontierCode 2.0.
Zudem führte Anthropic Bewertungen mit unterschiedlichen „effort“-Stufen von Fable 5.2 durch, das Ergebnis ist sehr überraschend, ich habe zeitweise sogar vermutet, dass bei der Dateneingabe ein Fehler passiert ist.
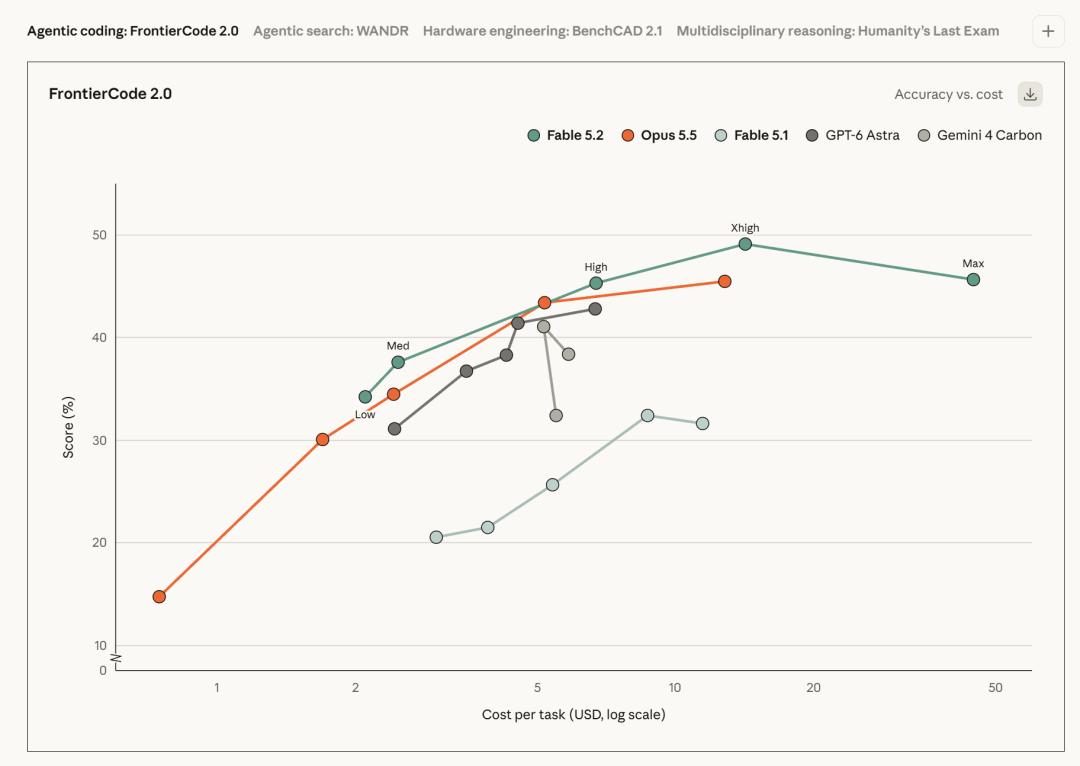
Der Xhigh-Modus von Fable 5.2 ist der weltweit stärkste, mit einer Punktzahl von 49,1 % und Kosten von 14,19 US-Dollar pro Aufgabe. Wenn der „effort“ auf die höchste Stufe „Max“ eingestellt wird, sinkt die Punktzahl hingegen auf 45,6 %, die durchschnittlichen Kosten pro Aufgabe betragen 44,70 US-Dollar.
Das bedeutet: Man verbringt mehr Zeit mit Nachdenken, verbraucht mehr Tokens, aber das Ergebnis ist schlechter als im Xhigh-Modus.
Der offizielle Grund von Anthropic lautet: Hoher „effort“ führt zu übermäßiger Überlegung.
Anthropic ist der Ansicht, dass ein höherer „effort“ bei Routineaufgaben dazu führen kann, „Kontext zu sammeln, der über den Bedarf der Aufgabe hinausgeht, und übermäßig nachzudenken“, zudem gibt es Prompt-Wörter zur Verhinderung von „übermäßiger Planung“. FrontierCode prüft, ob Patches für die Integration in echte Repositories geeignet sind, der Kontext liegt bereits im Diff vor. Wenn eine zweizeilige Reparatur zu einer umfassenden Rekonstruktion mit Begründung umgewandelt wird, ist dies in diesem Benchmark nicht qualifiziert, daher ist die Punktzahl niedriger als bei Xhigh.
Zudem erklärte Anthropic, dass der Grund auch darin liegen könnte, dass das Modell zu lange nachdenkt und die Aufgabe nicht rechtzeitig abschließt, wobei Zeitüberschreitungen zu Punkteabzügen führen.
Das größte Merkmal von Fable ist … günstig?
Der Token-Preis von Fable 5.2 ist von 10 US-Dollar pro Million Eingabe-Tokens auf 8 US-Dollar gesunken, der Ausgabepreis von 50 auf 40 US-Dollar, was einem Rückgang von 20 % entspricht; die Ausgabegeschwindigkeit ist bis zu 30 % höher als bei Version 5.1.
Der Fast-Modus wird separat berechnet: 16 US-Dollar für Eingabe, 80 US-Dollar für Ausgabe, der Preis verdoppelt sich, die Token-Generierung ist bis zu 2,5-fach schneller.
Das Lesen aus dem Cache kostet 0,20 US-Dollar, bei Fable 5 lag dieser Wert bei 1 US-Dollar.
Laut Anthropic erreicht Fable 5.2 bei aktiviertem „High“-Effort ungefähr das gleiche Ergebnis wie Opus 5.5 bei maximaler Einstellung (Max), und die Kosten pro Aufgabe betragen nur etwa die Hälfte des letztgenannten Werts.
Aber Anthropic hat nirgendwo offiziell erklärt, warum der Preis gesenkt wurde.
Woher kommen diese 20 % Preisnachlass also?
Am 12. September veröffentlichte Dario Amodei den Text „We Must Pace the Frontier“, in dem es heißt, dass eine Verlangsamung „nicht bedeutet, das Modelltraining oder den technischen Fortschritt einzustellen, sondern sicherzustellen, dass das Unternehmen genug Zeit hat, das Modell auszurichten und mit Schutzmechanismen auszustatten“.
Zehn Tage später, am 22. September, veröffentlichte Anthropic Opus 5.5 mit einem Preisrückgang von 20 % auf 4 und 20 US-Dollar und erklärte, dass die Betriebskosten um etwa 40 % niedriger sind als bei Opus 5. Etwa zwei Stunden später veröffentlichte OpenAI GPT-6 Sol und Luna, die um etwa 50 % günstiger sind als der Aktionspreis von GPT-5.6.
Der Ökonom Ara Kharazian von Ramp sagte: „Das ist keine technische Innovation, es handelt sich tatsächlich um einen Preiskrieg, der die KI-Preise drückt und gleichzeitig die eigenen Gewinnmargen senkt.“
Eine weitere Sache fällt stark auf: Die Versionsnummer lautet 5.2, während das vorherige Opus bereits auf Version 5.5 aktualisiert wurde. The New Stack erklärte: „Es ist wirklich überraschend, dass es nicht Fable 5.5 heißt.“ Anthropic hat die Versionsnummer jedoch nicht erklärt.
Weniger als eine Stunde nach der Veröffentlichung von Fable 5.2 kam die unerwartete Gegenmeldung.
Die unabhängige Bewertungsinstitution Artificial Analysis veröffentlichte einen langen Beitrag: Sie setzten Fable 5.2 auf den Intelligence Index v5, der Max-Modus erreichte 65 Punkte und belegte den ersten Platz, 6 Punkte mehr als die 59 Punkte von Opus 5.5 und etwa 15 Punkte mehr als die 49 Punkte der vorherigen Generation Fable 5.1. Es gewann in fünf von neun Bewertungen die höchste Punktzahl.
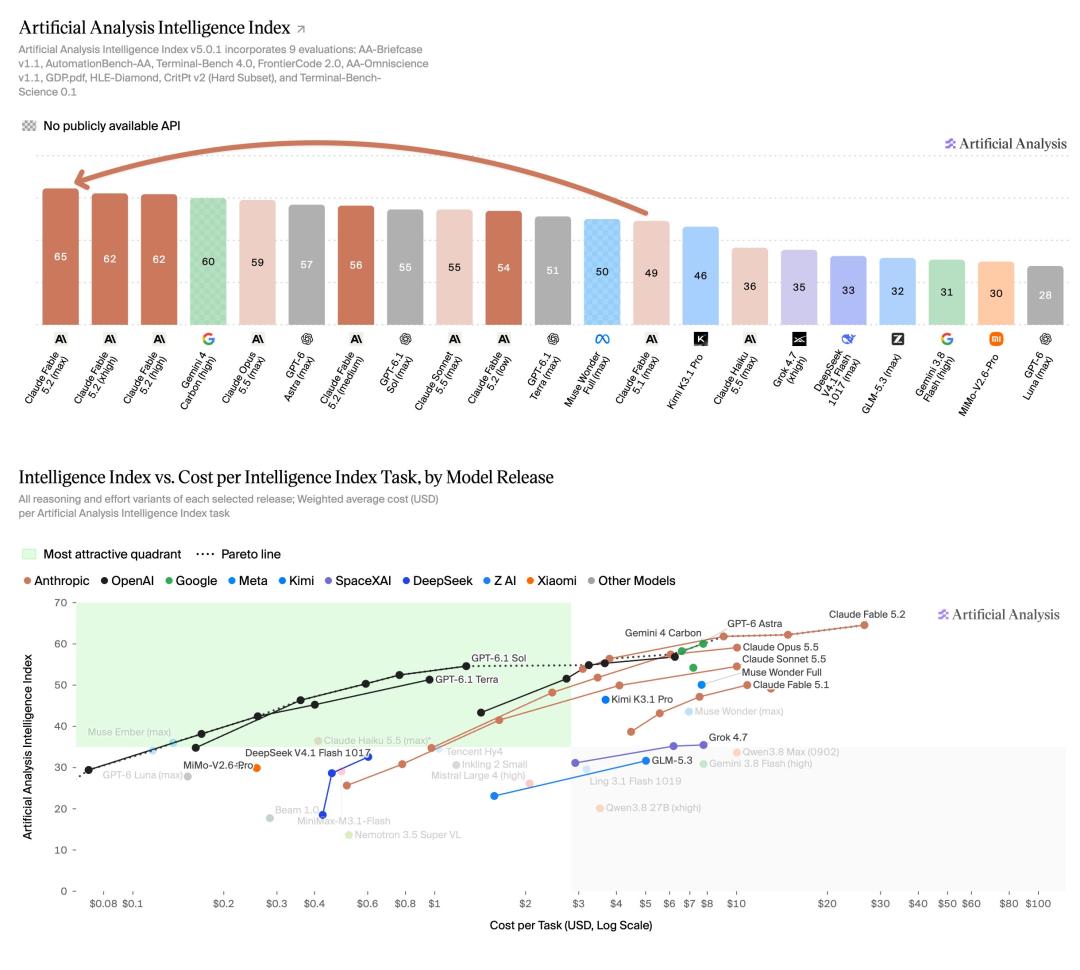
Keine Sorge, die Fable-Serie steht seit jeher für die Intelligenzobergrenze, das steht außer Frage. Artificial Analysis fuhr fort: Der Max-Modus kostet durchschnittlich 26,5 US-Dollar pro Aufgabe, das ist etwa das 2,6-fache des Preises von 10 US-Dollar von Opus 5.5 im Max-Modus und etwa das Doppelte des Preises von Fable 5.1.
Der Einzelpreis ist um 20 % gesunken, aber die Gesamtkosten haben sich verdoppelt. Und Artificial Analysis fügte noch hinzu: Fable 5.2 generierte während der Bewertung etwa 275 Millionen Tokens, während der Median vergleichbarer Modelle nur 72,8 Millionen beträgt, „es redet einfach zu viel“.
Zuletzt: Während die Leistungsmessungen mit Zahlen quantifiziert werden können, erklärte Anthropic, dass Fable 5.2 auch im Designbereich weiterentwickelt wurde.
Daher versuchten Mitglieder der Community weniger als eine halbe Stunde nach der Veröffentlichung von Fable 5.2, mit Fable 5.2 ein FPS-Spiel zu entwickeln.
In der Demonstration sind Waffen, Schussrückmeldungen und Szenen vollständig vorhanden. Einige Nutzer in den Kommentaren meinten nach dem Anschauen, dass das Spiel direkt veröffentlicht werden könnte.
Wenn Sie nur wissen, welche Art von Spiel Sie spielen möchten, und noch nicht einmal die erste Codezeile geschrieben haben, können Sie Fable in diesem Fall ein paar weitere Schritte denken lassen.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Buchstaben-KI“, Autor: Miao Zheng, veröffentlicht mit Genehmigung von 36Kr.