Anthropics leistungsstärkstes Modell 4 erstmals enthüllt: RSI schießt mit doppelter Geschwindigkeit rasant in die Höhe
Das extrem verborgene, geheimnisvolle „Model 4“ von Anthropic ist nun aufgedeckt worden!
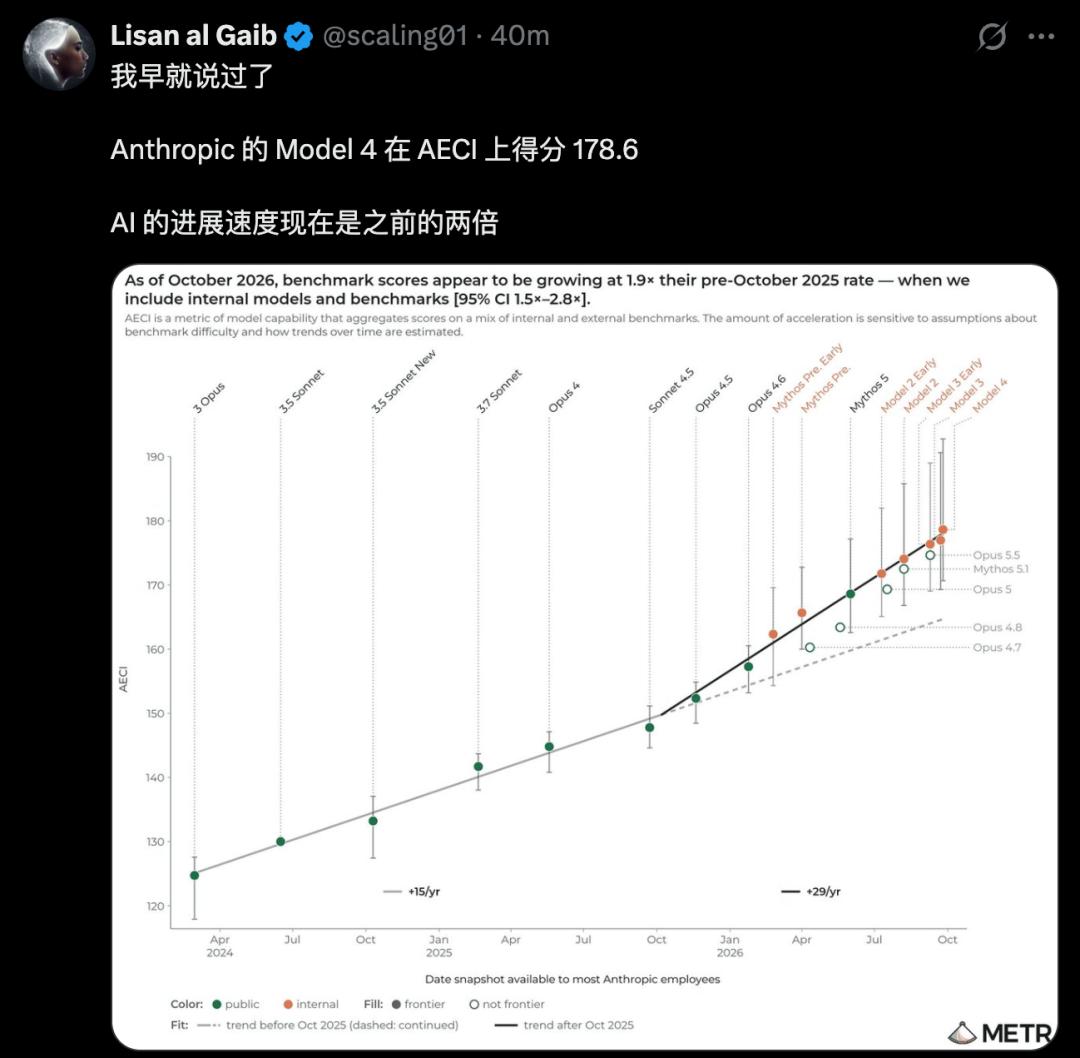
Es wurde zwischen September und Oktober heimlich fertig trainiert, sein interner umfassender Fähigkeitsindex (AECI) erreichte direkt einen unglaublich hohen Wert von 178,6. Die vorhandenen Testbögen können sein Potenzial kaum noch einschränken.
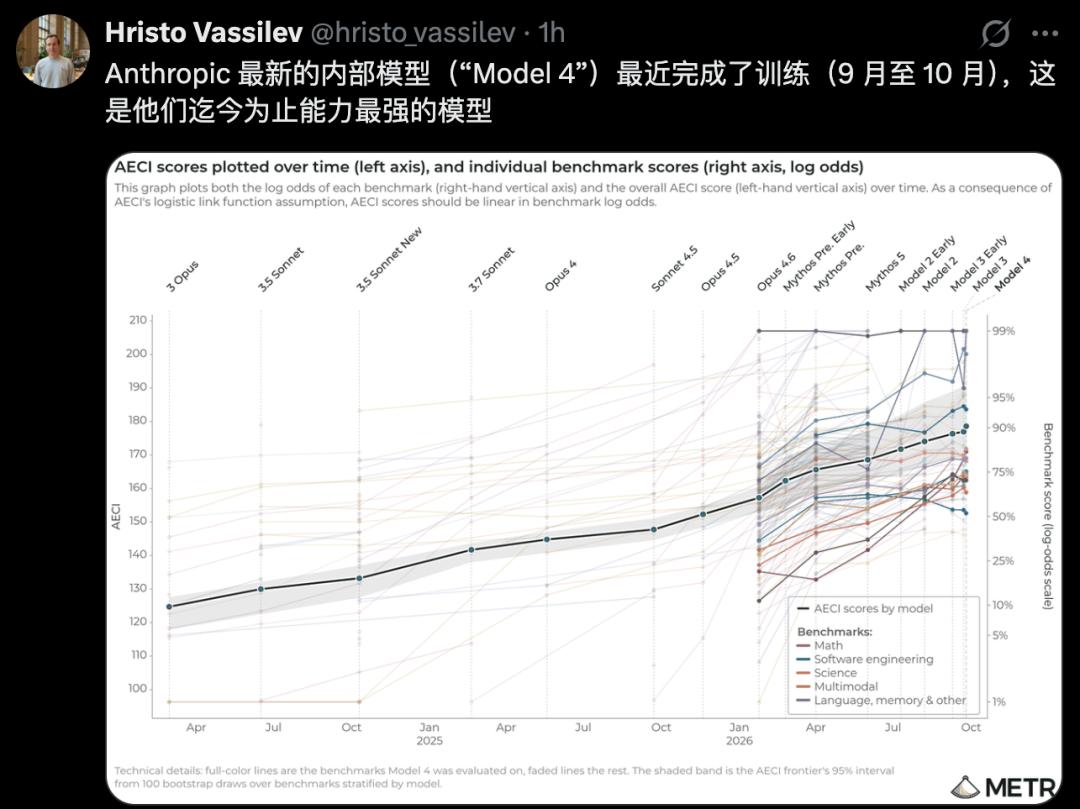
Genau heute hat die dritte Bewertungsstelle METR eine bahnbrechende Untersuchung veröffentlicht.
Nach 11 Wochen intensiver Arbeit, bei der sensible interne Daten von Anthropic tiefgehend analysiert wurden, ergab sich nur ein einziges Fazit —
Die Evolutionsgeschwindigkeit der Modelle von Anthropic ist völlig außer Kontrolle geraten und hat sich direkt verdoppelt.
Die aufsehenerregendsten Teile des Berichts sind diese Zahlenreihen.
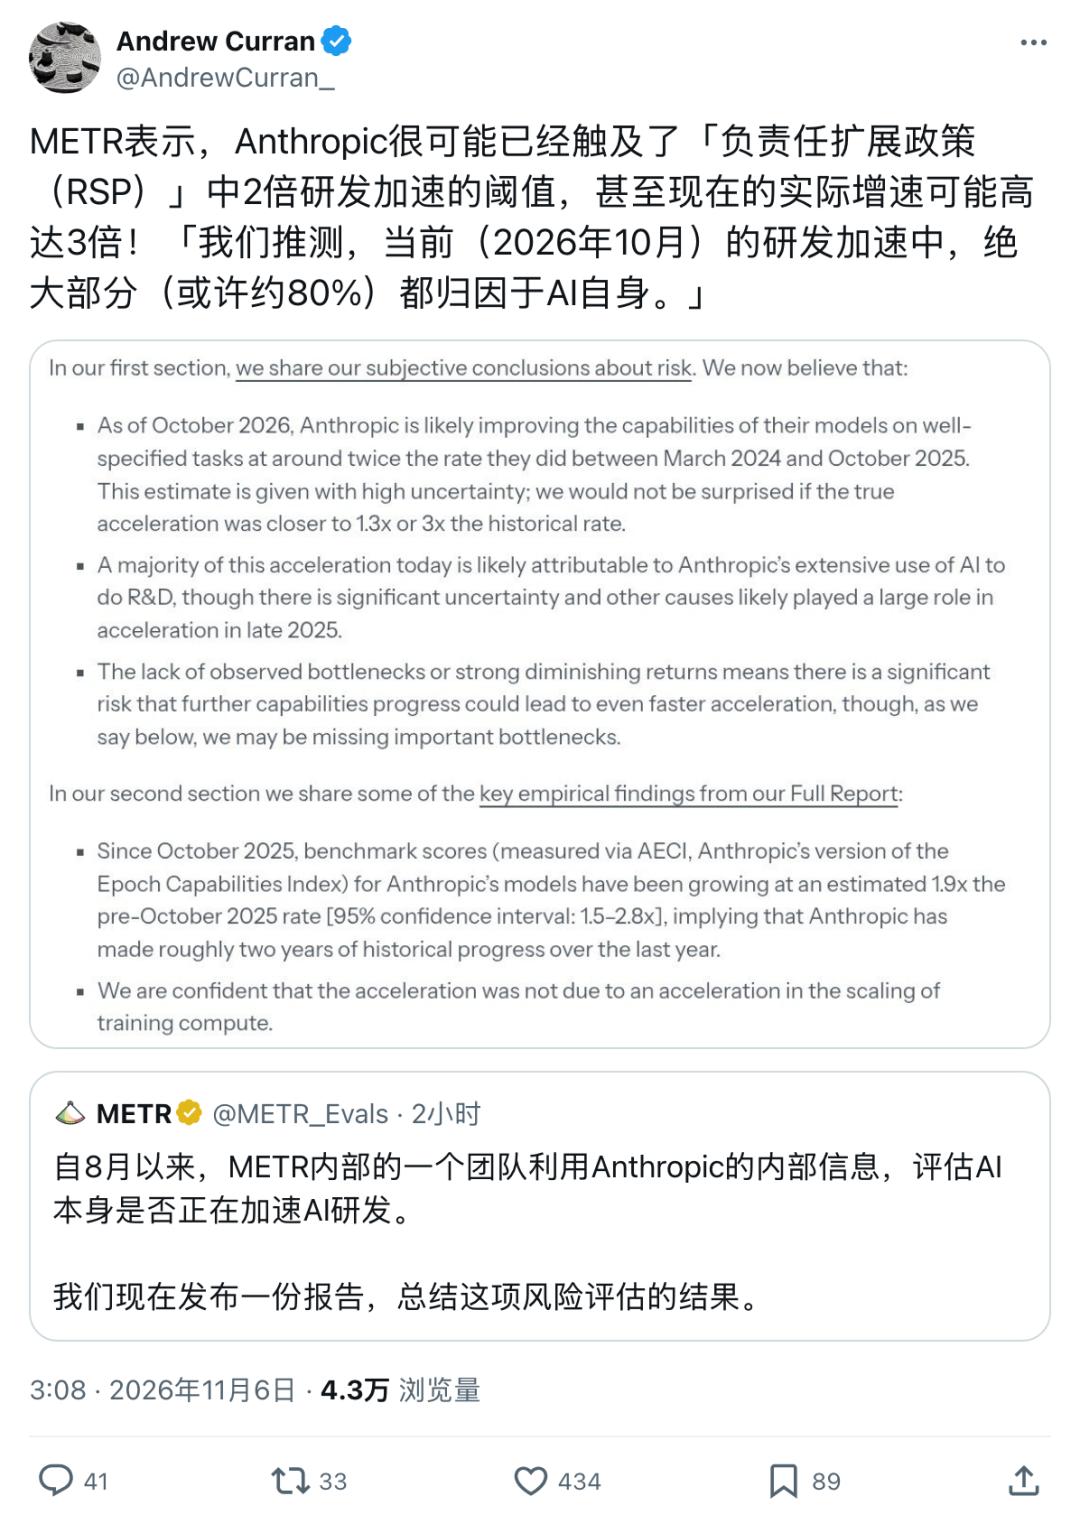
Bis Oktober lag die Steigerungsrate der Fähigkeiten von Anthropic bei klar definierten Aufgaben bereits beim Doppelten des Werts im Zeitraum von März 2024 bis Oktober 2025.
Der Wendepunkt liegt genau im Oktober 2025.
Seitdem hat sich die Wachstumsrate des internen Fähigkeitsindex AECI direkt auf das 1,9-fache des vorherigen Werts erhöht, und innerhalb eines Jahres wurde der Weg zurückgelegt, für den man früher zwei Jahre brauchte.
Noch erschreckender ist: Bei diesem rasanten Anstieg stammen 80 % des Antriebs tatsächlich von der KI selbst! Claude baut gerade selbst einen stärkeren Claude.
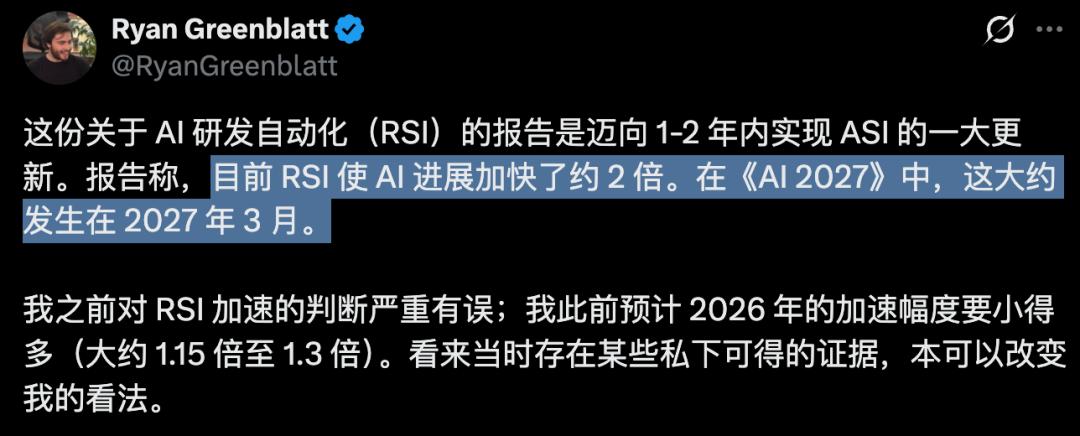
Der METR-Forscher Ryan Greenblatt erklärte offen: „Dieser Bericht ist ein starkes Signal dafür, dass ASI innerhalb von ein bis zwei Jahren erreicht werden kann.“
Bei dieser Geschwindigkeit wird die im Szenario „AI 2027“ beschriebene ASI schon in nur 4 Monaten vollständig Realität werden!
Das geheimnisvolle Model 4 taucht plötzlich auf
50 % von 15 Testbögen wurden vollständig gemeistert
Das Auffälligste an diesem Bericht ist eine Reihe von geheimen Codenamen, die Anthropic noch nie veröffentlicht hat.
Im Anhang des Berichts listet METR vier interne, unveröffentlichte Modelle auf.
Es handelt sich um „Unreleased 2022“, das 2022 fertig trainiert wurde, Model 2, das im Juli 2026 fertig trainiert wurde, Model 3, das zwischen August und September fertig trainiert wurde, und das neu erschienene Model 4 von September bis Oktober.
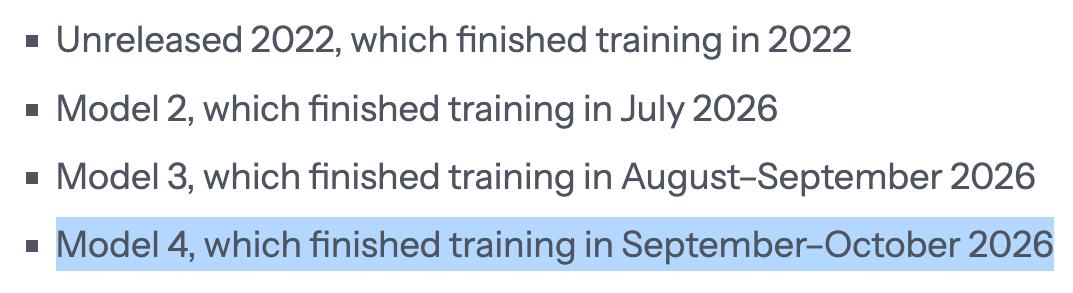
Genau dieses Model 4, das erst letzten Monat trainiert wurde, hat das gesamte Internet in Aufregung versetzt.
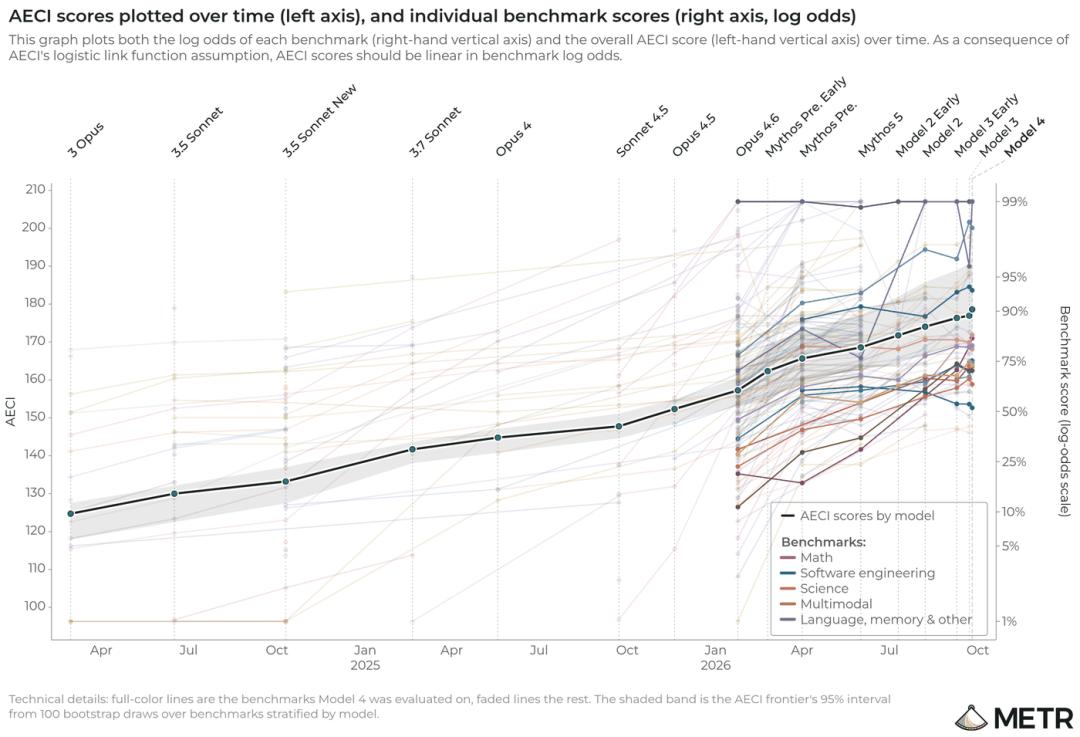
Es erreichte einen AECI-Wert von 178,6 und übertrifft damit bei weitem die öffentlichen Modelle Opus 5.5 (174,5 Punkte) und Mythos 5.1 (172,5 Punkte).
Der AECI ist wie die „Gesamtpunktzahl des Hochschulaufnahmeverfahrens“ für große Modelle: Er wandelt die Punkte der einzelnen Benchmark-Tests in einen umfassenden Rangwert um.
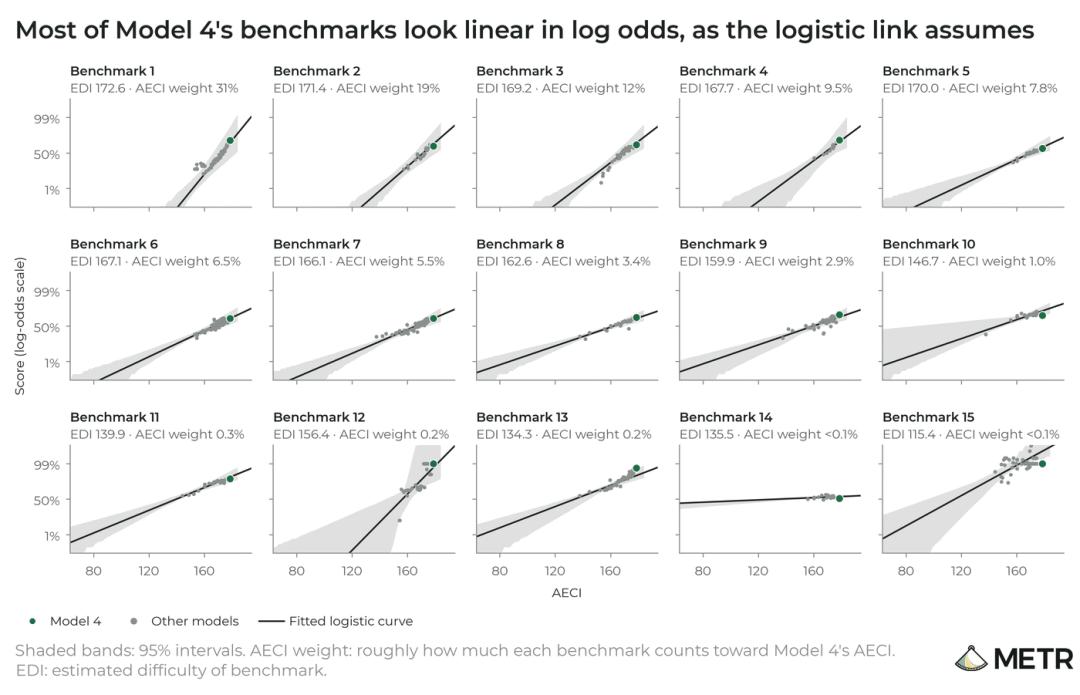
Bei den einzelnen Fächern: Bei den 15 Benchmark-Tests, an denen Model 4 teilnahm, lag die Trefferquote jedes einzelnen über 50 %. Noch vor 9 Monaten erreichte Opus 4.6 bei vielen Benchmarks nicht einmal die 50-Prozent-Marke.
Aber das ist noch nicht die echte Grenze von Model 4!
Das METR-Team hat im Bericht sogar einen „Fehlerbeseitigungstest“ durchgeführt und festgestellt, dass 3 der 15 Testbenchmarks Probleme haben: Entweder sind die Langfristaufgaben zu schwer, oder die Aufgabenbeschreibungen sind beschädigt.
Sobald diese 3 störenden Benchmarks entfernt und die Berechnung neu durchgeführt wird, steigt der AECI-Wert von Model 4 um weitere 1,1 Punkte auf 179,7 Punkte an.
Sogar beim Token-Verbrauch hat der interne Test von Anthropic das Potenzial von Model 4 noch nicht vollständig ausgeschöpft.
Für einen normalen Benchmark-Test werden für eine einzelne Aufgabe durchschnittlich 2,5 Millionen Eingabe-Token verbraucht und mehr als 70.000 Ausgabe-Token generiert.
Wenn ein Agent Code schreiben soll, verbraucht eine einzelne Aufgabe direkt volle 10 Millionen Eingabe-Token, und die Ausgabe erreicht 94.000 Token.
Was die METR-Bewerter noch mehr vor Probleme stellt: Die vorhandenen Testbögen können die Grenzen von Model 4 kaum noch messen.
Es ist kein Wunder, dass Anthropic vor dem Börsengang das S-1-Prospekt erneut aktualisiert und speziell einen neuen Risikohinweis hinzugefügt hat.
Laut internen Schätzungen werden zukünftige Modelle bald die Schwelle für „deutliche beschleunigte Forschung durch KI“ erreichen, und innerhalb eines Jahres wird die Arbeit erledigt, für die man früher zwei Jahre brauchte.
Model 4 ist der beste Beweis dafür. Was das Model 3 im Bild angeht, vermuten Nutzer im Internet, dass es sich um das berühmte Mythos 5.5 handelt.
80 % der Beschleunigung stammen von der KI selbst
Dass Model 4 so hohe Punkte erreichen kann, liegt daran, dass die Evolutionsgeschwindigkeit der Modelle deutlich zunimmt.
Der historische Wendepunkt liegt am 7. Oktober 2025.
Vor dieser Trennlinie stieg der AECI-Wert der Anthropic-Modelle jährlich um etwa 15 Punkte.
Ab Oktober 2025 hat sich die Kurve direkt nach oben beschleunigt, der jährliche Anstieg beträgt nun 29 Punkte, die Wachstumsrate erreicht das 1,9-fache des vorherigen Werts (das 95 %-Konfidenzintervall liegt zwischen dem 1,5-fachen und 2,8-fachen).
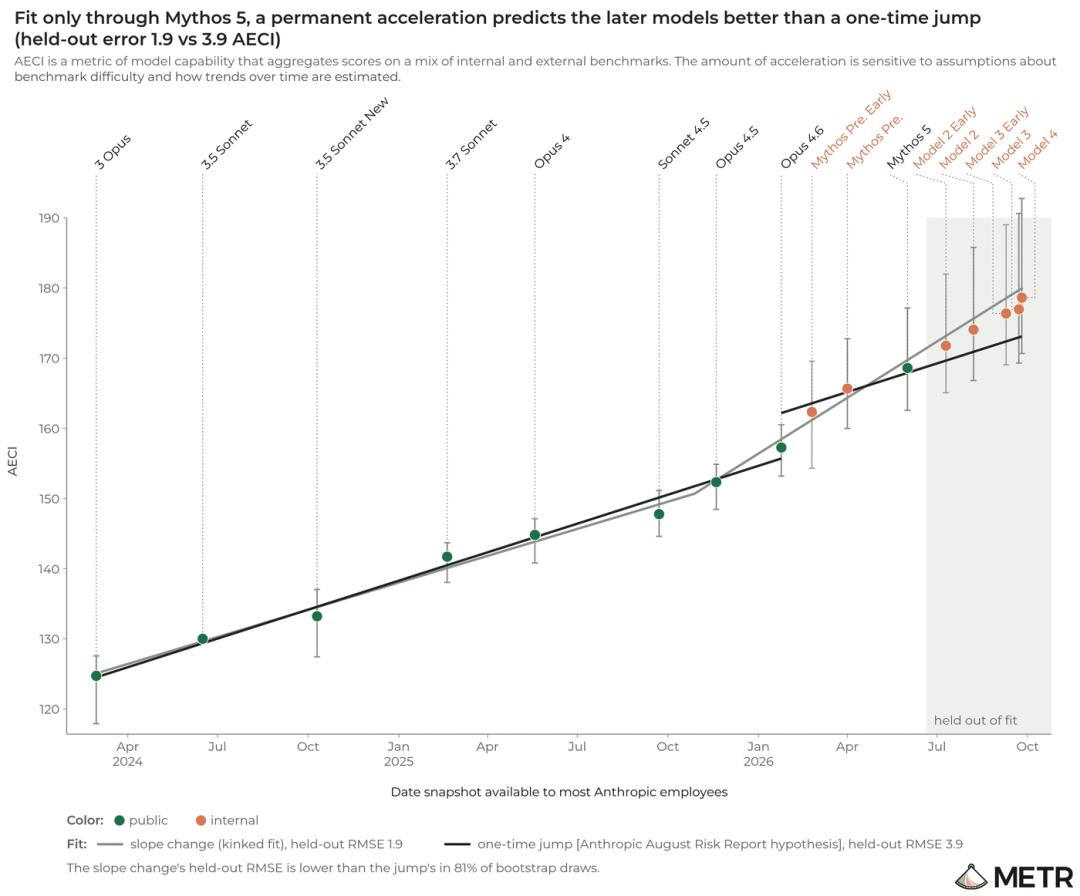
Anthropic hat im Risikobericht vom August dieses Jahres eine milde Annahme aufgestellt: Man geht davon aus, dass es sich nur um einen einmaligen „stufenweisen Sprung“ handelt, der durch die Nutzung neuer Tools und neuer Bewertungsmethoden verursacht wird.
Daraufhin führte METR eine Reihe von strengen blinden Vergleichsexperimenten durch.
Die Forscher zeichneten zwei Vorhersagelinien mit den Daten von Mythos 5 und früheren Modellen auf und testeten dann blind die später erschienenen Modelle Model 2, Model 3, Opus 5.5 und Model 4.
Das Ergebnis ist eindeutig: Bei 81 % der statistischen Stichproben beträgt der Vorhersagefehler nach dem Muster „langfristige kontinuierliche Beschleunigung“ nur 1,9 Punkte, was viel besser zu den echten Daten passt als das Muster „einmaliger Sprung“, dessen Fehler bis zu 3,9 Punkte beträgt.
Die doppelte Beschleunigung bedeutet also, dass Anthropic in nur einem Jahr den gesamten technischen Weg zurückgelegt hat, für den man früher volle zwei Jahre brauchte!
Im Kontext des exponentiellen Wachstums wird ein Indikator, der sich ursprünglich jährlich verdreifacht, bei doppelter Beschleunigung jährlich um das 9-fache steigen (3^2)!
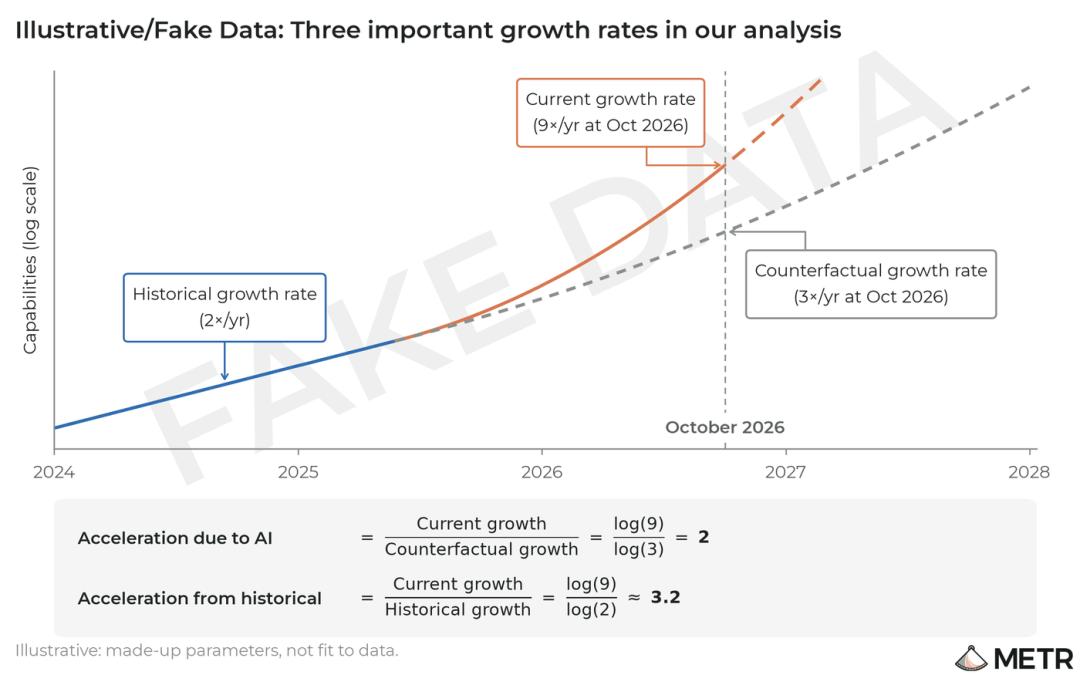
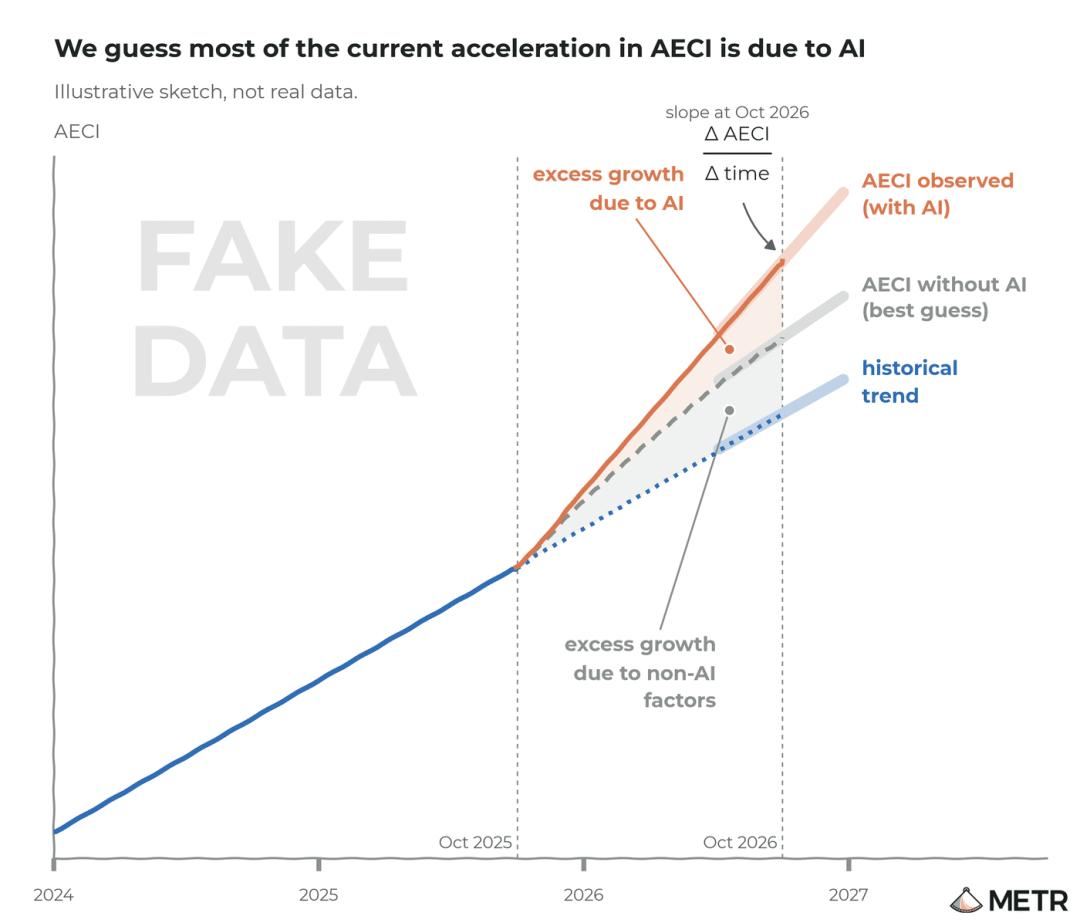
Um herauszufinden, woher dieser Antrieb kommt, hat METR die Rechenleistung, den Algorithmus und den Personaleinsatz aufgeschlüsselt und eine Gesamtberechnung durchgeführt.
METR schließt eindeutig die Möglichkeit aus, dass die Beschleunigung durch massiven Einsatz von mehr Trainingsrechenleistung erreicht wird, da die Wachstumsrate der Trainingsrechenleistung nach Oktober 2025 sogar langsamer ist als zuvor.
Der wahre Antrieb liegt im Forschungs- und Entwicklungsbereich.
Nach Schätzungen von METR stammen von der derzeit etwa zweifachen Forschungsbeschleunigung etwa 80 % von der unterstützenden Forschung durch die KI selbst, der kleine verbleibende Teil stammt von der gestiegenen Anzahl an Forschern und der Erweiterung der Inferenzrechenleistung.
Mitarbeiter erzielen 12-fache Beschleunigung
10 Ideen werden gleichzeitig an Agenten übergeben
Da bisher niemand außerhalb des Unternehmens Model 4 selbst testen kann, sind die täglichen Praxistests der internen Forscher bei Anthropic das einzige Fenster.
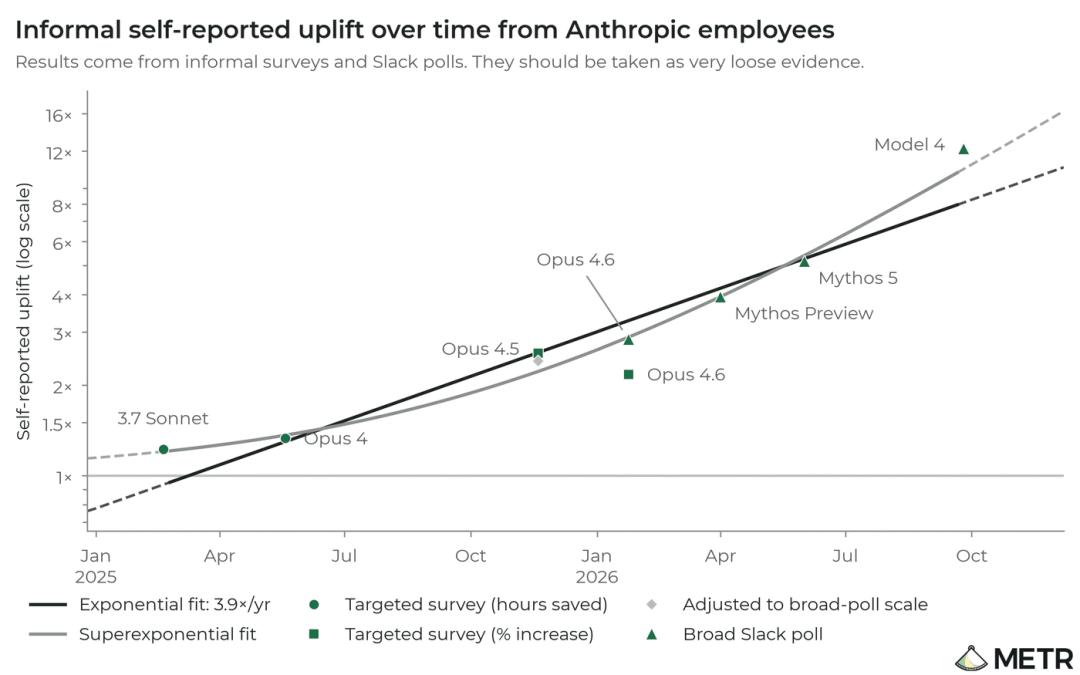
METR hat im Bericht ein Trenddiagramm einer informellen internen Umfrage bei Anthropic und einer Abstimmung aller Mitglieder auf Slack veröffentlicht.
Im Frühjahr 2025, als 3.7 Sonnet und Opus 4 verwendet wurden, lag die von den Mitarbeitern selbst angegebene Effizienzsteigerung nur bei 1,3- bis 1,4-fach.
Bei Mythos 5 im Juni dieses Jahres stieg die selbst angegebene Beschleunigung auf etwa das 5-fache.
Als im Oktober dieses Jahres Model 4 eingesetzt wurde, erreichte die von den Mitarbeitern selbst angegebene Forschungsbeschleunigung bereits etwa das 12-fache, was nach exponentieller Anpassung einem jährlichen Anstieg um das 3,9-fache entspricht.
Um herauszufinden, wie diese 12-fache Beschleunigung zustande kommt, führte METR Ende September ausführliche Interviews mit 11 technischen Forschern an der vordersten Front bei Anthropic durch.
Der bef