Das neue Google-Videomodell belegt den ersten Platz auf beiden Ranglisten, übertrifft Grok und Seedance und senkt den Preis um weitere 30 Prozent.
Bericht von Zhidongxi am 6. November: Heute hat Google DeepMind offiziell das neue Generation von Videogenerierungs- und Bearbeitungsmodell Gemini Omni 1.2 Flash vorgestellt. Dieses neue Modell bringt drei Kernverbesserungen: native 15-Sekunden-Videogenerierung, konversationelle Bearbeitung in mehreren Runden und eine stärkere Fähigkeit, Referenzbildern zu folgen.
Gleichzeitig ist der Preis von Gemini Omni 1.2 Flash um 30 % gegenüber dem Vorgängermodell Omni 1.1 Flash gesunken, der Preis für die Generierung von 720p-Videos sinkt auf 0,07 US-Dollar pro Sekunde (ca. 0,46 Yuan), was weniger als 1/3 des Preises von Seedance 2.5 für die Generierung von Videos gleicher Qualität beträgt.
Auf dem Wettbewerbsfeld großer Modelle hat Gemini Omni 1.2 Flash sowohl auf den beiden Ranglisten für Text-zu-Video und Bild-zu-Video den ersten Platz belegt und auf der Rangliste für Videobearbeitung den dritten Platz erreicht, und übertrifft damit Modelle wie FLUX3 Video, Grok Imagine Video 1.5, Seedance 2.0 und Seedance 2.5.
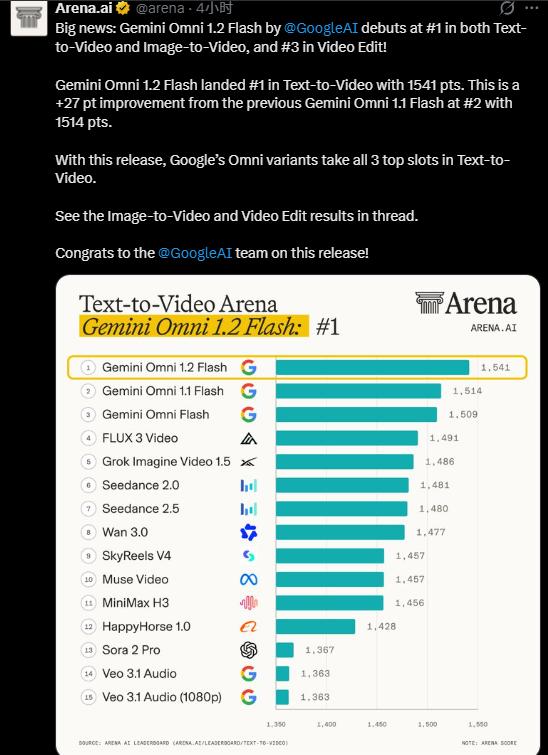
Gemini Omni ist eine neue Produktlinie von Google neben dem Veo-Videogenerierungsmodell, die als ein einheitliches Modell positioniert ist, das Videos aus beliebigen Modalitäten erstellen und bearbeiten kann. Omni Flash startete Ende Juni dieses Jahres die öffentliche Vorschau in der Gemini API, Ende August übernahm Omni 1.1 Flash die Rolle und ersetzte die Vorschauversion von Veo 3.1 in der Gemini API.
Google hat viele Generierungsergebnisse von Omni 1.2 Flash geteilt. Dieses Modell unterstützt nativ die Generierung und Bearbeitung von Videos mit einer maximalen Länge von 15 Sekunden, was eine 50%ige Steigerung gegenüber der Obergrenze von 10 Sekunden bei Omni 1.1 Flash darstellt, und unterstützt die freie Festlegung der Dauer zwischen 3 und 15 Sekunden in Schritten von 1 Sekunde.
Die Referenzbefolgungsfähigkeit des Modells ist ebenfalls deutlich verbessert. Benutzer können Charakterbilder, Produktbilder, Stilbilder, Aktionsclips von bis zu 3 Sekunden und Audiospuren mischen, um die Generierung zu leiten. Omni 1.2 Flash kann die Konsistenz der Details aus verschiedenen Kamerawinkeln von Anfang bis Ende beibehalten.
In der offiziellen Demonstration hat das Modell nur mit einem Foto eines Modells und Vorder- und Rückseitenbildern von drei Kleidungsstücken ein 15-sekündiges Video zum virtuellen Anprobieren generiert, das 360-Grad-Drehungen und passende Schnitte umfasst, wobei die Identität des Modells sowie der Schnitt und der Fall jedes Kleidungsstücks konsistent bleiben.
Im direkten Vergleich desselben Themas ist die Wiedergabetreue von Omni 1.1 Flash für Referenzbilder deutlich geringer als die von Omni 1.2 Flash.
Bei der Bearbeitungsmethode unterstützt Omni 1.2 Flash konversationelle Feinbearbeitung in mehreren Runden: Das Austauschen von Produkten, das Ändern des Hintergrunds, das Anpassen von Licht und Wetter sowie das Umschalten des Seitenverhältnisses können schrittweise für dasselbe Video angepasst werden, ohne dass das Video von Grund auf neu erstellt werden muss, und es unterstützt den gesamten 15-Sekunden-Clip.
In der Demonstration wurden der Hintergrund durch mehrfache Gesprächsrunden nacheinander von einem gestreiften Zelt zu einem Eichenwald, einem Pferdestall, einem Marktplatz und einer Steinkirche geändert, während die Aufführung der beiden Charaktere, die Reflexion der Rüstung und die Kamerakomposition unverändert blieben. Dies ist besonders praktisch für Teams, die Anzeigenvarianten für unterschiedliche Zielgruppen in großen Mengen erstellen müssen.
Auch die beiden Dimensionen Sprache und Kameraführung wurden verbessert. Die von Omni 1.2 Flash generierten Dialoge sind flüssiger und natürlicher, die Lippensynchronisation ist klarer, und es wird die Unterscheidung mehrerer Sprecher unterstützt.
Was die Kameraführung betrifft, können komplexe aufeinanderfolgende Aufnahmen wie FPV-Durchflüge, starkes Heranzoomen aus der Ferne und Umrundungen realisiert werden. Die offizielle Demonstration absolvierte einen kontinuierlichen FPV-Flug über einen Platz direkt zur Dachluke des Pantheons, ohne einen einzigen Schnitt.
Um dieses Modell zu verwenden, können Unternehmenskunden über die Gemini API darauf zugreifen oder es in Google AI Studio und der Google Cloud-Konsole testen; normale Benutzer können es in Googles Gemini App, dem KI-Videotool Flow und Google Vids erleben.
Schlussfolgerung: Der Unterschied in der Bildqualität wird allmählich geringer
Die Zeit ist gekommen, um Kosten und Arbeitsabläufe zu konkurrieren
Die Veröffentlichung von Gemini Omni 1.2 Flash spiegelt die Veränderung des Wettbewerbsschwerpunkts im Bereich der KI-Videogenerierung wider. Wenn sich der Unterschied in der Bildqualität zwischen den führenden Modellen allmählich verkleinert, geht die Phase, in der nur die Generierungsqualität verglichen wird, vorbei, und Dauer, Preis, Bearbeitbarkeit und Integration in Arbeitsabläufe werden zu neuen Wettbewerbsschwerpunkten.
Mit stetig sinkenden Kosten werden Szenarien wie groß angelegte A/B-Tests von Werbematerialien und die Abdeckung von Videos auf SKU-Ebene im E-Commerce, die zuvor aufgrund der Kosten kaum realisierbar waren, durch Videogenerierungsmodelle nach und nach Wirklichkeit.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Zhidongxi" (ID: zhidxcom), Autor: Chen Junda, Redakteur: Yunpeng, veröffentlicht mit Genehmigung von 36Kr.