Gerade hat OpenAI Pierre übernommen, will Codex nun Git ins Visier nehmen?
Gerade hat OpenAI offiziell angekündigt, die Pierre Computer Company zu übernehmen.
Laut OpenAI dient diese Übernahme dazu, eine Vision zu beschleunigen, bei der Codex zu dem Ort wird, an dem Teams gemeinsam mit KI Software erstellen – „von der ersten Idee bis zur endgültigen veröffentlichten Version“.
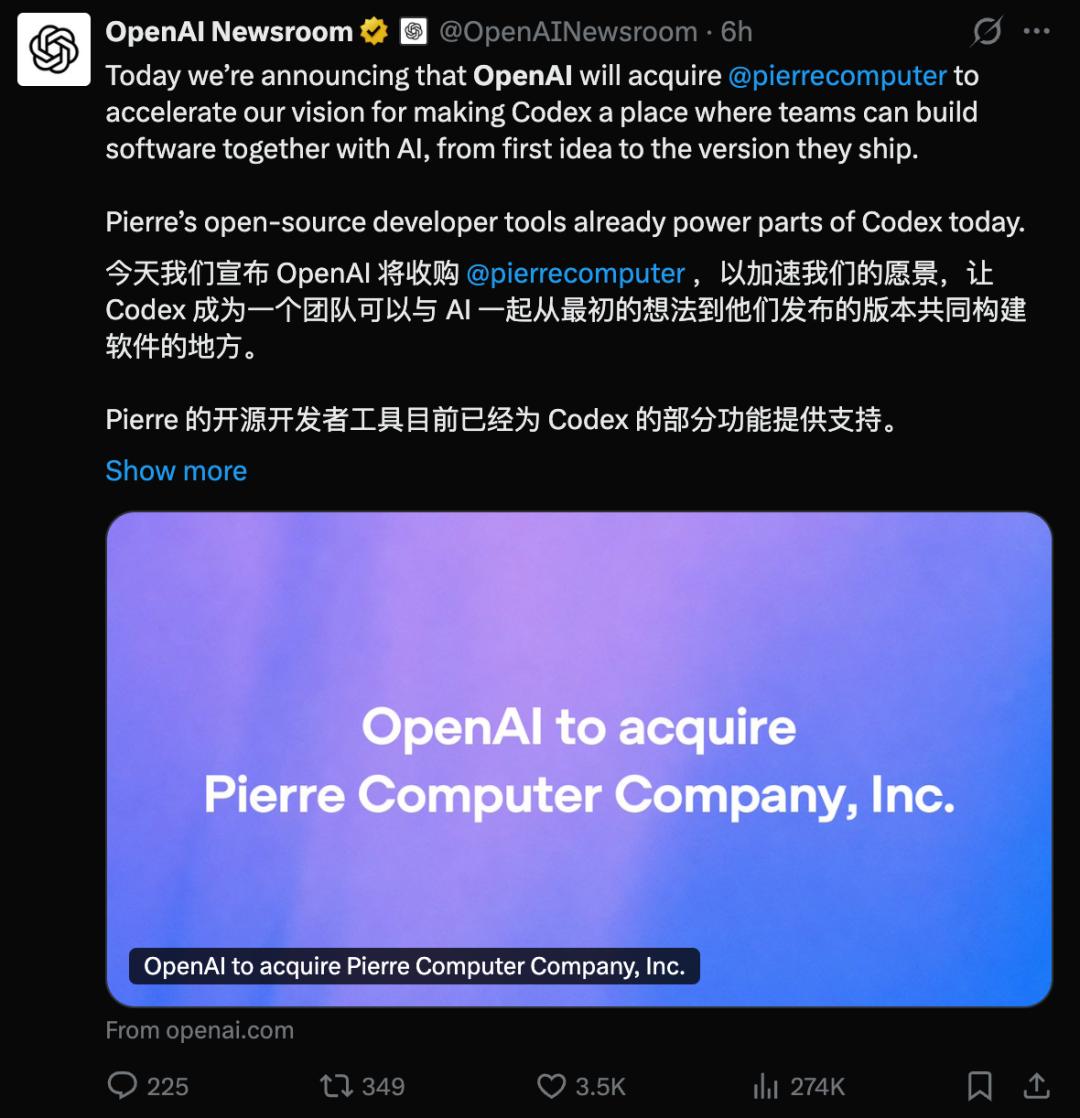
Gleichzeitig hat der offizielle Account von Pierre ein Video veröffentlicht, das auf einem Basketballplatz aufgenommen wurde, um den Beitritt zu OpenAI bekanntzugeben. In dem Video erklärten sie: „Die gute Nachricht ist, dass wir weiterhin die Produkte herstellen, die alle lieben.“
OpenAI möchte gemeinsam mit Pierre einen Standard für die moderne Softwareentwicklung setzen, der den gesamten Bereich abdeckt – „von dem ersten Branch, den ein Agent erstellt, bis zum spannenden Moment, an dem der Code bereitgestellt und für die ganze Welt zugänglich ist“. In der Mitteilung wird zudem erwähnt, dass OpenAI hofft, dass Codex den von Unternehmen gelieferten Code mit den Entscheidungen verbinden kann, die Mitarbeiter treffen.
Laut der offiziellen Mitteilung hat Pierre zuvor den Code-Hosting-Dienst Code Storage und eine Reihe von Open-Source-Entwicklertools entwickelt. Die beiden Open-Source-Bibliotheken Trees und Diffs werden bereits in der Codex-Anwendung für die Dateinavigation und die Oberfläche zur Überprüfung von Codeunterschieden verwendet.
Ziel dieser Übernahme ist es, den den Entwicklern vertrauten Git-Workflow weiter zu verbessern, damit er sich besser an das neue Modell der Zusammenarbeit zwischen Menschen und KI-Programmieragenten anpasst.
OpenAI verspricht, dass die Open-Source-Projekte von Pierre weiterhin Open Source bleiben und bestehende Kunden Code Storage weiterhin nutzen können. Die entsprechenden Funktionen werden in Zukunft schrittweise in Codex integriert. Derzeit muss die Transaktion noch Abschlussbedingungen wie die behördliche Genehmigung erfüllen, und vor dem offiziellen Abschluss werden beide Seiten weiterhin unabhängig voneinander betrieben.
Was ist Pierre überhaupt für ein Unternehmen?
Der Mitbegründer und CEO von Pierre ist Jacob Thornton. Frontendentwickler dürften ihm nicht fremd sein – er ist einer der Mitautoren von Bootstrap. Dieses Frontend-Framework, das intern bei Twitter entstand, wurde später zu einem der weltweit beliebtesten CSS-Frameworks und war praktisch das Einsteigerwerkzeug einer ganzen Generation von Webentwicklern.
Der andere Mitbegründer ist Ian Ownbey. Laut Informationen aus Venture Capital-Datenbanken wie Dealroom wurde Pierre 2023 gegründet und hat ein Team zwischen 11 und 50 Mitarbeitern. Gemäß der IA40-Liste hat Pierre insgesamt rund 24 Millionen US-Dollar an Finanzmitteln aufgenommen.
Wenn Sie die offizielle Website von Pierre unter pierre.computer öffnen, sehen Sie eine minimalistische Seite im Retro-Stil, die aussieht, als wäre sie aus den 1990er Jahren durch die Zeit gereist. Auf der Seite gibt es nur einen einzigen Satz zur Vorstellung des Unternehmens: Pierre entwickelt „grundlegende, kombinierbare Produktinfrastruktur für die Arbeit von Maschinen“.
Genau, mehr Inhalt bietet die offizielle Website nicht.
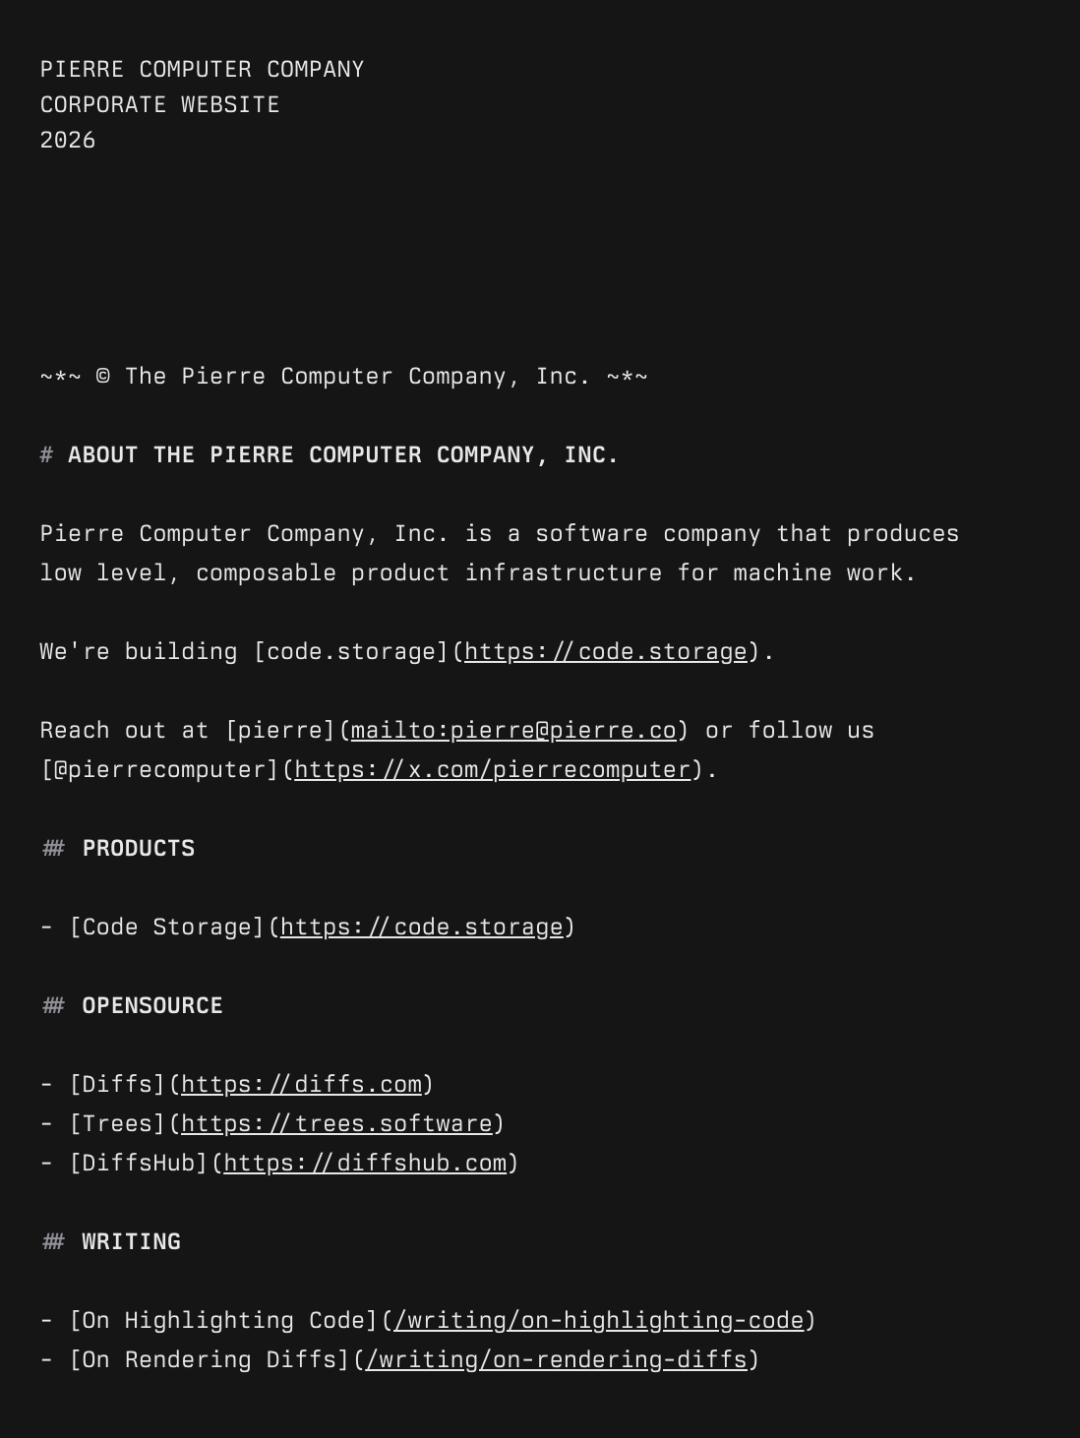
Die Produktlinie von Pierre ist nicht umfangreich: ein kommerzielles Produkt und drei Open-Source-Projekte:
- Code Storage: Das kommerzielle Hauptprodukt, eine KI-ausgerichtete Git-Hosting-Infrastruktur
- Diffs: Eine Bibliothek zur Darstellung von Codeunterschieden
- Trees: Eine Bibliothek zur Navigation durch Projekt-Dateibäume
- DiffsHub: Ein auf Diffs basierendes Open-Source-Projekt
Code Storage ist das Kernprodukt von Pierre, das darauf abzielt, Code und andere maschinengenerierte Ergebnisse für die größten Agenten-Arbeitslasten der Branche zu speichern.
Es unterstützt eine Speicherkapazität von bis zu 32 TB pro Repository, ohne Obergrenzen für die Anzahl der Repositories und den gesamten Speicherplatz. Weder Git-Anfragen noch API-Anfragen werden gedrosselt. Praxistests haben gezeigt, dass ein einzelnes Repository mehr als 500 Git-Anfragen pro Sekunde verarbeiten kann, mit einem Spitzenwert von über 15.000 API-Anfragen pro Sekunde, unterstützt mehr als 30 gleichzeitige Schreibvorgänge und bietet eine SLA mit 99,99 % Verfügbarkeit.
Hinter diesen Kennzahlen verbirgt sich die Tatsache, dass die KI-Programmierung den Rhythmus der Codeerzeugung verändert. Menschliche Ingenieure reichen möglicherweise nur wenige Male pro Tag Code ein, während KI-Agenten innerhalb einer Minute Dutzende von Branches erstellen und gleichzeitig eine große Anzahl von Lese- und Schreibanfragen stellen können. Die Drosselungsmechanismen und Zugriffssteuerungsprozesse herkömmlicher Git-Hosting-Plattformen sind hauptsächlich auf die Nutzungsgewohnheiten menschlicher Entwickler ausgelegt. Wenn Programmieragenten zu häufigen Nutzern werden, muss sich die vorhandene Infrastruktur entsprechend ändern.
Genau dafür ist Code Storage gedacht. Technisch basiert es auf dem dreistufigen Commit-Protokoll von Git und kombiniert es mit einer „speichenförmigen“ Quorum-Architektur, um gleichzeitig hochgradig gleichzeitige Lese- und Schreibvorgänge zu unterstützen und die Dauerhaftigkeit und Konsistenz der Daten zu gewährleisten. Entwickler können Repositorys direkt über SDKs für TypeScript, Python und Go bearbeiten, aber auch das native Git-Protokoll für Clone und Push verwenden und eine bidirektionale Synchronisierung mit GitHub, GitLab und Bitbucket durchführen. Das bedeutet, dass Entwickler ihren vorhandenen Workflow nicht vollständig ändern müssen, um auf einen für KI-Agenten optimierten Codespeicherdienst zuzugreifen.
Sogar das Preismodell berücksichtigt die Besonderheiten der KI-Programmierung. Heiße Daten, die innerhalb von 7 Tagen aufgerufen wurden, kosten 0,005 US-Dollar pro GB und Stunde; kalte Daten, die länger als 7 Tage nicht aufgerufen wurden, sinken auf 0,0002 US-Dollar – ein Unterschied um das 25-fache.
In KI-Programmierszenarien können Agenten schnell große Mengen an Code, Branches und Zwischenergebnissen generieren, von denen viele nur ein- oder zweimal gelesen oder geändert werden, bevor sie lange Zeit ungenutzt bleiben. Durch die stufenweise Abrechnung von heißen und kalten Daten versucht Code Storage, dieses Speichermodell für Code, der häufig generiert aber selten aufgerufen wird, kostentechnisch nachhaltiger zu gestalten.
Wenn Code Storage die Frage „Wo wird der Code gespeichert?“ beantwortet, lösen Trees und Diffs das Problem „Wie können Menschen den Code verstehen?“.
Mit Trees können Entwickler Projektdateien schnell durchsuchen und lokalisieren, während Diffs Codeänderungen auf einen Blick sichtbar macht. OpenAI hat diese beiden Bibliotheken in der Mitteilung ausdrücklich gelobt und erklärt, dass sie „Entwicklern ermöglichen, große Mengen an Code mühelos zu überprüfen und zu durchsuchen, während sie gleichzeitig eine hervorragende Leistung beibehalten“.
Diffs verfügt zudem über einen sehr praktischen Bearbeitungsmodus. Wenn Prüfer im Diff-Ansicht Probleme feststellen, können sie die entsprechende Zeile direkt an Ort und Stelle ändern, ohne zurück zum Editor wechseln zu müssen. Das neu veröffentlichte Highlights-Feature aktualisiert die Syntaxhervorhebung in Echtzeit, wenn Entwickler tippen oder Agenten Code streamen.
Wenn die KI-Code-Erzeugung explodiert
Aus den Aktivitäten von Pierre lässt sich leicht erkennen, dass hinter dieser Übernahme von OpenAI eine zunehmend verbreitete Sorge steht.
Die Geschwindigkeit, mit der KI Code schreibt, hat die von Menschen längst überholt. Aber nachdem der Code geschrieben ist, muss ihn jemand prüfen, überprüfen und dafür verantwortlich sein. Wenn ein Ingenieur mehrere Agenten gleichzeitig anweist, parallel zu arbeiten, kann die Anzahl der Diffs, die er täglich durchsehen muss, um ein Vielfaches höher sein als früher.
Die Phasen der Überprüfung und Veröffentlichung werden zu dem eigentlichen Engpass im Zeitalter der KI-Programmierung.
OpenAI hat diesen Punkt in der Mitteilung besonders hervorgehoben: „Es gibt noch einen weiteren wichtigen Aspekt bei der Verwendung von Git: Wie Entwickler Code überprüfen.“ Die Tools von Pierre wurden vor allem deshalb ausgewählt, weil sie großen Wert darauf legen, dass Menschen große Mengen an Code schnell verstehen können.
Ein weiteres bemerkenswertes Signal ist die von OpenAI erwähnte „Verknüpfung des von Unternehmen gelieferten Codes mit den Entscheidungen, die Mitarbeiter treffen“. Git kann Codeänderungen aufzeichnen, aber es ist schwierig, die Diskussionen und Abwägungen hinter den Änderungen zu protokollieren. Wenn immer mehr Code von KI generiert wird, werden die Gründe hinter Codeänderungen schwerer nachvollziehbar und gleichzeitig wichtiger als je zuvor.
Natürlich bedeutet die Übernahme an sich nicht, dass Codex morgen zu einer völlig neuen Codeplattform wird. Die Transaktion bedarf noch der behördlichen Genehmigung, und die Integration braucht Zeit. Das derzeitige Versprechen von OpenAI ist, dass Open-Source-Projekte weiterhin Open Source bleiben und Code Storage-Kunden den Dienst weiter nutzen können – die konkrete Form des neuen Produkts wurde noch nicht bekanntgegeben.
Rückblickend wird der Wettbewerb um KI-Programmierwerkzeuge immer tiefer gelegt. In den letzten mehr als zehn Jahren wurden die Speicherung, Rückverfolgung und Verwaltung von Code fast vollständig von Plattformen wie GitHub dominiert. Jetzt hat OpenAI ein Unternehmen übernommen, das ausschließlich KI-optimierte Git-Infrastruktur entwickelt – die Absicht ist mehr als offensichtlich.
Und damit stellt sich die Frage: Wenn in Zukunft der Großteil des Codes von KI geschrieben, von KI überprüft und auf der Plattform eines KI-Unternehmens gespeichert wird, brauchen Entwickler dann noch GitHub in seiner heutigen Form? Ist Ihr Team bereit, Codex den gesamten Prozess vom ersten Branch bis zur Veröffentlichung zu überlassen?
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“, Redakteur: Leng Mao, veröffentlicht mit Genehmigung von 36Kr.