Haben die Chinesen jene „Lithografiemaschine zur Herstellung von KI“ hergestellt?
In den vergangenen Tagen hat ForgeKernel, ein unbeaufsichtigter Agent, ohne sich auf die ursprüngliche Implementierung von DeepSeek zu stützen, den neuesten Kernoperator von DeepSeek vor der ganzen Welt um 9,8 % schneller geschrieben!
FlashMLA ist die von DeepSeek quelloffen gelegte Kernbibliothek für Attention-Operatoren, und DeepInfer, das am 20. Oktober erst kürzlich quelloffen gelegte Inferenz-Framework, hat es ebenfalls integriert. Es stammt aus dem in der Branche anerkannten Team mit der stärksten Infrastruktur-Kompetenz und kann als der Höhepunkt von von Menschen handgeschriebenen Operatoren angesehen werden.
Dies hat im Wettbewerb zwischen China und den USA um die Position als weltweit erster Ursprungsort für KI-Innovation einen äußerst wichtigen Punkt im Bereich RSI geholt. Insbesondere weil es sich nicht um Programmierung, Laufzeit-Bewertungen oder Spieleentwicklung handelt, sondern um das Schreiben der untersten Operatoren, wurde seine Bedeutung besonders hervorgehoben – das Licht von RSI hat bereits die unterste Forschung- und Entwicklungskapazität der chinesischen KI-Innovation erreicht.
Von September bis Oktober hat die Unterstützung verschiedener KI-Experten für RSI (rekursive Selbstverbesserung) nie nachgelassen. Einige handeln aus Sorge um die ultimative Beziehung zwischen Mensch und KI, andere wollen vielleicht nur die öffentliche Aufmerksamkeit der hinter ihnen stehenden kommerziellen Organisationen sichern.
Die sprechenden Personen lassen sich grob in zwei Gruppen einteilen. Die eine Gruppe sind Windmacher, die auf die Hitze der Branche und die Intensität des Wettbewerbs setzen, wobei die unterste Ebene die Fähigkeit ist, Trends zu setzen – ein typisches Beispiel ist Elon Musk. Die andere Gruppe verfügt über systematisches praktisches Handeln als Grundlage, fehlt aber an Unterstützung auf der Ebene der gesamten Methodik, wie zum Beispiel Clark im folgenden Text.
Am 12. Oktober änderte Jack Clark, Mitbegründer von Anthropic, in der 476. Ausgabe von Import AI seine Aussage: Der Zeitpunkt des Eintreffens der vollständigen RSI – der vollständige geschlossene Zyklus der rekursiven Selbstverbesserung – wurde von 2028 auf 2027 vorgezogen.
Er ist ein Anhänger der Beweisführung, und die Beweise liegen direkt vor ihm. Die tägliche Anzahl von Code-Zusammenführungen bei Anthropic ist von 2500 im Mai auf über 30.000 im September gestiegen. Git hielt dem nicht mehr stand, und das selbst entwickelte Versionsverwaltungssystem Scion wurde eingesetzt. Musk antwortete in den sozialen Medien nur mit einem Wort: Obv – offensichtlich.
Alle führenden Unternehmen arbeiten in diese Richtung, RSI scheint heute die Richtung mit der höchsten Sicherheit an der Spitze zu sein. Gleichzeitig ist es aber auch die Richtung mit den unschärfsten Standards: Es gibt keinen öffentlichen Bewertungsrahmen, und unter demselben Begriff verbergen sich Arbeiten mit völlig unterschiedlichem Wert.
Ich bin auf FaceWall Intelligence aufmerksam geworden, weil es einen Schritt weiter geht als die beiden oben genannten Gruppen und etwas Prüfbares vorgelegt hat. Ausgehend von einem leeren Verzeichnis hat die KI in etwa zwei Tagen ein Trainingsframework geschrieben, das die von menschlichen Ingenieuren über Jahre verfeinerte Basislinie übertrifft. Die eigenen Modelle von FaceWall werden seit Mai dieses Jahres auf diesem Framework trainiert. Und eine Live-Übertragung sowie ihre Spitzenposition auf der Huawei-Rangliste haben dieses Unternehmen an eine äußerst besondere und bemerkenswerte Position in der Branche gebracht.
Was mich wirklich beeindruckt hat, ist die Größe dieses Unternehmens. Ein Unternehmen mit etwa hundert Mitarbeitern steht an der vordersten Front des Paradigmenwechsels in der KI-Forschung und -Entwicklung. Das ist keine Geschichte über ein von Natur aus begabtes Genie, sondern spiegelt den aktuellen Trend des Wettbewerbs an der KI-Spitze wider.
Vor zwei Jahren sagte FaceWall, es wolle eine „Lithographiemaschine“ für große Modelle bauen. Ob diese Maschine bereits gebaut wurde und in welchem Schritt sie sich befindet, ist das, was dieser Artikel beantworten soll.
01
In der Ebene, die am meisten auf menschliches Können angewiesen ist, hat es gewonnen
Eine 22,5-stündige Live-Übertragung, die für normale Menschen äußerst langweilig wirkt, hat Aufsehen erregt.
Es ist genau das, was wir am Anfang erwähnt haben: ForgeKernel, ein unbeaufsichtigter Agent, hat ohne sich auf die ursprüngliche Implementierung von DeepSeek zu stützen, vor der ganzen Welt den neuesten Kernoperator von DeepSeek um 9,8 % schneller geschrieben!
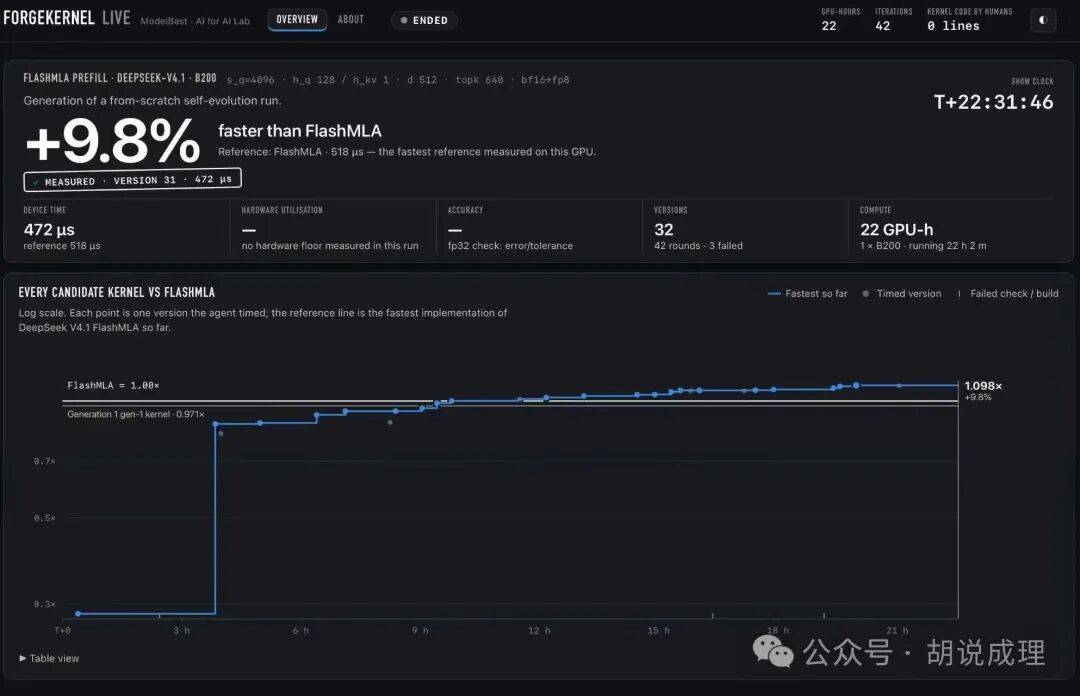
Die Live-Übertragung begann am 30. Oktober und lief bis gegen neun Uhr am nächsten Morgen, insgesamt 22,5 Stunden. Auf dem Bildschirm tippte niemand Code, nur ein Agent, eine NVIDIA B200 und ein Ziel: einen Prefill-Operator zu schreiben, der schneller ist als FlashMLA von DeepSeek.
Es verfügte nur über die mathematische Definition des Operators und die Einschränkungen der Zielhardware, keinen Quellcode und keine Papiere zum Abschreiben. Die erste Version bestand die Korrektheitsprüfung und dauerte 1834 Mikrosekunden. In weniger als 4 Stunden wurde sie auf 593 Mikrosekunden gedrückt.
Um die 7. Stunde herum führte ein Durchbruch in der Kernstruktur dazu, dass es zuerst seine eigene Vorgängerversion übertraf und dann zum ersten Mal FlashMLA überbot.
Am Ende der Live-Übertragung dauerte die endgültige Version 472 Mikrosekunden, während FlashMLA 518 Mikrosekunden benötigte. In insgesamt 42 Iterationsrunden entstanden 32 Versionen, wobei nur eine B200 und 22 GPU-Stunden verwendet wurden.
Die Anzahl der Codezeilen, die Menschen für diesen Operator geschrieben haben, ist Null.
Gegen Ende der Live-Übertragung gab es ein Detail: Es stellte selbst fest, dass das Burst-Laden von Q mit dem Datentransport von KV um Speicherressourcen konkurrierte, und steuerte daraufhin aktiv das Anforderungsrhythmus von Q, wodurch die Dauer um weitere 2,4 % gesenkt wurde. Eine solche Beurteilung konnten früher nur erfahrene Experten treffen.
Operatoren sind grundlegende Berechnungsmodule, die zur Laufzeit großer Modelle wiederholt aufgerufen werden. Operationen wie Matrixmultiplikation und Normalisierung müssen über entsprechende Operatoren auf dem Chip ausgeführt werden. Wie viel Leistung ein Chip entfalten kann, hängt zu einem großen Teil vom Optimierungsniveau dieser Operatoren ab. Wie Daten transportiert werden, wie Berechnungen parallelisiert werden und ob die Chip-Ressourcen voll ausgenutzt werden, beeinflussen die endgültige Laufgeschwindigkeit des Modells. Bei demselben Chip kann die tatsächliche Leistung je nach Optimierungsniveau der Operatoren stark variieren.
Ein einziger Operator kann eine ganze Branche verändern. FlashAttention aus dem Jahr 2022 hat nur den Schritt der Attention-Berechnung neu geschrieben, wodurch sie um ein Vielfaches schneller wurde. Lange Kontexte sind seitdem erschwinglich, und heute ist fast jedes große Modell auf es und seine Nachfolger angewiesen. FlashMLA von DeepSeek ist ein Zweig, der aus dieser Linie hervorgegangen ist.
Das ist auch die Ebene, die am meisten auf menschliches Können angewiesen ist. Um einen erstklassigen Operator gut zu schreiben, muss man gleichzeitig die Algorithmen, die Speicherhierarchie des Chips und die Befehlsplanung vollständig verstehen und dann auf verschiedenen Hardware-Geräten wiederholt Fehler machen. Laut FaceWall benötigen menschliche Experten für Operatoren wie FlashAttention, die eine tiefgreifende Neukonstruktion erfordern, oft mehrere Monate oder sogar ein halbes Jahr, um eine Iteration abzuschließen.
Diese Ebene war auch schon immer der schwierigste Teil, wenn KI Code schreibt. Als Stanford Anfang 2025 KernelBench veröffentlichte, erreichten weniger als 20 % der von den stärksten Inferenzmodellen geschriebenen GPU-Operatoren das Niveau der PyTorch-Basislinie. Beim Schreiben von Webseiten und Geschäftscode ist KI längst geübt. Auf der Ebene der Operatoren steht sie jedoch vor der Obergrenze des menschlichen Könnens.
Ein großer Teil des Schutzgrabens von NVIDIA ist genau auf dieser Ebene aufgebaut. Das CUDA-Ökosystem hat es bis heute geschafft, indem es in fast zwei Jahrzehnten Generationen von Experten handgeschriebene und optimierte Operatorbibliotheken hervorgebracht hat. Für jede neue Generation von inländischen Chips und jedes neue Modell müssen diese Operatoren erneut angepasst werden. Im August letzten Jahres kündigte Huawei an, das CANN-Software-Stack von Ascend vollständig quelloffen zu legen, genau um diese Wand anzugehen.
Aber die Anzahl menschlicher Experten kann nicht mit der Iterationsgeschwindigkeit von Chips und Modellen Schritt halten. Zwischen China und den USA besteht bereits eine Lücke bei der Hochleistungsrechenkapazität. Wenn diese Hürde in der Software weiterhin mit Arbeitskräften und Jahren überwunden werden muss, wird die Lücke nur noch größer.
Daher ist der offizielle Beitrag des Ascend CANN-Teams am 27. Oktober, der ForgeKernel namentlich nennt, sehr gewichtig: Es hat gleichzeitig die drei Hardware-Ranglisten 950DT, 950PR und A3 von CANNBench angeführt.
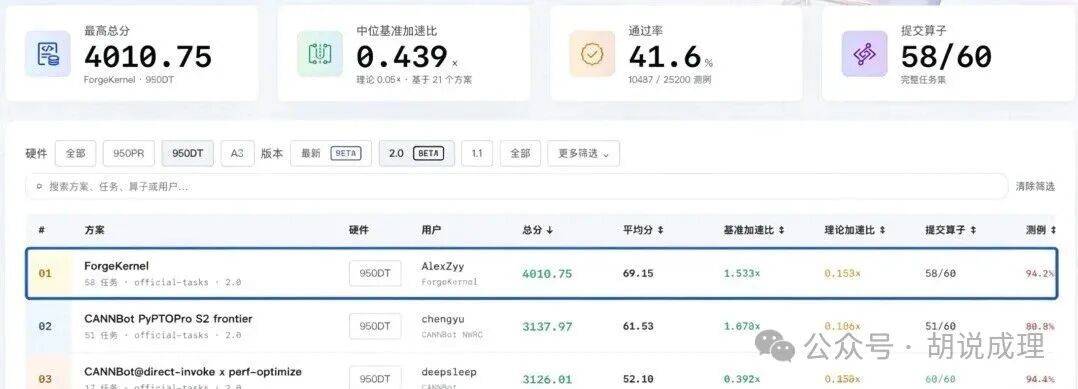
950DT ist die neue Generation von Chips, die Huawei erst in diesem Jahr auf den Markt gebracht hat. Die dazugehörige Operatorbibliothek befindet sich noch in der Anfangsphase des Aufbaus, und die manuelle Anpassung ist von Natur aus langsam.
ForgeKernel hat die Anpassung als Erster abgeschlossen und führt laut der Rangliste vom 27. Oktober die Gesamtpunktzahl um 37,1 % vor dem zweiten Platz an.
A3 entspricht dem heute am weitesten verbreiteten Ascend 910C. In der vorherigen Version von CANNBench, die am 15. Oktober abgeschlossen wurde, war es bereits der Erste auf dieser Rangliste.
Auf der NVIDIA-Seite belegt ForgeKernel auch den ersten Platz im schwierigsten FlashInfer-Bench-Bereich des von NVIDIA veröffentlichten SOL-ExecBench. Diese Bewertung zieht 235 CUDA-Operator-Aufgaben aus 124 echten Modellen heraus und misst, wie weit sie von der physischen Grenze der Hardware entfernt sind. Auf derselben Liste stehen auch Teams aus dem In- und Ausland wie Databricks, Cursor und Qwen.
Die Software- und Hardware-Unterschiede zwischen den beiden Seiten sind groß: NVIDIA verwendet CUDA, während Ascend eine eigene unabhängige Architektur und Toolchain hat. ForgeKernel verwendet dasselbe System. Beim Wechsel der Plattform wird nur das Leistungsanalysewerkzeug von NCU auf msprof umgestellt, und das für den neuen Chip erforderliche Hardware-Wissen wird vom Modell durch Tests auf diesem Chip gesammelt.
Die Ergebnisse stehen auf den offiziellen Ranglisten, der Prozess ist der ganzen Welt zugänglich, und der Code wurde ebenfalls veröffentlicht: Nach dem Ende der Live-Übertragung kündigte das Evolution Laboratory von FaceWall Intelligence gemeinsam mit der OpenBMB-Community an, ForgeKernel quelloffen zu legen.
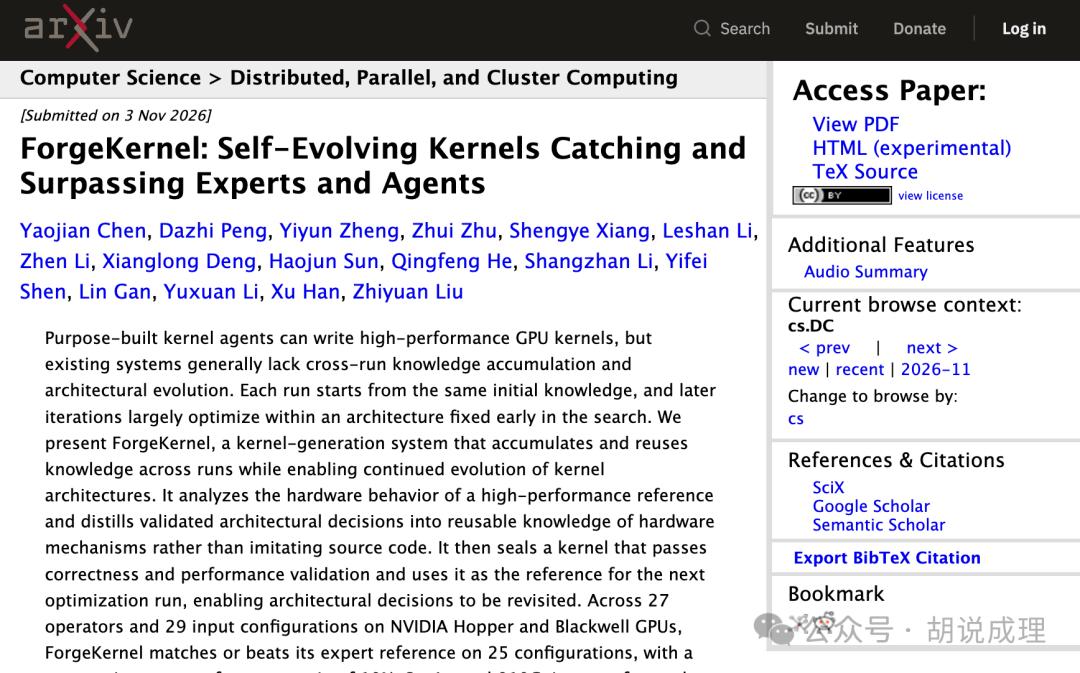
Einige Tage später wurde das Paper zu ForgeKernel offiziell online gestellt.
Dieses Ereignis hat die Position von FaceWall in der Branche verändert. Ursprünglich war es für seine Endgerätemodelle bekannt. Jetzt stehen die von ihm geschriebenen Operatoren an der Spitze der offiziellen Ranglisten von Ascend und NVIDIA gleichzeitig. Die von ForgeKernel generierten Operatoren wurden bereits in das Trainingsframework integriert und haben den Langzeittest von MiniCPM5-1B auf inländischen Chips und NVIDIA-Plattformen abgeschlossen.
In der Branche gibt es schon lange eine nie veröffentlichte Gerüchteküche: Wenn ein bestimmtes inländisches Hardware-Unternehmen bei der Optimierung der untersten Software-Ebene nicht weiterkommt, kann es versuchen, bei FaceWall nachzufragen, und vielleicht gibt es ein anderes Ergebnis. Natürlich ist dies nur eine lange Zeit in einem kleinen Kreis der Branche verbreitete Aussage.
Aber dieses Mal ist es anders: Ein Chiphersteller wie Huawei hat es offiziell genannt, was bedeutet, dass alle Modellteams, die auf dem Huawei-Ökosystem basieren, es direkt verwenden können. FaceWall ist von einem Unternehmen, das für seine Endgerätemodelle bekannt ist, an die vorderste Position des chinesischen Rechenkapazitäts-Ökosystems vorgedrungen. Danach wird niemand es mehr nur als ein Modellunternehmen betrachten.
Im Wettbewerb zwischen China und den USA ist dieser Punkt noch wichtiger. Das Schwierigste, was inländische Chips im Vergleich zu NVIDIA aufholen müssen, sind nie nur die Hardware-Indikatoren, sondern auch die fast zwanzig Jahre angesammelte Expertenerfahrung in CUDA – eine Wand, die aus Arbeitskräften und Jahren aufgebaut wurde. Jetzt kann diese Wand stündlich aufgeholt werden, und je dünner das Software-Stack der inländischen Chips ist, desto mehr kann die KI ergänzen.
Wenn FaceWall eine „Lithographiemaschine“ für große Modelle bauen will, dann gravitiert ForgeKernel die feinsten Linien. In der tiefgründigsten Ebene der KI-Grundlagentechnologie, die am meisten auf menschliches Können angewiesen ist, hat die KI eines chinesischen Unternehmens gleichzeitig auf den offiziellen Ranglisten der beiden Ökosysteme von China und den USA den ersten Platz belegt und hat öffentlich den von Menschen handgeschriebenen Maßstab übertroffen. Das ist viel schwieriger, als die KI Webseiten oder Geschäftscode schreiben zu lassen, und es ist der Schritt, der der „KI, die KI erzeugt“ am nächsten kommt, seit RSI existiert.
Wie dieser Punkt erreicht wurde, beginnt mit dem Begriff RSI.
02
Die Richtung mit der höchsten Sicherheit hat die wenigsten Standards
Vor etwa einem halben Jahr habe ich mit einem Kerntechniker eines inländischen KI-nativen Unternehmens gesprochen. Als wir über die Spitzenrichtungen sprachen, bat er mich wiederholt, keine Fortschritte ihres Unternehmens im Bereich „KI erzeugt KI“ öffentlich zu berichten.
Seine ursprünglichen Worte lauteten: „Es ist so spitz, dass andere denken, wir würden prahlen, wenn wir es sagen.“
Nur ein halbes Jahr später ist dieses einst geheimnisvolle Thema zum heißesten Begriff in der Branche geworden, und inländische KI-native Unternehmen konkurrieren darum, ihre eigenen Fortschritte vorzulegen.
In den Wochen von September bis Oktober tauchte RSI nacheinander auf den Pressekonferenzen verschiedener Unternehmen auf. Alibaba sprach auf der Yunqi-Konferenz über Erkundungen in der Zusammenarbeit von Training, Inferenz und Chip-Modellen. Zhipu ließ den Infra Agent sein eigenes Inferenzsystem entwerfen und optimieren. DeepSeek und MiniMax haben diesen Begriff ebenfalls in ihre technische Erzählung aufgenommen.