Das KI-Gedächtnis ist einen astronomisch hohen Preis wert.
Die Grundkosten für das KI-Gedächtnis sind inzwischen so niedrig, dass sie kaum mit dem Begriff „exorbitanter Preis“ in Verbindung gebracht werden können. Für die Standardedition von Alibaba Cloud PolarDB Agent Memory auf dem chinesischen Festland betragen die Kosten für Rechen- und Speicherressourcen pro 10.000 Gedächtniseinträgen pro Stunde 0,015 Yuan. Bei einer konstanten Anzahl von 10.000 Einträgen ergeben sich für 30 Tage Kosten von 10,8 Yuan, wobei Modellaufrufe separat berechnet werden.
Dennoch nehmen die Unternehmen, die um dieses Geschäft konkurrieren, stetig zu. ChatGPT von OpenAI, Claude und Grok von Anthropic bieten bereits personalisierte Funktionen über einzelne Konversationen hinweg an; Datenbankanbieter und unabhängige Dienstleister wollen das Gedächtnis für noch mehr Anwendungen bereitstellen. Im Oktober 2025 gab Mem0 eine kombinierte Finanzierung von 24 Millionen US-Dollar aus Seed-Runde und Serie-A-Runde bekannt, wobei die im gleichen Zeitraum offengelegte Anzahl von API-Aufrufen von 35 Millionen im ersten Quartal des Jahres auf 186 Millionen im dritten Quartal anstieg.
Was alle Seiten anstreben, sind die bereits von Nutzern und Unternehmen angesammelten Ressourcen: wiederholt vorgegebene Anforderungen, bearbeitete Ausnahmefälle, abgelehnte Lösungen und halb abgeschlossene Arbeiten. Das Speichern einiger Sätze kann sehr günstig sein, aber dass diese angesammelten Ressourcen bei der nächsten Aufgabe weiter wirken, beeinflusst, wem Nutzer die Arbeit anvertrauen und ob sie bereit sind, zu einem anderen Dienstleister zu wechseln.
Der Wert des Gedächtnisses muss sich letztendlich in fortlaufenden Arbeitsprozessen entfalten.
Chatverläufe stellen noch keine Berufserfahrung dar
KI-Anwendungen können viele Konversationen speichern, und Modelle mit langem Kontext können auch eine große Menge an Text auf einmal einlesen. Aber im vollständigen Verlauf gibt es sowohl endgültige Entscheidungen als auch aufgegebene Lösungen; sowohl langfristige Präferenzen als auch einmalige Anforderungen. Wenn die nächste Aufgabe beginnt, muss das Modell immer noch beurteilen, welche Inhalte relevant sind und welche Version gültig ist. Das Speichern des Materials erledigt nur einen einzelnen Schritt des gesamten Prozesses.
Alibaba Cloud AgentRun verwaltet Langzeitgedächtnis, Sitzungsverlauf und Sitzungsstatus getrennt voneinander. Das Langzeitgedächtnis speichert Präferenzen und Informationen über verschiedene Sitzungen hinweg, der Sitzungsverlauf behält alle vollständigen Nachrichten bei, und der Sitzungsstatus speichert Variablen und Fortschritt der aktuellen Aufgabe. Wenn der Nutzer sagt „Bitte weiter machen“, muss das System sowohl seine üblichen Anforderungen kennen als auch wissen, bis zu welchem Punkt die aktuelle Aufgabe fortgeschritten ist – es darf nicht der Abschlusszustand der vorherigen Aufgabe auf die neue Aufgabe angewendet werden.
Dieser Unterschied wird besonders deutlich, wenn sich das Projekt ändert. Wenn eine Lösung nach Diskussion abgelehnt wurde, gibt es im Verlauf immer noch viele Gründe, die sie unterstützen. Wenn nur nach Textähnlichkeit gesucht wird, kann die alte Lösung leichter gefunden werden als eine kurze Stornierungsentscheidung. Selbst wenn das System die ursprünglichen Worte korrekt wiederfindet, kann es anschließend eine Aufgabe ausführen, die nicht mehr durchgeführt werden sollte. Das Gedächtnis muss die Reihenfolge und den Geltungsbereich zwischen den Entscheidungen behalten, um die Voraussetzungen für die Umwandlung in echte Erfahrung zu schaffen.
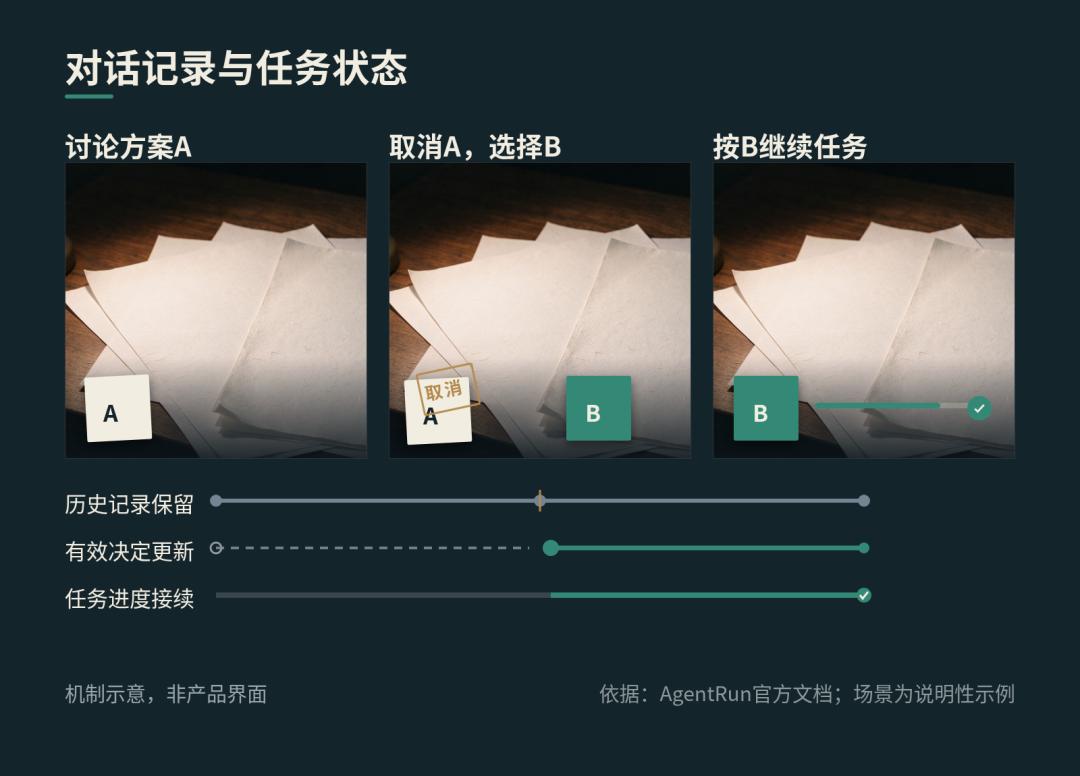
Der LongMemEval-Benchmark umfasst 500 Fragen, um Informationsextraktion, Schlussfolgerungen über verschiedene Sitzungen hinweg, zeitliche Zusammenhänge, Wissensaktualisierung und Zurückhaltung bei unbeantwortbaren Fragen zu prüfen. Bei seiner kleinen Version umfasst ein einzelner Testverlauf etwa 40 Sitzungen und 115.000 Token. Einen Namen zu finden und zu erkennen, dass diese Person später ihre Aufgaben gewechselt hat, sind unterschiedliche Anforderungen. Eine dauerhaft genutzte KI muss mit letzterer Art von Veränderungen umgehen können.
Weniger Material lesen, aber auch keine Bedingungen verlieren
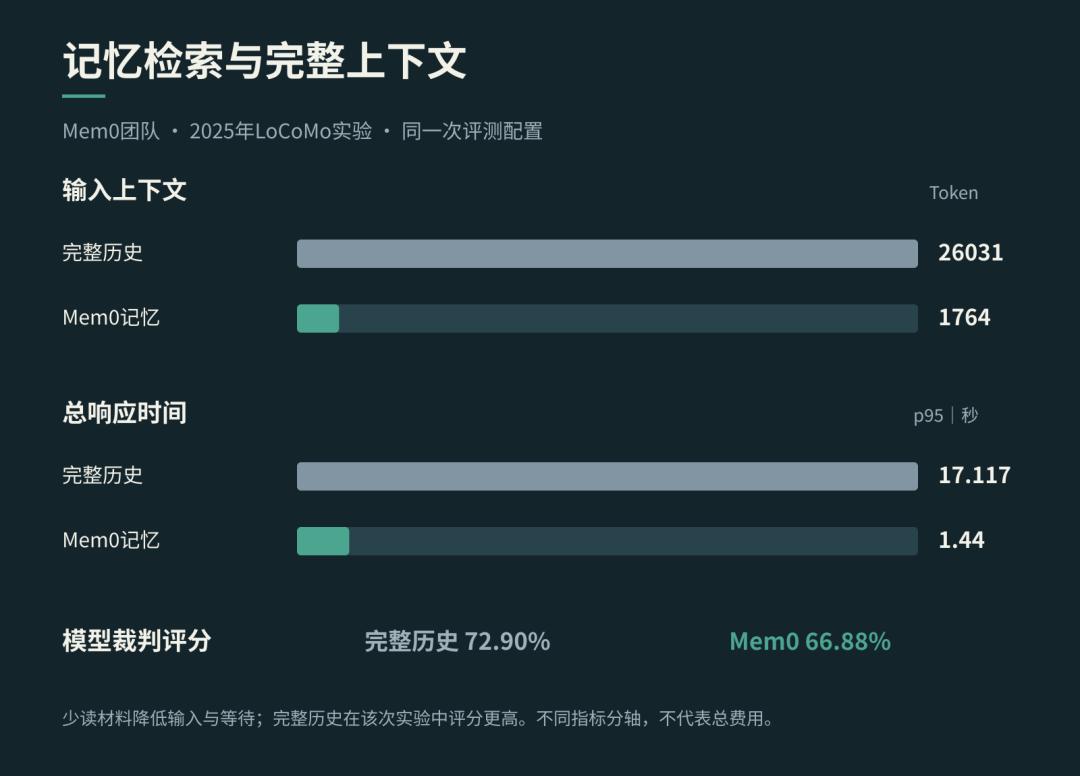
Wenn der vollständige Verlauf wiederholt an das Modell übergeben wird, treten zuerst Kosten für Eingabe und Wartezeit auf. Im LoCoMo-Experiment des Mem0-Teams im Jahr 2025 verwendete die Lösung mit vollständigem Kontext bei jeder Abfrage etwa 26031 Token, während die Mem0-Gedächtnislösung nur 1764 Token nutzte. Das 95. Perzentil der gesamten Antwortzeit betrug 17,117 Sekunden bzw. 1,440 Sekunden, was bedeutet, dass etwa 95 % der Anfragen innerhalb der entsprechenden Zeit abgeschlossen wurden.
Aber die Bewertung des Modellrichters für die Lösung mit vollständigem Kontext lag bei 72,90 %, während Mem0 66,88 % erreichte. Diese Ergebnisse zeigen einen klaren Kompromiss: Die Abfrage aus dem Gedächtnis reduziert Eingabe und Wartezeit erheblich, während der vollständige Verlauf in diesem Experiment noch eine höhere Punktzahl erzielte. Weniger Material zu lesen bringt Vorteile, birgt aber auch das Risiko, Bedingungen zu übersehen.
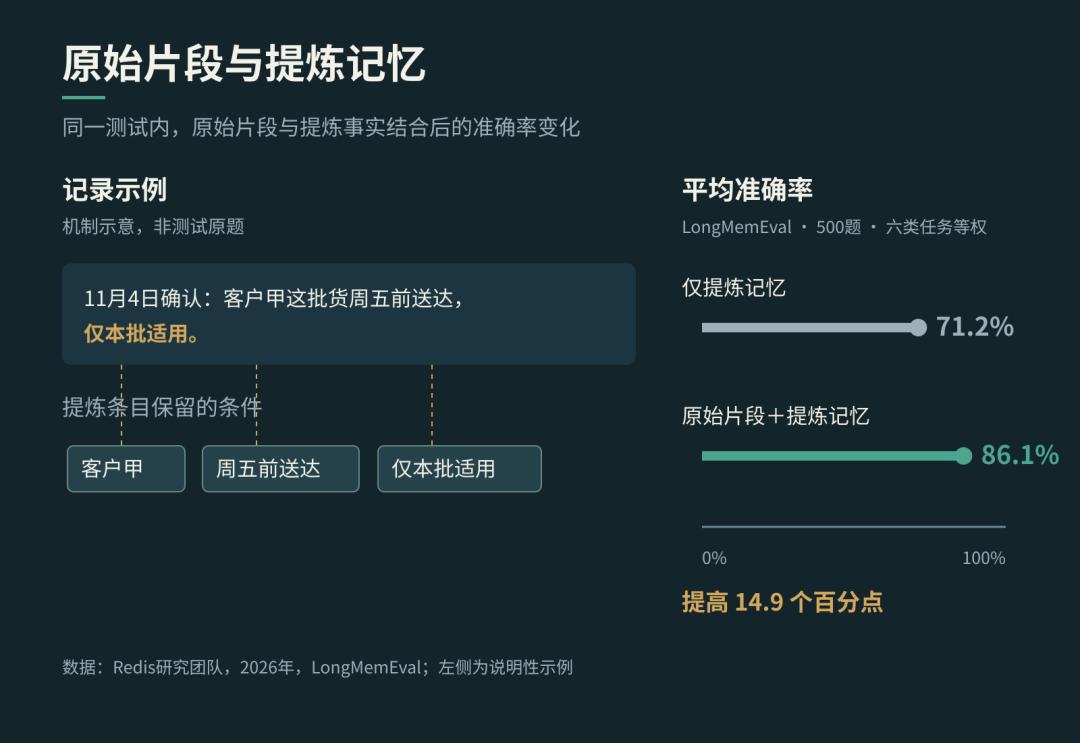
Wie Effizienz und Details miteinander vereinbart werden können, ist der Teil, der sich mehr Investitionen lohnt. Bei dem LongMemEval-Test, der das Redis-Forschungsteam im Jahr 2026 veröffentlichte, lag die durchschnittliche Genauigkeit von sechs Aufgabentypen bei 71,2 %, wenn nur extrahiertes Gedächtnis verwendet wurde. Wenn gleichzeitig ursprüngliche Fragmente und extrahierte Fakten abgefragt wurden, erreichte die Genauigkeit 86,1 %. Der Test umfasste 500 Fragen und nutzte die Bewertung durch Modellrichter, wobei der Unterschied zwischen den beiden Konfigurationen 14,9 Prozentpunkte betrug.
Extrahierte Fakten eignen sich zum Zusammenführen von Informationen über verschiedene Sitzungen hinweg und zum Ordnen von Veränderungen, während ursprüngliche Fragmente Namen, Daten und genaue Formulierungen behalten, die in einer Zusammenfassung leicht weggelassen werden könnten. Eine einzelne Ausnahme mag damals unbedeutend erscheinen, aber sie kann bei der nächsten Aufgabe genau darüber entscheiden, ob die Aufgabe ausgeführt werden kann. Die Speicherung ursprünglicher Inhalte bietet die Möglichkeit, später bei der Beurteilung auf das Material zurückzugreifen. Die beiden Studien verwenden unterschiedliche Tests und Konfigurationen, beantworten jeweils die Kosten des Lesens von weniger Material und wie Informationsverluste reduziert werden können – sie lassen sich nicht zu einem Ranking verschiedener Produkte zusammenfügen.
Für Unternehmen zählen letztendlich auch Wartungs- und Nacharbeitskosten. Wenn dieselben Anforderungen in nachfolgenden Aufgaben mehrfach aufgerufen werden, kann die vorherige Organisation wiederholt verwendet werden. Je häufiger Dokumente geändert werden, desto höher steigen auch die Aufwendungen für Extraktion, Indizierung und Aktualisierung. Caching kann die Kosten für wiederholte Eingaben senken, aber die Abfrage selbst muss ebenfalls berechnet werden – die Rechnung wird nicht nur aus einer einzigen Speichergebühr bestehen.
Größere Verluste können nach der Generierung der Antwort auftreten. Wenn eine Lieferbedingung übersehen wird, sind anschließende Nachfragen, Neuerstellungen und manuelle Korrekturen erforderlich, sodass die eingesparten Token durch Nacharbeit aufgezehrt werden. Was Einkäufer wirklich interessiert, ist, wie viel Zeit und Kosten insgesamt für eine Arbeit aufgewendet werden, von der Übergabe an die KI bis zum Abschluss. Nur wenn der Gesamtrechnungsbetrag durch den Gedächtnisdienst besser gestaltet wird, bekommt der niedrige Speicherpreis eine wirtschaftliche Bedeutung.
Drei KI-Anbieter sammeln alle das Wissen über ihre Nutzer an
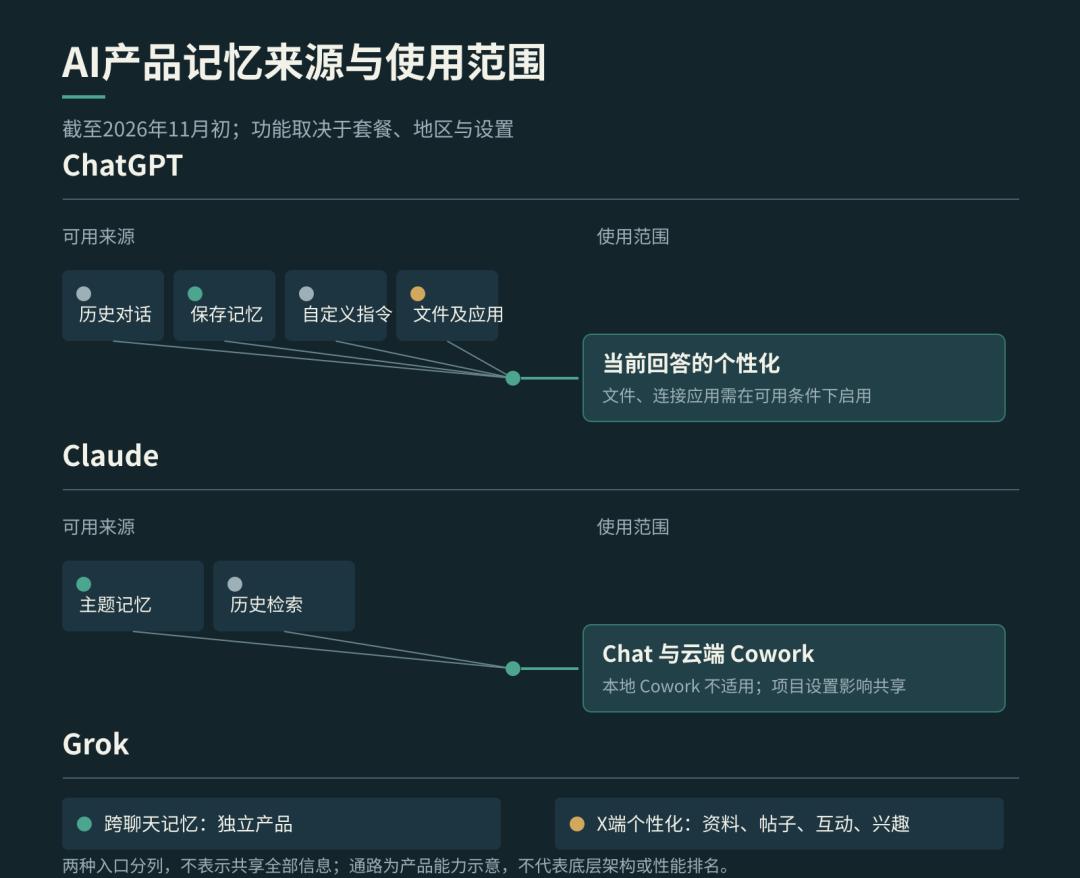
Diese technischen Entscheidungen sind bereits in alltägliche Produkte eingegangen. ChatGPT von OpenAI kann historische Konversationen, gespeicherte Gedächtniseinträge und benutzerdefinierte Anweisungen verwenden; unter unterstützten Tarifen, Regionen und Einstellungen können auch gespeicherte Dateien und Inhalte verbundener Anwendungen genutzt werden. Es bietet Gedächtniszusammenfassungen und kann die Quellen, die zur Personalisierung beitragen, unterhalb der Antwort anzeigen, sodass Nutzer sie nachvollziehen oder korrigieren können – aber Zusammenfassungen und Quellen stellen keine vollständige Liste dar.
Daher stammen die Materialien zur Kenntnis des Nutzers nicht mehr nur aus dem Chatfenster. Projektänderungen in E-Mails und gespeicherte Arbeitsdateien können der KI helfen, die Aufgabe fortzusetzen. Mit mehr Quellen wird die Fehlerkorrektur auch komplexer: Nach der Änderung einer Zusammenfassung können alte Informationen immer noch in einer E-Mail oder einem Dokument verbleiben. Nutzer müssen nachvollziehen können, woher der Fehler stammt, und Dienstleister müssen die Beziehungen zwischen verschiedenen Quellen verwalten.
Claude von Anthropic bietet das thematisch gespeicherte Gedächtnis und die Abfrage historischer Konversationen getrennt voneinander an. Die aktuelle Version kann Gedächtniseinträge während des Chats speichern und alte Konversationen durchsuchen, wobei die Abfrage als Toolaufruf angezeigt wird. Chat und cloudbasierter Cowork können das gleiche Gedächtnis gemeinsam nutzen, während lokal ausgeführter Cowork dies vorerst nicht unterstützt. Ob das Projektgedächtnis und das Kontogedächtnis miteinander kommunizieren können, hängt von den entsprechenden Einstellungen ab.
Diese Anordnung verbindet „das Merken von Anforderungen“ mit „dem Nachschlagen der ursprünglichen Worte“ und ermöglicht es der angesammelten Erfahrung, mit dem Arbeitsablauf weiterzuwandern. Wenn Nutzer von der Diskussion zur Ausführung der Aufgabe wechseln, können die zuvor vorgegebene Schreibweise und der Projekthintergrund weiterverwendet werden. Dies stimmt mit den vorherigen Forschungsrichtungen überein – aber dass das Produkt diese Zugänge bietet, bedeutet nicht, dass Informationen jedes Mal korrekt extrahiert und aufgerufen werden können. Die tatsächliche Wirkung muss immer noch in fortlaufenden Aufgaben geprüft werden.
Auf der offiziellen Website von Grok wird ebenfalls das Gedächtnis über verschiedene Chats hinweg aufgeführt, das Präferenzen und vergangene Konversationen merken kann. Auf der X-Plattform gibt es einen weiteren Personalisierungsmechanismus: Unter entsprechender Autorisierung können Informationen wie öffentliche Profile, Beiträge, Interaktionen und Interessen zur Personalisierung verwendet werden, und es gibt unabhängige Steuerungselemente. Dies hat einen anderen Zweck als die Echtzeitsuche im Internet und in öffentlichen Beiträgen: Die Suche ergänzt externe laufende Ereignisse, während das persönliche Gedächtnis dem System hilft, die vorherigen Anforderungen und Entscheidungen des Nutzers zu verstehen.
Die drei Anbieter unterscheiden sich in Informationsquellen und Steuerungsmethoden, aber ihr gemeinsames Ziel ist es, die wiederholte Arbeit des Nutzers bei der Vorstellung von Anforderungen zu reduzieren. Hier wird erörtert, wie Produkte den Kontext speichern und verwenden – es geht nicht darum, dass das Modell jede einzelne persönliche Information dauerhaft in seine Gewichtungen schreibt. Die Kontinuität, die Nutzer erleben, stammt aus der gemeinsamen Arbeit von Modell und peripheren Systemen.
Dies erhöht auch den Wettbewerbsdruck für unabhängige Gedächtnisdienste. Wenn die Anforderung nur darin besteht, Beruf, Schreibweise und häufig genutzte Tools zu merken, reichen die integrierten Funktionen der Plattform möglicherweise bereits aus. Der Grund, warum Drittanbieter weiterhin Gebühren verlangen können, liegt in komplexeren Arbeitsabläufen: Ob mehrere Modelle dieselbe Erfahrung nutzen können, ob verschiedene Mitglieder nach Berechtigungen darauf zugreifen können und ob die Informationen nach Geschäftsänderungen rechtzeitig korrigiert werden können. Nachdem das Speichern von Präferenzen zu einer grundlegenden Fähigkeit geworden ist, ist die zuverlässige Wiederverwendung angesammelter Arbeitserfahrungen schwerer zu ersetzen.
Unternehmen brauchen korrigierbare Erfahrungen
Datenbankanbieter haben hier ihre eigene Position. Die Informationen, die Unternehmen von der KI merken lassen wollen, sind oft bereits mit dem tatsächlichen Geschäft verbunden, und Aktualisierungen finden auch in den Geschäftssystemen statt.
Die Produktbeschreibung von Oracle Agent Memory nennt ein Logistikszenario: Ein Werk benötigt jede Woche bestimmte Materialien, Transportpersonal muss über entsprechende Qualifikationen verfügen, und die Lieferung muss vor einem festgelegten Zeitpunkt abgeschlossen werden. Diese Anforderungen müssen in mehreren Planungsrunden beibehalten werden und sich mit dem Geschäft weiter aktualisieren. Nachdem ein Satz gespeichert wurde, muss das System wissen, zu welchem Werk, welcher Warencharge und welchem Gültigkeitszeitraum er gehört.
Wenn der Gedächtnisdienst eine separate Kopie der Anforderung speichert, muss sich diese Kopie ändern, nachdem das Geschäftssystem aktualisiert wurde. Andernfalls kann die KI sehr geübt einen bereits abgelaufenen Ablauf planen. Oracle listet Aktualisierung, Ablauf und kaskadierte Löschung als Produktfunktionen auf; Tencent Cloud Agent Memory unterscheidet persönliches, Agent- und Teamgedächtnis, wobei die gemeinsame Nutzung durch das Team eine ausdrückliche Autorisierung erfordert und standardmäßig privat ist.
Ob eine Erfahrung wiederverwendet werden kann, hängt daher nicht nur davon ab, ob ihr Inhalt korrekt ist. Wenn die besonderen Anforderungen eines bestimmten Kunden ihre Zugehörigkeit verlieren, können sie fälschlicherweise auf andere Kunden angewendet werden; wenn eine einmalige vorübergehende Ausnahme als allgemeine Teamregel gespeichert wird, können nachfolgende Agenten sie dauerhaft befolgen. Das Gedächtnis sorgt dafür, dass korrekte Vorgehensweisen leicht fortgesetzt werden können, aber es lässt auch Fehler länger verbreiten.
Das macht Berechtigungen, Versionen und Herkunft zu einem Teil des Dienstes. Wenn Nutzer Probleme feststellen, müssen sie unterscheiden können, ob die ursprüngliche Information falsch ist, ob bei der Extraktion Bedingungen übersehen wurden, ob bei der Abfrage die falsche Version ausgewählt wurde oder ob das Modell ein Verständnisproblem hat. Für verschiedene Schritte sind unterschiedliche Korrekturmethoden erforderlich. Der Wechsel zu einem größeren Modell garantiert nicht, dass die vorherigen Probleme bei Speicherung und Abfrage automatisch verschwinden.
Nur Gedächtnisdienste, die diese Beziehungen verarbeiten können, können zu einer Infrastruktur werden, die Unternehmen langfristig nutzen. Kunden zahlen nicht nur für die Anzahl der gespeicherten Informationen, sondern auch dafür, dass alte Regeln nach Aktualisierungen rechtzeitig außer Kraft gesetzt werden, Fehler nachvollzogen werden können und die Informationen nach Widerruf der Autoris