Lei Jun hat kürzlich veröffentlicht: Xiaomi-Roboter produzieren Xiaomi-Autos.
Ihr Xiaomi-Auto wird derzeit von Xiaomi-Robotern hergestellt und gefertigt:
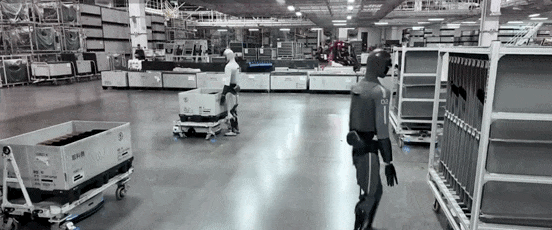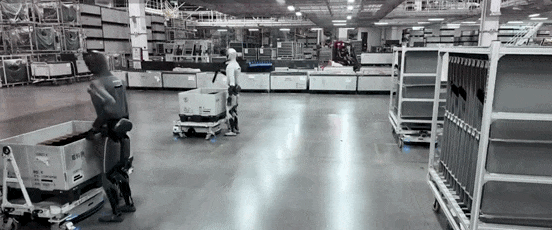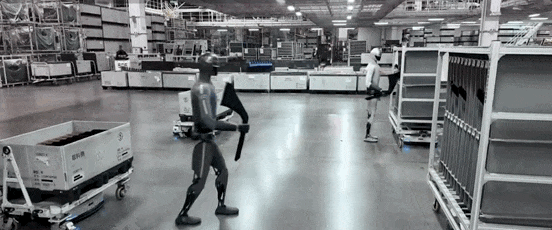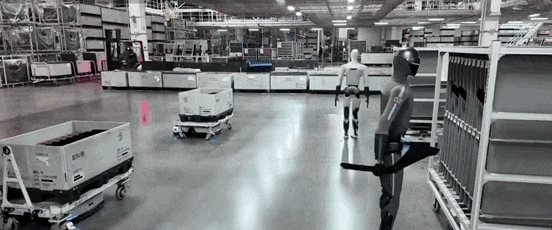
Gerade hat Lei Jun, Gründer von Xiaomi, persönlich die neuesten Fortschritte bekannt gegeben:
Der humanoide Roboter von Xiaomi hat erstmals in der Automobilfabrik die stabile Arbeit von 8 Stunden gemeistert und erfüllt vollständig die Anforderungen der ganztägigen Produktion.
Für Xiaomi ist dies ein Höhepunkt, bei dem erstmals die Grenzlinie der Embodied Intelligence überschritten wurde.
Auf der anderen Seite ist es ziemlich amüsant: In großen Technologieunternehmen ist es ausgerechnet der Roboter, der als Erster das „8-Stunden-Arbeitszeitmodell“ umsetzt
Xiaomi-Roboter, das „8-Stunden-Arbeitszeitmodell“
Man muss sagen, dass reale Szenarien tatsächlich die beste Baseline sind~
Im Juli wurde ein Video veröffentlicht, das zeigt, wie Xiaomi-Roboter in der Fabrik arbeiten. Man konnte noch „Mängel“ erkennen, wie zum Beispiel Zittern oder Stocken.
Aber in dem neuesten Material kann CyberOne 02 bereits 8 Stunden lang kontinuierlich Aufgaben in der Automobilmontagewerkstatt erledigen:
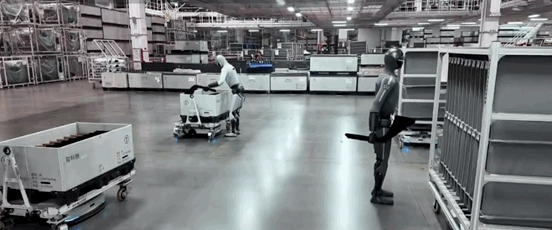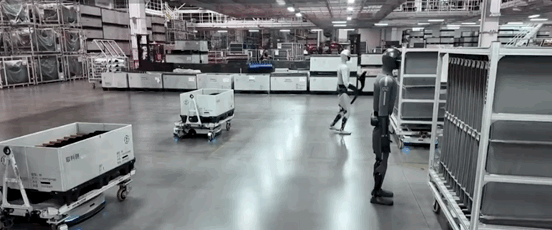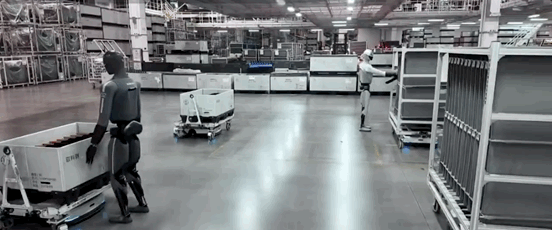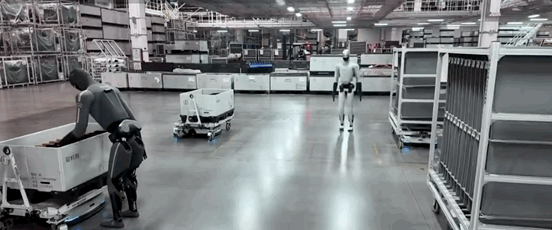
Der Arbeitsplatz ist die Sortierung der Seitenabdeckungen des Armaturenbretts im Logistikbereich der Automobilgesamtmontage. Die Abdeckungen gehören zu flexiblen Werkstücken, sind groß, haben unregelmäßige Formen und zufällige Platzierungspositionen. Die Anforderungen an die visuelle Lokalisierung und die Greifkraftsteuerung sind höher als bei standardisierten Strukturteilen.
CyberOne 02 läuft 8 Stunden lang im Takt der Produktionslinie und passt automatisch seine Entnahmeroute und Schrittweite an, wenn das AMR, das die Teile anliefert, sich bewegt:
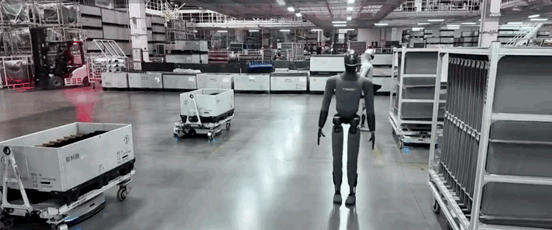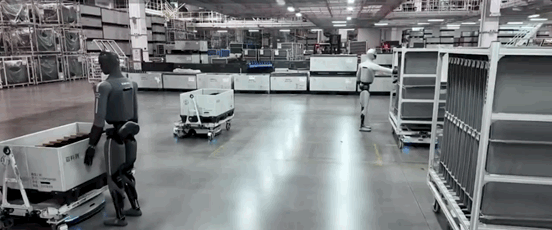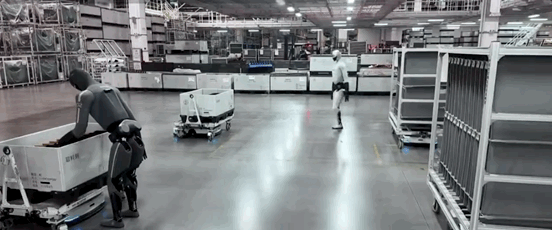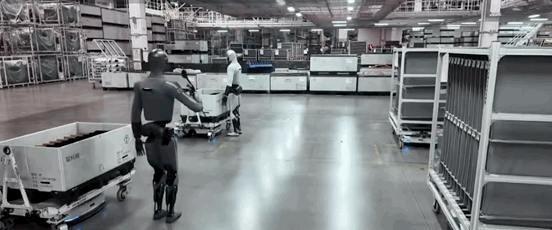
Wenn das AMR seinen Arbeitsplatz wechselt, wartet CyberOne 02 geduldig. Bei Abweichungen der angelieferten Teile oder fehlgeschlagener Platzierung kann es sich selbst anpassen:
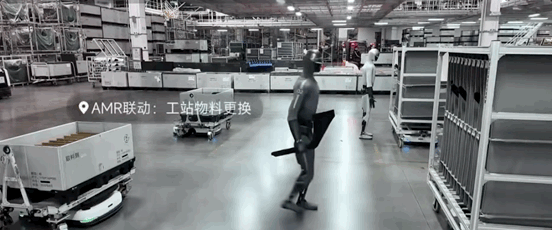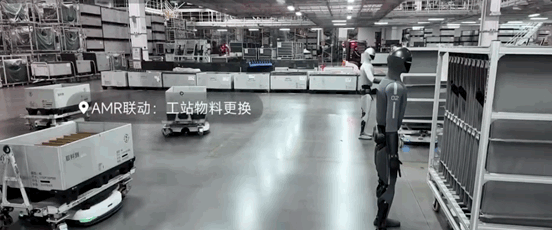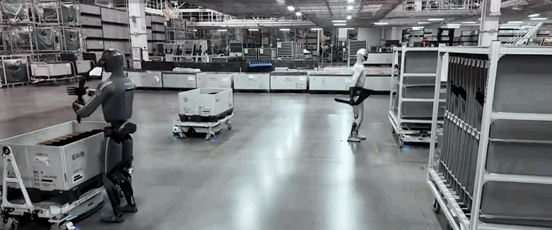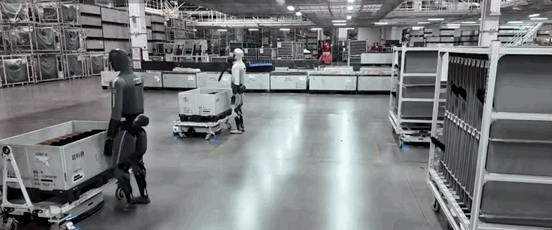
Lei Jun ist sehr bescheiden und definiert diese Phase als „Praktikum“ des Roboters, eine erste Überprüfung der Fähigkeit zur Arbeit auf Produktionsebene.
Neben der Fabrik erwähnte er noch ein weiteres Szenario:
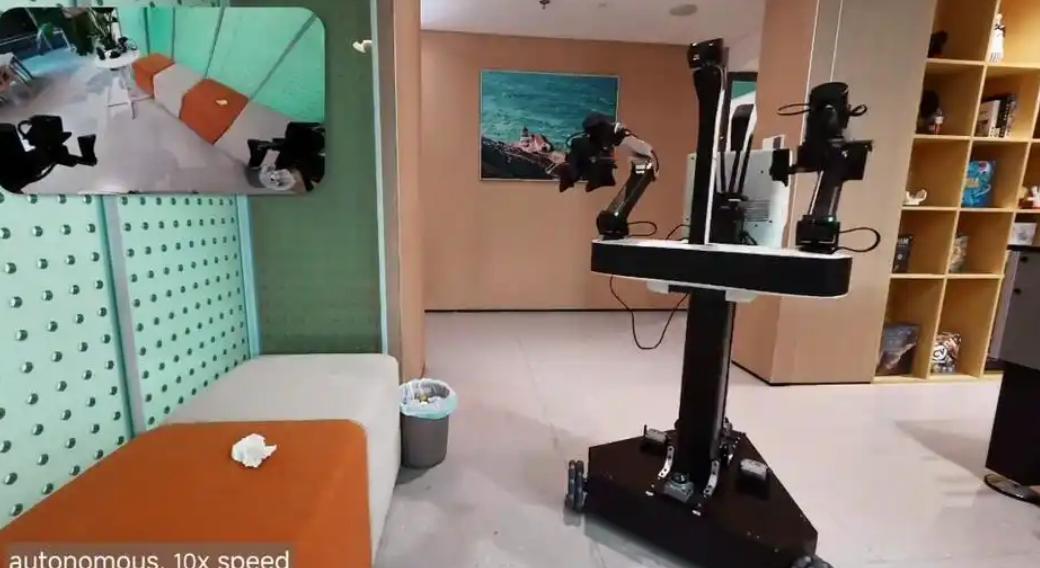
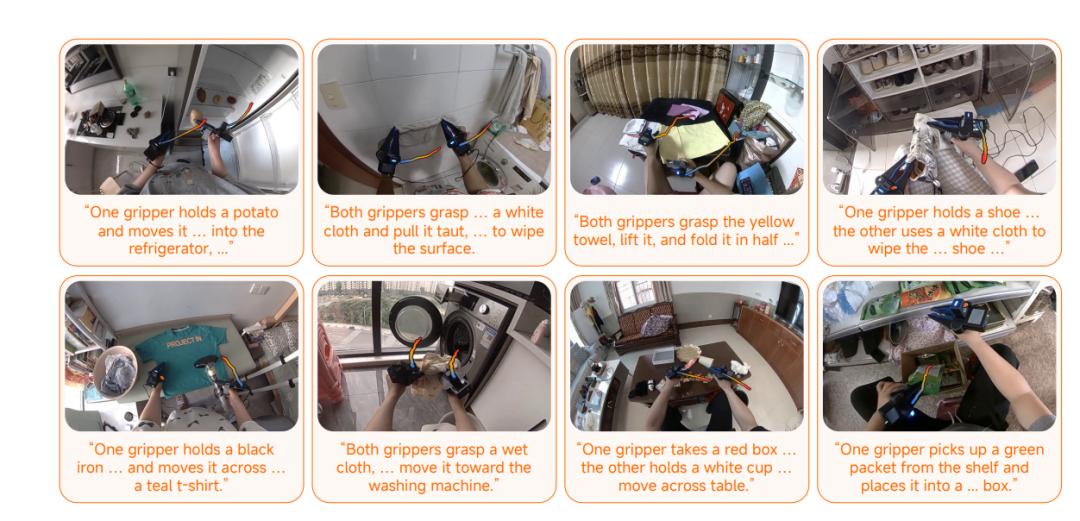
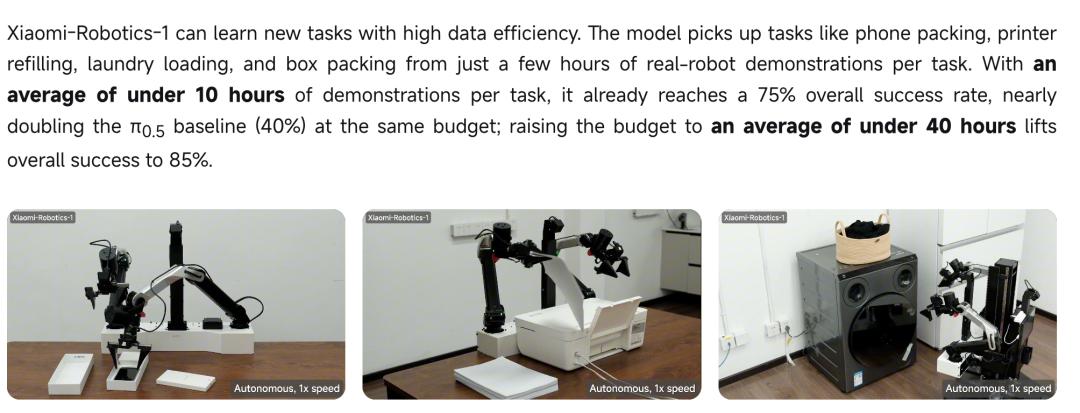
In den Xiaomi-Jugendwohnungen wurde eine Langzeitaufgabenüberprüfung mit einer Dauer von über 30 Minuten, die 3 Räume abdeckt und mehr als 50 Aufgaben umfasst, erfolgreich durchgeführt.
Es kann vollständige Aufgaben selbstständig planen und ausführen, die Schritte wie Werkzeugvorbereitung, Aufräumen von Sofa und Tisch, Müllbeseitigung, Sortieren und Zurücklegen von Gegenständen, Rauminspektion, vollständige Überprüfung der gesamten Wohnung und Verlassen des Ortes umfassen.
Die Szenarien für Geschäfts- und Privatkunden entwickeln sich beide gut. Im Vergleich zu dem früheren CyberDog von Xiaomi macht die Embodied Intelligence von Xiaomi den Eindruck, dass sie sich nach kurzer Zeit enorm weiterentwickelt hat.
Und Lei Jun betonte, dass hinter allen Szenarien dasselbe grundlegende Modell für Embodied Intelligence steht.
Wie weit sind die technischen Fortschritte der Embodied Intelligence von Xiaomi?
Der CyberOne 02 Roboter, der in der Xiaomi-Automobilfabrik arbeitet, nutzt offiziell das neueste grundlegende Embodied-Modell von Xiaomi, Xiaomi-Robotics-1.
Und dies ist eine typische Forschung, bei der man „mit einem Problem nach einer Lösung sucht“.
Embodied Intelligence steht seit langem vor einem praktischen Problem: Es ist für Roboter sehr schwierig, so einfach wie Sprachmodelle genügend Trainingsdaten zu erhalten: Um eine bestimmte Bewegung oder Aufgabe zu erlernen, muss ein echter Roboter in der physischen Umgebung wiederholt ausführen, und dann werden Daten durch Fernsteuerung und andere Methoden erfasst;
Aber wenn Roboter in der physischen Umgebung wiederholt bestimmte Aufgaben ausführen, müssen sie diese Aufgabe bereits beherrschen… Die Datengeschlossene Schleife der Embodied Intelligence hat bis heute keinen allgemein anerkannten effizienten Startpfad.
Sie könnten sagen, dass menschliche Bedienung doch die beste Datenquelle ist. Ehrlich gesagt, hat das autonome Fahren diesen Fehler schon einmal gemacht, und die Embodied Intelligence wird nicht noch einmal darauf hereinfallen.
Abgesehen von dem Kostenproblem: Selbst wenn es ein Datenerfassungsprodukt gäbe, das jeder braucht und das man jeden Tag trägt, wie kann man dann sicherstellen, dass der Anteil der effizienten Daten, die zur Lösung kritischer Sonderfälle (Corner Cases) benötigt werden, in den zurückgegebenen Daten ausreichend ist?
Wenn man speziell Personen anstellt, um gezielt Daten zu erfassen, stößt man wieder auf das Kostenproblem. Daher können menschliche Daten zur Verstärkung und Unterstützung kritischer Fälle verwendet werden, aber sie sind kaum die Hauptdatenquelle für die Verbesserung und Iteration des Grundmodells.
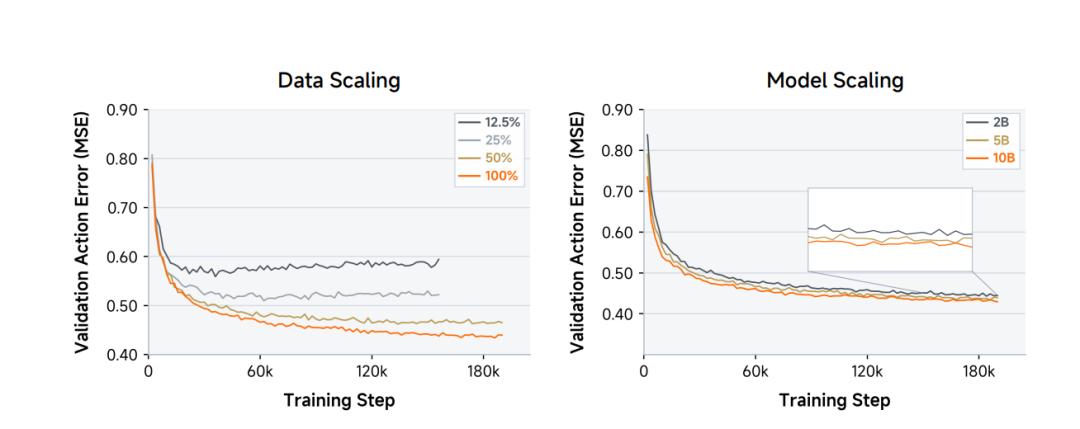
Was Xiaomi XR-1 zu lösen versucht, ist genau das Problem, wie Embodied Intelligence große Mengen an vortrainierten Daten erhält. Mit anderen Worten, es wird versucht, das bereits im Bereich der großen Modelle aufgetretene Scaling Law nachzuahmen.
Genauer gesagt verwendet XR-1 in der Modellarchitektur eine End-to-End-VLA-Architektur (Vision-Language-Action) und führt das Mixture-of-Transformers (MoT)-Design ein.
Einfach ausgedrückt muss VLA drei Glieder verbinden: Der Roboter erfasst Umgebungsinformationen durch das Sehen, versteht das Aufgabenziel anhand von Sprachbefehlen und generiert schließlich ausführbare Aktionen.
XR-1 unterteilt diesen Prozess in zwei miteinander gekoppelte Kernkomponenten: das visuelle Sprachrückgrat und den Aktionsgenerationskopf.
Das visuelle Sprachrückgrat verwendet das vortrainierte Qwen3-VL, das hauptsächlich dafür verantwortlich ist, die Szene, die der Roboter gerade sieht, und die vom Benutzer gegebenen Sprachbefehle zu verstehen. Es liefert Informationen auf visueller und semantischer Ebene und hilft dem Modell, den aktuellen Umgebungszustand und die Aufgabenanforderungen zu beurteilen.
Der Teil der Aktionsgenerierung verwendet den Diffusion Transformer (DiT). Er nutzt den Zustand des Roboters selbst und den KV-Cache, der vom visuellen Sprachmodell bereitgestellt wird, als Bedingung und generiert durch Flow Matching eine Aktionssequenz für einen zukünftigen Zeitraum, nämlich das Action Chunk.
Die Architektur hat eine klare Aufgabenteilung: Qwen3-VL ist für das Verständnis von Umgebung und Aufgabe verantwortlich, DiT wandelt die Verständnisergebnisse in kontinuierliche Aktionen um, und beide arbeiten über die MoT-Architektur zusammen, um das End-to-End-VLA-Modell zu bilden.
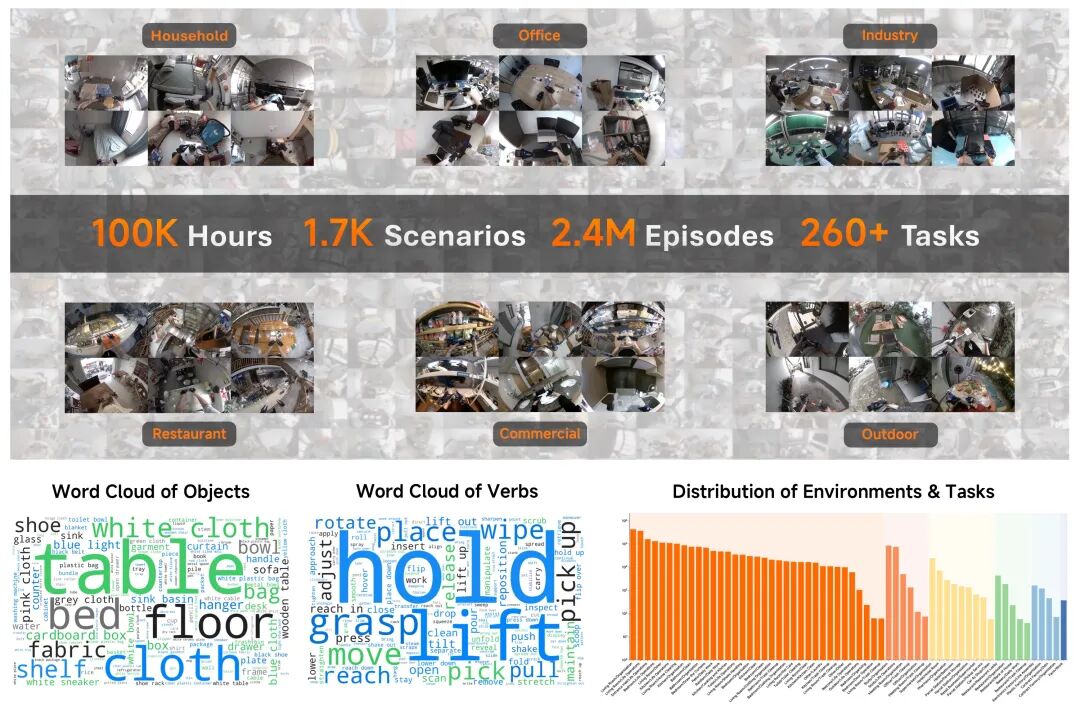
Nachdem das Modell fertig ist, verwendet XR-1 in der Trainingsphase ein zweistufiges Paradigma. Die erste Stufe ist das Embodiment-freie Vortraining. Xiaomi verwendet UMI-Geräte, um mehr als 100.000 Stunden an echten menschlichen Bedienungstrajektorien zu erfassen.
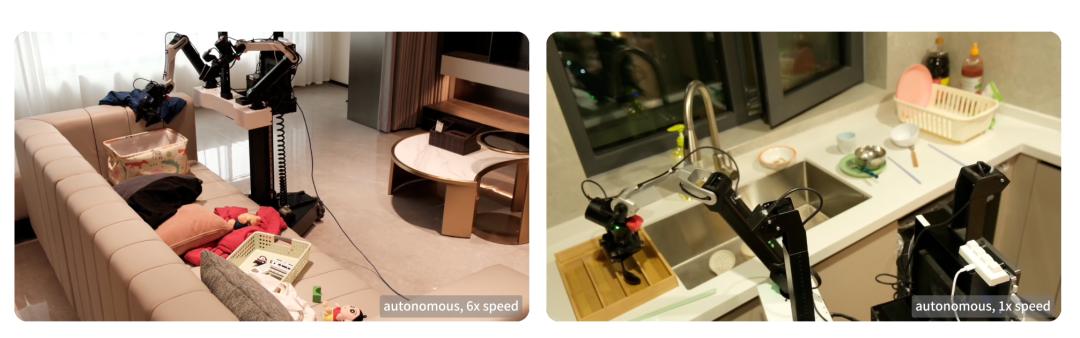
UMI kann als kostengünstiges handgehaltenes Gerät zur Erfassung von Betriebsdaten verstanden werden, das aus Komponenten wie Greifern und Handgelenkskameras besteht. Das Xiaomi-Team nutzt dieses Gerät, um in der realen Umgebung Vorgänge wie Greifen, Bewegen und Platzieren auszuführen, und das System zeichnet gleichzeitig visuelle Informationen und Betriebstrajektorien auf – die Erfassung von Daten muss nicht an einen bestimmten Roboter gebunden sein, der Kern ist es, die Beziehungen zwischen verschiedenen Elementen der Aufgabenausführung aufzuzeichnen.
Nach Abschluss des Vortrainings tritt XR-1 in die zweite Stufe ein: das Cross-embodiment Post-Training: Das Modell passt sich durch diese Daten schrittweise der Körperstruktur, den Bewegungsmöglichkeiten und der Steuerungsmethode des spezifischen Roboters an und lernt gleichzeitig Aufgabenbefehle, die für Menschen gewohnter sind.
Das ist der eigentliche Kernpunkt von Xiaomi XR-1 – die Anpassung, nämlich diesen körperlosen Aktionsabsichten eine physische Schnittstelle zu geben, die alle Roboter gemeinsam nutzen können.
XR-1 wählt die Aktionsetiketten einheitlich als delta EE Pose (relative inkrementelle Endeffektor-Pose) aus, was bedeutet, dass nur beschrieben wird, in welche Richtung sich der Endeffektor wie weit verschiebt und um welche Achse er sich wie weit dreht.
Derselbe Typ von Bedienungsabsicht entspricht bei verschiedenen Robotern unterschiedlichen Gelenktrajektorien, aber ihre delta EE Pose ist ähnlich.
Das Modell lernt auf dieser gemeinsam genutzten Darstellung, sodass für das Post-Training kein unabhängiges Aktionsvokabular für jeden Roboter gepflegt werden muss.
Aber die delta EE Pose vereinheitlicht nur das Schreibformat der Aktionen und löst nicht das Problem der kinematischen Machbarkeit. Beim Post-Training können echte Roboterdaten diese nicht machbaren Abbildungen aufdecken, sodass das Modell lernt, sie zu vermeiden.
Das ist die zweite Ebene der Körperausrichtung: Die gemeinsam genutzte Darstellung bietet einen einheitlichen Koordinatenrahmen, und die Daten des echten Roboters beschränken die Befehle in diesem Rahmen auf den Unterraum, den der spezifische Roboter tatsächlich erreichen kann.
Die Anpassung auf Netzwerkebene erfolgt durch schichtweises Feintuning.
Die Daten für das Post-Training betragen etwa 10.000 Stunden, davon stammen mehr als 7.200 Stunden von selbst erfassten echten Roboterdaten von Xiaomi. Diese Menge reicht natürlich nicht aus, um das Modell von Grund auf neu zu trainieren, aber ihre Rolle ist die Kalibrierung: Die letzten Schichten des visuellen Encoders werden adaptiv feinabgestimmt, sodass die Merkmale von der Ausrichtung auf semantische Kategorien zu einer Ausrichtung auf physische Interaktionen verschoben werden und mehr Aufmerksamkeit auf greifbare Teile und räumliche Beziehungen gelegt wird;
Gleichzeitig passt der Aktionsgenerationskopf DiT die Ausgabeverteilung an den körperübergreifenden Daten an, sodass die generierte delta EE-Pose-Sequenz näher an dem erreichbaren Bereich des Zielkörpers liegt.
Das Kernwissen des Qwen3-VL-Rückgrats wird beibehalten, es wird nur eine Anpassung auf Schnittstellenebene vorgenommen.
Daher bedeutet