Mietet man 30 Wohnungen nur zum Trainieren? Die Roboter sind noch nicht verkauft, aber das Geschäft mit dem Datenverkauf boomt bereits im Voraus.
Wer hätte gedacht, dass die erste breite Öffentlichkeitswirkung der Datenerfassung für körpergebundene KI ausgerechnet durch einen Pannenfall bei der Wohnungsanmietung entsteht.
Kürzlich tauchte eine Nachricht in den Trending Topics auf: Jemand hat auf einen Schlag 30 Wohnungen gemietet, und jede Wohnung wurde nur etwa eine Woche lang gemietet. Die Makler hielten dies zunächst für einen neuen Betrugsstreich oder illegale Machenschaften. Nach umfassenden Untersuchungen stellte sich heraus, dass die vielen Wohnungen nur gemietet wurden, um Szenarien aufzubauen und Trainingsdaten für humanoide Roboter zu erfassen.
Ist diese Branche bei der Datenerfassung bereits so weit im Wettbewerb angekommen? Lei Technology (ID: leitech) stellte fest, dass solche Geschichten kein Einzelfall sind.
Mit der zunehmenden Beliebtheit der Strecke für körpergebundene KI tauchen eine Reihe von Unternehmen auf, die speziell Roboter mit Dienstleistungen für Datenerfassung, Datenmarkierung und Training versorgen.
Einige bauen Roboter-Trainingsplätze mit Tausenden von Quadratmetern, andere verteilen Erfassungsgeräte an normale Menschen, damit diese beim Erledigen von Hausarbeiten nebenbei Daten für Roboter erfassen, und wieder andere dehnen ihr Geschäft direkt auf Dutzende von Städten im ganzen Land aus.
Während die Roboter selbst noch nach kommerziellen Anwendungszenarien suchen, hat sich die Datenerfassungsarbeit rund um das Erlernen von Fähigkeiten bereits zu einem lebhaften Bereich entwickelt.
Die Roboter sind noch nicht zu Hause, aber eine Gruppe von Menschen, die ihnen das Arbeiten beibringen, verdient bereits damit
Daten bedeuten alles. Ein wichtiger Grund für die rasante Entwicklung großer Sprachmodelle in den letzten Jahren ist die riesige Menge an Texten, Bildern und Videos im Internet.
Sowohl Webseiten, Bücher als auch Inhalte auf sozialen Plattformen können zu Lernmaterialien für Modelle werden. Obwohl diese Daten auch gefiltert, bereinigt und markiert werden müssen, sind die Zugangskanäle zumindest relativ vielfältig.
Roboter haben da nicht so viel Glück.
Menschen können Wissen über Texte und Videos erlernen, aber wenn Roboter eine physische Aufgabe wirklich erledigen wollen, reicht es nicht aus, nur zu wissen, wie es geht. Sie müssen die Position, Form und das Gewicht von Objekten verstehen, wissen, an welche Stelle der Arm bewegt werden soll, wie viel Kraft beim Greifen erforderlich ist und wie sie sich bei unerwarteten Situationen anpassen müssen.
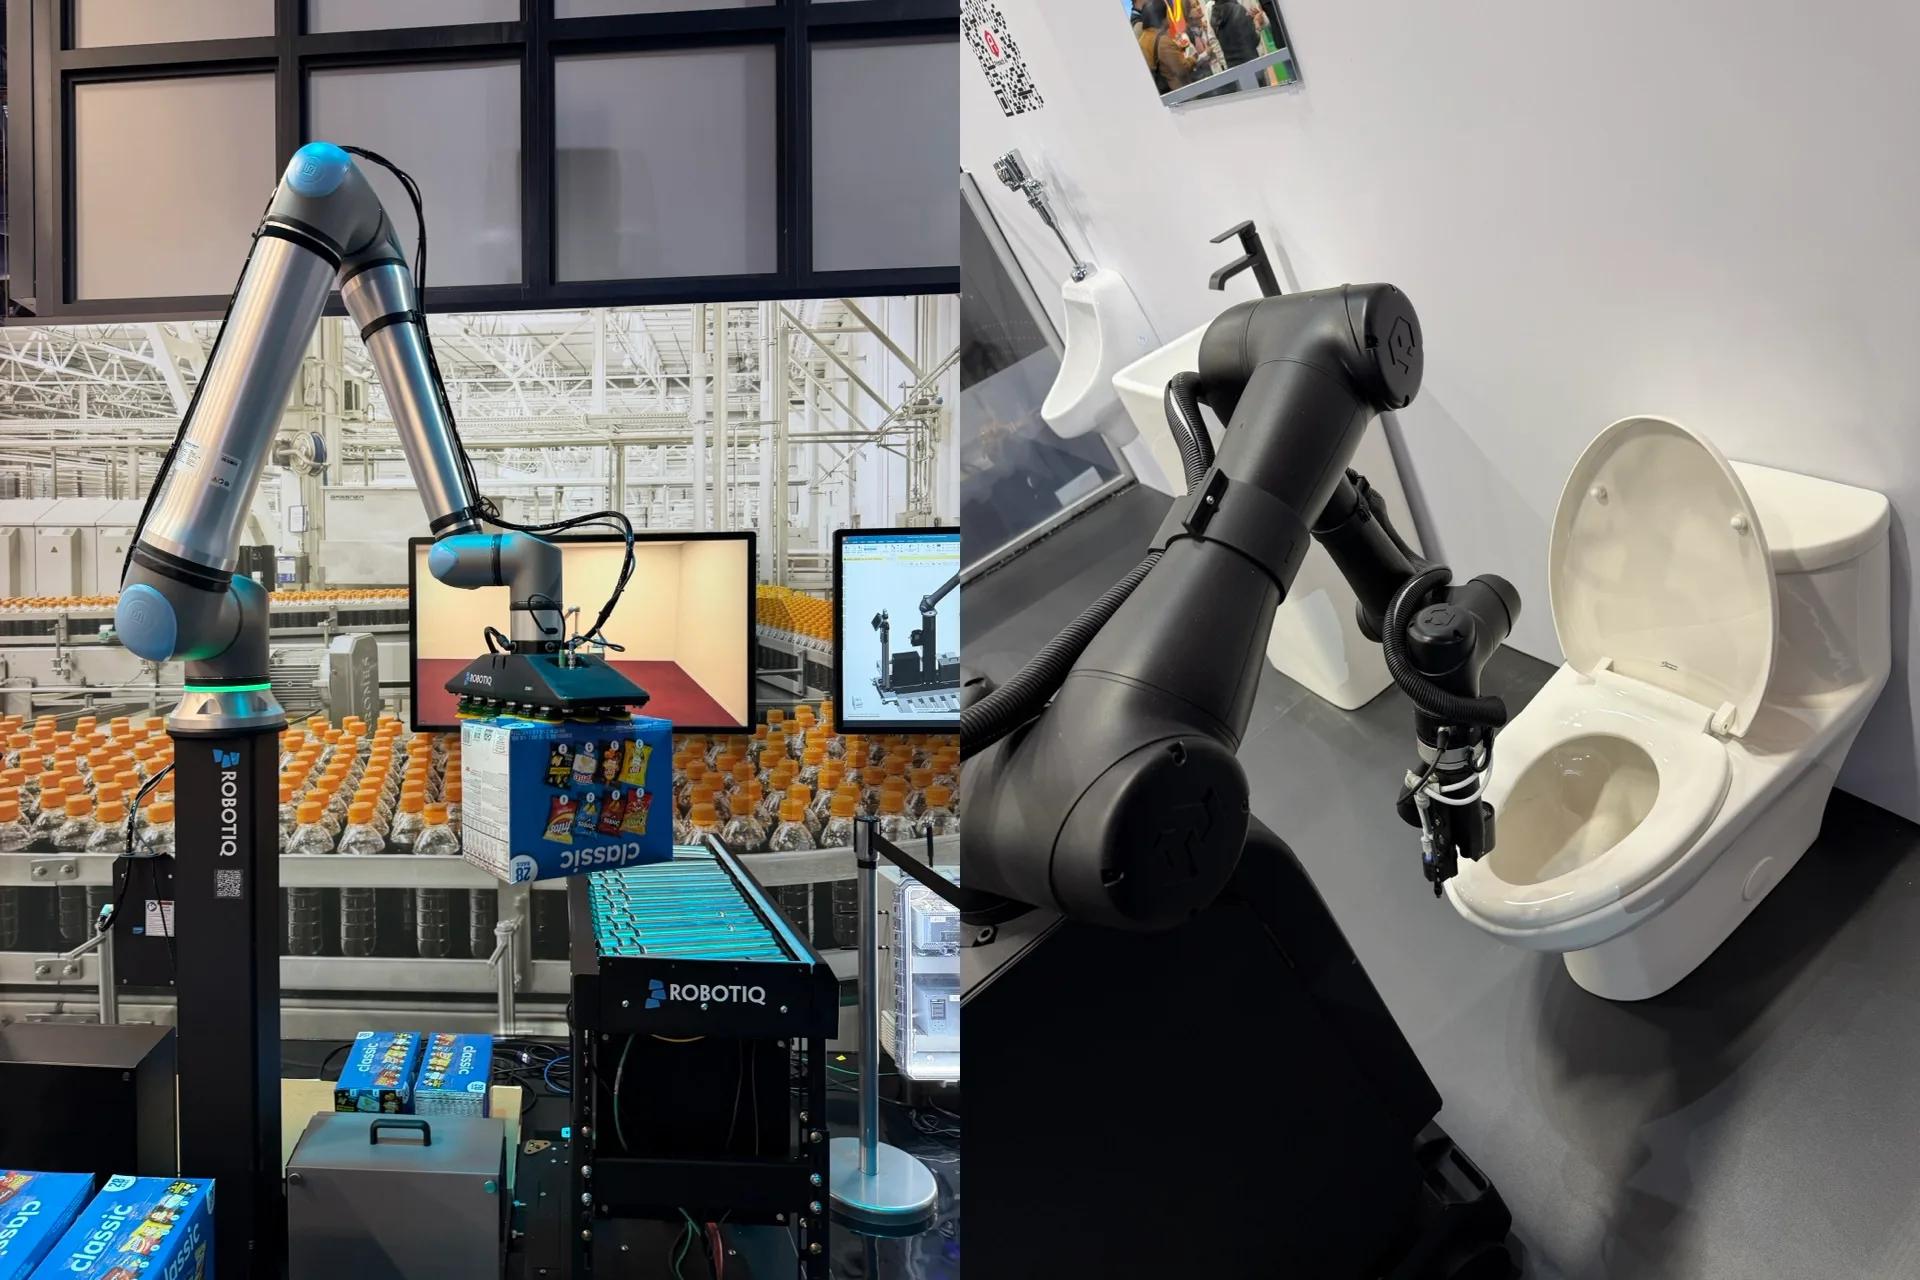
Aufnahme vor Ort von Lei Technology auf der CES 2026
Nehmen wir ein einfaches Beispiel: Lassen Sie den Roboter einen Wasserbecher heben.
Für Menschen erfordert dies fast kein Nachdenken. Aber der Roboter muss zuerst die Position und Haltung des Bechers erkennen, seine Form beurteilen, dann die Bewegungsbahn des mechanischen Arms planen und die Greifzange steuern, um den Greifvorgang abzuschließen. Wenn der Becher mit Wasser gefüllt ist, darf die Greifkraft nicht zu groß sein, sonst könnte der Becher zerquetscht werden, und sie darf auch nicht zu klein sein, sonst fällt der Becher herunter.
Außerdem führen Menschen im wirklichen Leben selten nur eine einzelne unabhängige Aktion aus. Wir können gleichzeitig ein Handy halten und mit der anderen Hand den Wasserbecher heben, uns dann umdrehen und den Becher auf den Tisch stellen. Der gesamte Prozess umfasst die Zusammenarbeit beider Hände, räumliche Beurteilung, Objekterkennung und Planung fortlaufender Aktionen.
Das ist auch der Grund, warum Roboter nicht nur durch das Ansehen von Videos lernen können, zu arbeiten.
Sie benötigen eine große Menge an Interaktionsdaten aus der realen Welt, um zu wissen, welche Aktionen Menschen in welchen Umgebungen ausführen, wie Hände und Objekte in Kontakt kommen und welche Ergebnisse nach der Ausführung der Aktionen entstehen.
Und diese Art von Daten kann kaum allein über das Internet bereitgestellt werden.
Laut einem Bericht der China Securities Journal vom Oktober wächst der Datenbedarf vieler Roboter- und Großmodellunternehmen derzeit von der Ebene von Millionen Stunden auf die Ebene von zehn Millionen Stunden. Damit eine einzelne Fähigkeit des Roboters ein lieferbares Niveau erreicht, sind möglicherweise 2000 bis 5000 Stunden Trainingsdaten erforderlich.
Daher beginnen Unternehmen, die speziell Trainingsdaten für Roboter erfassen, aufzutauchen.
Abgesehen von der oben genannten Datenerfassung in festen Szenarien mit 30 Wohnungen erkunden viele Unternehmen zur Kostensenkung auch die körperlose Datenerfassung.
Die sogenannte körperlose Erfassung kann einfach so verstanden werden, dass nicht unbedingt ein vollständiger humanoider Roboter alle Aktionen selbst ausführen muss. Stattdessen tragen Menschen Geräte wie Headset, Handschuhe oder halten Greifzangen in der Hand, um den Prozess der Aufgabenausführung des Roboters zu simulieren, und wandeln dann die Aktionsbahn, räumliche Position und Bedieninformationen des Menschen in Trainingsdaten um.
Auf diese Weise lassen sich die Erfassungskosten stark senken. Schließlich ist ein vollständiger Roboter nicht billig. Wenn für die Erfassung jedes Datensatzes ein Roboter belegt werden muss, sind die Kosten für die Skalierung leicht vorstellbar.
Aus dieser Perspektive ähnelt die Arbeit von Roboter-Datenerfassern etwas der Arbeit von Menschen, die in der Vergangenheit Daten für KI-Modelle markiert haben. Nur dieses Mal sagen sie der KI nicht nur, was auf einem Bild zu sehen ist, sondern gehen persönlich in die reale Welt, um dem Roboter zu zeigen, wie er sich bewegen soll.
Einige mieten Wohnungen, andere setzen auf Crowdsourcing – der Markt für Datenerfassung gerät in Schwung
Tatsächlich sieht die Datenerfassung zwar neu aus, hat aber bereits unterschiedliche Vorgehensweisen entwickelt.
Derzeit lassen sich die typischen Wege grob in zentralisierte Erfassung, Crowdsourcing-Erfassung und eine durch Datenverarbeitung und Training gebildete umfassende Dienstleistungskette unterteilen.
Bei der zentralisierten Erfassung werden spezielle Roboter-Trainingsplätze aufgebaut, Szenarien wie Haushalt, Fabrik, Supermarkt und Gastronomie in feste Standorte verlegt und dann verschiedene Arten von Robotern und Erfassungsgeräten eingesetzt, damit diese wiederholt festgelegte Aufgaben ausführen.
Zum Beispiel hat das Pekinger Innovationszentrum für humanoide Roboter einen speziellen Daten- und Trainingsstandort aufgebaut. Der Vorteil dieses Modells besteht darin, dass die Datenqualität relativ einfach kontrolliert werden kann. Erfassungsumgebung, Geräte und Betriebsabläufe sind relativ einheitlich, und auftretende Probleme lassen sich leicht zurückverfolgen.
Aber es hat auch deutliche Einschränkungen: Die reale Welt ist zu groß, und ein fester Trainingsplatz kann nicht alle Situationen simulieren.
Daher wird die Crowdsourcing-Erfassung zu einer weiteren Option.
Dieses Jahr im September hat Mifeng Technology, ein Unternehmen unter dem Dach von Agibot Robotics, offiziell das Crowdsourcing-Modell für die Datenerfassung von körpergebundener KI eingeführt. Normale Menschen können Erfassungsgeräte beantragen, im täglichen Leben Aufgaben wie das Ordnen des Schreibtisches, Kochen und Falten von Kleidung erledigen, entsprechende Daten erfassen und dafür eine Vergütung erhalten.
Bis Oktober ist das Crowdsourcing-Geschäft von Mifeng Technology in 40 Städten wie Peking, Guangzhou, Shenzhen und Shanghai implementiert worden.
Die Teilnehmer können zwischen 10 und 30 Yuan pro Stunde für die Datenerfassung verdienen. Für normale Menschen bedeutet dies, dass sie einen Teil ihrer täglichen Handlungen zu einer Nebenarbeit machen können. Für Datenanbieter hingegen wird das Erfassungsnetzwerk auf kostengünstige Weise auf mehr echte Haushalts- und Lebensszenarien ausgedehnt.
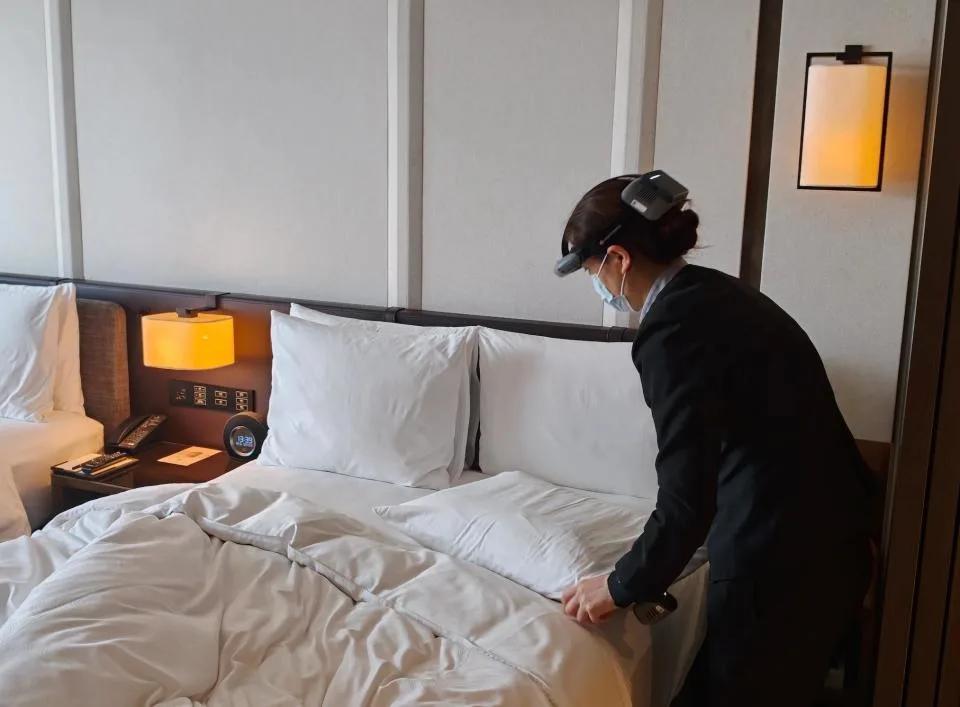
Quelle: Aufnahme von Lei Technology
Dafür müssen nicht einmal alle Teilnehmer sich mit Robotern auskennen.
Sie müssen nur gemäß den Anforderungen Geräte tragen, festgelegte Aktionen ausführen und die erfassten Daten hochladen, um die Möglichkeit zu erhalten, Anbieter von Trainingsdaten für Roboter zu werden.
Neben Mifeng Technology treibt auch JD.com einen ähnlichen großangelegten Datenerfassungsplan voran. JD.com aktiviert intern mehr als 100.000 Mitarbeiter verschiedener Berufe und extern bis zu 500.000 Personen aus allen Branchen, um an der Erfassung teilzunehmen. Das Ziel ist, innerhalb eines Jahres 5 Millionen Stunden Videodaten aus echten menschlichen Szenarien zu sammeln und innerhalb von zwei Jahren 10 Millionen Stunden zu überschreiten.
Darüber hinaus gibt es eine Reihe von Unternehmen, die sich nicht damit zufriedengeben, nur Rohdaten zu verkaufen, sondern beginnen, sich in Bereiche wie Datenverarbeitung, Markierung, Qualitätsprüfung und Modelltraining auszudehnen.
Wenn jemand zum Beispiel Kleidung faltet, scheint dies nur ein einfaches Video zu sein. Aber was der Roboter wirklich benötigt, ist möglicherweise die Bewegungsbahn der Hand, die Positionsänderung des Objekts, die Kontaktinformationen beim Greifen und der Aufgabenstatus, der jeder Aktion entspricht.
Wenn diese Informationen nicht verarbeitet werden, ist der Nutzen der Daten für das Modell stark eingeschränkt.
Daher müssen Datenanbieter nicht nur die Erfassung abschließen, sondern auch Datenbereinigung, Aktionsmarkierung, Qualitätsprüfung, Formatkonvertierung durchführen und sogar spezielle Datensätze an die Roboterkonfiguration und Modellanforderungen des Kunden anpassen.
Interessanterweise sind die Teilnehmer an dieser Datenerfassung nicht nur Unternehmen für körpergebundene KI. Lokale Innovationszentren, KI-Datenanbieter, Hardwarehersteller und sogar Einzelhandels- und Dienstleistungsunternehmen mit einer großen Anzahl von Offline-Szenarien können Teilnehmer werden.
Die Roboter sind noch nicht in großem Umfang verkauft worden, aber die Arbeitsteilung der Industrie rund um die Lernfähigkeit von Robotern wurde bereits aufgebaut. Das ist eigentlich nicht schwer zu verstehen: Das autonome Fahren folgt einem ähnlichen Weg, es lernt in der Anfangsphase durch eine große Menge realer Daten und explodiert dann zu einem bestimmten Zeitpunkt.
Kann man mit dem Verkauf von Daten wirklich Geld verdienen? Das hängt vor allem von der Anpassungsfähigkeit ab
Wenn Sie bis hierhin gelesen haben, denken Sie vielleicht, dass normale Menschen nur Geräte tragen und Hausarbeiten erledigen müssen, um daran teilzunehmen, und die Nachfrage scheint sehr groß zu sein. Aus dieser Sicht scheint die Datenerfassung für körpergebundene KI ein gutes Geschäft zu sein.
Trotzdem wird nicht empfohlen, blind in diesen Markt einzusteigen. Der Umfang der Datenerfassung wächst zwar, aber das bedeutet nicht, dass alle Daten verkauft werden können, und schon gar nicht, dass es bereits ein stabiles Gewinnmodell gibt.
Aus Stellen-Apps lässt sich auch ersehen, dass die Arbeit als Datenerfasser für körpergebundene KI tatsächlich nicht sehr hoch bezahlt wird. Die meisten Gehälter liegen im Bereich von 3000 bis 4000 Yuan. Wenn Sie in einer Groß- oder Mittelstadt leben, ist dieses Gehalt niedriger als das von Lieferfahrern für Takeaway.
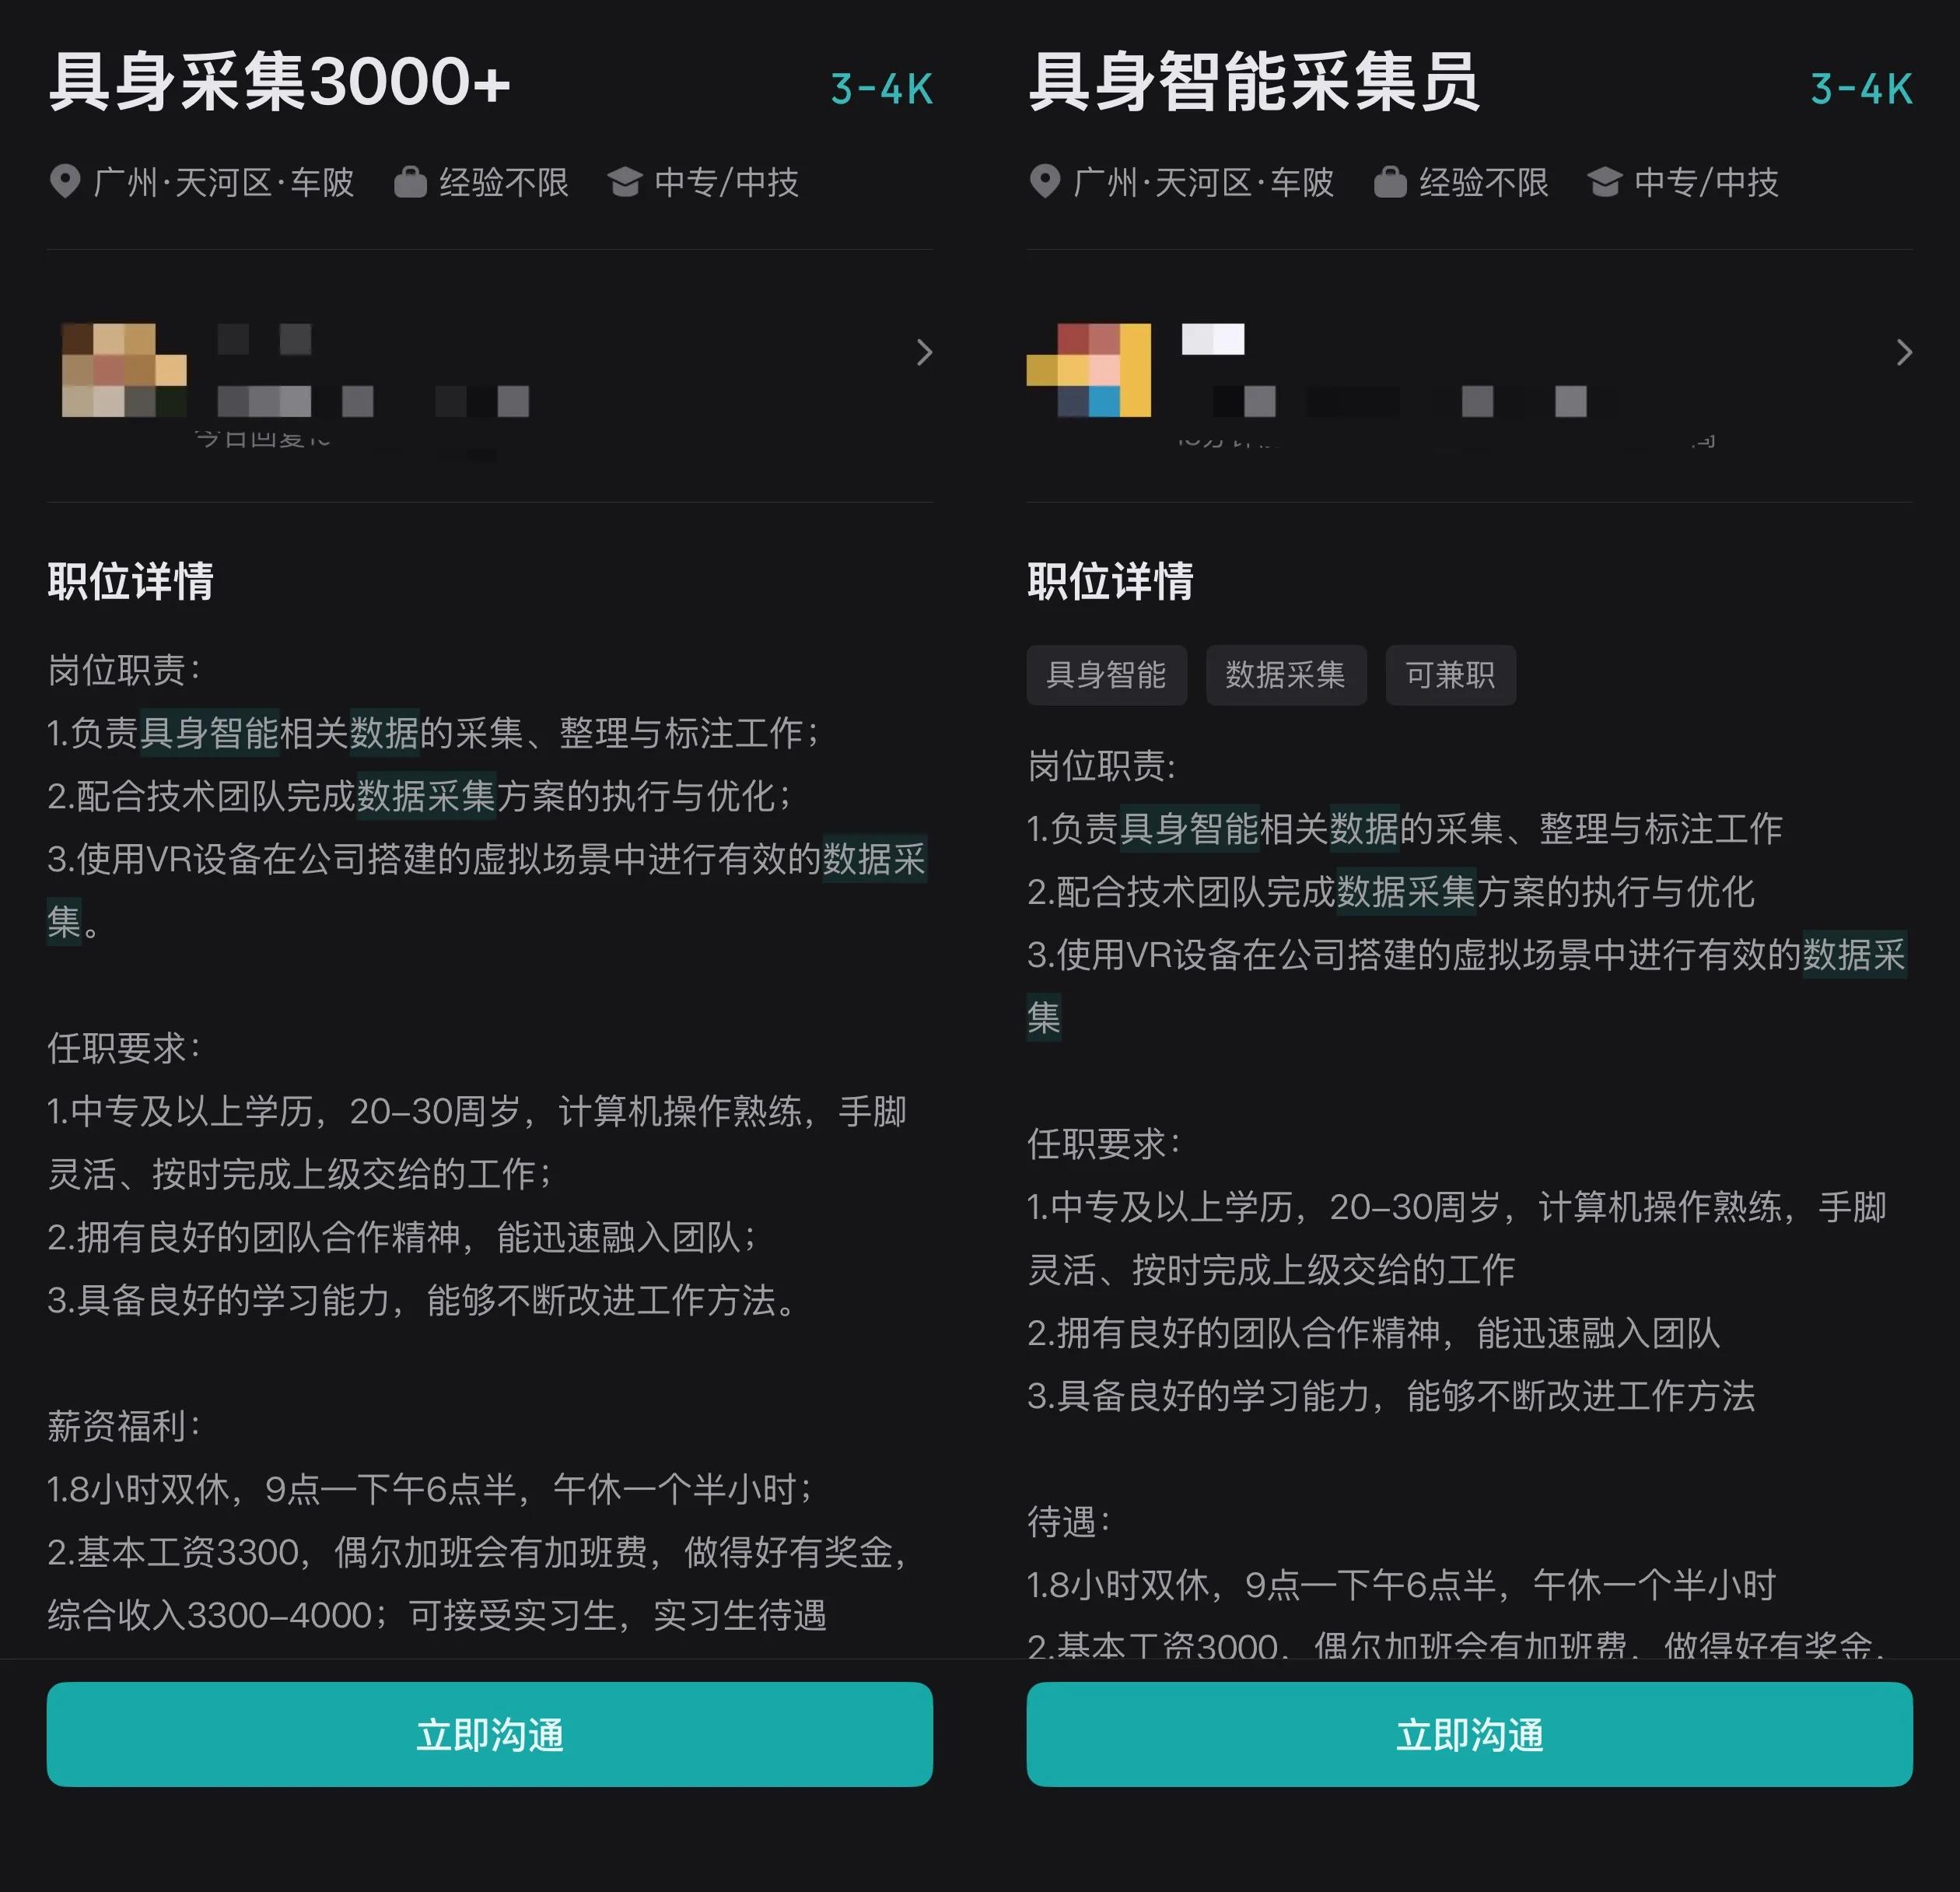
Quelle: Screenshot einer Stellen-App
Dafür gibt es eigentlich zwei Gründe: Erstens hat diese Arbeit keine sehr hohe Eintrittshürde. Zweitens sind die Daten keine universellen Daten, das heißt, das Verhältnis von Aufwand zu Ertrag ist nicht proportional, daher kann nicht zu viel Gehalt gezahlt werden.
Konzentrieren wir uns auf den zweiten Grund: Derzeit befindet sich die Branche für körpergebundene KI noch in einer Phase der schnellen Weiterentwicklung der technischen Routen. Die Roboterkonfigurationen, Sensoren, Steuersysteme und Modellarchitekturen verschiedener Hersteller sind unterschiedlich. Daher können die Daten, die ein Datenanbieter erfasst hat, nicht unbedingt direkt von einem anderen Roboterunternehmen verwendet werden.
Dies führt zu einem etwas peinlichen Phänomen in der Datenbranche: Einerseits beklagen alle, dass ihnen Daten fehlen; andererseits bauen alle ihre eigenen Datensysteme gemäß ihrer technischen Route auf.
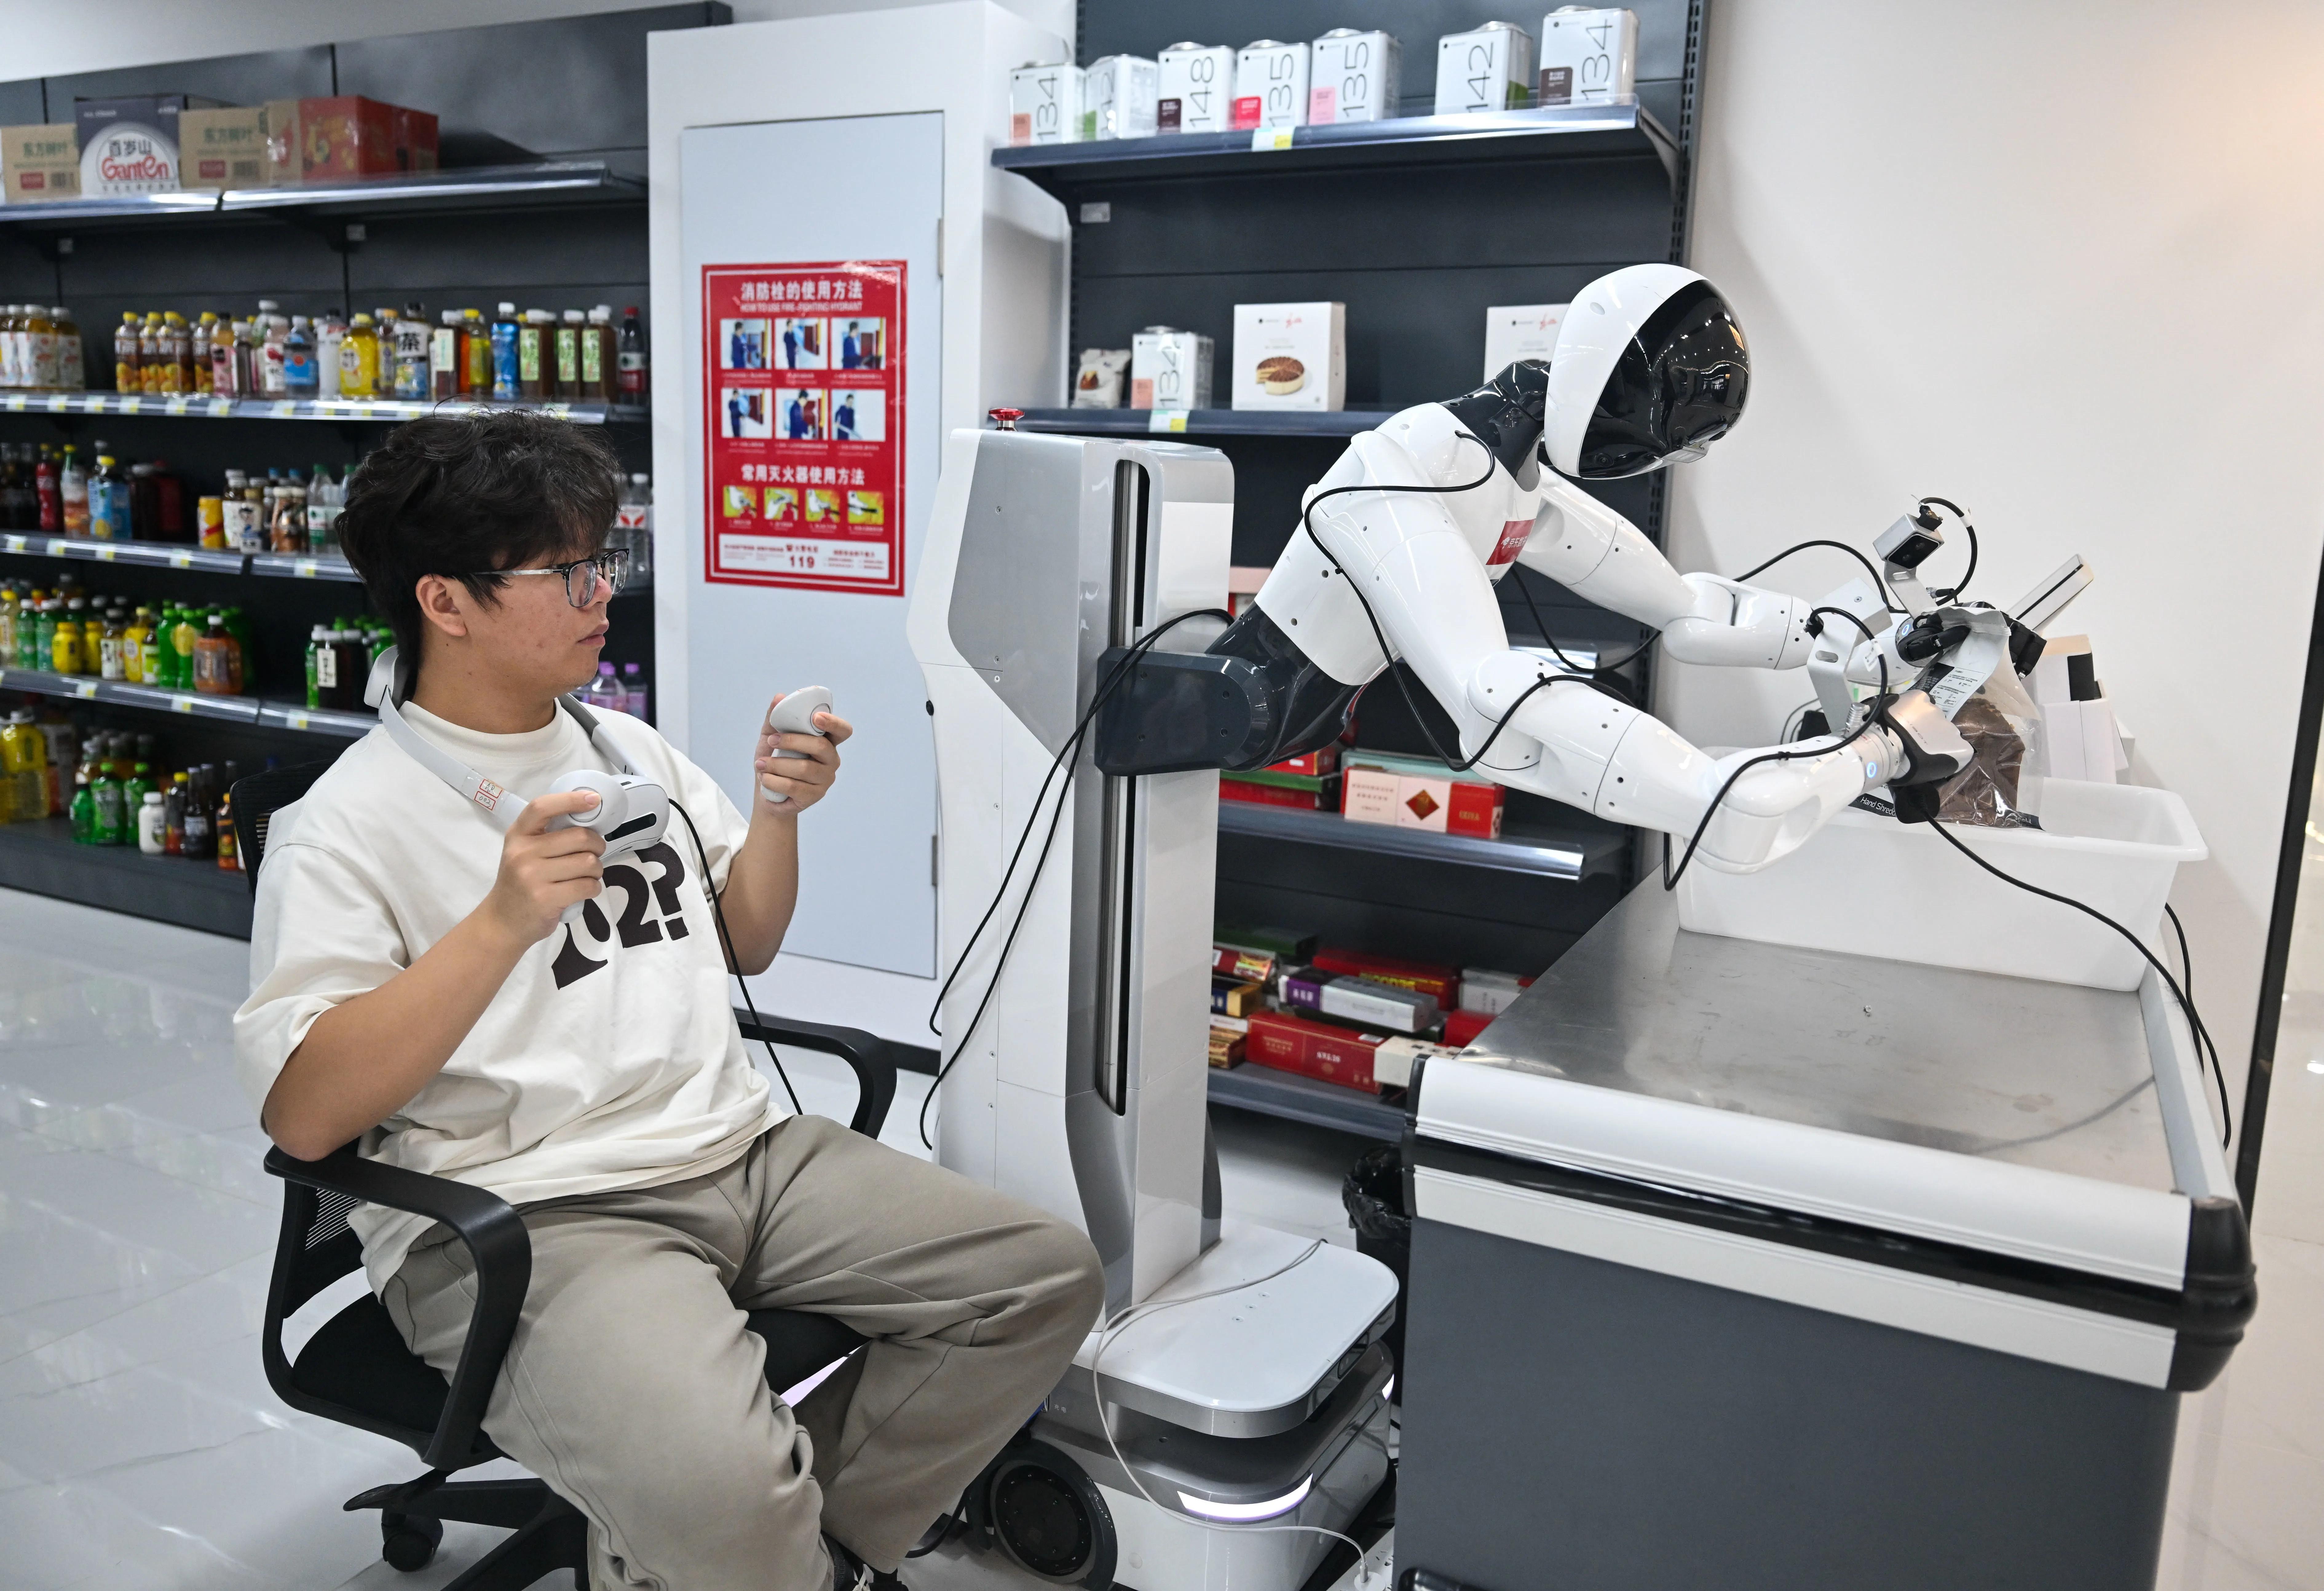
Quelle: Xinhua Nachrichtenagentur
Der von der China Academy of Information and Communications Technology veröffentlichte „Entwicklungsbericht zur körpergebundenen KI (2025)“ erwähnt, dass derzeit die Methoden zur Datenerfassung und Markierung in verschiedenen Trainingsplätzen sowie die Konfiguration der Roboter selbst nicht einheitlich sind, sodass Daten aus verschiedenen Trainingsplätzen kaum integriert und gemeinsam genutzt werden können. Gleichzeitig muss noch überprüft werden, ob die Daten aus Trainingsplätzen kontinuierlich den tatsächlichen geschäftlichen Anforderungen entsprechen.
Daten sind keine gewöhnlichen Waren, die nach der Produktion einfach ins Regal gestellt werden und auf Käufer warten. Sie müssen oft an die Roboter, Modelle und spezifischen Aufgaben des Kunden angepasst werden.
Außerdem führen Roboterunternehmen selbst auch Datenerfassungsarbeiten durch: Agibot Robotics hat eine eigene Datenerfassungsfabrik und erkundet über sein Tochterunternehmen Mifeng Technology auch die Crowdsourcing-Erfassung. Das Pekinger Innovationszentrum für humanoide Roboter baut nicht nur Trainingsstandorte auf, sondern treibt auch die Datenlieferung voran. Roboterunternehmen wie Galaxy Universal und Ubtech bauen ebenfalls Fähigkeiten zur Datenerfassung und zum Training rund um ihre eigenen Produkte und Modelle auf.
Daher ist die wahrscheinlichere zukünftige Situation nicht, dass alle Roboterunternehmen die Datenerfassung auslagern, sondern dass selbst aufgebaute Datensysteme und Drittanbieter nebeneinander existieren.
Apropos Daten: Es gibt ein Problem, das nicht ignoriert werden kann: der Schutz der Privatsphäre und der Datensicherheit.
In S