Die Erkennung ist gelöst. Schon eine Abweichung von einem Halbton bei der Synthese stellt einen Unfall dar: Die von Strait Jiyin entwickelte Dialektsynthese ist die schwierigste zu überwindende Hürde.
StraitsVoice AI entwickelt ein Sprach-Basismodell für chinesische Dialekte. Derzeit sind zehn Dialekte integriert, vier davon werden kommerziell genutzt, und 11 staatliche und unternehmerische Projekte haben die Abnahme abgeschlossen.
StraitsVoice AI, ein Anbieter von Sprach-Basismodellen für chinesische Dialekte, hat die Finanzierungsrunde der Angel-Phase eingeleitet. Das Unternehmen plant, 5 Millionen Yuan aufzunehmen und 5 % der Unternehmensanteile zu veräußern. Die Mittel werden in vier Bereichen eingesetzt: 40 % für Forschung und Entwicklung sowie Modelliteration (einschließlich Erweiterung der Rechenkapazität), 20 % für Erfassung und Lizenzierung von Sprachkorpora, 20 % für Marketing und Vertriebskanäle und 20 % für die Ergänzung des Teams.
I. Der letzte Schritt der Dialekt-KI stockt bei den Tonhöhen
Die Großmutter sprach ihr ganzes Leben lang nur Hakka-Dialekt. Liao Changwei, ein Landsmann aus Taiwan, hat sie gefilmt. Der Film trägt den Titel „Das Licht der Großmutter“ und wurde später im besonderen Mondfest-Programm des China Media Group ausgestrahlt. Nach Ende der Vorführung verging die Zeit trotzdem wie zuvor.
„Die Maschine kann ihre Sprache verstehen, aber sie kann den besonderen Klang ihrer Stimme nicht nachahmen“, sagte Liao Changwei. „Fehlt nur eine halbe Tonstufe, ändert sich bereits die Bedeutung.“
Im Hakka-Dialekt unterscheiden sich die Wörter für „essen“ und „sterben“ nur um eine einzige Tonstufe. Ein Fehler macht die Äußerung nicht nur unschön, sondern führt zu falschen Aussagen.
Auf der Seite der Spracherkennung sind die Probleme weitgehend gelöst. Das große Sprach-Basismodell Spark-Audio-1.0-Preview, das iFlytek im September dieses Jahres veröffentlicht hat, unterstützt die Erkennung von 99 Sprachen und 202 Dialekten. Verstehen ist kein Problem mehr.
Bei der Sprachsynthese sieht es anders aus. Die Erkennung muss nur „verstehen“, und kleine Abweichungen beeinträchtigen das Ergebnis nicht. Die Synthese hingegen muss „richtig sprechen“ – schon eine halbe falsche Tonstufe führt zu einem Fehler.
Noch schwieriger ist das Singen. Die Tonhöhen der Dialekte tragen die semantische Bedeutung beim Sprechen, müssen aber beim Singen der Melodie folgen. Zwei Regelwerke ziehen an derselben Audiospur: Folgt man der Melodie, verliert sich die Bedeutung der Wörter. Hält man starr an den Tonhöhen fest, löst sich die Melodie auf. Bis heute gibt es kein wirklich kommerziell nutzbares Produkt für das Singen in Dialekten.
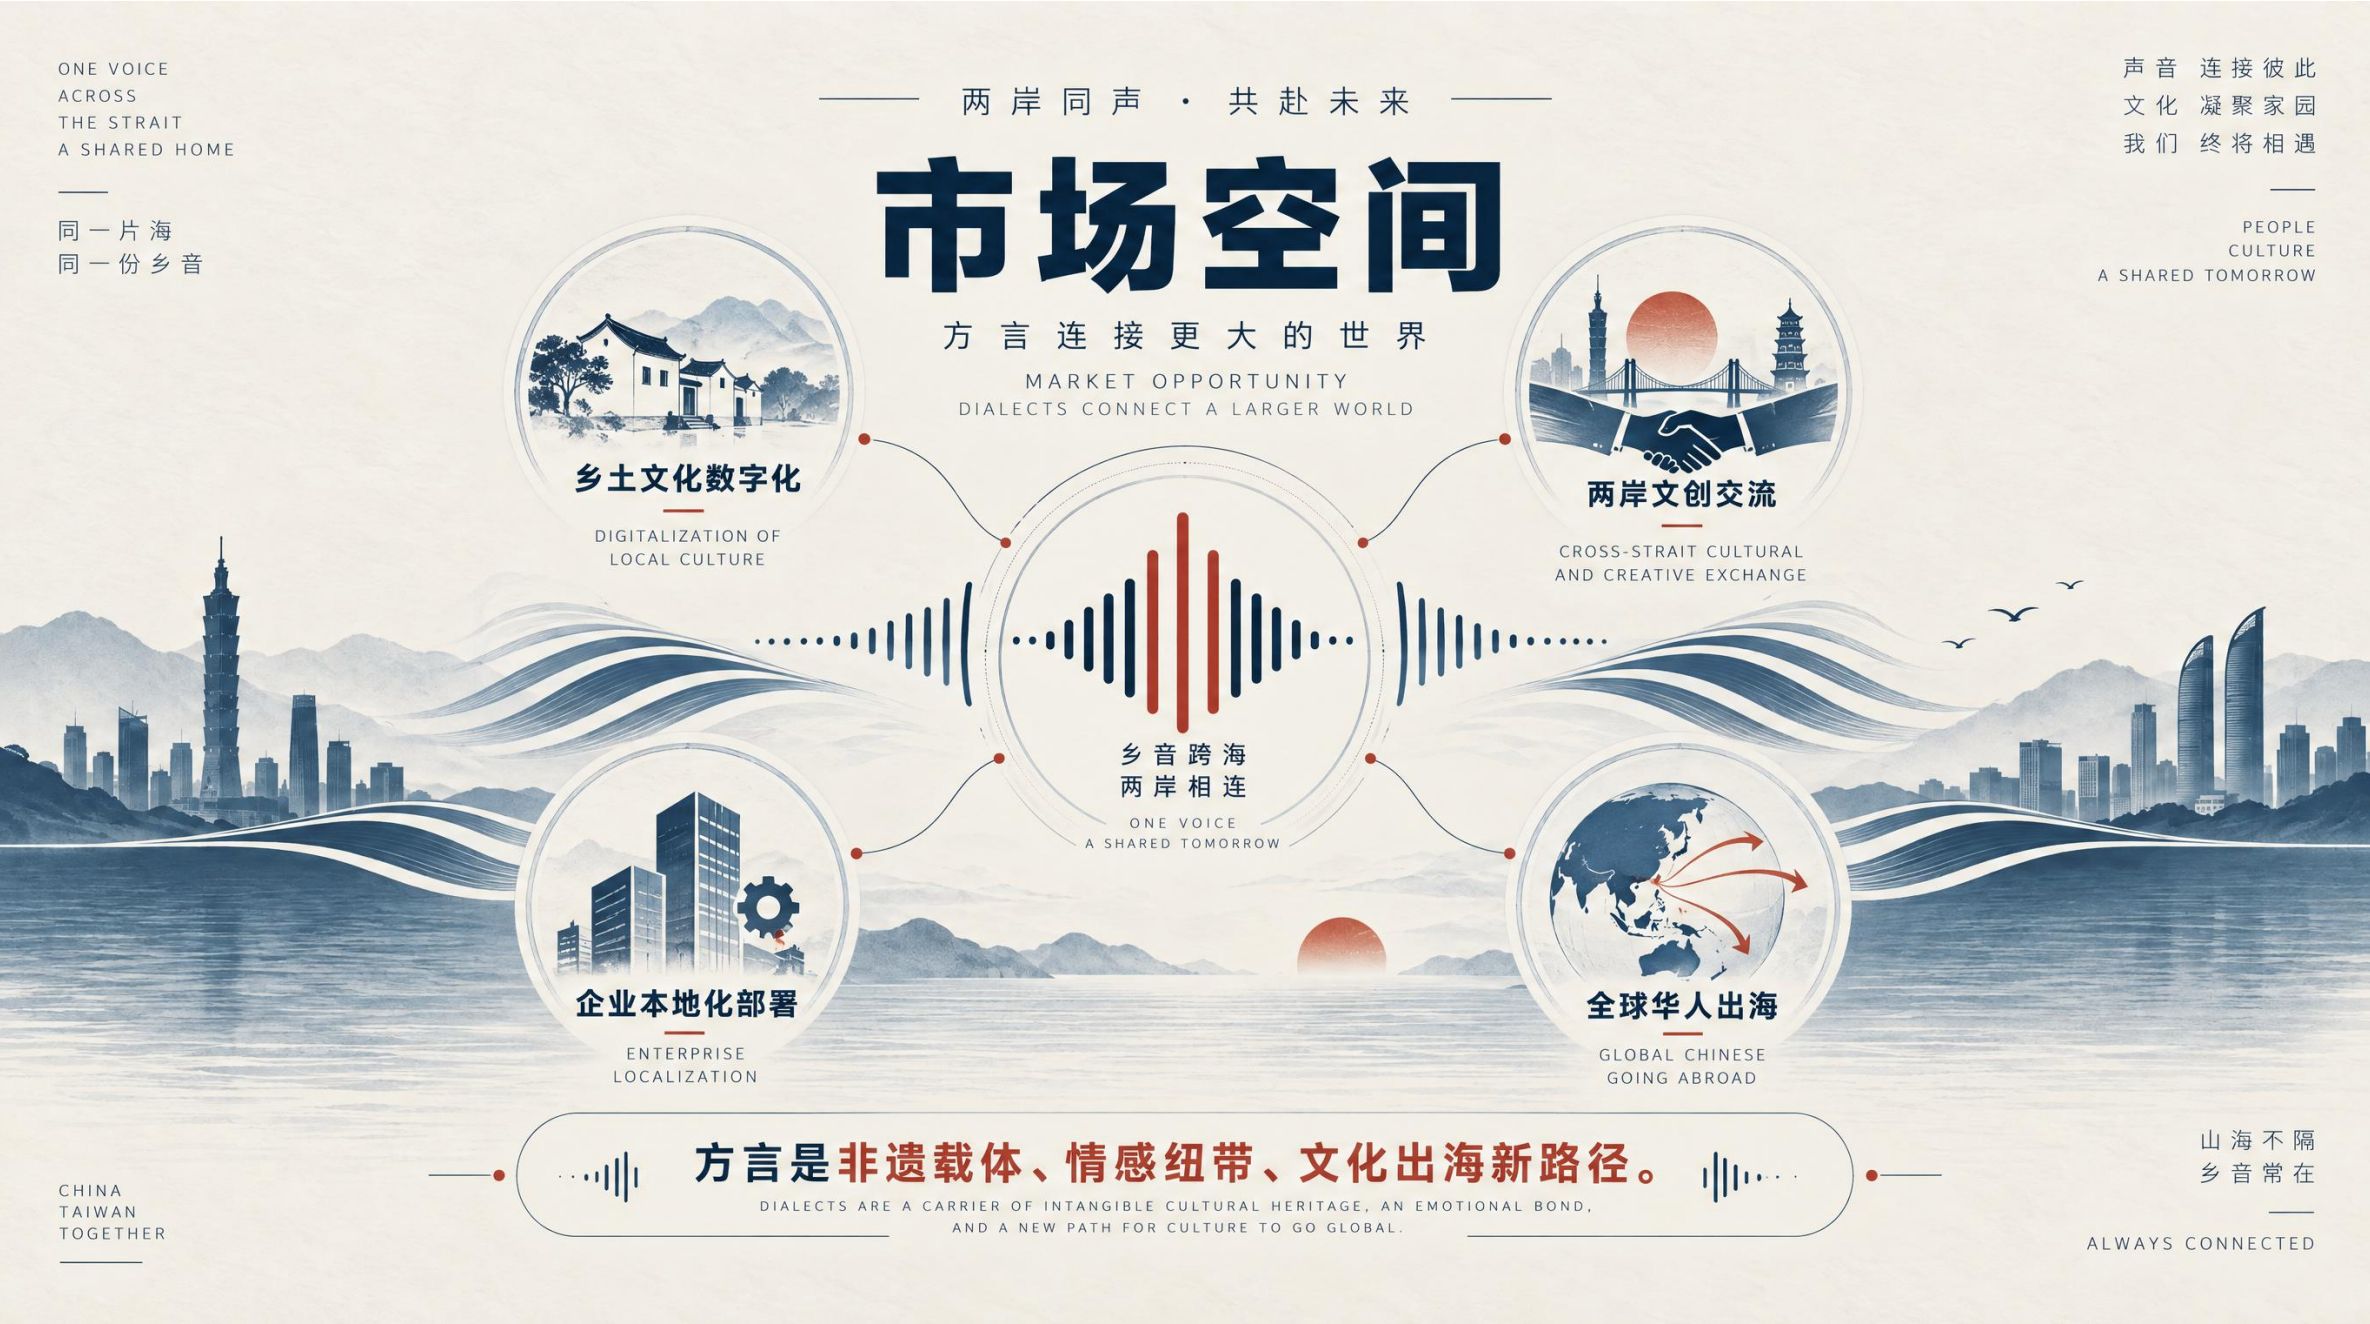
Dieses Thema betrifft nicht nur die chinesische Sprache. Weltweit gibt es nur wenige Sprachen mit Tonhöhen, und die chinesische Sprachfamilie ist die größte davon. Thailändisch, Vietnamesisch und Burmesisch sind ebenfalls tonale Sprachen. Eine Methode, die den Konflikt zwischen Tonhöhen und Melodie in chinesischen Dialekten löst, kann später auf ganz Südostasien übertragen werden. Nach öffentlichen Daten des Büros für Auslandschinesen beim Staatsrat leben über 60 Millionen Auslandschinesen, wobei der größte Teil in Südostasien ansässig ist. Ihre Kinder sind dort aufgewachsen, und die Muttersprache droht zu verschwinden. Wenn grenzüberschreitende E-Commerce-Unternehmen Waren nach Südostasien verkaufen, wirkt eine Äußerung in Minnan-Dialekt oder Hakka-Dialekt näher als jede Werbebotschaft.
Auf der Marktseite gab es in diesem Jahr bereits eine Antwort. Der Chaoshan-Dialekt-Film „Ein Liebesbrief an die Großmutter“ kam am 30. April in die Kinos und endete am 30. September. Er spielte im Inland 2,005 Milliarden Yuan ein, wurde von 58,82 Millionen Zuschauern gesehen, überschritt die 100-Millionen-Yuan-Marke an ausländischen Kinokassen und führte die jährliche Rangliste der chinesischen Filme in Singapur an. Die Investition in diesen Film betrug nur 14 Millionen Yuan, alle Darsteller waren Laien, und 95 % der Dialoge waren auf Chaoshan-Dialekt. Es fehlt nicht an Zuschauern, sondern an Werkzeugen, die stabil hochwertige Inhalte erzeugen können.
StraitsVoice AI setzt auf drei Veränderungen. Auf der Nachfrageseite setzen lokale Regierungen Maßnahmen zur Bewahrung der heimatlichen Kultur um, Museen erstellen Dialekt-Führungen, Kultur- und Tourismusbehörden produzieren Dialekt-Imagefilme, und die Budgets werden ständig freigesetzt – es gab in der Vergangenheit nur keine Anbieter, die die Leistungen erbringen konnten. Auf der technischen Seite senkt die Architektur mit gemischten Experten die Kosten für die Integration neuer Dialekte, und die Rechenkapazität auf Endgeräten steigt ebenfalls. Fahrzeugsysteme, Mobiltelefone und industrielle Geräte können Sprachmodelle offline ausführen, sodass die Dialekte erstmals einen Platz haben, um „integriert“ zu werden. Auf der Angebotsseite bleiben die allgemeinen großen Modelle bei den großen Sprachen – sie könnten auch Dialekte verarbeiten, aber die Daten sind nicht wirtschaftlich.
II. Nur die unterste Ebene wird entwickelt
StraitsVoice AI wählt die unterste Ebene aus: Es entwickelt keine Apps, keine Mini-Programme, sondern die Komponente, die es anderen Produkten ermöglicht, Dialekte zu sprechen.
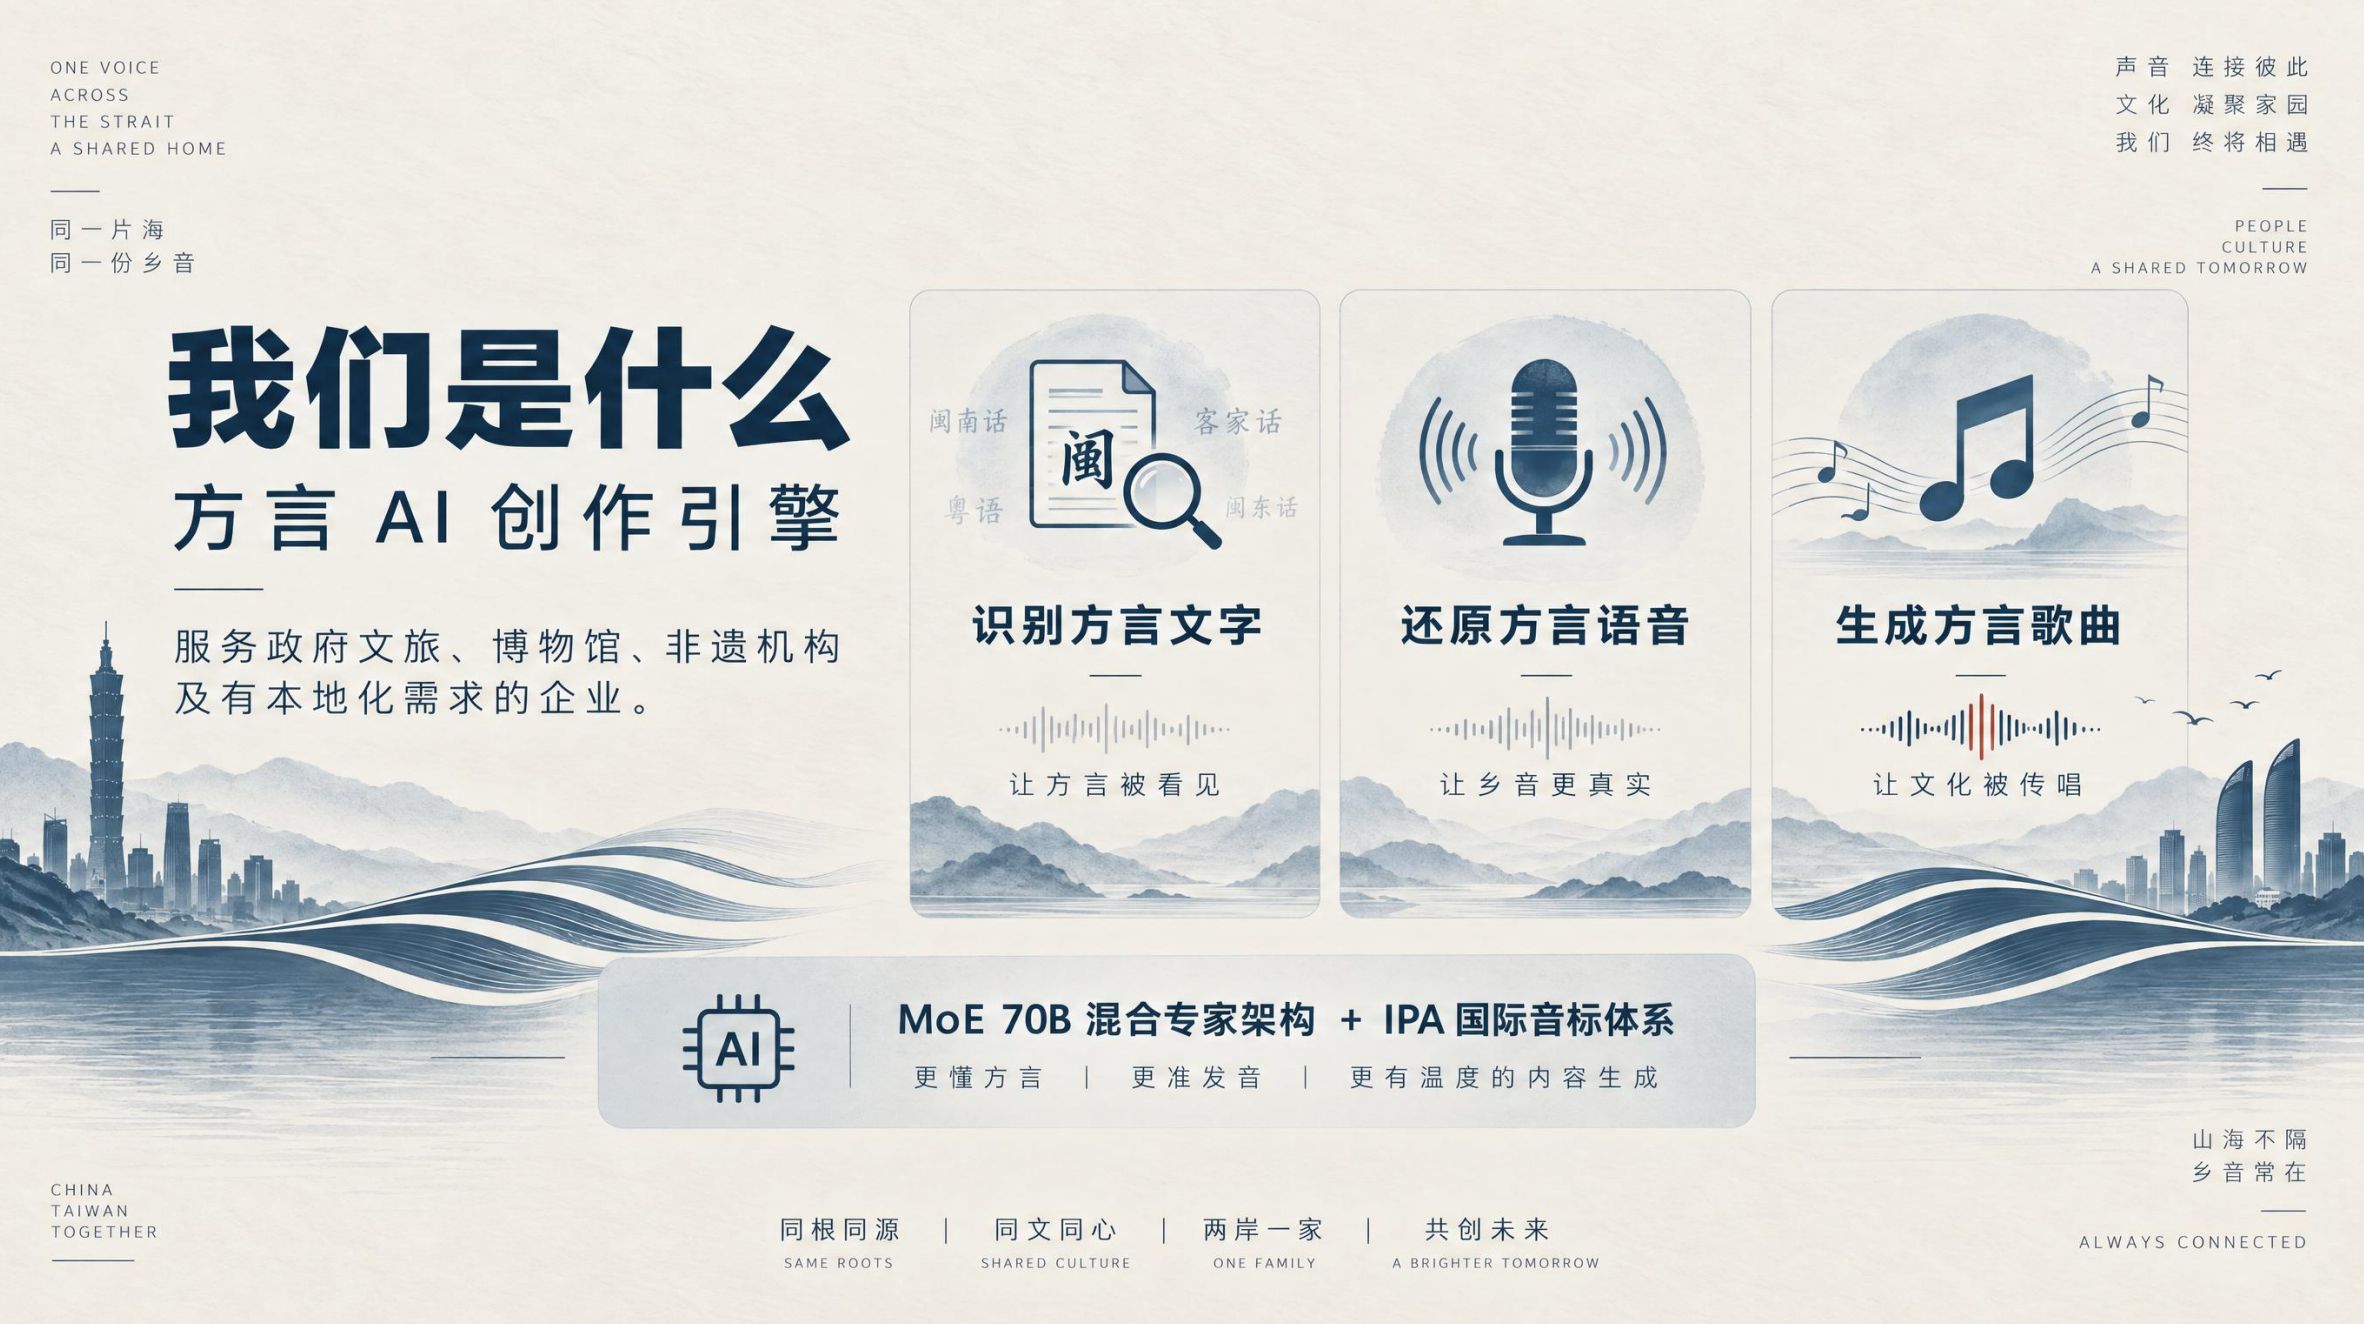
Die Grundlage ist die MoE 70B-Architektur mit gemischten Experten. Das große Modell wird in einzelne unabhängige kleine Dialekt-Experten unterteilt. Wenn ein bestimmter Dialekt benötigt wird, wird das entsprechende Modul aktiviert, und weniger als 30 % der Parameter werden bei einer einzelnen Inferenz verwendet. Die Integration eines neuen Dialekts dauert nur zwei bis vier Wochen, sodass die Menge der Trainingsdaten und die Kosten für die Rechenkapazität sinken. Ergänzt durch das Aussprache-System des internationalen phonetischen Alphabets IPA können verschiedene Dialekte nach denselben Regeln integriert werden.
Diese Fähigkeit wird von drei Dingen gestützt.
Erstens ein annotiertes Korpus mit 50 Millionen Wörtern an muttersprachlichen Aufzeichnungen und vollständigen Lizenzen. Jede Aufzeichnung wird bei der Unterzeichnung lizenziert, jede Zitierung ist autorisiert, jede Beauftragung ist festgelegt. Jede Stimme hat eine Lizenzvereinbarung, die geistigen Eigentumsrechte der Annotationen sind registriert, und die Stimmen Verstorbener werden nicht geklont.
Zweitens eine Phonem-Regelbibliothek mit 200.000 Einträgen, die Tonhöhen, Tonveränderungen bei aufeinanderfolgenden Wörtern und unterschiedliche Aussprachen von Schriftzeichen in literarischer und alltäglicher Sprache abdeckt. Die IPA-Transkription reicht bis auf Phonemebene, sodass die tatsächliche Aussprache desselben Zeichens in verschiedenen Dialekten einzeln nachvollzogen werden kann.
Drittens eine selbst entwickelte Methode zur Trennung von Tonhöhen und Melodie-Einschränkungen. Zwei patentierte Erfindungen (CN202411849270.X, CN202510627552.3) schützen die „Tonhöhe-Melodie-Abbildung“, dazu kommen 35 Software-Urheberrechte. Die Methode wandelt die Tonhöhe von einem „richtig/falsch“-Label in eine kontinuierliche Tonhöhenkurve um, wandelt die Melodie von einem „streng einzuhaltenden“ Template in eine Einschränkung, die lokal nachgeben kann, und markiert die Konfliktstellen explizit – das menschliche Ohr muss nur die verdächtigen Wörter prüfen, nicht die gesamte Aufnahme von Anfang bis Ende anhören.
Es gibt noch etwas anderes, das andere nur schwer übernehmen können: Eine Dialekt-Gesangskorpus mit zusätzlichen Annotationen zu Melodien, Gesangsstilen und Emotionen, die vier Ebenen von Melodiestrukturen, lokalen Gesangsstilen, Emotionsannotationen und Originalmaterialien umfasst.
„Die Kosten für die Vervielfältigung dieses Systems liegen nicht im Algorithmus, sondern in der Zeit“, sagte Liao Changwei. „50 Millionen Wörter an Sprachkorpora müssen Satz für Satz aufgenommen werden, 200.000 Phonem-Regeln müssen Eintrag für Eintrag annotiert werden, und die muttersprachlichen Prüfer müssen über Jahre ausgebildet werden. Diese drei Dinge lassen sich nicht kaufen, sondern erfordern Zeit und Mühe.“
Die Zeit schlägt sich auch in der Kostenkurve nieder. Die Entwicklung des ersten Dialekts von Grund auf bis zur Inbetriebnahme kostete Millionen Yuan, und die Investition wurde nach etwas mehr als einem Jahr zurückgezahlt. Der zweite Dialekt kostete nur 30 % des ersten, und die Kosten wurden nach acht bis zehn Monaten gedeckt. Ab dem dritten Dialekt betragen die Kosten weniger als 20 % des ersten, und die Investition wird nach mehr als einem halben Jahr zurückgezahlt. Sprachkorpora, Modelle, Evaluationssets und Kundenbeziehungen bleiben im Unternehmen und können direkt für den zweiten Dialekt genutzt werden.
Alle zehn großen Dialektregionen Chinas sind bereits integriert: Mandarin, Jin-Dialekt, Wu-Dialekt, Hui-Dialekt, Gan-Dialekt, Xiang-Dialekt, Min-Dialekt, Yue-Dialekt, Pinghua und lokale Dialekte sowie Hakka-Dialekt. Davon sind vier Dialekte – Hakka, Minnan, Kantonesisch und Fuzhou-Dialekt – bereits kommerziell im Einsatz. Der Fuzhou-Dialekt gehört zur ostminnischen Gruppe des Min-Dialekts und ist kein Zweig des Minnan-Dialekts. Dass beide gleichzeitig funktionieren, zeigt, dass dieses Basismodell nicht für einen einzelnen Dialekt maßgeschneidert ist.
Es wurde zudem eine bidirektionale Umwandlung zwischen Mandarin und Heimatdialekt realisiert: Ein Einheimischer spricht den Dialekt, das System wandelt ihn in Mandarin um, sodass Außenstehende ihn verstehen. Ein Außenstehender gibt einen Satz auf Mandarin ein, das System liest ihn im Dialekt vor, sodass der Einheimische ihn versteht. Einseitige Übersetzungswerkzeuge gibt es überall, aber es gibt nur wenige Anbieter von bidirektionalen Sprachbasismodellen.
III. 11 Abnahmebescheinigungen und die dahinterstehende Bilanz
Die zahlenden Kunden sind Institutionen, keine Privatpersonen.
Die erste Gruppe umfasst lokale Regierungen sowie Kultur-, Tourismus- und Propagandaabteilungen. Vor Festivals wollen sie einen Dialekt-Imagefilm produzieren, mit einem Budget von 200.000 bis 300.000 Yuan. Wenn sie lokale Sänger suchen, die Aufnahme auslagern und dann jemanden für die Übersetzung und Synchronisation suchen, dauert das drei Monate und oft schaffen sie es nicht, den Termin einzuhalten. Sie brauchen keine komplizierte Technologie, sondern ein Produkt, das genau erschwinglich ist und pünktlich fertig wird.
Die zweite Gruppe umfasst Sehenswürdigkeiten, Museen, integrierte Medien von Rundfunk und Fernsehen, Automobilhersteller, Banken, Bürgerämter und Pflegeheime – bei der gleichen Hinweismeldung erinnert sich niemand an die Version auf Mandarin, aber sobald die Version im Dialekt ertönt, blicken ältere Menschen auf. Die dritte Gruppe sind ältere Menschen, die kein Mandarin sprechen. Sie müssen Hotlines anrufen, zur Bank gehen, ins Krankenhaus gehen oder Sozialversicherungsangelegenheiten erledigen – wenn sie sich nicht klar ausdrücken können, können sie die Angelegenheiten nicht erledigen.
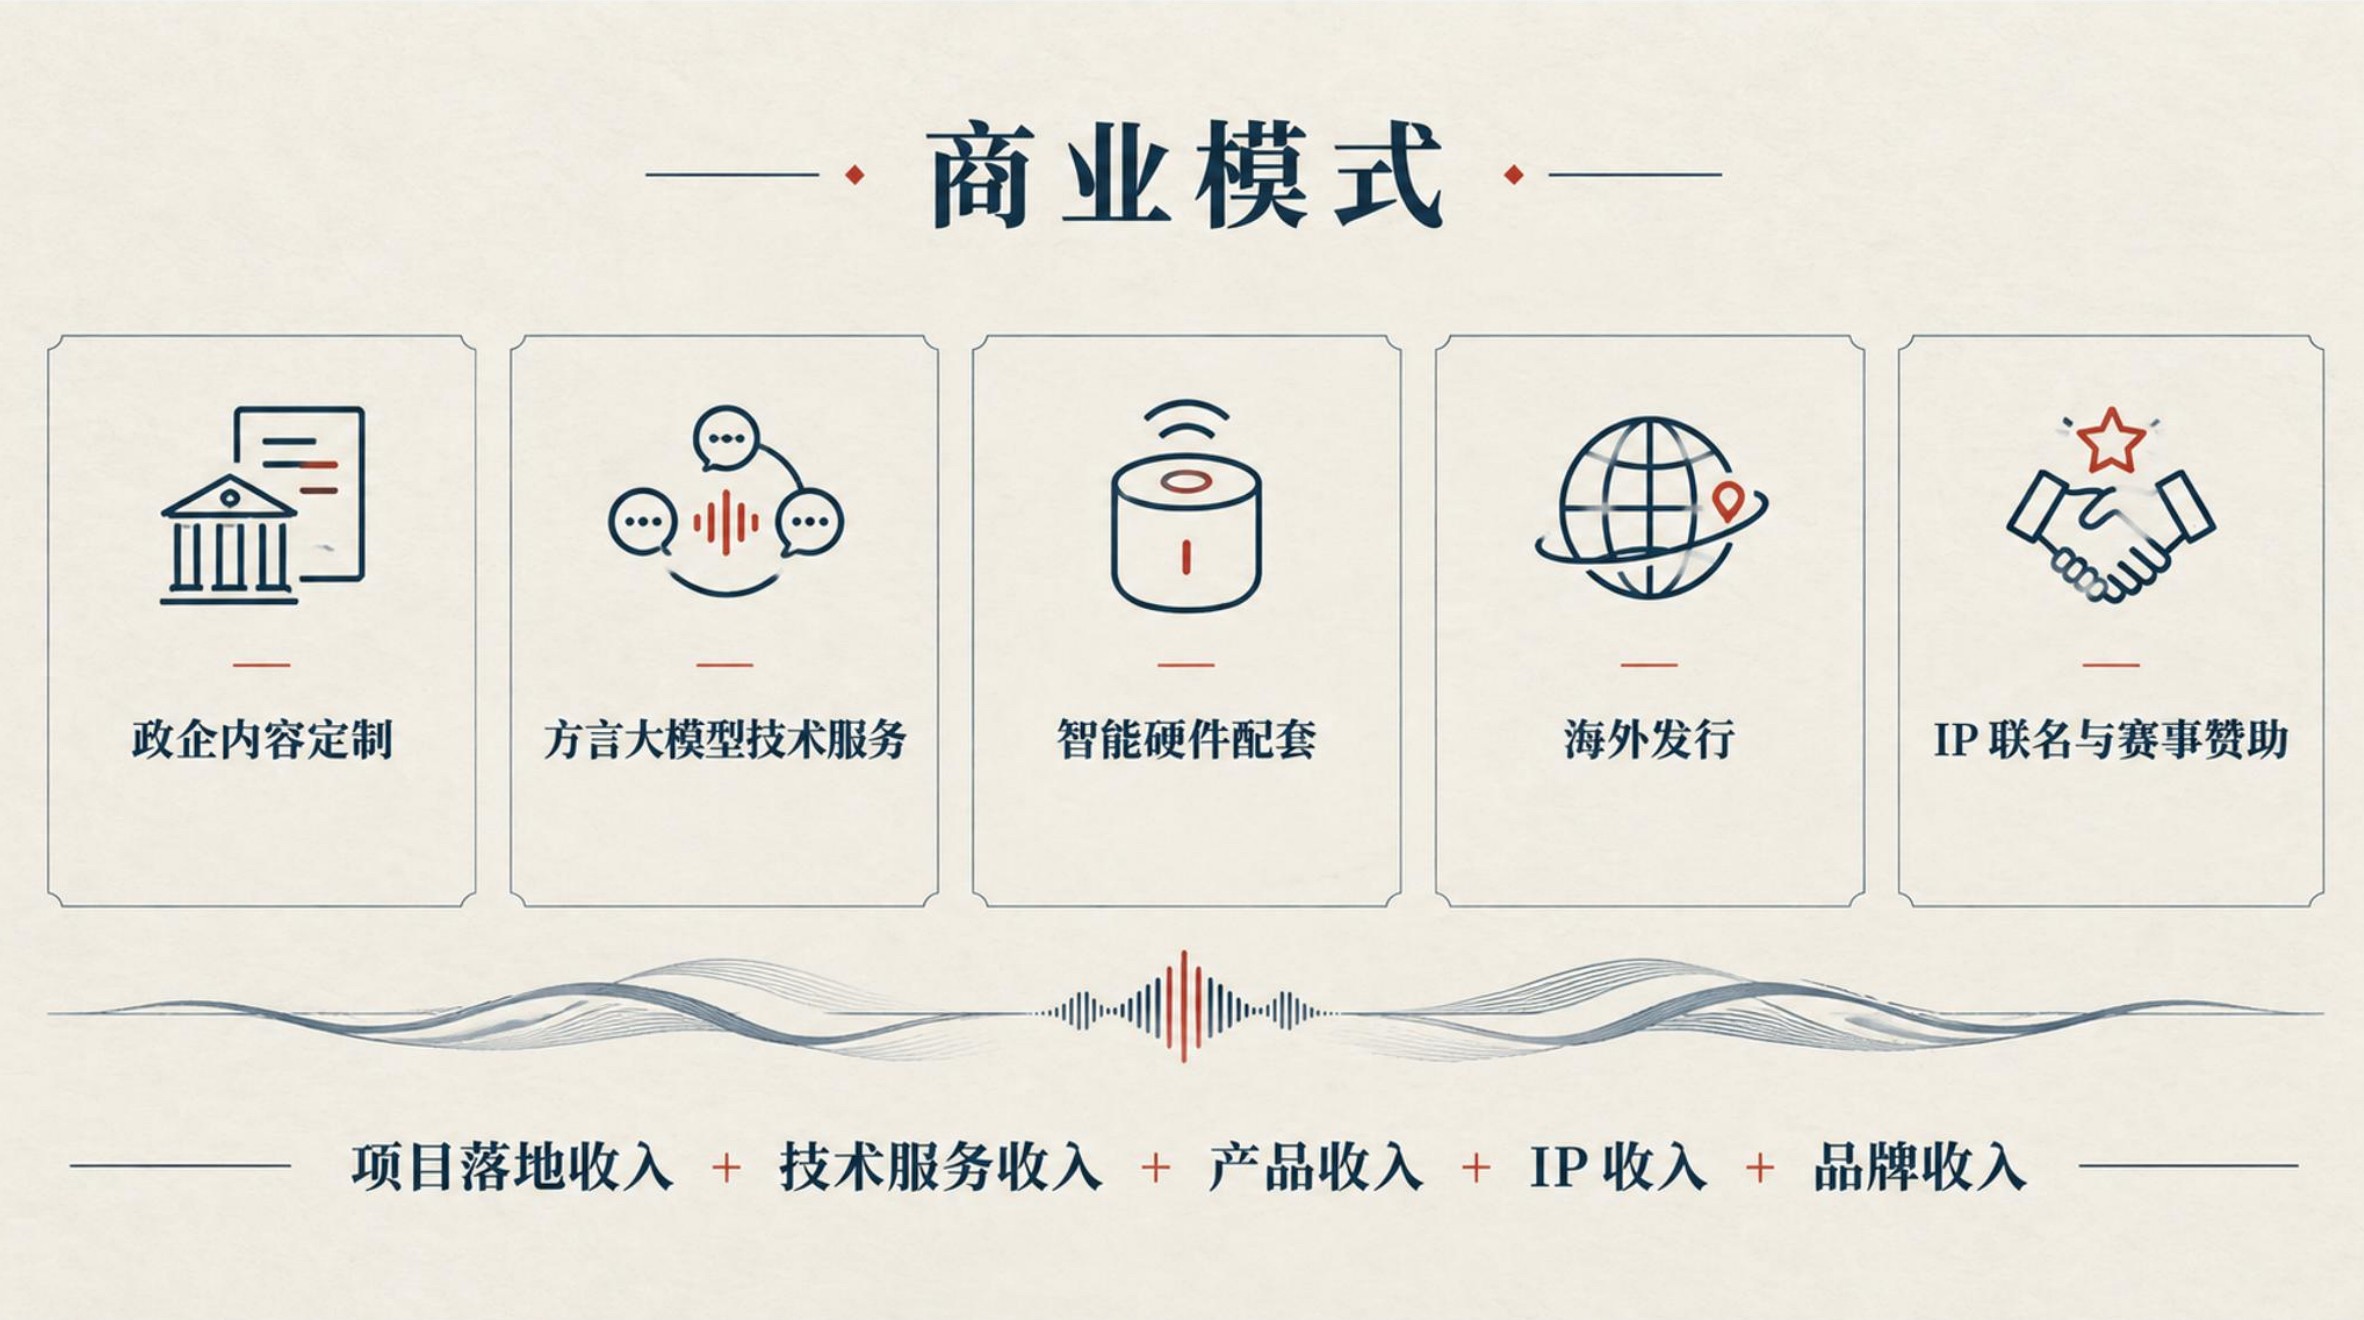
Es gibt fünf Einnahmequellen: Individuelle Inhaltserstellung für staatliche und unternehmerische Kunden, Produktion von Dialekt-Kurzfilmen, Musikvideos, Werbefilmen und Digitalisierung des immateriellen Kulturerbes; technische Dienstleistungen für große Dialekt-Modelle, Bereitstellung von lokaler Bereitstellung, Sprachinteraktion, KI-Stimmen und Lösungen für digitale Menschen; Unterstützung für intelligente Hardware, Erstellung von Dialekt-Führungen für Museen, Dialekt-Interaktion für Bildungsprodukte und Heimatdialekt-Interaktion für kulturelle Kreativprodukte; internationale Verbreitung, Bereitstellung von Dialekt-Musik und Kurzvideo-IPs für Südostasien und die globalen chinesischen Gemeinschaften; darüber hinaus IP-Kooperationen und Sponsoring von Wettbewerben.
Die Angebote für einzelne Projekte liegen im Bereich von 300.000 bis 2 Millionen Yuan, die Lieferzeit beträgt etwa drei Monate, die Bruttomarge liegt zwischen 55 % und 65 %, und die Bruttomarge für Geschäfte zur Lizenzierung von Fähigkeiten kann über 70 % erreichen. Es ist üblich, dass die Zahlungen von staatlichen und unternehmerischen Kunden sechs bis neun Monate dauern. Das Unternehmen hat drei strenge Regeln festgelegt: Die Vorfinanzierung für ein einzelnes Projekt überschreitet nicht 300.000 Yuan, die Vorauszahlung beträgt nicht weniger als 30 %, und maximal vier Projekte laufen gleichzeitig.
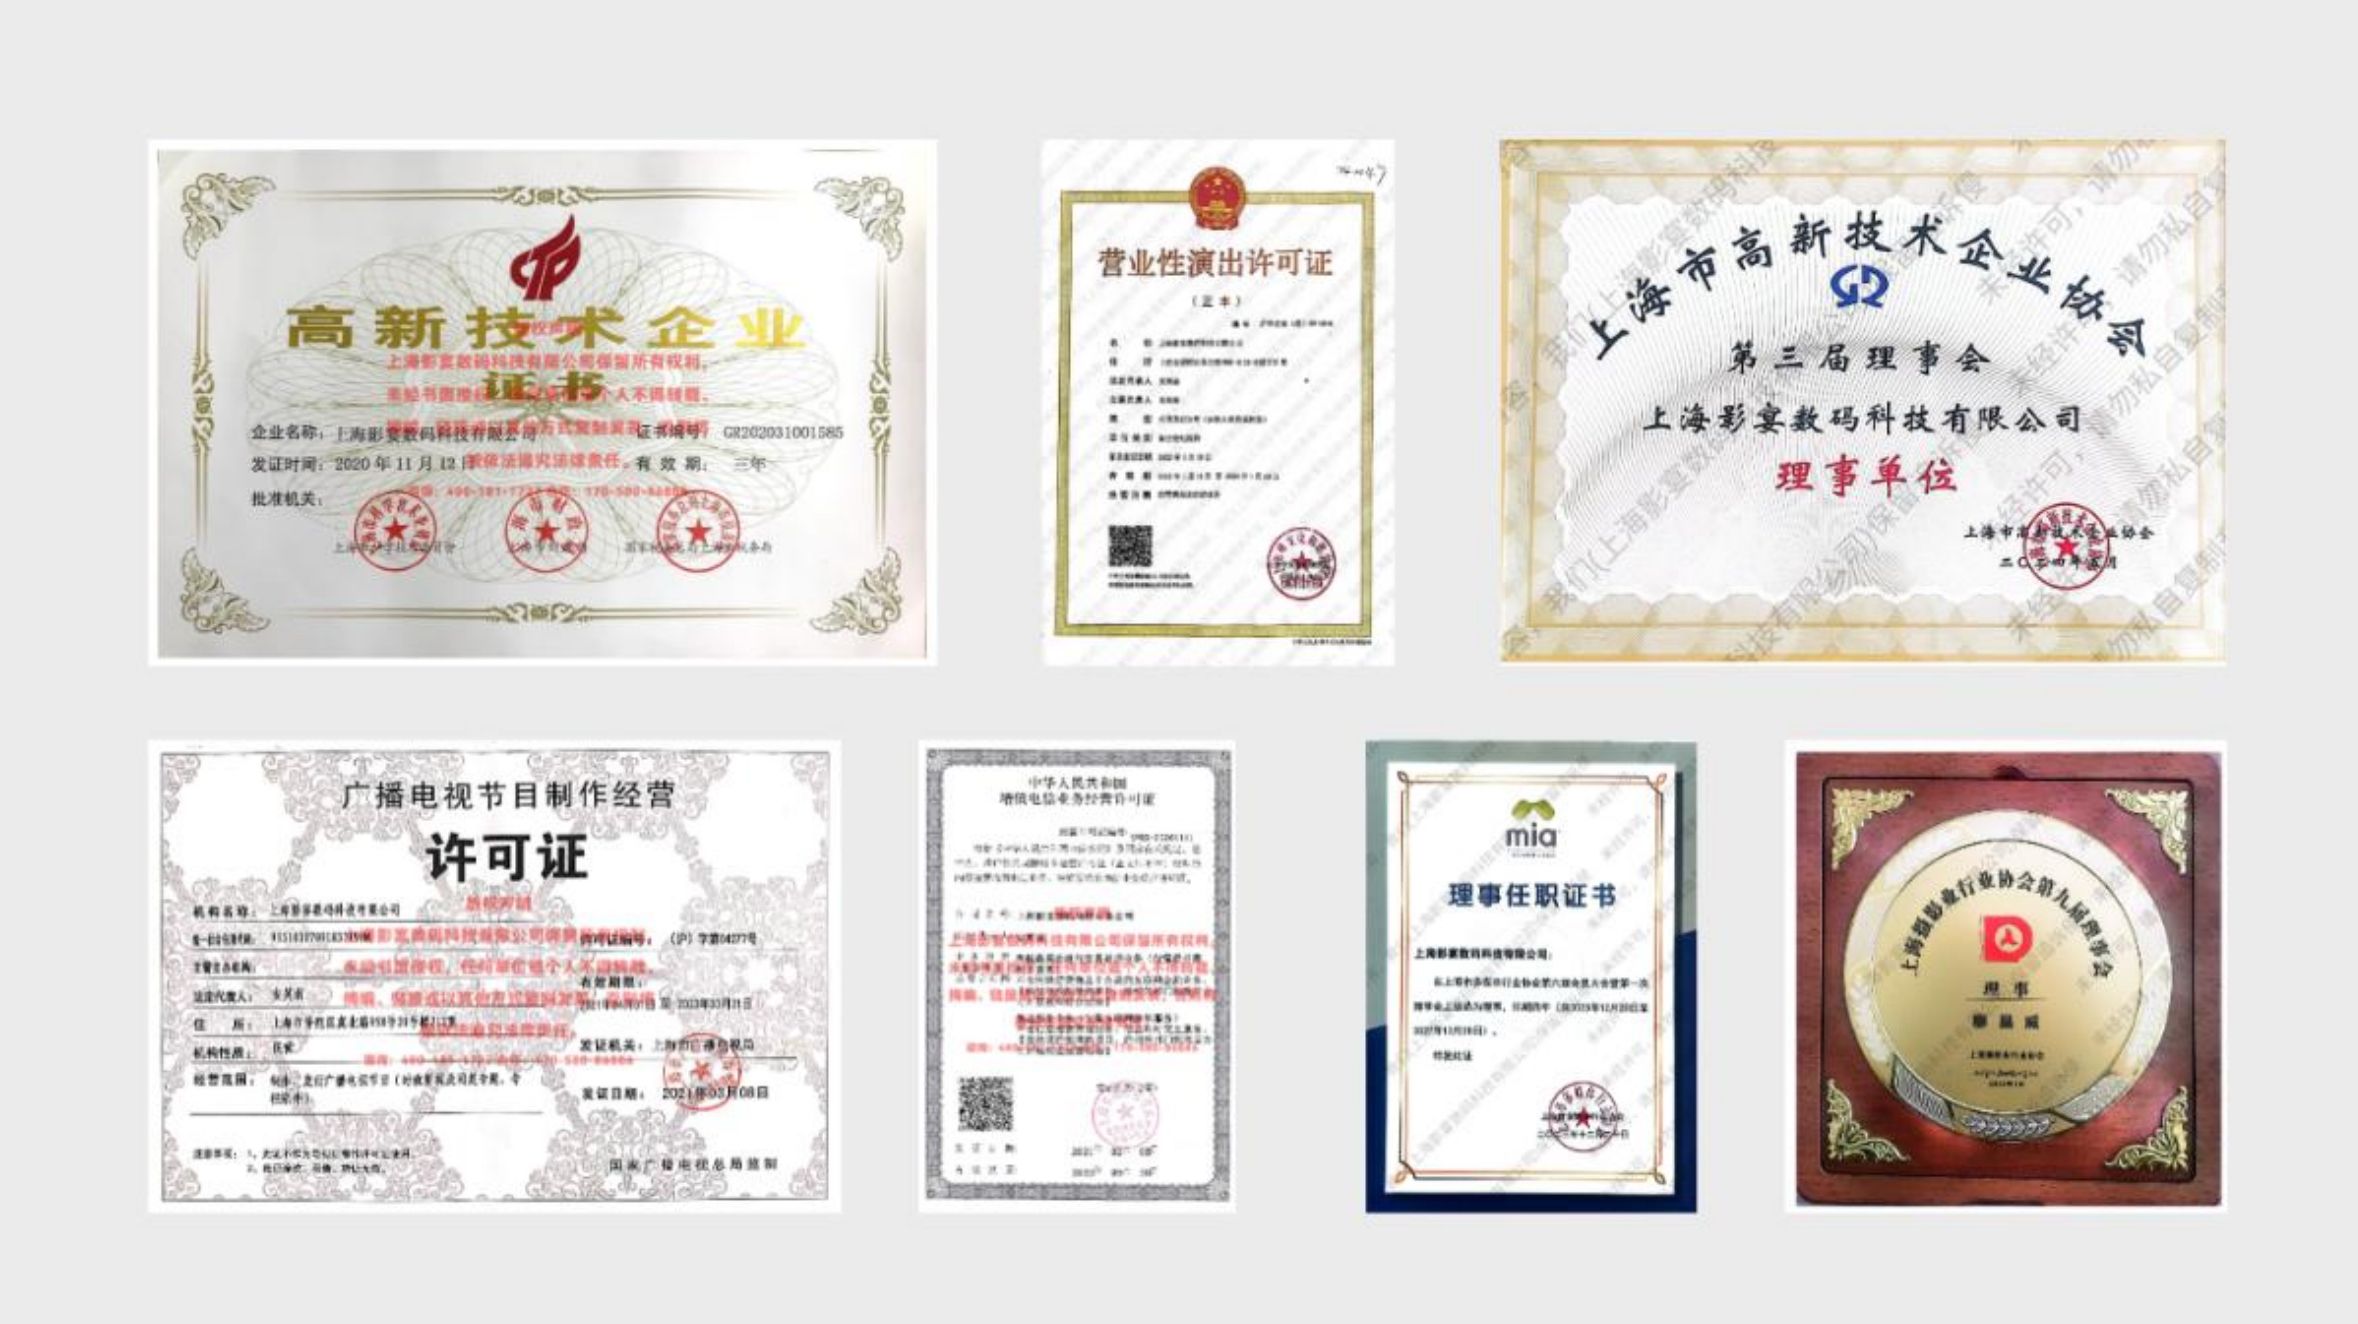
Der Fortschritt ist zweigeteilt. Bei den bereits abgeschlossenen Dialekt-Projekten handelt es sich um das Fahrzeug-Dialekt-Sprachpaket für XPeng Motors, Projekte der Propagandaabteilung des Parteikomitees von Ganzhou und von Qingdao Kultur und Tourismus. Die Endgerätemodule werden in kleinen Mengen als Muster geliefert und derzeit gemeinsam mit Automobilherstellern und Roboterherstellern abgestimmt. China Mobile, State Grid, China Post und Everbright Bank gehören zu den Kundenbeziehungen auf Gruppenebene, bei denen bisher Projekte für Filme und digitale Menschen geliefert wurden – diese Beziehungen können als Vertriebskanäle für das Dialekt-Geschäft