Verdopplung des ChatGPT Pro-Kontingents: Ist das ein Zugeständnis, keine Wohltat?
Am 29. Oktober gab Tibo, Produktleiter bei OpenAI, bekannt, dass ab sofort die Nutzungsbeschränkungen der Tarife Pro 100, Pro 200, Pro 500 und Business Premium vollständig verdoppelt werden.
Dazu gibt es eine wichtige Anmerkung: Nach Anhörung des Nutzerfeedbacks hat OpenAI beschlossen, das Nutzungslimit von Pro 200 nicht weiter zu kürzen, sodass das Nutzungsvolumen von ChatGPT Work und Codex bei diesem Tarif auf dem bisherigen Niveau verbleibt. Gleichzeitig profitieren Dots weiterhin von erweiterten Kapazitäten, deren Nutzungsvolumen unabhängig vom Standardlimit des Kontos berechnet wird und nicht auf dieses angerechnet wird.
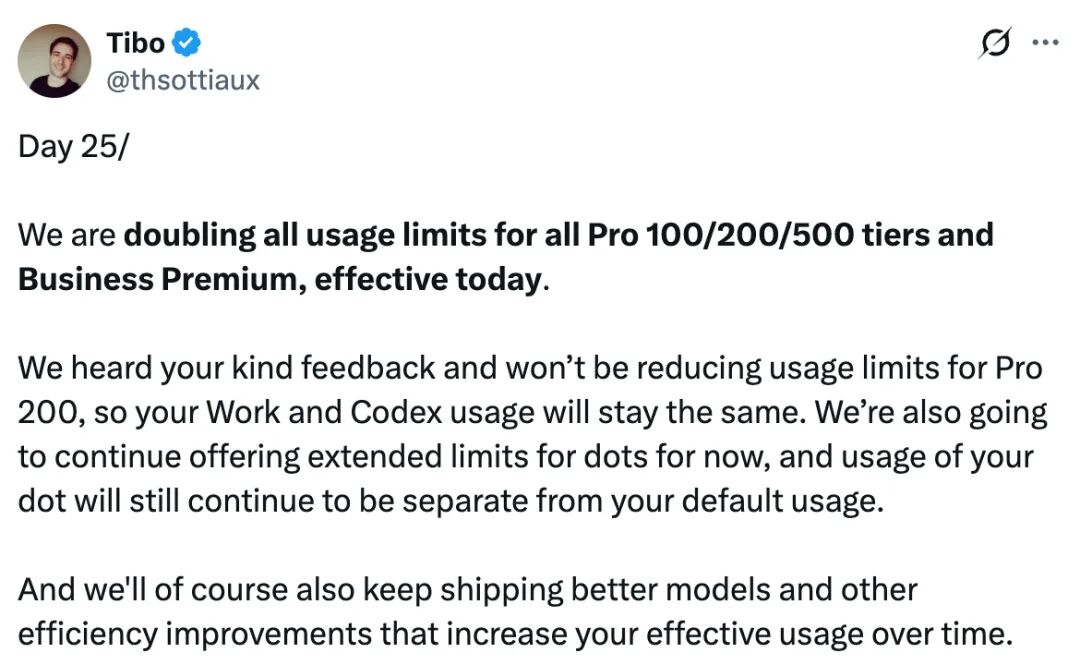
Diese Anpassung reagiert praktisch auf die Kontroverse, die durch die vorherige Anpassung des Pro-Abonnementsystems ausgelöst wurde. Zuvor hatte OpenAI den 500-US-Dollar-Tarif Pro 500 eingeführt und die Rechte des 200-US-Dollar-Pro-Tarifs angepasst, wobei die ursprünglichen Pro 200-Nutzer mit einer teilweisen Senkung des Nutzungslimits rechnen mussten. Mit dieser Ankündigung werden die entsprechenden Kürzungspläne zurückgezogen, was bedeutet, dass das Nutzerfeedback die endgültige politische Entscheidung tatsächlich beeinflusst hat.
Im Anschluss fragten einige Nutzer weiter, ob Pro 500 ein Nutzungsvolumen bedeutet, das dem 50-fachen des Plus-Tarifs entspricht, worauf Tibo direkt mit „Ja“ antwortete. Dies zeigt auch, dass OpenAI den Abstand des Nutzungslimits zwischen verschiedenen Zahlungsstufen weiter vergrößert, um Nutzern mit hoher Intensität im KI-Programmieren und Arbeitsabläufen mehr Nutzungsraum zu bieten.
Die Gemeinschaft reagierte darauf nicht durchweg positiv. Einige Pro-Nutzer begrüßten die Kapazitätserweiterung, aber auch einige 200-US-Dollar-Pro-Nutzer wiesen darauf hin, dass sie bereits zuvor ein höheres Limit genossen hatten, bei dieser Anpassung lediglich die geplanten Kürzungen zurückgezogen wurden und sie keine echten neuen Rechte erhalten haben.
„Ich freue mich, dass Nutzer anderer Pro-Stufen und Tarife mit niedrigen Limits eine echte Erhöhung des Nutzungslimits erhalten haben – das sind die echten Verbesserungen. Aber die Streichung der geplanten Limitsenkung in den 28-tägigen Verbesserungsplan einzubeziehen und als vollständige Verdopplung des Upgrades zu bewerben, ist irreführend. Ehrlich gesagt ist diese Aussage für Nutzer, die diese Angelegenheit stetig verfolgt haben und sich bei ihrer Planung auf offizielle Ankündigungen verlassen haben, kaum akzeptabel“, sagte ein Nutzer.
Gleichzeitig drückten einige Plus-Nutzer ihre Unzufriedenheit darüber aus, dass diese Anpassung die Niedrigpreistarife nicht abdeckt, und sind der Meinung, dass OpenAI den Unterschied des Nutzungserlebnisses zwischen verschiedenen Zahlungsstufen weiter vergrößert.
Neben der Erhöhung des Limits betonte Tibo auch, dass OpenAI weiterhin bessere Modelle und Effizienzoptimierungen einführen wird, damit die Nutzer im Laufe der Zeit mehr tatsächliches Nutzungsvolumen erhalten. Es ist bemerkenswert, dass diese Anpassung am 25. Tag des 28-tägigen Produktverbesserungsplans von OpenAI stattfindet. Tibo scherzte anschließend, dass OpenAI gerade von einem „Unternehmen zum Zurücksetzen von Limits“ zu einem „Token-Unternehmen“ übergeht.
Andrew Ambrosino, der bei OpenAI für die Codex- und ChatGPT-Produkte verantwortlich ist, erklärte ebenfalls, dass das Team eine Runde intensiver Verbesserungen gestartet hat, die sich auf die Lösung von Problemen bei der Einfachheit und Leistung von Anwendungen konzentrieren, und er selbst dafür verantwortlich ist.
Das bedeutet, dass OpenAI nicht vorhat, die Nutzeranforderungen nur durch die Erhöhung der Tarifobergrenzen zu lösen, sondern gleichzeitig die Modellfähigkeit, die Inferenzeffizienz und den Output pro Recheneinheit verbessern will. Für Entwickler, die zunehmend auf Codex angewiesen sind, ist die Gewährleistung eines stabilen und ausreichenden Nutzungslimits zu einem wichtigen Faktor geworden, der die Abonnemententscheidung beeinflusst.
Neben OpenAI hat auch Anthropic im vergangenen Jahr die Nutzungsbeschränkungen von Claude Code häufig angepasst und durchlief sogar einen Prozess von der Verschärfung über die Erweiterung bis hin zur teilweisen Rücknahme.
Im März 2026 verschärfte Anthropic das 5-Stunden-Nutzungslimit für Nutzer der Tarife Free, Pro und Max während der Spitzenzeiten; nach Abschluss einer Rechenleistungskooperation mit SpaceX im Mai verdoppelte das Unternehmen das 5-Stunden-Limit von Claude Code und hob die Spitzenzeit-Limitsenkung für die Tarife Pro und Max auf. Gleichzeitig erhöhte das Unternehmen das wöchentliche Limit von Claude Code vorübergehend um 50 %, behielt aber nach Ende der Aktion im September nur ein permanentes Limit bei, das 25 % über dem ursprünglichen Niveau lag.
Die Unzufriedenheit über die Limit-Anpassungen führte auch zu Nutzerklagen gegen die Abonnementrechte.
Die Tarife Max 5x und Max 20x von Anthropic werben jeweils mit dem 5-fachen und 20-fachen des Nutzungsvolumens des Pro-Tarifs, wobei dieser Multiplikator sich tatsächlich auf das Nutzungsvolumen innerhalb jedes 5-stündigen Sitzungsfensters bezieht und nicht auf das kumulierte wöchentliche Nutzungsvolumen – die Nutzer unterliegen gleichzeitig einer wöchentlichen Gesamtbegrenzung. Im September dieses Jahres reichte eine Gruppe von Nutzern deswegen eine Sammelklage gegen Anthropic ein, da sie der Meinung sind, dass die entsprechenden Beschränkungen während des Kaufprozesses nicht ausreichend und auffällig erläutert wurden, was zu einer Lücke zwischen dem tatsächlichen Nutzungserlebnis und den Erwartungen beim Kauf führt.
1 Hintergrund-Agenten verbrauchen unbemerkt eine große Menge an Token
Das Limit-Problem bei KI-Programmierwerkzeugen ist kein einfaches Problem der Tarifpreise. Da Agenten zunehmend mehr Entwicklungsaufgaben übernehmen, verbrauchen die automatische Ausführung im Hintergrund, die Aufgabenplanung und die Multi-Agent-Zusammenarbeit ebenfalls eine große Menge an Rechenleistung – es entstehen sogar Fälle, in denen Nutzer keine Aufgaben direkt wahrnehmen, aber bereits ein erhebliches Nutzungsvolumen verbraucht wurde.
Dieses Problem trat bereits im Juni dieses Jahres bei Codex von OpenAI auf. Damals stellten viele Nutzer fest, dass das Nutzungslimit, das normalerweise eine Woche zum Verbrauch brauchte, plötzlich innerhalb von ein oder zwei Tagen aufgebraucht war. Einige 200-US-Dollar-Pro-Nutzer gaben an, dass das Limit, für das sie früher eine Woche ununterbrochener Arbeit brauchten, später an einem einzigen Tag erschöpft sein konnte.
Tibo erklärte anschließend, dass das Problem mit einer anormalen Arbeitslast im Hintergrund zusammenhängt: Automatische Code-Prüfungen und unterstützende Sub-Agenten laufen manchmal häufiger als erwartet, führen Aufgaben sogar wiederholt aus oder versuchen nach Fehlern übermäßig oft erneut, was zu unnötigem Rechenleistungsverbrauch führt. Darüber hinaus zeigte das Codex-Dashboard einige Aktivitäten an, die tatsächlich nicht auf die Rechnung der Nutzer angerechnet wurden, was die Verwirrung der Nutzer über den anormalen Verbrauch des Limits weiter verstärkte.
Aus diesem Grund organisierte OpenAI eine Notfalluntersuchung, gründete ein spezialisiertes Team zur Untersuchung des Problems, implementierte Korrekturen und setzte das Nutzungslimit aller Nutzer zurück. Gleichzeitig wurde die Überwachung des Hintergrundnutzungsvolumens erweitert, um ähnliche Probleme früher zu erkennen. Tibo erklärte außerdem, dass das Team den Nutzern eine zusätzliche Rücksetzung des Limits gewähren wird, um die Auswirkungen des vorherigen anormalen Verbrauchs auszugleichen.
Bei Claude Code von Anthropic wurde ein ähnliches Problem festgestellt, wobei der Verbrauch in einem noch unauffälligeren Bereich stattfand.
Am 15. August reichte ein Entwickler ein Issue im GitHub-Repository von Anthropics Claude Code ein und forderte das Unternehmen auf, einen offiziellen Schalter bereitzustellen, der es Nutzern erlaubt, die Statuszusammenfassungen von Sub-Agenten zu deaktivieren, ohne die gesamte Sub-Agent-Funktionalität opfern zu müssen.
Das Problem liegt im Hintergrund-Statusaktualisierungsmechanismus von Claude Code. Wenn Nutzer mehrere Sub-Agenten starten, ruft das System regelmäßig das Modell auf, um eine kurze Statusmeldung für jeden aktiven Agenten zu generieren, z. B. welche Aufgabe gerade ausgeführt wird. Nach der Analyse der internen Anfragen von Claude Code durch Entwickler wird dieser Mechanismus standardmäßig alle 30 Sekunden ausgelöst, wobei jedes Mal der vollständige Gesprächsverlauf der Sub-Agenten und die Tool-Definitionen erneut übermittelt werden, damit das Modell die Zusammenfassung generiert. Das Endergebnis umfasst normalerweise nur Dutzende von Token, dient hauptsächlich der Aktualisierung der Statustexte in der Oberfläche und hilft Nutzern und Claude Code, den Arbeitsfortschritt jedes Hintergrund-Agenten zu verfolgen.
Ein Entwickler führte eine Paketerfassungsanalyse für eine 4-stündige Sitzung durch, bei der 27 Sub-Agenten gestartet wurden. Von 1496 API-Anfragen entfielen 339 auf agent_summary, was 22,7 % aller Anfragen entspricht; dieser Teil der Anfragen erzeugte etwa 62,76 Millionen ursprüngliche Token, was 22,2 % der gesamten ursprünglichen Token ausmacht. Nach der Gewichtung nach den Preisen für Cache-Lesevorgänge, Cache-Schreibvorgänge und Ausgaben von Opus 5 macht der Kostenanteil immer noch etwa 18 % der gesamten Sitzung aus.
Ein anderer Entwickler stellte bei einem 1 Stunde und 45 Minuten dauernden Test mit 4 Sub-Agenten ein ähnliches Problem fest. Dabei erreichte der Kontextumfang eines langlaufenden Agenten etwa 380.000 Token, 103 Statuszusammenfassungsanfragen erzeugten 21,8 Millionen Cache-Lese-Token, was 26 % des gesamten Cache-Lesevolumens der Sitzung entspricht – aber die endgültige Ausgabe beträgt nur etwa 2100 Token. Nach Berechnungen dieses Entwicklers kann allein dieser Agent zur Generierung von Statusmeldungen pro Stunde etwa 45 Millionen Cache-Lese-Token erzeugen.
Noch problematischer ist, dass diese Hintergrundanfragen mit der Einstellung skipTranscript: true versehen sind und normalerweise nicht in die regulären Sitzungstranskriptdateien aufgenommen werden. Daher können Drittanbieter-Tools, die den Verbrauch anhand von Sitzungsprotokollen berechnen, das tatsächliche Token-Nutzungsvolumen unterschätzen. Die Nutzer sehen einige wenige Wörter, die sich in der Statusleiste der Agenten ständig ändern – im Hintergrund kann jedoch eine große Menge an Kontextlesevorgängen stattfinden.
Am 28. Oktober veröffentlichte der Entwickler „Flamerix AI“ ebenfalls seine Überwachungsergebnisse. Durch die Analyse der OpenTelemetry-Telemetriedaten von Claude Code stellte er fest, dass innerhalb einer einwöchigen Statistikperiode agent_summary 16,4 % der gesamten geschätzten Kosten und 19,7 % der gesamten API-Anfragen ausmachte, wobei das Verhältnis von Eingabe- zu Ausgabe-Token etwa 9000:1 betrug. Mit anderen Worten: Das System muss wiederholt eine große Menge an Kontext lesen, um eine kleine Anzahl von Statustexten zu generieren.
Anschließend veröffentlichte Flamerix AI ein Open-Source-Skript unter der MIT-Lizenz, das versucht, die entsprechenden Timer über den Bun-Preloading-Mechanismus abzufangen und die Statuszusammenfassungen zu deaktivieren, ohne die Binärdatei von Claude Code zu modifizieren. Dieses Skript wurde in mehreren Versionen unter Linux getestet: Nach dem Deaktivieren der Zusammenfassungen funktionieren die Hintergrund-Sub-Agenten, Forked Skills und Hintergrundsitzungen weiterhin normal, nur das Agents-Panel aktualisiert die Statustexte nicht mehr fortlaufend. Diese Methode hängt jedoch von der internen Implementierung von Claude Code ab und ist keine offiziell von Anthropic unterstützte Lösung – zukünftige Versionsaktualisierungen können sie außer Kraft setzen.
Als diese Angelegenheit in der Gemeinschaft weiter diskutiert wurde, meldete sich Edwin Arbus, ein Anthropic-Ingenieur, der sich als Mitglied des Claude Code-Teams ausgab, zu Wort.
Er erklärte, dass dieser Mechanismus nur für arbeitende Hintergrund-Agenten gilt, während inaktive Agenten keine fortlaufenden Zusammenfassungsanfragen auslösen. Der von Flamerix AI gemessene Wert von 16,4 % stammt möglicherweise von Teams, die Hintergrund-Agenten in großem Umfang nutzen, und ist nicht allgemein repräsentativ. Nach den Telemetriedaten von Anthropic der vergangenen Woche macht agent_summary bei den Claude Code-Nutzern, die Telemetrieinformationen übermitteln, unter Berechnung nach den API-Listenpreisen etwa 2 % der Gesamtkosten und etwas weniger als 4 % der gesamten Anfragen aus; wenn nur die Terminalumgebung betrachtet wird, liegt dieser Anteil bei etwa 6 %.
Arbus räumte jedoch ein, dass selbst 2 % für eine Funktion, die hauptsächlich zur Generierung von Statusmeldungen dient, immer noch zu hohe Kosten verursachen. Er teilte mit, dass Anthropic bereits den teuersten Fall in Versionen ab Claude Code 2.1.311 behoben hat – nämlich das Problem, dass Zusammenfassungsanfragen den Prompt-Cache nicht treffen. Derzeit entwickelt das Team eine kostengünstigere Implementierung, bei der nicht mehr jedes Mal der vollständige Gesprächsverlauf übermittelt wird, sondern kurze Notizen gesendet werden, die von einem kleineren Modell zur Generierung der Zusammenfassung verarbeitet werden.
Das bedeutet jedoch nicht, dass der Aufwand für Hintergrundzusammenfassungen vollständig beseitigt ist. Am 29. Oktober konnten Entwickler die entsprechenden Anfragen noch auf der Version Claude Code 2.1.312 reproduzieren. Andere Entwickler berechneten 129 Hintergrund-Agent-Sitzungen innerhalb von 30 Tagen und stellten fest, dass agent_summary etwa 14 % des Anfragevolumens und 10 % der geschätzten Kosten ausmacht – in einer Sitzung mit 40 Agenten erreichte der Anteil sogar 24 %.
Dies zeigt auch, dass das Problem nicht einfach in einer übermäßigen Anzahl von Hintergrundanfragen liegt, sondern dass der Kontextumfang, die Cache-Trefferquote, die Modellauswahl und die Aktualisierungsfrequenz gemeinsam die endgültigen Kosten bestimmen. Bei langlaufenden Agenten summiert sich selbst bei Cache-Treffern bei jeder Anfrage das wiederholte Lesen von Hunderttausenden von Token im Kontext zu einem nicht unerheblichen Aufwand.
2 Wie können KI-Programmierwerkzeuge einen stabilen Dienst bereitstellen?
Der Grund, warum Entwickler bereit sind, große Budgets für die KI-Programmierung auszugeben, liegt darin, dass sie echte Produktivitätssteigerungen erwarten. Ein Anstieg des Nutzungsvolumens des Werkzeugs bedeutet jedoch nicht, dass der Nutzen im gleichen Maße steigt – die Messung des Return on Investment (ROI) wird zu einem neuen Problem.
Während die Limit-Anpassungen die Nutzer beeinflussen, wirken sie sich auch umgekehrt auf das Geschäftsmodell der Hersteller von KI-Programmierwerkzeugen aus.
Feste monatliche Abonnementgebühren und nutzungsabhängige Abrechnungen folgen unterschiedlichen wirtschaftlichen Logiken. Bei API-Geschäften, die nach Token abrechnen, erzielen Hersteller in der Regel mehr Einnahmen, je mehr die Nutzer verbrauchen. Bei festen monatlichen Abonnements wie Pro oder Max ist der von den Nutzern gezahlte Preis jedoch relativ fest, während die Inferenzkosten mit zunehmendem Nutzungsvolumen stetig steigen. Insbesondere wenn Agenten lange Zeit autonom laufen und mehrere Sub-Agenten parallel aufrufen, können wenige starke Nutzer Rechenleistung