Mit der „DNA-Technik des beweglichen Buchdrucks“ werden biologische Daten für KI erzeugt, Yongyuan Hesheng erhält eine 50 Millionen Yuan umfassende Angel-Finanzierungsrunde | Erstveröffentlichung von 36Kr
Text von HU Xiangyun
Redaktionell bearbeitet von HAI Ruojing
36Kr erfuhr, dass Yongyuan Hesheng Technology (Shenzhen) Co., Ltd. (im Folgenden als „Yongyuan Hesheng“ bezeichnet) kürzlich eine Angel-Finanzierungsrunde in Höhe von 50 Millionen Yuan abgeschlossen hat. Diese Finanzierungsrunde wird gemeinsam von Shunwei Capital und Yunmu Capital investiert. Die in dieser Runde eingeworbenen Mittel werden für die Erstellung hochwertiger Datensätze, die Erweiterung der Produktionskapazität der selbst entwickelten innovativen DNA-Synthesetechnologie und den weiteren Ausbau der Infrastruktur für die Datenherstellung verwendet.
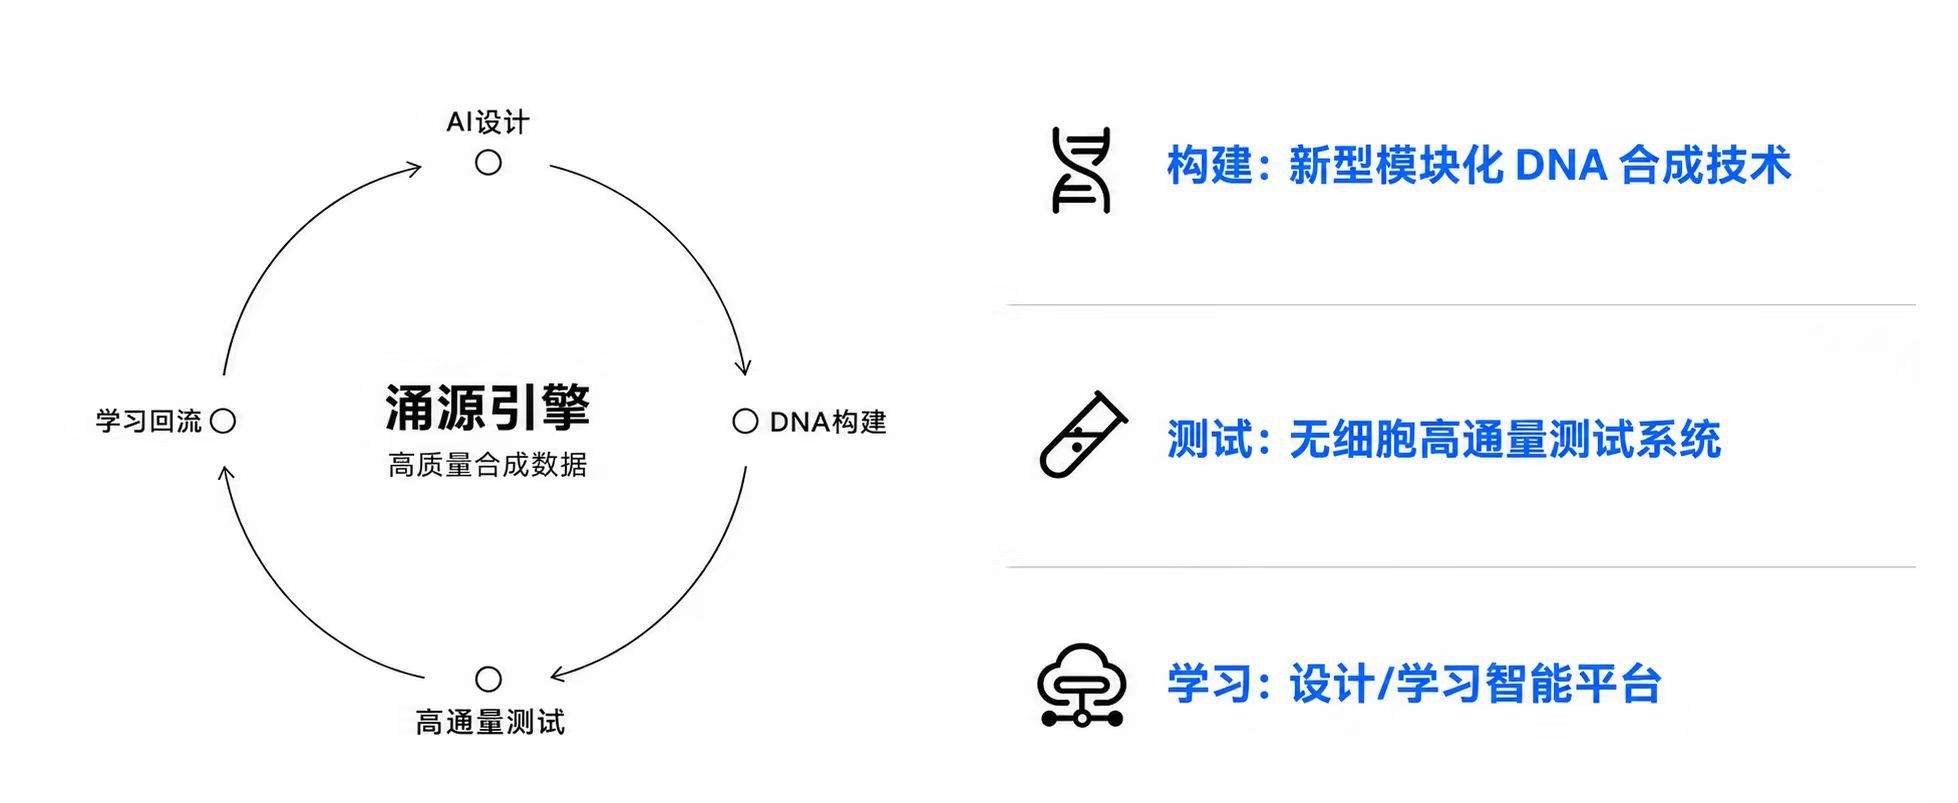
Yongyuan Hesheng positioniert sich als „Datenherstellungsplattform im Bereich KI + Biotechnologie“ und bietet wissenschaftlichen Forschungseinrichtungen, Pharmaunternehmen und Modellentwicklerteams integrierte Dienstleistungen von der Sequenzkonstruktion über Funktionsexperimente bis zur Datenaufbereitung und liefert KI-gerechte Sequenz-Funktions-Datensätze.
Der Gründer und CEO YANG Zongying erklärte, dass der Grund für die Wahl dieses Geschäftsfelds darin liegt, dass für KI-gestützte biologische Designteams nach der Generierung von Kandidatensequenzen noch eine Frage besteht, die unbedingt durch Experimente beantwortet werden muss: Wie genau verhalten sich diese Entwürfe unter festgelegten Bedingungen und welche Richtungen sollten in der nächsten Runde weiter optimiert werden? „Wir möchten diesen Teil übernehmen, die DNA-Konstruktion, Funktionsmessung und Datenaufbereitung verbinden und rund um die Forschungs- und Entwicklungsfragen unserer Kunden Sequenz-Funktions-Daten erstellen. Die Daten können sowohl für das Modelltraining als auch für die Modellbewertung, den Vergleich von Kandidatenlösungen und die Planung der nächsten Experimentrunde verwendet werden.“
Bildquelle: Yongyuan Hesheng
Im Jahr 2015 entdeckte YANG Zongying während seines Masterstudiums in Synthetischer Biologie am Imperial College London, dass trotz der hohen Beliebtheit dieses Fachgebiets das Forschungsparadigma in Laboren noch relativ primitiv ist. „Beispielsweise gibt es in menschlichen Zellen mehr als 20.000 Gene, aber Forscher verändern oft nur eine sehr kleine Anzahl von Genknoten und beobachten dann die Veränderungen des Systems, sodass die verfügbaren Informationen sehr begrenzt sind.“
Da es allein durch menschliche „Handarbeit“ kaum möglich ist, komplexe Lebenssysteme zu entschlüsseln, kann KI, die besser darin ist, Muster aus riesigen Datenmengen zu extrahieren, neue Durchbrüche bringen?
Mit dieser Idee ging YANG Zongying anschließend an die Newcastle University in Großbritannien, um in Informatik zu promovieren und die Nutzung von maschinellem Lernen für das Genomdesign zu erforschen. Kurz nach Beginn der Forschung stellte er fest, dass im Vergleich zu Rechenleistung und Algorithmen die eigentliche Lücke in den großen Mengen biologischer Daten liegt, die für das Trainieren von Modellen benötigt werden. Der Grund für die Seltenheit solcher Daten liegt zu einem großen Teil im Anfangsstadium: Die Kosten für die DNA-Synthese sind zu hoch.
Die gängigen DNA-Syntheseverfahren auf dem Markt umfassen die chemische Synthese, die hochdurchsatz-Chipsynthese, vertreten durch Twist, und das aufstrebende TdT-enzymatische Syntheseverfahren. Diese Wege haben jeweils ihre eigenen Vorteile in technischer Hinsicht, aber insgesamt ist es in den drei Dimensionen Kosten, Geschwindigkeit und Syntheselänge schwierig, die Versorgung mit den riesigen Datenmengen, die für KI benötigt werden, umfassend zu unterstützen.
Daher beschloss YANG Zongying, die zugrundeliegende Logik des traditionellen Rahmens zu durchbrechen und ein neues DNA-Syntheseverfahren zu finden, um das Kostenproblem bei der Datenproduktion zu lösen. Er nennt es „DNA-Buchdruck mit beweglichen Lettern“.
Einfach ausgedrückt besteht die zugrundeliegende Logik der traditionellen DNA-Synthese darin, einzelne Nukleotide nacheinander zusammenzufügen. Nehmen wir die chemische Synthese als Beispiel: Obwohl ihre Genauigkeit pro Schritt hoch ist und 99,5 % erreicht, kann sie in der Regel nur Fragmente mit einer Länge von weniger als 200 Basen auf einmal synthetisieren. Um ein Gen mit 1000 Basen zu erhalten, müssen diese anschließend noch zusammengesetzt und assembliert werden. Wenn man von der Genauigkeit pro Schritt ausgeht, ist die Richtigkeit des Endprodukts nach 999 Reaktionen bereits stark gesunken, sodass die nachfolgende Qualitätskontrolle und Selektion auch höhere Kosten erfordert. Zusätzlich zu Kostenpunkten wie Rohstoffverschwendung und Personalaufwand bleiben die Preise für die DNA-Synthese langfristig auf einem hohen Niveau.
Beim „DNA-Buchdruck mit beweglichen Lettern“ werden keine einzelnen Basen nacheinander zusammengefügt, sondern es wird im Voraus eine „Bibliothek mit beweglichen DNA-Lettern“ aufgebaut. Diese Bibliothek besteht aus vorgefertigten doppelsträngigen Modulen, die häufig verwendete Sequenzkombinationen abdecken und wie bewegliche Lettern wiederholt aufgerufen werden können.
„Nach Eingang einer Bestellung planen wir zuerst den Synthesepfad mit intelligenten Algorithmen, wählen die optimale Kombination von Modulen der beweglichen DNA-Lettern aus und führen die sequenzielle Assemblierung mithilfe eines selbst entwickelten Multienzymsystems durch. Auf diese Weise müssen statt 999 Reaktionen nur noch etwa 99 durchgeführt werden; außerdem ist die Genauigkeit des enzymvermittelten Assemblierungsschritts höher, unsere Treue bei der Synthese einzelner Basen erreicht 99,95 %. Durch die Verringerung der Anzahl der Reaktionen und die Erhöhung der Genauigkeit pro Schritt steigt der Anteil der korrekten Endprodukte deutlich, und die Kosten für die Qualitätskontrolle sinken entsprechend“, erklärte YANG Zongying.
Weiterhin wird berichtet, dass die Module der beweglichen Lettern in strukturell stabiler doppelsträngiger Form vorliegen, sodass komplexe Sequenzen synthetisiert werden können, die mit herkömmlichen Verfahren schwer zu synthetisieren sind, z. B. Sequenzen mit hohem GC-Gehalt (über 80 %), sehr niedrigem GC-Gehalt (unter 15 %), Haarnadelstrukturen, tandemartigen Wiederholungssequenzen usw. Außerdem können die Module der beweglichen Lettern nach ihrer einmaligen Herstellung über einen langen Zeitraum wiederholt verwendet werden, sodass die auf jede Nutzung entfallenden Kosten stark reduziert werden. Nachdem der gesamte Prozess in eine automatisierte Produktionslinie integriert wurde, lassen sich auch die Personalkosten voraussichtlich senken.
Nach den von Yongyuan Hesheng bereitgestellten Daten sind die Kosten für die Synthese einer einzelnen Base des Unternehmens auf unter 0,05 Yuan gesunken, was etwa 1/10 des Niveaus der traditionellen kommerziellen Nutzung entspricht. Die Lieferzeit für DNA mit einer Länge von 10 kb wurde auf weniger als 7 Tage verkürzt, während herkömmliche Lösungen in der Regel 21 bis 35 Tage benötigen. Derzeit kann diese Technologie in Laborumgebungen stabil reproduziert werden, das Unternehmen arbeitet an der groß angelegten stabilen Produktion auf Fabrikebene.
Dennoch löst die günstigere Synthese von DNA nur einen Teil der Probleme. „Unser ursprüngliches Ziel ist es, die Lücke bei den biologischen Daten zu schließen, die für KI benötigt werden, und die Voraussetzung für die kostengünstige Erzeugung biologischer Daten ist eine relativ vollständige DNA-Synthesekapazität. Danach besteht die zentralere Arbeit darin, sich stromabwärts zu erstrecken, Sequenzen in experimentelle Daten umzuwandeln und diese wissenschaftlichen Forschungseinrichtungen, Pharmaunternehmen oder Unternehmen für große KI-Modelle zur Verfügung zu stellen“, erklärte YANG Zongying.
Um Sequenzen in Daten umzuwandeln, die für das Training von KI verwendet werden können, müssen Sequenzen und Funktionen „paarweise auftreten“. Beispielsweise entspricht bei Antikörpern eine Antikörpersequenz dem numerischen Wert ihrer Bindungsstärke an einem bestimmten Zielort. Was Yongyuan Hesheng tun möchte, ist, diese Paarungsbeziehungen in großen Mengen zu erzeugen, Tausende von Kandidatensequenzen auf einmal zu synthetisieren, Bindungsexperimente durchzuführen, um die Affinität einzeln zu messen, und diese Werte zusammen mit den Versuchsbedingungen in einer Tabelle aufzuzeichnen, um so einen vollständigen Datensatz zu erstellen.
Gleichzeitig sind die Kosten auf der Testseite nicht niedriger als bei der Synthese. Nehmen wir das Technologiebeispiel der Bio-layer-Interferometrie (BLI) für die Antikörper-Affinitätsbestimmung: Eine einzelne Probe kostet mehr als hundert Yuan, Tausende von Proben kosten also Hunderttausende Yuan. Eine herkömmliche Zelltransformation und -expression dauert etwa eine Woche und ist stark auf manuelle Arbeit angewiesen.
Aus diesem Grund hat Yongyuan Hesheng ein eigenes schnelles Proteincharakterisierungssystem aufgebaut, das Schritte wie Zellkultur, Transformation und Klonenselektion einspart. „Mit unserer Methode liegen die Ergebnisse nach etwa 2 bis 4 Stunden vor, und mit der Anbindung an automatisierte Arbeitsplätze können derzeit auf der Basislinie mehr als 2000 Proben pro Woche verarbeitet werden.“ Gleichzeitig verbessert Yongyuan Hesheng auch eine Plattform mit höherem Durchsatz für die Charakterisierung, um durch die Kombination innovativer Charakterisierungstechnologien und Hochdurchsatz-Sequenzierungstechnologien die Charakterisierung und Analyse größerer Mengen biologischer Daten wie Antikörperdaten zu realisieren.
YANG Zongying erwähnte, dass eine der Kernarbeiten bei der Erstellung von KI-gerechten Datensätzen die Vervollständigung der Metadaten ist. Früher mussten Forscher nur die Affinitätswerte aufzeichnen, die den Antikörpersequenzen entsprechen, aber für das Training von KI müssen Informationen wie die Person, die das Experiment durchgeführt hat, die Versuchszeit, Temperatur, pH-Wert, Chargen der Reagenzien usw. vollständig aufgezeichnet werden, damit das Modell Rauschen filtern kann. Andererseits veröffentlichen Forscher im traditionellen wissenschaftlichen System im Grunde nur positive Ergebnisse, die wissenschaftlichen Hypothesen entsprechen, während für das Training von KI sowohl positive als auch negative Proben vorhanden sein müssen, um die Lerneffizienz zu steigern. „Analog zur Vorbereitung von Schülern auf Prüfungen: Das Üben nur von Aufgaben, die sie bereits lösen können, bringt nur begrenzte Verbesserungen, das Training mit falsch gelösten Aufgaben hilft viel mehr bei der Leistungssteigerung.“
Es wird berichtet, dass die Datensatzprodukte von Yongyuan Hesheng derzeit in zwei Typen unterteilt sind: allgemeine und angepasste. Allgemeine Datensätze werden im Voraus für gemeinsame Anforderungen der Branche erstellt und als Lagerware verkauft, z. B. die Affinität einer Gruppe von Antikörpersequenzen, die im Voraus für beliebte Zielorte gemessen wurde, oder die Bereitstellung von Enzymsequenz- und Funktionsdaten für Unternehmen, die industrielle Enzyme herstellen. „Dies sind auch die zwei Datentypen, die nach dem Auftreten der Nachfrage nach dem Training von KI-Modellen auf dem Markt stark nachgefragt werden.“
Angepasste Datensätze werden von Kunden mit spezifischen Problemen in Auftrag gegeben. YANG Zongying gab ein Beispiel: Das Unternehmen arbeitete einst mit einem Unternehmen der Fortune-500-Liste an dem UTR-Sequenzdesign für mRNA, wobei die UTR die Expressionsstufe und Stabilität der mRNA im Wirtsorganismus beeinflusst. „Nachdem wir mehrere Gruppen von DNA synthetisiert haben, führen wir weiterhin In-vitro-Experimente durch, die die schnelle Erstellung von Hunderten von Gruppen von gepaarten Daten aus Sequenz und Expressionsmenge unterstützen, und anschließend wird eine Feinabstimmung des Modells realisiert.“
Was die Kommerzialisierung betrifft, arbeitet Yongyuan Hesheng derzeit bereits mit einigen Versuchskunden zusammen, darunter wissenschaftliche Einrichtungen, Pharmaunternehmen und Unternehmen für große KI-Modelle. „Im Jahr 2027 wird unser Umsatz voraussichtlich mehrere zehn Millionen Yuan erreichen“, erklärte YANG Zongying.
YANG Zongying erläuterte, dass ein führendes inländisches Unternehmen für KI-Modelle einer der Kunden ist, mit denen das Unternehmen derzeit am engsten zusammenarbeitet. Die beiden Seiten kooperieren bei der Iteration des Antikörpergenerierungsmodells, wobei der Kooperationspartner Rechenleistung und Algorithmen bereitstellt und Yongyuan Hesheng die Infrastruktur für die Datenherstellung zur Verfügung stellt, um den geschlossenen Kreislauf von der KI-generierten Sequenz über die experimentelle Validierung bis zur Datenrückführung zu schließen.